JS嵌套数组怎么深拷贝?JSON方法与structuredClone对比
深入解析 JavaScript 嵌套数组深拷贝方案。剖析展开运算符与 slice 为何无法解决多维引用问题,详尽对比 JSON.parse(JSON.stringify()) 序列化方案与现代原生 structuredClone API 的运行机制、数据类型支持、边界陷阱及性能表现,提供清晰的工程选型决策指南。
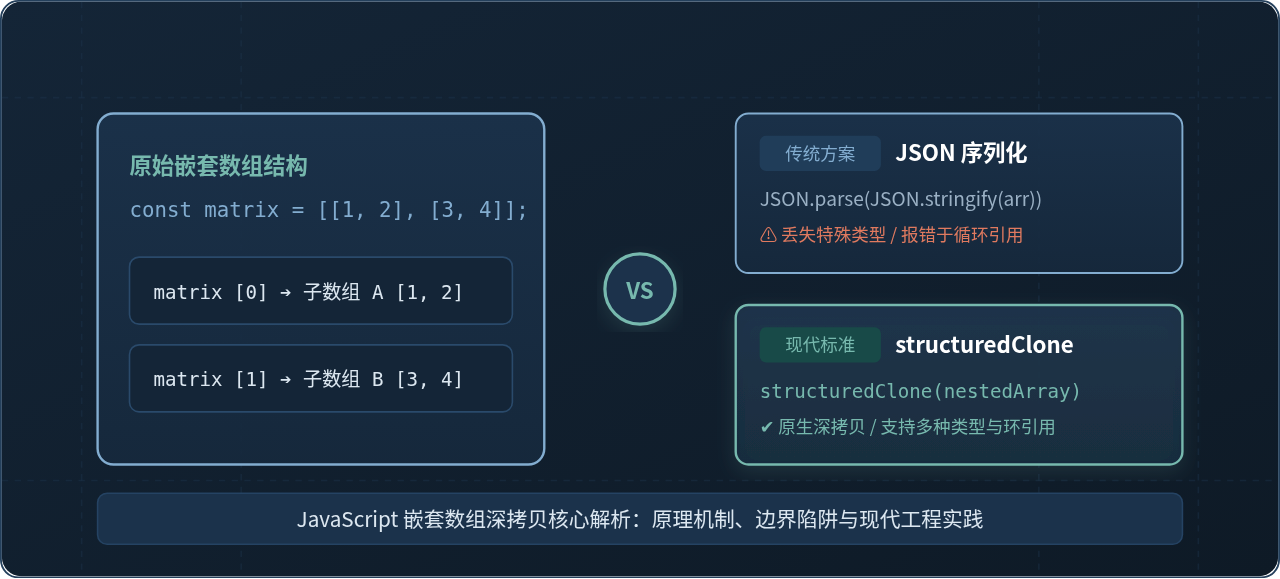
在 JavaScript 中拷贝包含子数组的多维数组或嵌套结构时,常规的浅拷贝方法(如展开运算符 [...arr] 或 arr.slice())只会复制第一层外层数组,内层嵌套数组依然共享相同内存引用。为了真正实现内外层完全隔离的深拷贝,现代标准提供了原生的 structuredClone() 全局方法;而在早期工程中,开发者普遍采用 JSON.parse(JSON.stringify(arr))。本文通过具体代码与原理图示,剖析浅拷贝的失效原因,并从数据类型支持、循环引用与性能边界多维度对比两种主流深拷贝方案。
一、为什么嵌套数组不能使用常规浅拷贝?
假设我们正在开发一个棋盘游戏或数据表格,通常会使用二维嵌套数组来记录单元格数据:
const board = [
  [1, 2],
  [3, 4]
];

// 尝试使用展开运算符进行拷贝
const boardCopy = [...board];

// 修改新数组中第 0 行第 0 列的值
boardCopy[0][0] = 99;

// 检查原数组
console.log(board[0][0]); // 示例输出: 99 (原数组被意外篡改!)
console.log(board === boardCopy); // 示例输出: false (外层已生成新数组)
console.log(board[0] === boardCopy[0]); // 示例输出: true (内层子数组仍共用同一指针)
展开运算符 [...board]、board.slice()、board.concat() 以及 Array.from(board) 都是浅拷贝(Shallow Copy)。它们的作用机制是创建一个全新的外层数组容器,但容器内填充的元素如果是引用类型(例如子数组或对象),则直接复制它们的堆内存指针。因此,当修改子数组中的元素时,原数组对应位置的数据也会随之改变。
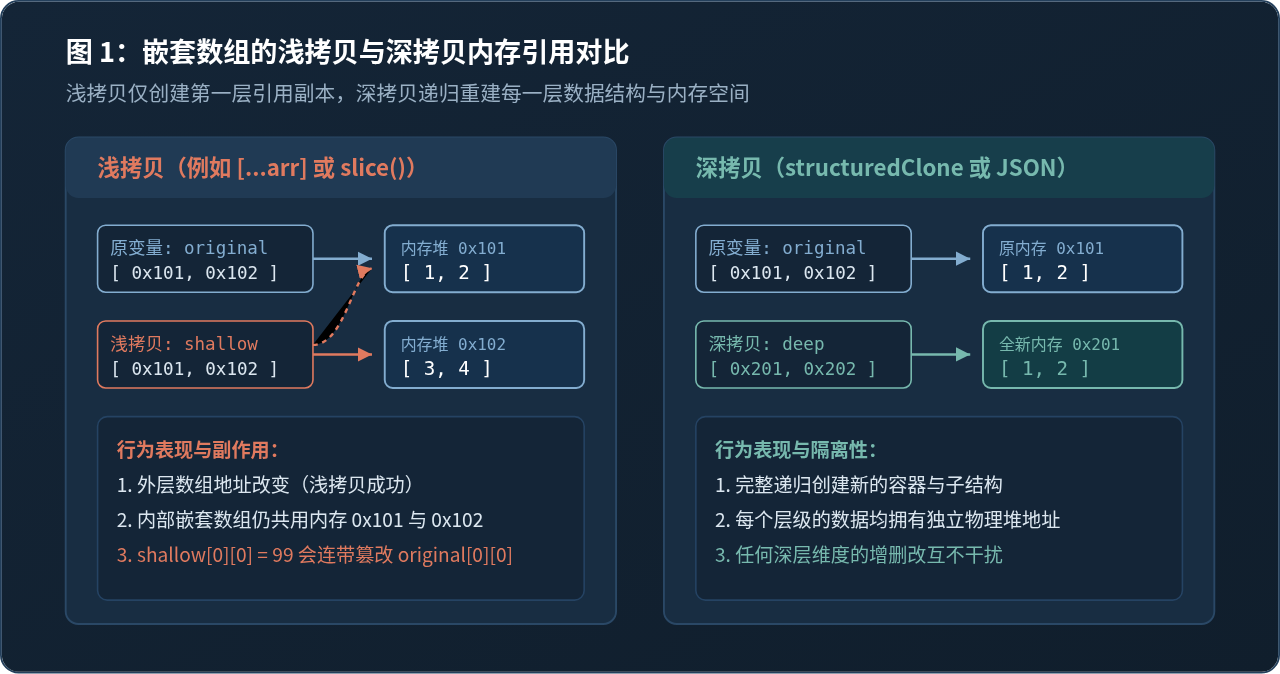
如图 1 所示,深拷贝的核心要求是:不仅仅在外层开辟新的堆内存,还必须递归遍历所有嵌套层级,为内部的每一个子数组、对象及集合都分配独立的堆地址,达到真正的物理级数据解耦。
二、传统方案:JSON 序列化与反序列化
在没有原生深拷贝 API 的时代,前端社区最为普及的单行深拷贝方案是先用 JSON.stringify() 将数组转为纯文本字符串,再通过 JSON.parse() 解析重构出一个结构完全独立的新数组:
const matrix = [
  [10, 20],
  [30, 40]
];

// 使用 JSON 序列化进行深拷贝
const deepMatrix = JSON.parse(JSON.stringify(matrix));

deepMatrix[0][0] = 888;

console.log(matrix[0][0]);     // 示例输出: 10 (原数组保持完好)
console.log(deepMatrix[0][0]); // 示例输出: 888 (深拷贝成功)
console.log(matrix[0] === deepMatrix[0]); // 示例输出: false (子数组指针已完全独立)
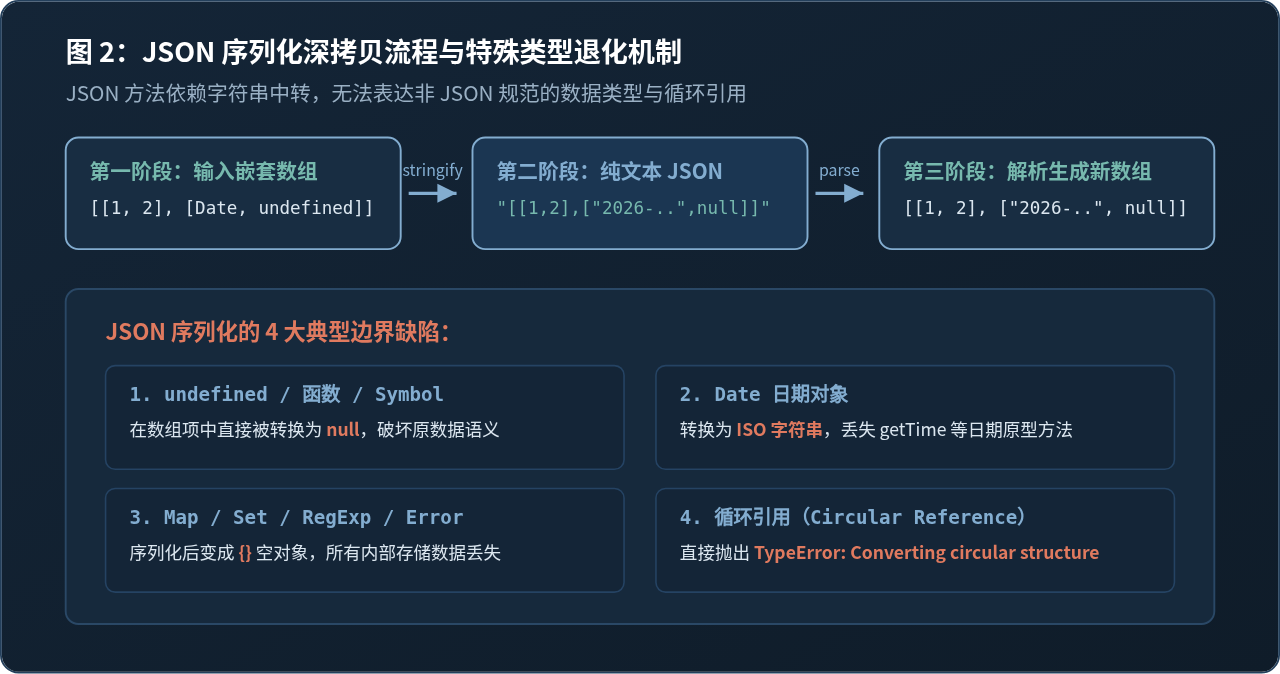
如果嵌套数组内只包含纯数字、字符串、布尔值或普通键值对象,JSON 方案写法精简且能满足深层隔离需求。然而,JSON 是一套数据交换格式,其规范支持的数据类型远少于 JavaScript 本身。一旦嵌套数组中掺杂复杂类型,JSON 方案就会发生数据静默退化或直接运行时崩溃。
JSON 方案的 4 个典型边界陷阱
- undefined、函数与 Symbol 被替换为 null:在普通对象中这类属性会被直接丢弃,但在数组中为了维持索引连续性,会被强行转换成
null。 - Date 日期对象退化为 ISO 字符串:
new Date()经过序列化后变为纯字符串,失去getTime()、getFullYear()等原型方法。 - Map、Set、RegExp 变成空对象:集合结构与正则表达式无法被 JSON 表达,反序列化后全变成没有任何内部状态的
{}。 - 遇到循环引用直接抛错崩溃:当数组中包含指向自身的子引用时,
JSON.stringify会直接抛出无法处理的异常。
// 陷阱验证代码示例
const complexList = [
  [1, undefined, function() {}],
  [new Date("2026-01-01"), new Set([1, 2])]
];

const jsonResult = JSON.parse(JSON.stringify(complexList));

console.log(jsonResult[0]);
// 示例输出: [1, null, null] (undefined 和函数被破坏为 null)

console.log(typeof jsonResult[1][0]);
// 示例输出: "string" (Date 对象降级为普通字符串,原对象方法不可用)

console.log(jsonResult[1][1]);
// 示例输出: {} (Set 数据全部丢失,沦为空对象)

// 循环引用场景验证
const circularArr = [1];
circularArr.push(circularArr); // 包含自身

try {
  JSON.parse(JSON.stringify(circularArr));
} catch (err) {
  console.log(err.message);
  // 示例输出: Converting circular structure to JSON
}
三、现代原生标准:structuredClone 深度克隆
针对上述痛点,HTML 规范委员会制定了结构化克隆算法(Structured Clone Algorithm),并在现代浏览器与 Node.js 环境中正式落地为全局 API:structuredClone()。它由 JavaScript 宿主引擎底层实现,专门用于无损复制复杂的嵌套数据结构。
// 语法调用非常直接,无需任何依赖
const deepCloned = structuredClone(targetArray);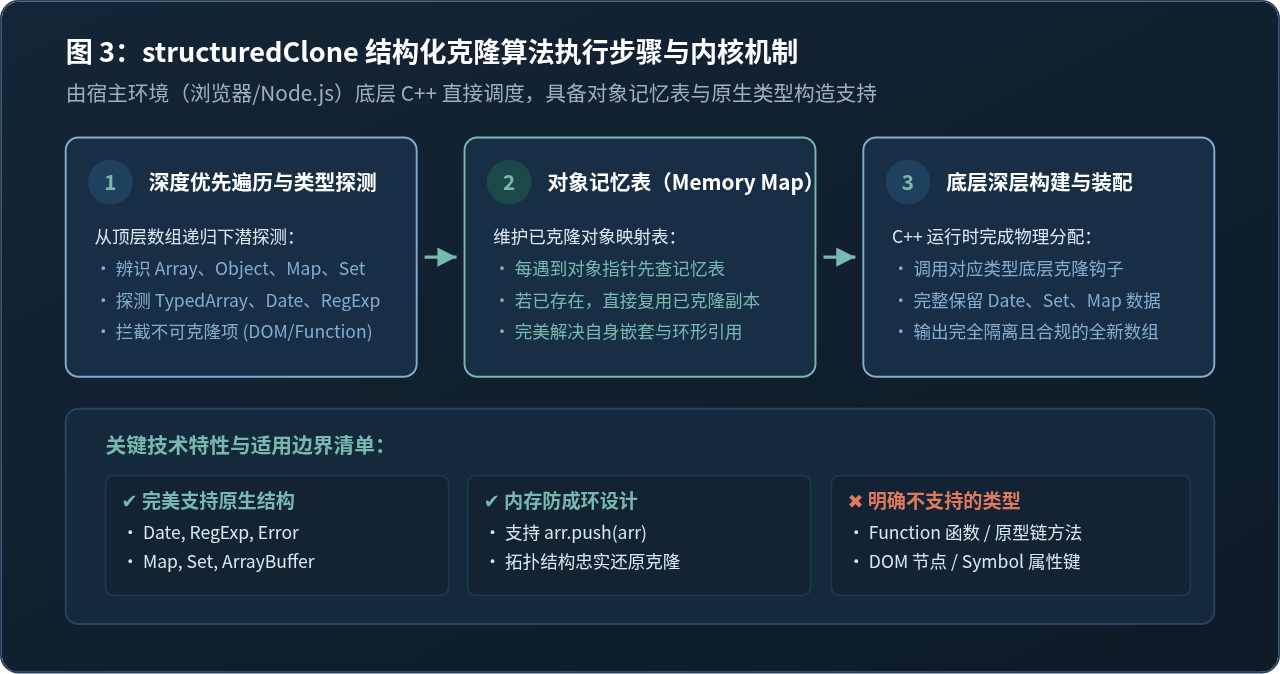
执行机制与优势特点
structuredClone() 的底层执行过程包含三个关键步骤:
- 深度类型探测与内存分配:算法递归遍历嵌套数组的每一个元素,由底层 C++ 运行时直接调用对应内置类型的数据拷贝钩子,避免了“对象 ➔ 字符串 ➔ 对象”的高额格式转换开销。
- 内置对象记忆表(Memory Map):算法在克隆过程中自动维护一张对象映射记录表。每当遇到一个引用类型,先检查表中是否已经记录过该地址;如果已经存在,则直接指向新创建的对应副本。这使其不仅能从容应对循环引用(如
arr.push(arr)),还能准确维持复杂数据图谱中的同引关系。 - 原生支持几乎所有内置引用类型:包括
Date、RegExp、Map、Set、ArrayBuffer、TypedArray、Error等均能无损克隆,并完整保留原型方法。
// structuredClone 实测验证
const advancedData = [
  [1, new Date("2026-05-20")],
  [new Set([100, 200]), new Map([["k", "v"]])]
];

const clonedData = structuredClone(advancedData);

// 验证 Date 原型方法调用
console.log(clonedData[0][1].getFullYear()); // 示例输出: 2026 (完整保留 Date 实例)

// 验证 Set 集合与数据隔离性
clonedData[1][0].add(300);
console.log(advancedData[1][0].has(300)); // 示例输出: false (原集合未受影响)
console.log(clonedData[1][0].has(300));   // 示例输出: true (克隆集合更新成功)

// 验证循环引用处理
const loopList = [10, 20];
loopList.push(loopList);

const clonedLoop = structuredClone(loopList);
console.log(clonedLoop[2] === clonedLoop); // 示例输出: true (自身环形拓扑完美保留)
console.log(clonedLoop[2] === loopList); // 示例输出: false (引用与原数组彻底隔离)尽管 structuredClone 远比 JSON 强大,但它仍然不允许克隆函数(Function)、DOM 节点以及对象的原型链(会剥离自定义类的 Prototype,仅保留自身数据属性)。如果尝试克隆包含函数的数组,会同步抛出 DataCloneError: function could not be cloned 异常。
四、JSON 方法与 structuredClone 深度横向对比
为了在实际项目中作出准确决策,我们将两种深拷贝机制的核心特性与技术指标梳理如下:
| 对比维度 | JSON 序列化方案 | structuredClone 原生 API |
|---|---|---|
| 调用语法 | JSON.parse(JSON.stringify(arr)) |
structuredClone(arr) |
| 实现层级 | JavaScript 字符串中间体编解码 | 宿主环境引擎底层 C++ 直接克隆 |
| undefined / null | 变异 undefined 在数组中变为 null | 支持 完整保留 undefined 与 null |
| Date 对象 | 丢失 降级为 ISO 时间字符串 | 支持 保留 Date 实例与全部原型方法 |
| Map / Set / RegExp | 丢失 转换为空普通对象 {} |
支持 深度拷贝内部全部键值与集合元素 |
| 循环引用 | 报错 抛出 TypeError | 支持 记忆表自动复用,拓扑忠实复制 |
| 函数 (Function) | 在数组中退化为 null |
直接抛出 DataCloneError 强提醒 |
| 大数据性能 | 需分配中间长字符串,GC 压力大 | 直接内存级结构复制,性能与内存消耗更平稳 |
| 运行环境基准 | 全版本通用(ECMAScript 5+) | Node.js 17.0+ / Chrome 98+ / Safari 15.4+ |
五、工程实战:如何选择深拷贝方案?
在前端应用与服务端 Node.js 业务开发中,选择深拷贝方案应结合项目运行环境与数据类型特征:
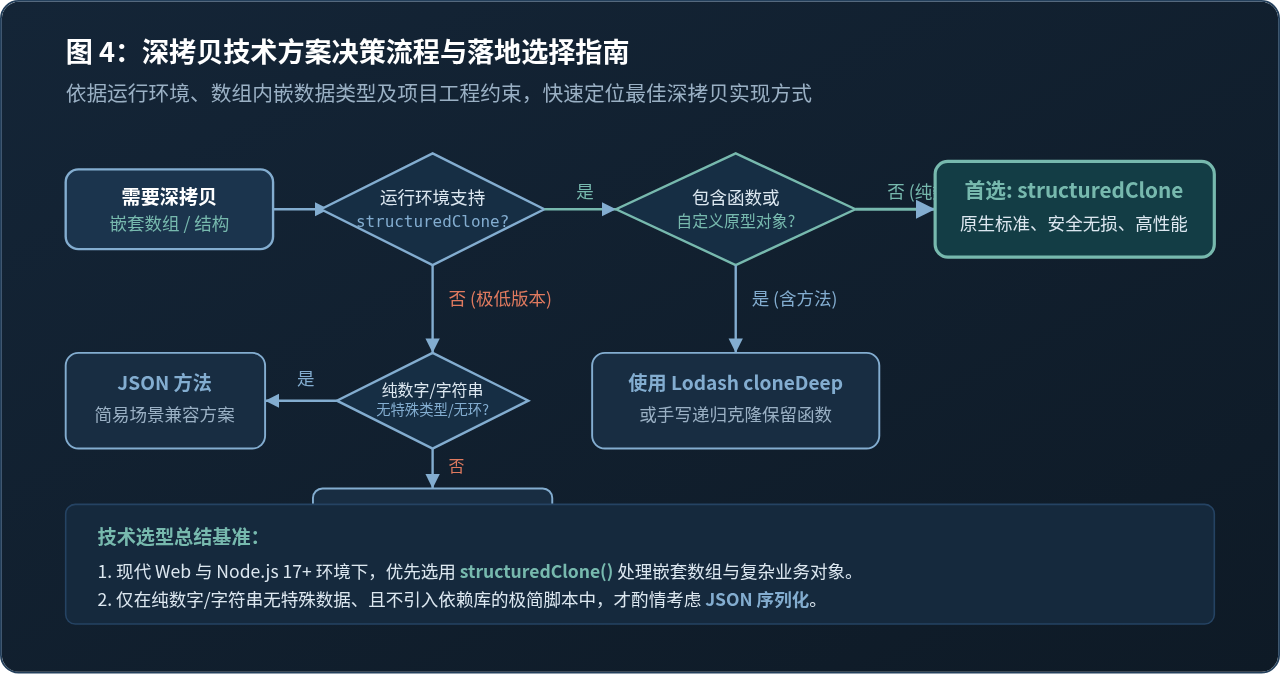
1. 现代化项目(首选 structuredClone)
若你的项目基于现代构建工具(Vite、Next.js、Nuxt 3)且目标运行环境为主流浏览器或 Node.js 18+ LTS,应全面将 structuredClone() 作为处理嵌套数组与复合对象的默认深拷贝工具。它的行为可预测性最高,能够杜绝日期退化、集合丢失等隐蔽的数据变更 Bug。
2. 纯基础类型与老旧浏览器兼容(考虑 JSON 方法)
当需要快速处理纯数字网格(如 LeetCode 刷题中的二维矩阵 [[0,1],[1,0]])、纯字符串配置,且确信数据内部绝不会出现 Date、undefined 或循环引用时,JSON.parse(JSON.stringify(arr)) 依然是一行代码搞定的实用技巧。
3. 兼容老环境的稳妥 Polyfill 方案
如果需要在低版本浏览器(如旧版 WebView)中安全运行,建议在打包流程中引入官方规范的垫片库,例如 core-js:
// 引入 core-js 提供的垫片,全局无感注入 structuredClone
import "core-js/actual/structured-clone";

const copy = structuredClone(legacyNestedArray);只有当嵌套数组内部存放了包含自定义业务方法的对象类实例、闭包函数,或者需要保留复杂的自定义原型继承链时,structuredClone 与 JSON 才均不适用。此时才建议引入 lodash.clonedeep 这类能够自定义克隆策略的三方工具函数。
六、核心总结
- 浅拷贝陷阱:多维数组使用
[...arr]或arr.slice()仅拷贝外层地址,内层数组依然发生引用共享,修改会导致连带副作用。 - JSON 方法局限:
JSON.parse(JSON.stringify(arr))仅适合纯基础类型的嵌套结构;一旦遇到undefined、Date、Set、Map会发生数据丢失,遇到循环引用会直接抛错中断执行。 - 现代首选标准:
structuredClone()是 HTML 官方推荐的原生深拷贝标配,无需外部依赖,原生支持环形引用与常见复合数据类型,是目前 JavaScript 处理嵌套数组深拷贝的最佳实践。
JS含对象数组怎么转成自定义格式字符串
2026-11-20 14:15:56
JS大数组合并性能对比:push、concat还是spread
2026-11-20 12:16:26
JavaScript数组赋值基础:声明、初始化与索引修改
2026-11-20 10:26:18
JavaScript实现原型继承的常见模式及优缺点对比
2026-11-20 09:11:59
ES6 Class能否替代JS闭包:数据封装方案对比
2026-11-20 08:26:56