

遍历HTML元素所有属性的JavaScript实现方法
详细讲解在JavaScript中遍历HTML元素所有属性的四种实现方法,深入剖析NamedNodeMap底层对象模型、迭代器特性、动态集合避坑技巧以及数据对象序列化实战。
attributes 集合或调用 getAttributeNames() 原生方法。通过现代 for...of 语法可以直接解构提取属性键值,借助 Array.from() 能够生成便于函数式处理的不可变快照,而通过 Object.fromEntries() 则能一行代码将全部属性整理为标准键值对象。理解 DOM 的 NamedNodeMap 类数组特性及其动态集合行为,是安全高效操作属性的关键前提。
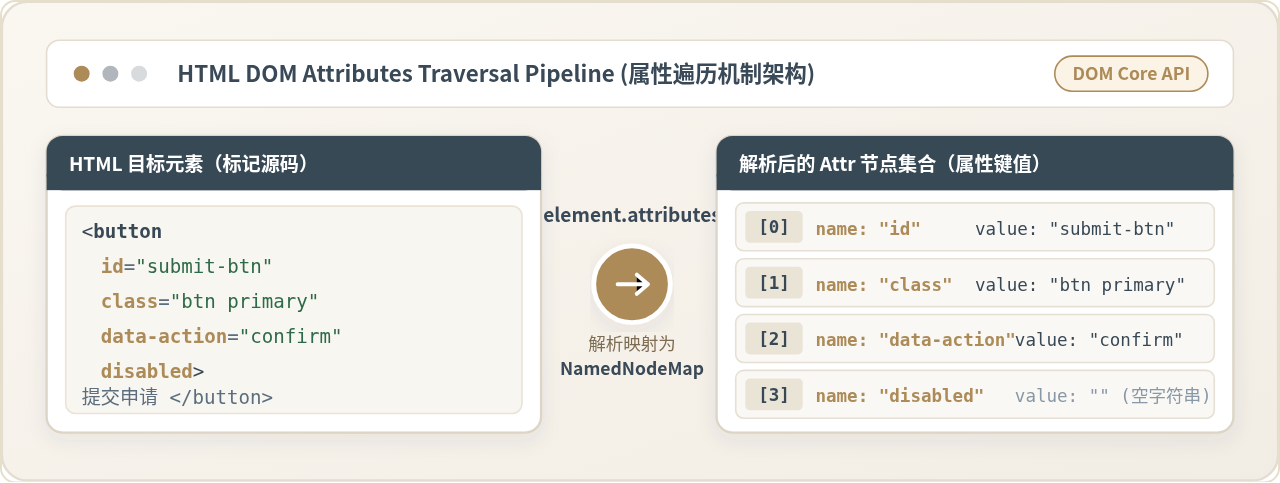
一、DOM 属性的底层载体:认识 NamedNodeMap 与 Attr 节点
在 HTML 文档中,任何写在标签起始部位的键值标记(例如 id="app"、class="container"、data-role="dialog" 以及 disabled)在被浏览器解析后,都会作为该元素节点的属性存储。当我们在 JavaScript 中获取到一个 DOM 元素实例后,访问其 element.attributes 属性,便能获得该元素上定义的所有属性。
需要明确的是,element.attributes 既不是 JavaScript 原生的普通数组(Array),也不是一个纯键值对象(Object),而是一个 NamedNodeMap(命名节点映射表)。
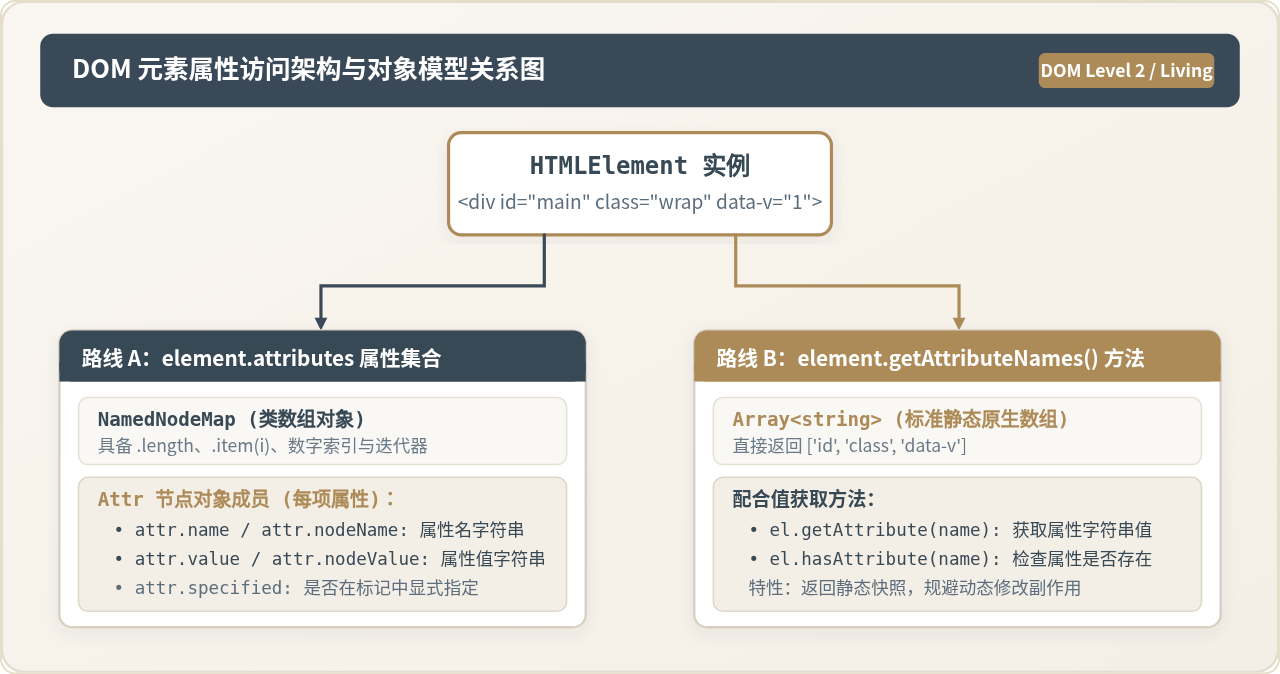
NamedNodeMap 具备以下三个关键的技术特征:
- 类数组对象(Array-like Object):它具有
length属性,并且支持通过从0到length - 1的数字索引直接读取元素,或者调用item(index)方法。 - 每个单元为 Attr 节点:集合中的每一项都是一个独立的 DOM
Attr节点对象,核心包含name(属性名字符串,如"class")和value(属性值字符串,如"btn primary")。 - 实现了迭代协议(Symbol.iterator):在现代 ECMAScript 规范中,
NamedNodeMap原生内置了可迭代协议,这意味着开发者可以直接对它使用for...of循环,或通过扩展运算符与Array.from()展开。
HTML 属性(Attribute)是指写在 HTML 标记中的字符串键值,由
attributes 集合及 getAttribute() 访问;而 DOM 属性(Property)是挂载在 JavaScript 内存中 DOM 对象实例上的普通属性(例如 element.innerHTML、element.onclick、element.style)。遍历 HTML 标记属性时必须使用针对 Attribute 的专用 API,切忌使用 for...in 遍历 DOM 元素实例。
二、遍历 HTML 元素属性的四种实现方法与代码演示
围绕 NamedNodeMap 与现代 DOM 规范,前端开发中共有四种实用、可靠的遍历实现方案。以下我们以一个包含多种代表性属性的 HTML 元素作为统一示例进行详细演示:
<!-- 示例目标 DOM 结构 -->
<input
  id="search-input"
  class="form-control active"
  type="search"
  placeholder="请输入搜索关键词..."
  data-module="header-search"
  data-limit="20"
  autocomplete="off"
  required
>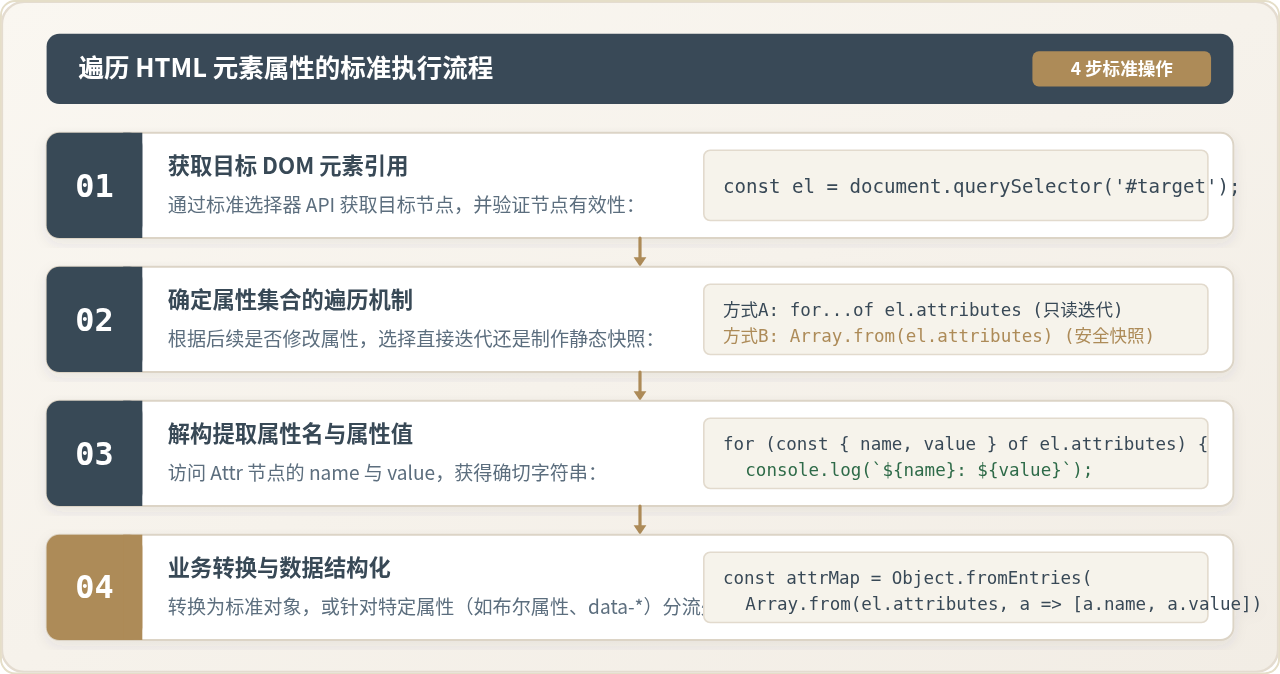
方法 1:使用 for...of 循环直接迭代 attributes(现代开发首选)
这是目前最直观、可读性最高的写法。由于 NamedNodeMap 原生实现了可迭代接口,我们可以直接使用 for...of 循环逐项获取 Attr 节点,并利用对象解构直接提取 name 和 value。
const inputEl = document.querySelector('#search-input');

// 直接利用 for...of 迭代元素属性集合
for (const { name, value } of inputEl.attributes) {
  console.log(`属性名: ${name} | 属性值: ${value}`);
}
控制台示例输出:
属性名: id           | 属性值: search-input
属性名: class        | 属性值: form-control active
属性名: type         | 属性值: search
属性名: placeholder  | 属性值: 请输入搜索关键词...
属性名: data-module  | 属性值: header-search
属性名: data-limit   | 属性值: 20
属性名: autocomplete | 属性值: off
属性名: required     | 属性值:
方法 2:使用 Array.from() 转为普通数组(数据处理利器)
element.attributes 作为一个类数组集合,并不具备原生数组的 map、filter、reduce 等高阶方法。如果我们希望对属性进行过滤筛选、模式匹配,或者将整个元素的所有属性打包成一个标准的 JavaScript 键值对象,先使用 Array.from() 进行浅拷贝是最佳方案。
const inputEl = document.querySelector('#search-input');

// 1. 借助 Array.from 转换为静态数组后使用 forEach
const attrArray = Array.from(inputEl.attributes);
attrArray.forEach(attr => {
  console.log(attr.name, attr.value);
});

// 2. 筛选所有 data-* 自定义数据属性
const dataAttrs = attrArray
  .filter(a => a.name.startsWith('data-'))
  .map(a => ({ key: a.name, val: a.value }));

// 3. 一行代码将全部属性转为纯对象
const attrObject = Object.fromEntries(
  Array.from(inputEl.attributes, a => [a.name, a.value])
);
console.log('属性对象映射:', attrObject);
方法 3:调用原生的 element.getAttributeNames()(字符串数组直接获取)
在较新的 DOM Living Standard 规范中,浏览器为 Element 接口新增了 getAttributeNames() 方法。调用此方法会直接返回一个由当前元素所有属性名称构成的标准 JavaScript 字符串数组(Array<string>)。
const inputEl = document.querySelector('#search-input');

// 直接获取属性名数组并遍历
const names = inputEl.getAttributeNames();

names.forEach(name => {
  const value = inputEl.getAttribute(name);
  console.log(`${name} => ${value}`);
});
此方法的显著优势在于:当业务逻辑只需要检查、收集元素拥有哪些属性名称时,无需实例化或接触 Attr 节点,直接获得了纯字符串数组;在需要值的时候配合标准的 getAttribute(name) 提取即可。
方法 4:传统数字索引 for 循环(经典向下兼容)
对于需要向下兼容非常早期浏览器版本(例如早于 ES6 的旧运行环境),或者在极致追求基础循环指令效率的底层类库中,可以通过 attributes.length 搭配传统 for 循环按索引下标访问。
var inputEl = document.getElementById('search-input');
var attrs = inputEl.attributes;

for (var i = 0; i < attrs.length; i++) {
  var attrNode = attrs[i]; // 亦可写为 attrs.item(i)
  console.log(attrNode.name, attrNode.value);
}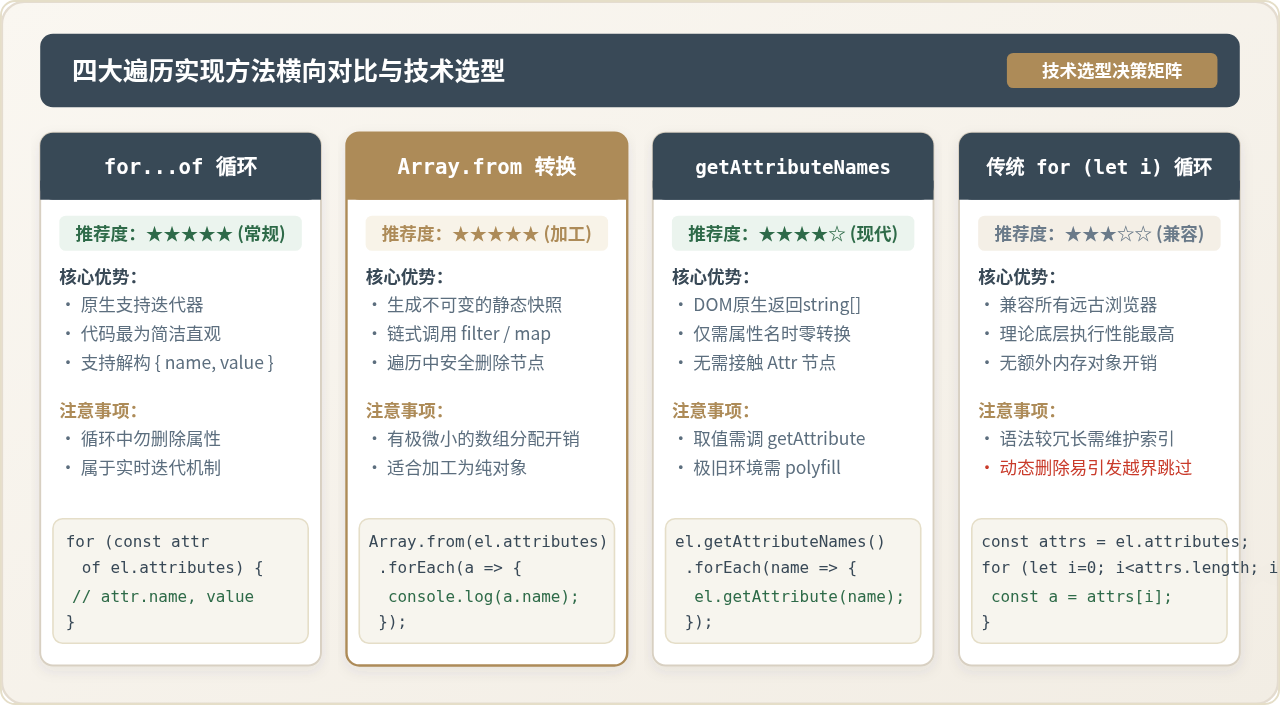
| 遍历方案 | 返回数据形态 | 代码可读性 | 安全性(防修改漂移) | 推荐应用场景 |
|---|---|---|---|---|
for...of 循环 |
逐项产出 Attr 节点 |
极高 (ES6解构) | 需避免循环内删除 | 日常业务只读遍历、属性审查首选 |
Array.from() 数组化 |
转换为标准 Attr[] |
高 (函数式链式) | 极高 (静态快照) | 需 filter/map、修改删除、对象序列化 |
getAttributeNames() |
直接产出 string[] |
极高 (简洁语义) | 极高 (返回静态数组) | 现代标准环境、仅需提取属性名集合 |
传统 for (let i) |
按索引下标读取 | 中 (需维护指针) | 易因实时删改导致跳项 | 极深老旧兼容性要求、超高性能敏感循环 |
三、实战进阶与核心避坑指南
在实际工程实践中,遍历 DOM 属性看似简单,但在处理动态元素修改、布尔属性状态判定以及元素克隆同步时,有几个极为关键的陷阱需要特别关注。
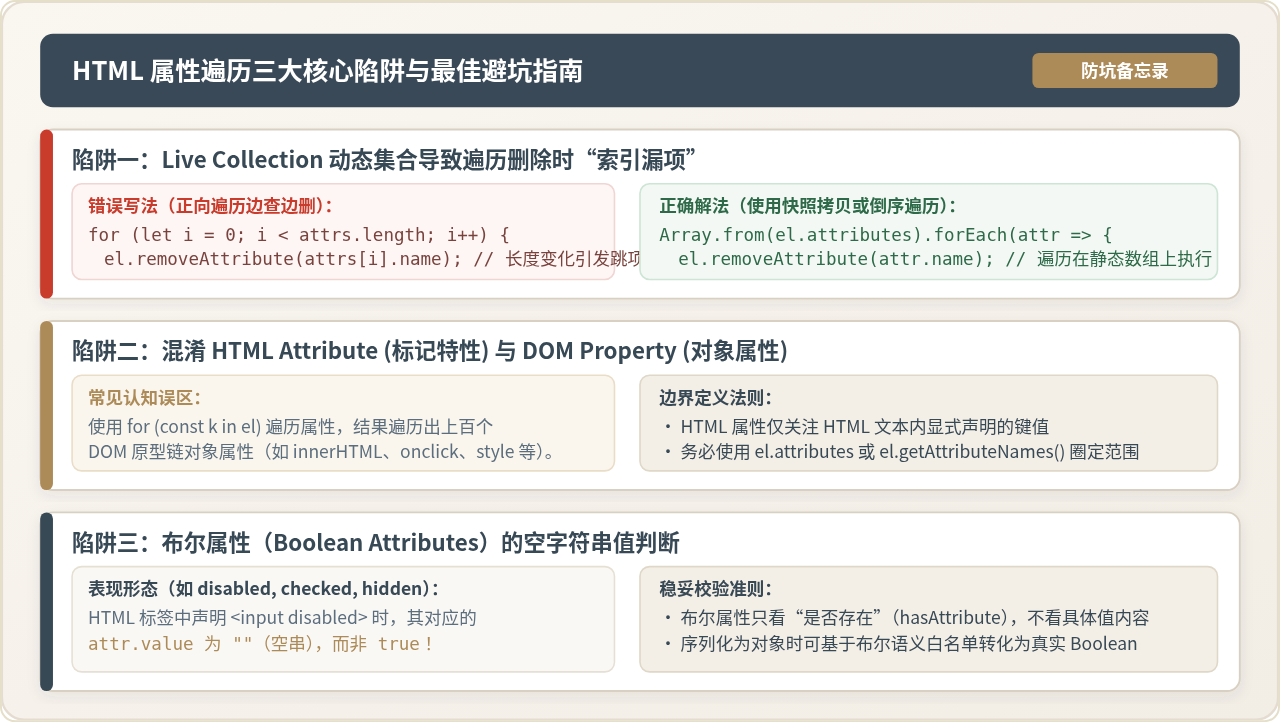
1. 警惕 Live Collection(动态集合)导致的“索引漏项”
element.attributes 属于 DOM 规范中的 实时动态集合(Live Collection)。这意味着一旦你在遍历过程中通过 element.removeAttribute() 移除了某个属性,attributes 内部的长度会立刻减 1,而后方所有的属性节点会自动向前平移一位。
如果使用传统的正向索引 for (let i = 0; i < attrs.length; i++) 边遍历边删除,就会发生灾难性的“漏删”跳项:
当
i = 0 时删除了第 0 项属性,原本处于索引 1 的属性立即往前递补成为了新的索引 0。但在下一轮循环中 i 递增到了 1,导致原本位于第 1 项的属性被直接跳过,未执行删除!
避坑解决方案:
- 推荐:使用 Array.from() 制作静态快照后操作:
// 先通过 Array.from 将动态集合拷贝成不可变的普通数组 Array.from(element.attributes).forEach(attr => { if (attr.name.startsWith('data-')) { element.removeAttribute(attr.name); // 安全,绝不会影响外层数组迭代 } }); - 备选:使用倒序循环:从
length - 1递减到0遍历,删除末尾项不会影响前方尚未访问的元素索引。
2. 布尔属性(Boolean Attributes)的特殊值判定
HTML 规范中有许多布尔属性,如 disabled、checked、readonly、hidden 等。按照 HTML5 规范,只要标签中出现了该属性名,就代表该功能处于开启状态,哪怕其属性值写为 disabled=""、disabled="disabled" 甚至是 disabled="false"。
当遍历 <button disabled> 时,读取出的 attr.value 是空字符串 "",而不是布尔值 true。
// 错误判定:attr.value 为 "",Boolean("") 为 false!
const isDisabled = Boolean(attr.value); // 得到 false,逻辑错误!

// 正确判定:检查元素是否具有该属性
const isDisabledCorrect = el.hasAttribute('disabled'); // 得到 true
3. 自定义数据属性(data-*)的双重遍历机制
所有形如 data-user-id="123" 的属性都会完整出现在 element.attributes 中,其 attr.name 保持原始短横线形式 "data-user-id"。与此对应,现代 DOM 提供了 element.dataset 专门读取这些属性,但它返回的是驼峰命名的键(例如 userId)。
如果你的目标是处理所有 HTML 标记属性,直接使用 attributes 是最全面的;如果只需要处理 data-* 数据,使用 dataset 则更为专一。
四、通用工具函数:将元素所有属性提取为标准化数据对象
在实际项目封装、DOM 序列化、组件克隆或自动化埋点上报中,我们经常需要把一个 HTML 元素的所有属性提取为一个便于序列化或网络传输的纯 JSON 兼容对象。以下提供一个健壮且考虑周全的通用解析函数:
/**
 * 遍历并解析 HTML 元素的所有属性
 * @param {Element} element - 目标 DOM 节点
 * @param {Object} options - 解析选项配置
 * @param {boolean} [options.lowercaseNames=true] - 是否将属性名规范为全小写
 * @param {Array<string>} [options.exclude=[]] - 需要排除忽略的属性黑名单
 * @returns {Record<string, string>} 标准键值对象
 */
function extractElementAttributes(element, options = {}) {
  if (!(element instanceof Element)) {
    throw new TypeError('参数必须是有效的 DOM Element 实例');
  }

  const {
    lowercaseNames = true,
    exclude = []
  } = options;

  const excludeSet = new Set(exclude.map(k => k.toLowerCase()));
  const result = {};

  // 使用 Array.from 建立静态快照遍历,防止潜在的原型污染或动态影响
  for (const { name, value } of Array.from(element.attributes)) {
    const normalizedName = lowercaseNames ? name.toLowerCase() : name;

    // 过滤黑名单属性
    if (excludeSet.has(normalizedName)) {
      continue;
    }

    result[normalizedName] = value;
  }

  return result;
}

// 示例调用:
const btn = document.querySelector('#submit-btn');
const data = extractElementAttributes(btn, {
  exclude: ['style'] // 忽略内联样式属性
});
console.log('提取结果:', JSON.stringify(data, null, 2));
五、技术总结与最佳选型建议
遍历 HTML 元素的属性是前端 DOM 审查与元数据操作的基石技能。在实际技术选型时,可以根据业务侧重快速决策:
- 日常只读打印与调试:直接使用
for (const { name, value } of el.attributes),语法最凝练,直观易懂。 - 需要函数式处理或动态增删:使用
Array.from(el.attributes)转化为标准数组快照,兼具链式操作便利与对 Live 集合的安全性。 - 只需检查拥有哪些属性名:优先使用
el.getAttributeNames(),直接得到纯字符串数组,开销最小。 - 转为 JSON 键值字典:搭配
Object.fromEntries(Array.from(el.attributes, a => [a.name, a.value])),清晰且符合现代 ECMAScript 范式。
JS中scrollTop、scrollHeight与clientHeight的区别
2026-11-19 20:13:20
JS截取图片后怎么转换为Blob对象上传服务器
2026-11-19 19:14:15
JS组件封装中怎么处理样式隔离与事件冲突
2026-11-19 18:44:34
JS设置style基础:element.style对象与驼峰命名转换
2026-11-19 14:32:04
图解JavaScript事件循环:调用栈、Web APIs与任务队列的协作机制
2026-11-19 13:05:33







