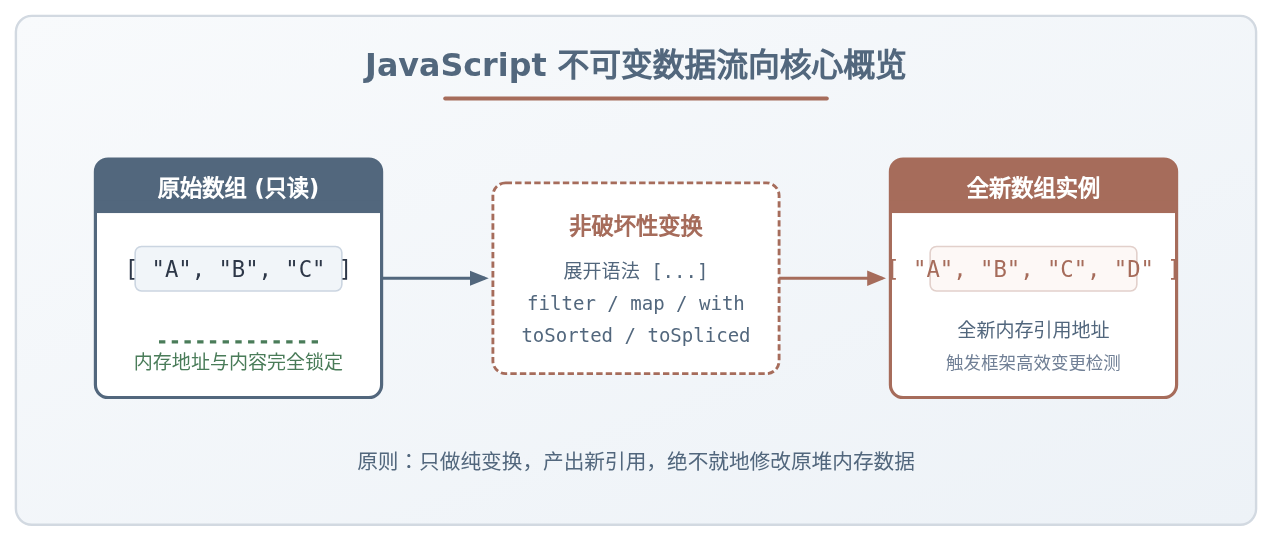
JS不修改原数组进行排序的最佳实践
深入讲解JavaScript在不修改原数组的前提下进行安全排序的最佳实践,剖析ES2023 toSorted()、展开语法与slice()机制,防范状态突变与浅拷贝深层陷阱。
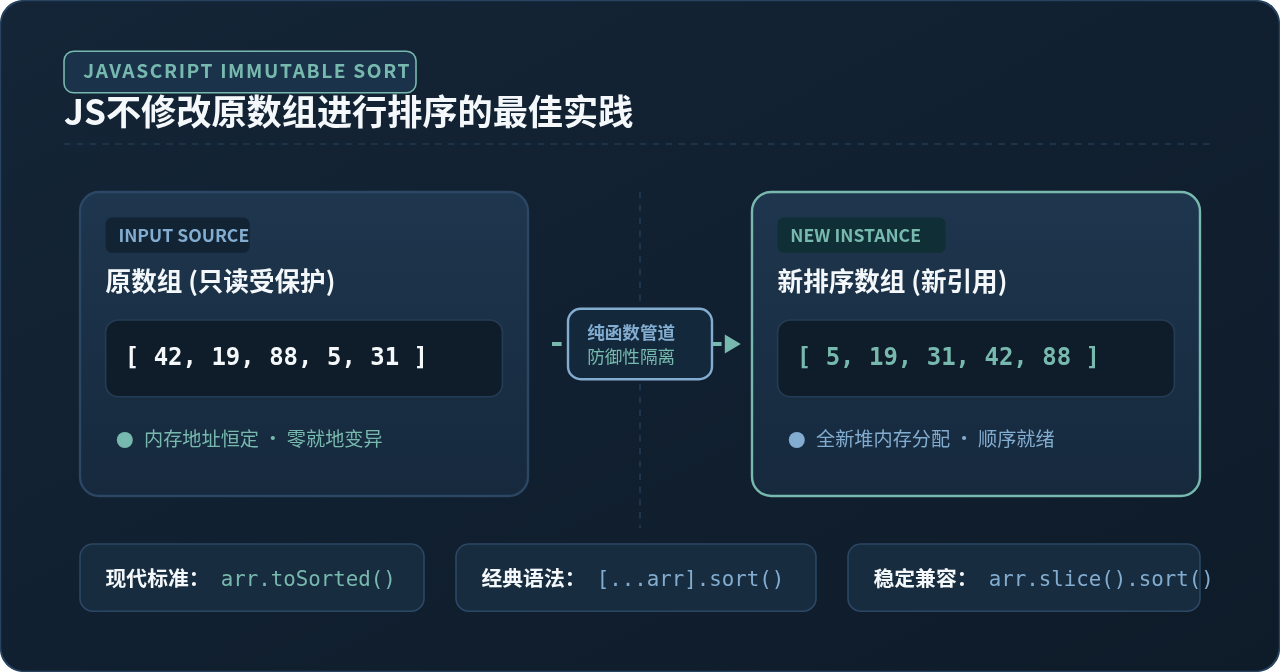
假设你正在开发一个前端仪表盘,从后端接口获取了一组按创建时间排列的订单列表,保存在全局状态或 React useState 中。当用户点击“按金额排序”按钮时,如果开发人员随手写下 orders.sort((a, b) => a.amount - b.amount),页面可能会立即出现诡异现象:原始的时间顺序被永久覆盖、下游依赖该数组的子组件无法感知数据更新,或者在某些需要复原顺序的筛选操作中彻底丢失了初始数据。
核心原因在于:JavaScript 原生的 Array.prototype.sort() 是一个破坏性就地修改方法(In-place Mutation)。它不会返回新数组,而是直接覆写原有内存指针中的数据槽位。在现代单向数据流与响应式框架(如 React、Vue 3、Redux)普及的背景下,不修改原数组进行安全排序(Immutable Sorting)已成为前端工程化中的必备硬性规范。本文将系统拆解这一问题的本质根源、现代原生规范与经典方案,并给出生产环境下的完整最佳实践选型指南。
一、为什么直接使用 sort() 会造成副作用?
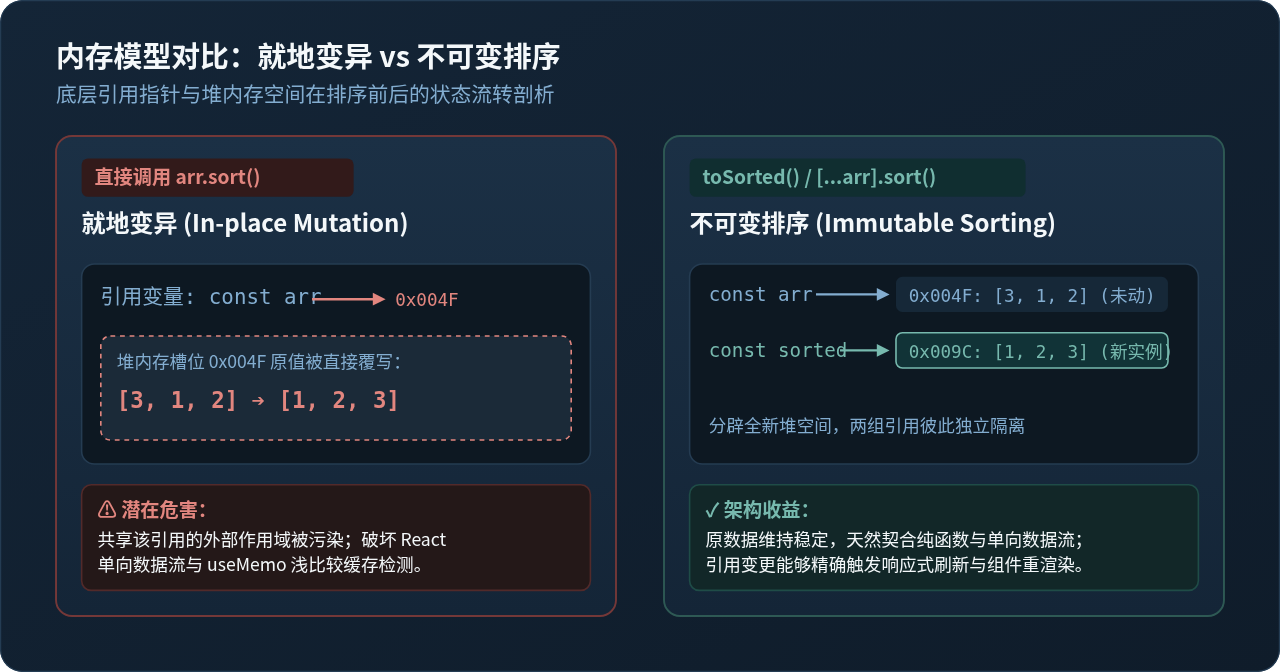
要深刻理解不可变排序的必要性,首先需要看清原生 sort() 的底层行为。在 ECMAScript 规范定义中,Array.prototype.sort() 的操作直接作用于 this 对象的内部槽位,其返回值仅仅是同一个数组的引用(即 arr.sort(...) === arr 结果恒为 true)。
const rawScores = [85, 42, 99, 63];
const sortedScores = rawScores.sort((a, b) => a - b);

console.log(sortedScores); // 示例输出:[42, 63, 85, 99]
console.log(rawScores);    // 示例输出:[42, 63, 85, 99](原数组已被无声篡改!)
console.log(rawScores === sortedScores); // 示例输出:true(二者共享完全相同的内存指针)
这种直接修改原内存槽位的行为,在工程开发中主要引发两类严重缺陷:
- 破坏引用透明性(Referential Transparency):外部函数无法信任传入的数组是安全的。若函数 A 与函数 B 共享同一个数组,函数 A 的排序动作将直接导致函数 B 获取到完全非预期的顺序。
- 击穿响应式依赖检测:React 的
useMemo、memo以及 Redux 等状态管理工具依赖浅比较(prev !== next)来决定是否触发重渲染或更新缓存。若就地修改数组,前后引用完全一致,框架将判定状态未发生变化,导致 UI 视图静默不更新。
二、现代原生标准:ECMAScript 2023 的 toSorted()
为了从语言核心层面终结数组修改的原生副作用,ECMAScript 2023(ES14)正式标准化了四个全新的“修改时复制(Change Array by Copy)”方法,其中用于排序的核心方法便是 Array.prototype.toSorted()。
1. 语法与行为特征
toSorted() 的传参与原生 sort() 完全相同,接受一个可选的比较函数 compareFn。与 sort() 的根本区别在于:它首先在底层分配一个全新的数组实例,将元素拷贝后在独立空间内完成排序,最后返回新数组,原数组毫发无损。
const baselineNumbers = [50, 12, 89, 3];

// 使用 ES2023 原生 toSorted 进行无副作用排序
const orderedNumbers = baselineNumbers.toSorted((a, b) => a - b);

console.log(baselineNumbers); // 示例输出:[50, 12, 89, 3](原始顺序完好无损)
console.log(orderedNumbers);  // 示例输出:[3, 12, 50, 89](生成独立的新有序数组)
console.log(baselineNumbers === orderedNumbers); // 示例输出:false
2. 运行环境支持与降级策略
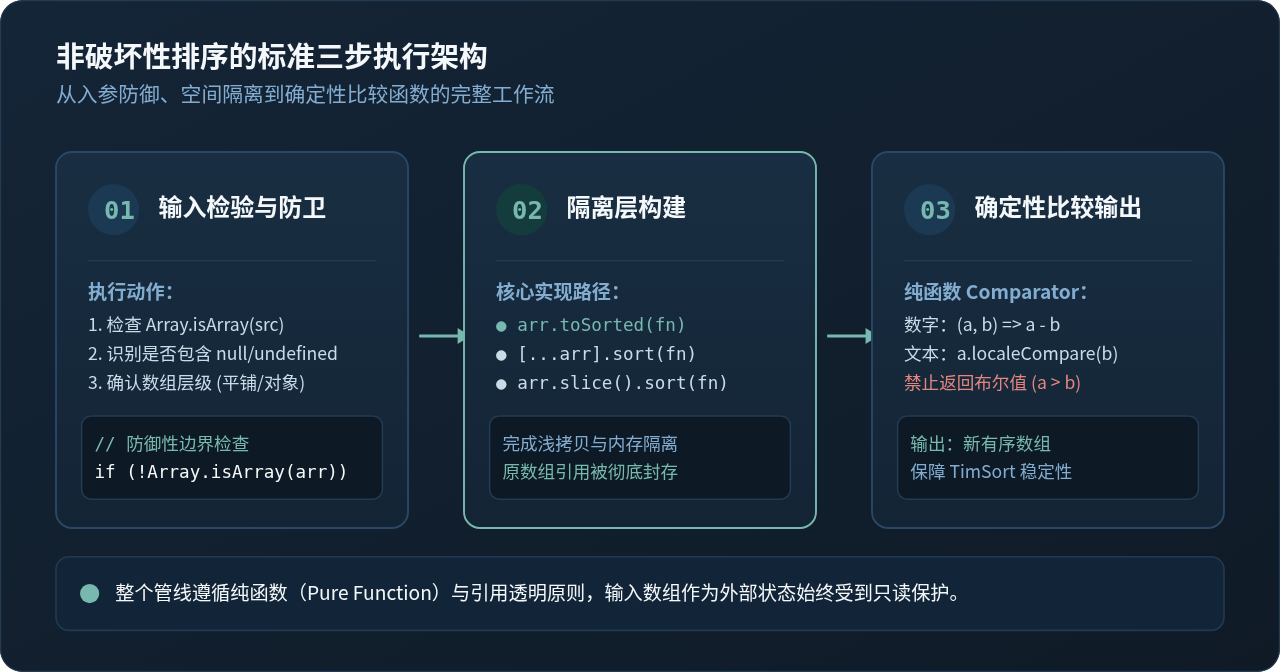
目前各大主流引擎均已内置全面支持 toSorted()(包括 Node.js 20+、Chrome 110+、Safari 16.4+、Firefox 115+)。若项目需要兼容较旧的客户端环境,可在入口文件中通过 core-js 引入 Polyfill,或使用如下防卫性封装函数:
function safeSort(array, compareFn) {
  if (!Array.isArray(array)) {
    throw new TypeError("Expected an Array as input");
  }
  // 优先使用原生 toSorted,不存在时优雅降级为浅拷贝排序
  if (typeof array.toSorted === "function") {
    return array.toSorted(compareFn);
  }
  return array.slice().sort(compareFn);
}
三、经典兼容方案:浅拷贝后的防御性排序
在 ES2023 广泛推行之前,业内通行的不可变排序准则是“先拷贝,再排序”。通过在排序执行前创建数组浅拷贝(Shallow Copy),让 sort() 的就地修改作用于拷贝出来的影子数组上,从而实现对原数据的间接保护。
方案 1:展开运算符语法 [...arr].sort(...)
ES6 引入的展开语法(Spread Operator)是目前业务代码中使用频率最高、语义极其直观的写法:
const items = ["banana", "apple", "cherry"];
const sortedItems = [...items].sort((a, b) => a.localeCompare(b));优点:语法极简、契合现代前端团队风格。适用场景:常规页面级业务数据(长度在数千以内)。
方案 2:数组切片方法 arr.slice().sort(...)
slice() 是自 JavaScript 早期(ES3)便存在的原生切片方法。当不传参数调用 arr.slice() 时,它会返回当前数组完整区间的浅拷贝副本:
const metrics = [404, 200, 500, 301];
const ascendingMetrics = metrics.slice().sort((a, b) => a - b);性能与底层差异:展开运算符 [...arr] 需要通过调用迭代器协议(Symbol.iterator)逐项取出元素推入新数组,伴随迭代器对象的初始化开销;而 arr.slice() 在 V8 引擎底层是直接执行连续内存块复制(Fast Elements Copy)。在面对包含数万乃至数十万项的大数组时,slice().sort() 的执行耗时与内存开销明显优于 [...arr]。
四、对象数组排序的陷阱:浅拷贝与深层引用
toSorted()、[...arr] 还是 arr.slice(),它们创建的都仅仅是浅拷贝(Shallow Clone)。
浅拷贝只复制了最外层数组包含的指针槽位。如果数组内部元素是引用类型(如 Plain Object、Class 实例),新数组中的项依然与原数组中的项指向同一块对象堆内存。
const userList = [
  { id: 101, name: "Alice", score: 78 },
  { id: 102, name: "Bob", score: 92 }
];

// 进行不可变排序
const rankList = userList.toSorted((a, b) => b.score - a.score);

// 此时虽然 rankList !== userList,但元素对象是共享的!
rankList[0].score = 100; // 危险!直接污染了原 userList[1] 的内部属性
console.log(userList[1].score); // 示例输出:100防御准则:如果你的业务逻辑仅对列表重新排列展示(只读消费),浅拷贝已足够安全且性能最优;但如果后续流程需要同时修改排完序的元素属性,必须采用深拷贝(如原生 structuredClone())或借助 Immer 产出全不可变数据树。
规范的自定义比较器编写指南
编写排序比较函数时,必须严格遵守返回负数、零、正数的三态契约,不可返回布尔值:
- 数值安全排序:使用
(a, b) => a - b(升序)或b - a(降序)。注意如果数值范围可能存在NaN或极大浮点跨度,推荐使用显式大小判定以避免精度溢出。 - 文本国际化排序:字符串绝对不能直接相减,必须调用
localeCompare:(a, b) => a.name.localeCompare(b.name, 'zh-Hans-CN')。 - 排序稳定性(Stability):现代 ECMAScript 规范已全面强制要求数组排序算法必须是稳定排序(Stable Sort)(V8 已采用 TimSort 算法)。当两项比较结果返回
0时,它们在原数组中的相对先后顺序将严格得到保留。
五、工程化场景选型与架构最佳实践
在实际企业级应用开发中,面对多样化的运行基建与状态管理方案,应依据清晰的技术选型路径来落地非破坏性排序:
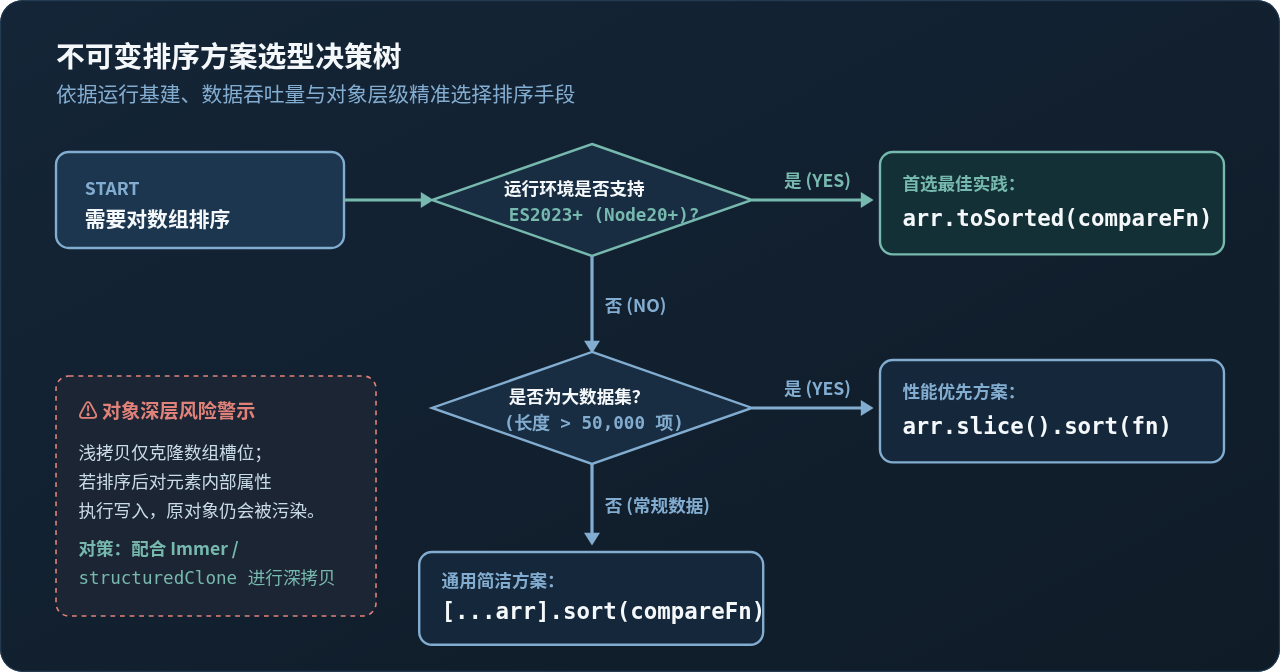
1. 在 React 组件与状态管理中的最佳实践
在 React 中,排序数据通常属于派生状态(Derived State)。强烈建议不要在 useEffect 中把排序结果二次 setState,而应当配合 useMemo 进行记忆化派生:
import React, { useMemo } from "react";

function ProductTable({ products, sortOrder }) {
  // 纯函数派生:依赖变更时才触发全新不可变排序
  const sortedProducts = useMemo(() => {
    if (!products || products.length === 0) return [];

    // 优先使用 toSorted 确保原 props.products 不受丝毫影响
    return products.toSorted((a, b) => {
      const diff = a.price - b.price;
      return sortOrder === "asc" ? diff : -diff;
    });
  }, [products, sortOrder]);

  return (
    <ul>
      {sortedProducts.map(item => (
        <li key={item.id}>{item.title} - ¥{item.price}</li>
      ))}
    </ul>
  );
}
2. 在 Vue 3 计算属性中的最佳实践
Vue 3 的 ref 和 reactive 具备深度依赖收集。若在 computed 内部直接对响应式数组调用 .sort(),会触发极具破坏性的无限循环更新警告(因为排序修改了响应式数组自身,立即再次触发该 computed 重新计算)。必须采用不可变方式:
import { ref, computed } from "vue";

const rawList = ref([{ score: 90 }, { score: 65 }, { score: 82 }]);

// 正确做法:computed 内部使用 toSorted 产出新数组,切断变异依赖死循环
const sortedList = computed(() => {
  return rawList.value.toSorted((a, b) => a.score - b.score);
});
六、代码审查与方案速查矩阵
为了在工程团队中统一认知,避免低级缺陷溜入生产分支,可通过以下矩阵对主流方案的特性、开销与风险进行全景对照:
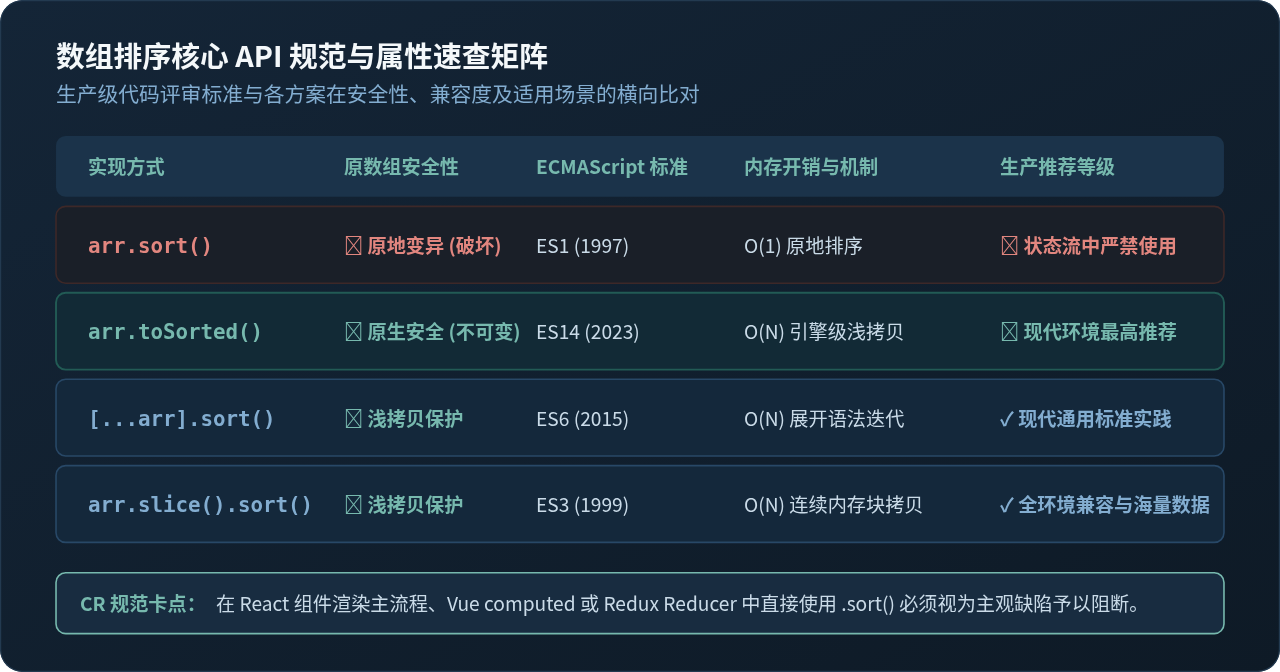
props 传递、Vue reactive/ref、React state 或全局 Store 的代码提交中,严禁出现没有任何拷贝前置的直接 .sort()。遇到 ES2023+ 环境一律统一为 arr.toSorted(),低版本基建环境强制使用 [...arr].sort() 或 arr.slice().sort()。
结语
在 JavaScript 中保持数据的不可变性,不仅是函数式编程的核心思想,更是现代前端工程构建可预测、易调试、高内聚系统的一致要求。Array.prototype.sort() 的历史原地变异设计在当下的工程架构中极易诱发隐蔽的状态污染缺陷。掌握并优先采用 toSorted(),在旧基建中熟练运用 slice() 和展开语法进行防御性隔离,是每一位 JavaScript 工程师在编写高质量数据处理管线时的基石操作。
JS算法题中利用Map和Set优化时间复杂度的技巧
2026-11-19 23:13:54
JavaScript不修改原数组的排序实现方法
2026-11-19 22:28:56
JavaScript高级程序设计中的闭包与作用域链重点梳理
2026-11-19 22:17:34
JavaScript字符串转大写:toUpperCase()基础用法与示例
2026-11-19 21:40:05
JSON.stringify()与join()在JS数组转字符串场景下的选择
2026-11-19 20:17:02