

JS提取数字时怎么保留小数点和负号
在JavaScript中从字符串提取包含负号和小数点的数字时,不能仅做简单字符过滤。本文详解使用结构化正则表达式匹配并转换带符号浮点数的完整步骤、核心语法与边界处理。
/-?\d+(?:\.\d+)?/g 配合 match() 方法匹配出符合数值语法的完整片段,再结合空值防御机制与 parseFloat() 或 Number() 将匹配文本转换为真正具有数学意义的数值类型。
一、常见提取方法的局限与辨析
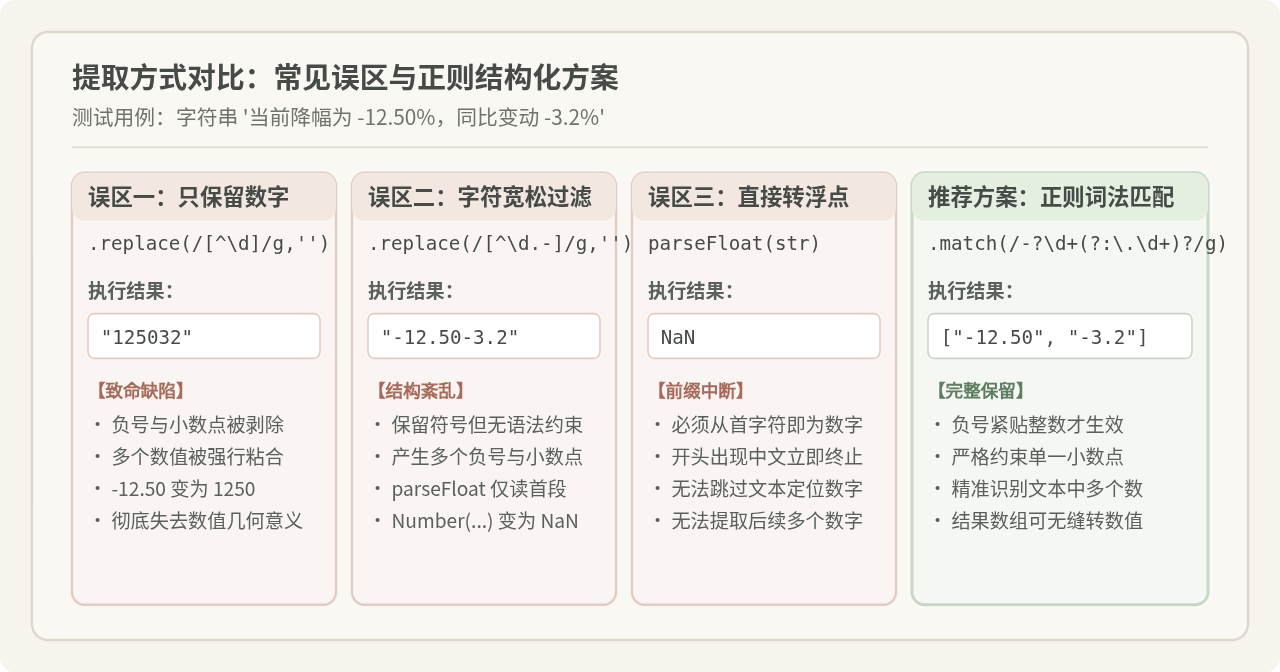
在处理诸如 "当前温度为 -12.5℃,环比变动 -3.2%" 这类文本时,初学者往往会尝试一些看似直观的快捷手段,但往往会引入难以察觉的计算逻辑错误。下面辨析三种最具代表性的尝试及其问题本质。
1. 误区一:使用 replace(/[^\d]/g, '') 过滤非数字
这种做法通常用来提取纯数字编号、电话号码或纯整数场景。它的逻辑是“字符黑名单”机制,把所有非 0-9 的字符一律删去。然而,负号 - 和小数点 . 也是非数字字符,会被同步删除。输入 "-12.5",处理后的字符串会变成 "125",负号丢失且数值放大了十倍,原本代表负降幅的数据变成了巨大的正整数。
2. 误区二:宽松放行 replace(/[^\d.-]/g, '') 的二次陷阱
有些开发者为了保住符号,将正则改写为 /[^\d.-]/g,允许保留点号和负号。这种方法在字符串严格只包含“一个负数”时看似有效,但一旦文本中包含多个数值、短横线标点或版本号,它就会暴露出缺乏语法约束的致命弱点。例如处理 "第-1组:偏差-0.85",替换后会得到 "-1-0.85";输入 "版本1.2.0降价-5.5" 会得到 "1.2.0-5.5"。这一连串散落的点和负号连接在一起,已经不再是合法数字,随后执行 Number() 会直接输出 NaN。
3. 误区三:直接使用全局 parseFloat() 解析
parseFloat() 本身确实能够解析负号与小数,但它的解析规则要求有效数字必须位于字符串开头(允许前导空格)。如果待解析字符串前面有汉字或字母(例如 "余额: -250.60元"),parseFloat 在遇到第一个汉字“余”时就判定不符合数字格式,直接返回 NaN,根本无法穿透前置文字去提取后面的数字。
二、核心正则表达式的语法构成与原理
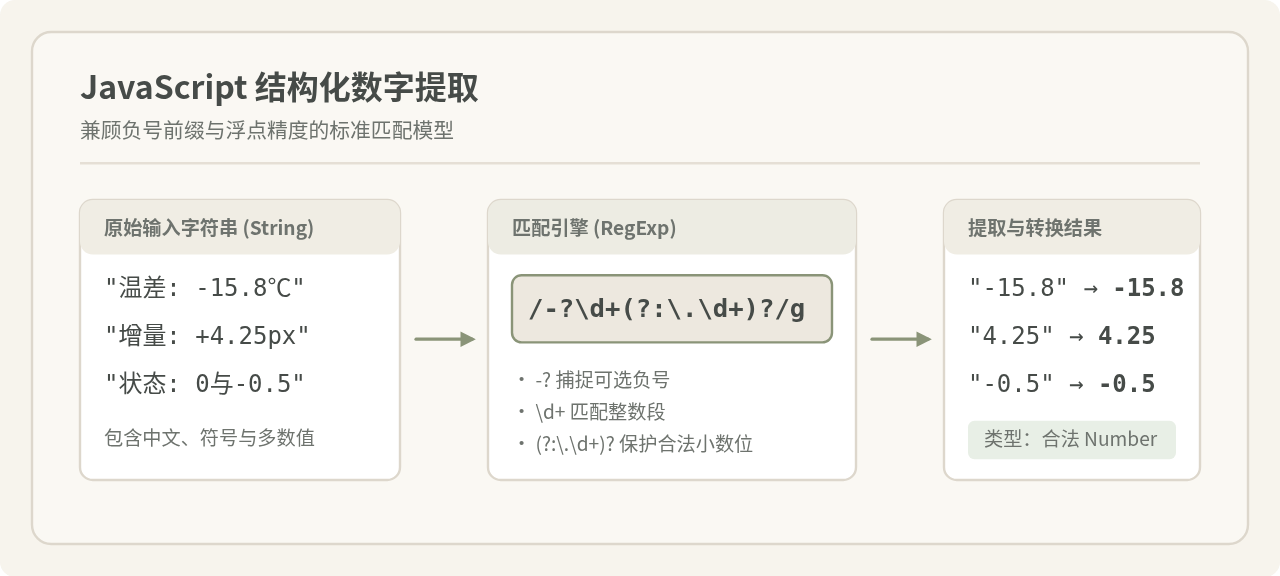
要想精准提取保留负号和小数点的数字,关键在于让正则表达式具备“识别完整数值语法结构”的能力,而不是做无上下文的单字符替换。推荐的标准表达式为:
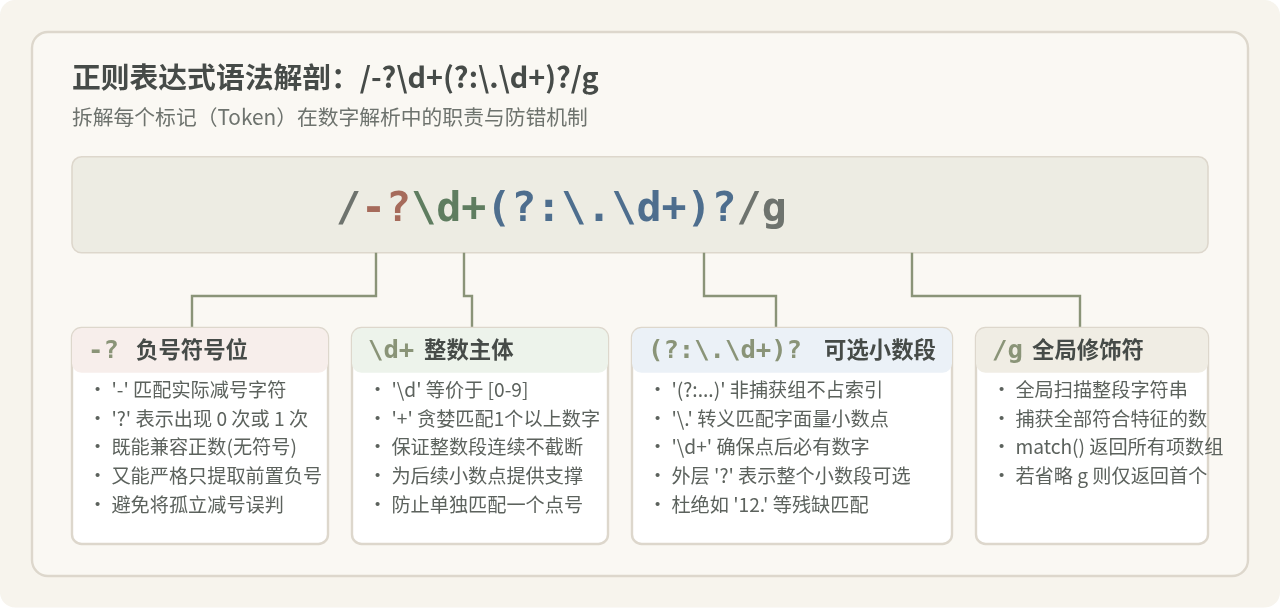
const numberRegex = /-?\d+(?:\.\d+)?/g;该正则表达式可以严密拆解为三个阶段的语法检查:
-
符号位
-?: 连字符-匹配实际的减号/负号,随后的量词?代表“出现 0 次或 1 次”。如果数字带有负号则保留;如果是普通正数,则跳过符号位,不会强制要求必须存在负号。 -
整数段
\d+:\d匹配单个数字字符(0-9),量词+匹配 1 个或多个连续数字。它确保了负号后面紧跟的是真实的整数主体,有效避免了将单独的标点破折号识别为数字。 -
小数段
(?:\.\d+)?: 这里由三部分精密配合构成:\.:由于点号在正则中代表任意字符,因此必须加上反斜杠转义,表示字面量小数点;\d+:小数点后必须紧随至少一个数字,这样能防止匹配如"12."这种不规范的末尾点号;(?: ... ):非捕获分组(Non-capturing Group)。它的作用是将“点和小数位”绑定为一个原子整体,但不会在正则引擎中单独生成捕获项;- 末尾的
?:代表整组小数结构也是可选的。如果是整数,该结构匹配 0 次;如果是小数,则整体保留。
-
全局修饰符
g: 如果只需要提取文本中的第一个数字,可以去掉g;如果文本中包含多个数值需要全部获取,则加上g。
三、提取与数值转换的标准四步流程
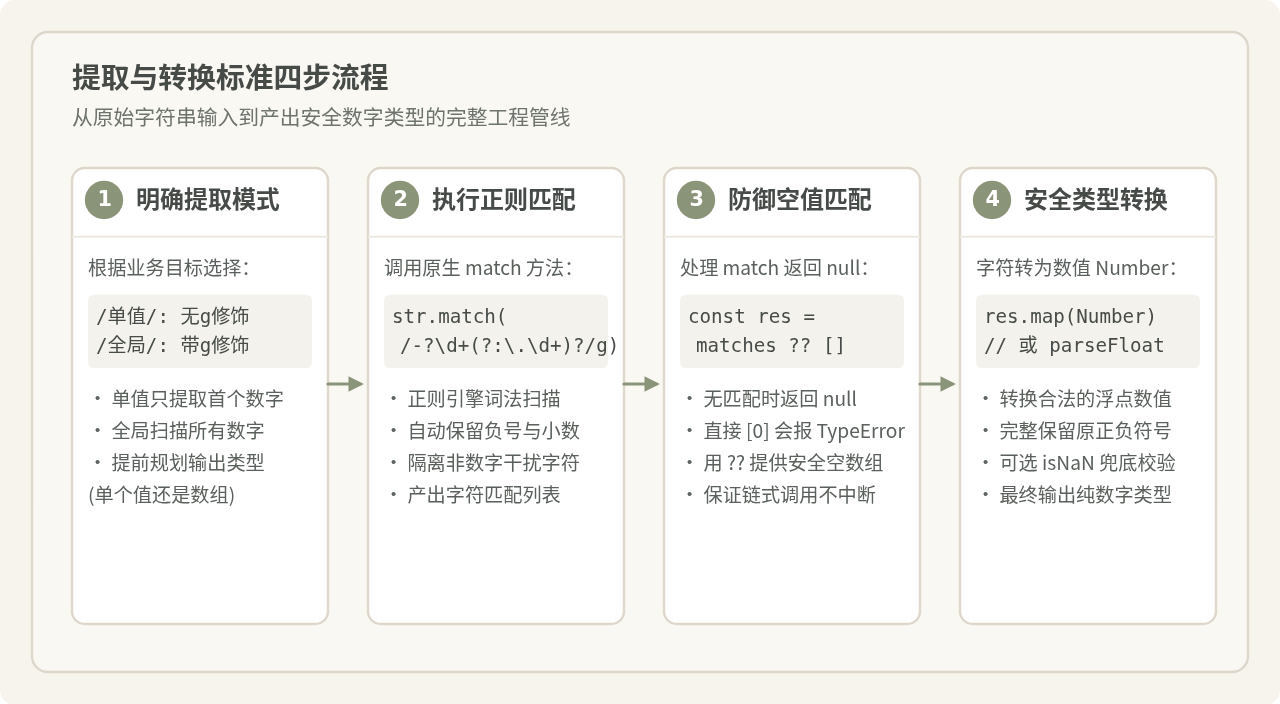
仅通过正则得到字符串还不够,在实际业务工程中,完整的处理管线还需要兼顾空匹配防御与类型转换。推荐遵循以下四个标准操作步骤:
步骤 1:明确提取目标(单值 vs 多值)
在写代码前,先确定业务场景是“只要文本里出现的第一个数字”,还是“提取文中所有的数值列表”。根据目标选择是否携带全局标志符 g。
步骤 2:执行正则匹配
使用字符串的原生 match() 方法。当使用带有 g 的正则时,match() 会直接返回一个包含所有匹配字符串的数组。
// 示例代码:执行多值匹配
const text = "今日气温偏离基准:早间 -3.5℃,午间 12℃,晚间 -0.8℃。";
const rawMatches = text.match(/-?\d+(?:\.\d+)?/g);
// 输出:["-3.5", "12", "-0.8"]
步骤 3:防御 null 并设置默认值
这是生产环境中最容易导致崩溃的盲点:当文本中没有任何数字时,str.match() 会返回 null 而非空数组 []。如果直接对结果执行 [0] 或调用数组的 .map(),会触发 TypeError: Cannot read properties of null。因此必须使用空值合并操作符 ?? 提供默认值。
// 空值兜底保障
const safeMatches = text.match(/-?\d+(?:\.\d+)?/g) ?? [];
步骤 4:类型转换与数值校验
提取出的内容仍为 string 类型(如 "-3.5")。如果后续需要用于计算、图表绘制或存储,应调用 Number() 或 parseFloat() 进行数值化:
// 将匹配到的字符串数组批量转为 Number 类型
const numbers = safeMatches.map(item => Number(item));
// 输出:[-3.5, 12, -0.8]将上述四步封装为通用的纯函数,方便在项目中各模块稳定复用:
/**
 * 从文本中安全提取所有数字(保留负号与小数点)
 * @param {string} input - 输入字符串
 * @returns {number[]} 提取得到的数值数组,未匹配到返回空数组
 */
function extractNumbers(input) {
  if (typeof input !== 'string') return [];
  const matches = input.match(/-?\d+(?:\.\d+)?/g);
  if (!matches) return [];
  return matches.map(Number);
}

/**
 * 提取文本中的第一个数字(保留负号与小数点)
 * @param {string} input - 输入字符串
 * @param {number|null} fallback - 未匹配时的默认返回值
 * @returns {number|null}
 */
function extractFirstNumber(input, fallback = null) {
  if (typeof input !== 'string') return fallback;
  const match = input.match(/-?\d+(?:\.\d+)?/);
  return match ? Number(match[0]) : fallback;
}

// 验证示例
console.log(extractNumbers("冷库A:-18.5度,备用库:0度,加热区:+24.6度"));
// 示例输出: [-18.5, 0, 24.6]

console.log(extractFirstNumber("预计亏损 -1024.50 元"));
// 示例输出: -1024.5

console.log(extractFirstNumber("纯中文描述无数字", 0));
// 示例输出: 0
四、特殊边界场景与对应解决方案
在实际项目和真实用户输入中,数据格式往往并不完全规范。以下列出四种典型边界场景及其应对策略。
1. 场景一:省略前导 0 的小数(如 -.5、.75)
在 CSS 属性或部分科学记账中,有时会省略整数位的 0,例如 margin: -.5rem。前面的正则 \d+ 要求必须有至少一位整数,因而会漏掉 -.5。如果需要兼容这种写法,可调整为:
// 兼容前导零省略的小数:匹配 \d*\.\d+ 或者 \d+
const looseNumberRegex = /-?(?:\d*\.\d+|\d+)/g;

const cssText = "transform: translate(-.5px, 12.8px)";
console.log(cssText.match(looseNumberRegex));
// 示例输出: ["-.5", "12.8"]
// 执行 Number("-.5") 能够被 JS 原生正确解析为 -0.5
2. 场景二:负号与数字之间夹杂空格或货币符号(如 - $15.5)
财务文本中经常出现 "扣费: -¥50.00" 或 "- $12.30"。如果直接用标准正则,会把 - 视作独立符号遗弃,只提取出 50.00,从而丢失负值信息。对于此类场景,应先做规整化替换,把负号与数字之间的符号或空格移除,再进行提取:
function extractFinancialNumber(text) {
  // 将类似 "- ¥"、"- $" 规整化为 "-"
  const normalized = text.replace(/-\s*[$¥¥€£]\s*/g, '-');
  const match = normalized.match(/-?\d+(?:\.\d+)?/);
  return match ? Number(match[0]) : null;
}

console.log(extractFinancialNumber("账户结余: - ¥125.80 元"));
// 示例输出: -125.8
3. 场景三:包含千分位逗号的数字(如 -1,250,000.50)
千分位逗号会截断 \d+,导致 "-1,250,000.50" 被切碎为 ["-1", "250", "000.50"]。处理大额千分位数值时,如果字符串中没有其他英文逗号并列,可先移除数字间的逗号:
function extractWithCommas(text) {
  // 匹配位于数字之间的逗号并移除
  const cleaned = text.replace(/(?<=\d),(?=\d)/g, '');
  return cleaned.match(/-?\d+(?:\.\d+)?/g)?.map(Number) ?? [];
}

console.log(extractWithCommas("总额: -1,234,567.89,准备金: 50,000"));
// 示例输出: [-1234567.89, 50000]
4. 场景四:科学计数法(如 -1.25e-4)
如果文本来源于传感器数据日志或科研系统,数值可能带有指数标志(e 或 E)。此时需在小数后扩展指数捕获:
// 扩展支持科学计数法的正则
const scientificRegex = /-?\d+(?:\.\d+)?(?:[eE][+-]?\d+)?/g;
const sensorLog = "偏差: -3.5e-3, 峰值: 1.2E4";
console.log(sensorLog.match(scientificRegex)?.map(Number));
// 示例输出: [-0.0035, 12000]
五、方案选型与技术总结
从混杂文本中提取数字的核心准则是:优先依靠模式匹配(Pattern Matching)精确定位合法的数字 Token,坚决避免无上下文约束的字符剔除(Character Replacing)。
| 目标场景 | 推荐正则表达式 / 处理策略 | 典型输入示例 | 输出转换结果 |
|---|---|---|---|
| 标准整数与浮点数(保留正负号) | /-?\d+(?:\.\d+)?/g |
"温差 -15.6℃ 到 4.2℃" |
[-15.6, 4.2] |
| 允许省略前导零的浮点数 | /-?(?:\d*\.\d+|\d+)/g |
"增量 -.5px 与 .8px" |
[-0.5, 0.8] |
| 单值提取(只取第一个数值) | /-?\d+(?:\.\d+)?/(省略 g) |
"误差 -0.05mm 需校准" |
-0.05 |
| 财务千分位与货币文本 | 预处理去除逗号/货币符后正则提取 | "支出 -¥1,200.50 元" |
-1200.5 |
| 科学计数法日志 | /-?\d+(?:\.\d+)?(?:[eE][+-]?\d+)?/g |
"漂移率 -2.4e-5" |
-0.000024 |
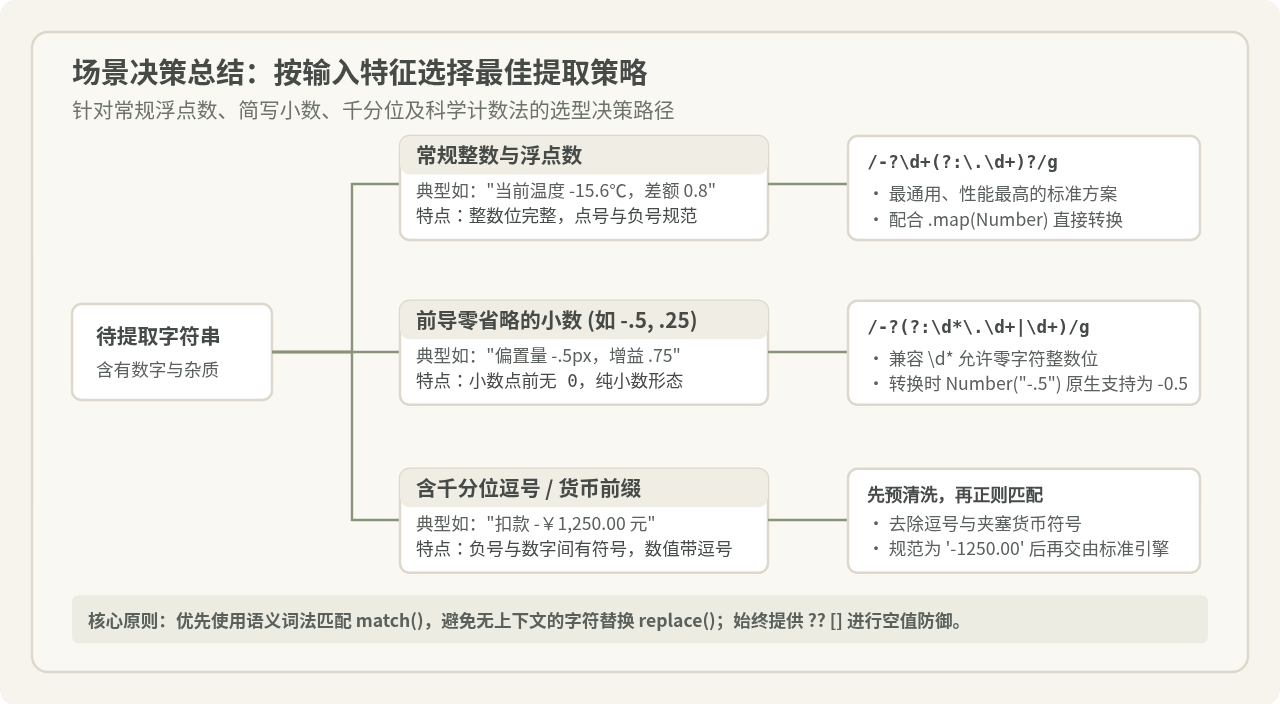
在实际编写业务逻辑时,切记为 match() 方法的返回值提供空值合并保底(?? []),并使用 Number() 或 parseFloat() 将最终匹配的字符串切片安全地实例化为 JavaScript 的原生数值类型,以确保计算安全与代码健壮。
JS字符串排序怎么忽略大小写?
2026-11-19 18:14:41
JS利用返回对象实现多值返回与解构赋值技巧
2026-11-19 17:58:30
JS计算时间差出现负数或时区误差怎么解决
2026-11-19 15:55:52
JS闭包与普通函数的区别:作用域访问机制对比
2026-11-19 15:50:18
JavaScript正则贪婪与非贪婪匹配原理及避坑指南
2026-11-19 14:55:41







