

JS使用URL对象解析域名、路径和参数
深入讲解在 JavaScript 中使用原生 WHATWG URL 对象及 URLSearchParams 规范化解析网络地址的完整方案,涵盖域名、端口、路径和查询参数的安全提取、避坑细节与最佳实践。
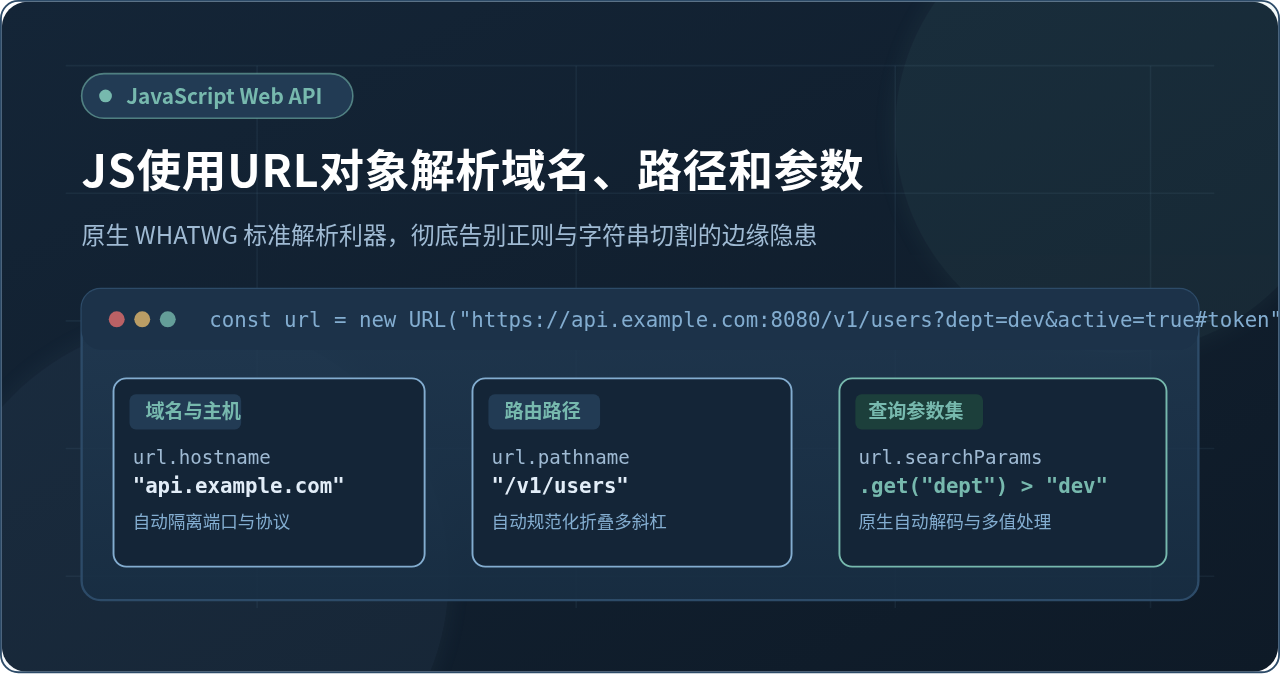
https://api.example.com:8080/v2/users/detail?dept=dev&active=true#profile 的网络地址中提取出当前域名、请求路由和业务参数。以往很多代码依赖手工正则表达式或 split('?') 切割字符串,这种方式在遇到带端口的主机名、多层级路由或带特殊编码的参数时极易产生解析遗漏。现代 JavaScript 规范(WHATWG)内置了标准的 URL 和 URLSearchParams 类,提供了开箱即用、安全且双向联动的解析能力,直接通过原生属性便可准确获取各项指标。
一、URL 对象的初始化与防御式创建
在标准的浏览器环境(Chrome、Firefox、Safari、Edge 等主流版本)以及 Node.js(v10+)和 Deno 等服务端运行时中,URL 对象均作为全局构造函数直接可用。其标准构造语法如下:
// 语法结构:new URL(url [, base])
const targetUrl = new URL("https://api.example.com:8080/v2/users/detail?dept=dev&active=true#profile");
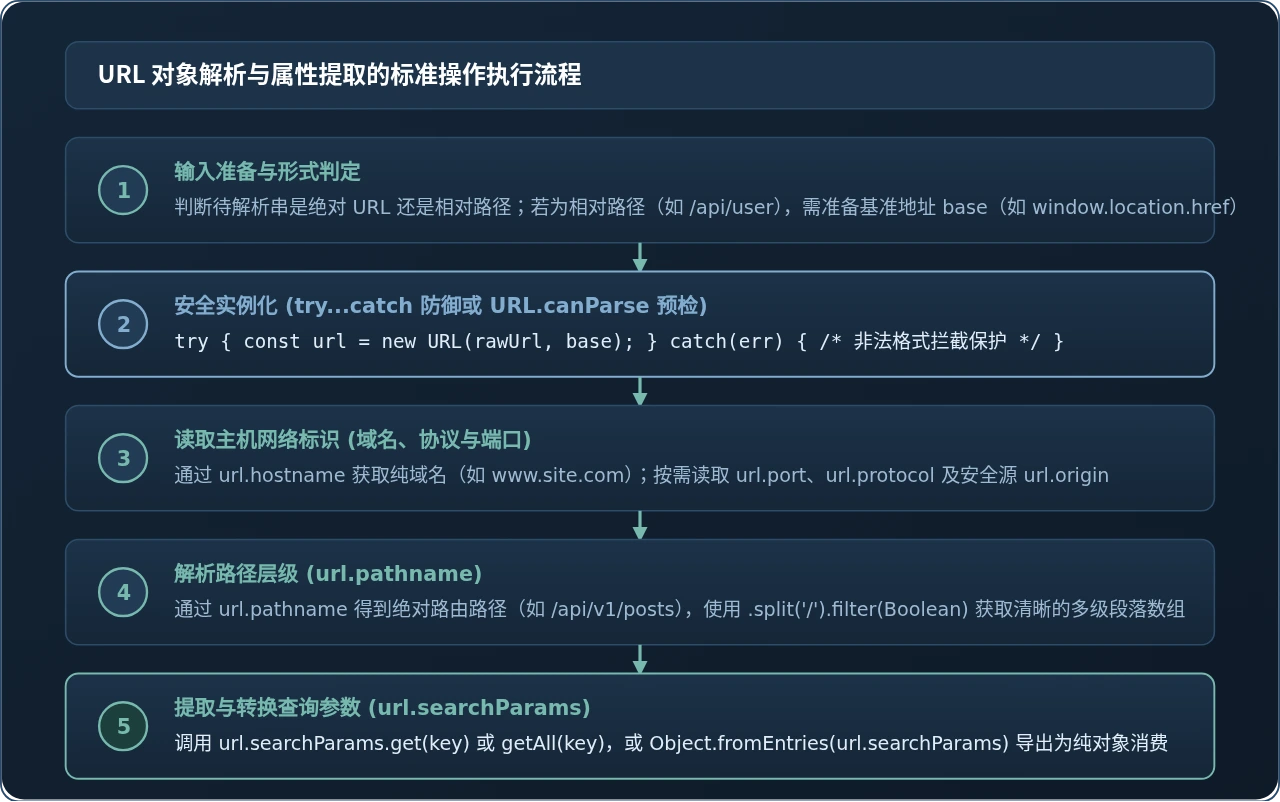
构造函数接收两个参数:第一个参数为待解析的目标地址字符串;第二个参数为可选的基准地址(base)。当待解析字符串为相对路径(例如 /v2/users/detail 或 ../search)时,必须提供 base,否则构造函数将抛出 TypeError: Invalid URL。
// 相对路径解析场景(在浏览器端通常将 window.location.href 作为基准)
const relativePath = "/api/v1/goods?id=998";
const fullUrl = new URL(relativePath, "https://shop.example.com");

console.log(fullUrl.href);
// 输出示例:"https://shop.example.com/api/v1/goods?id=998"
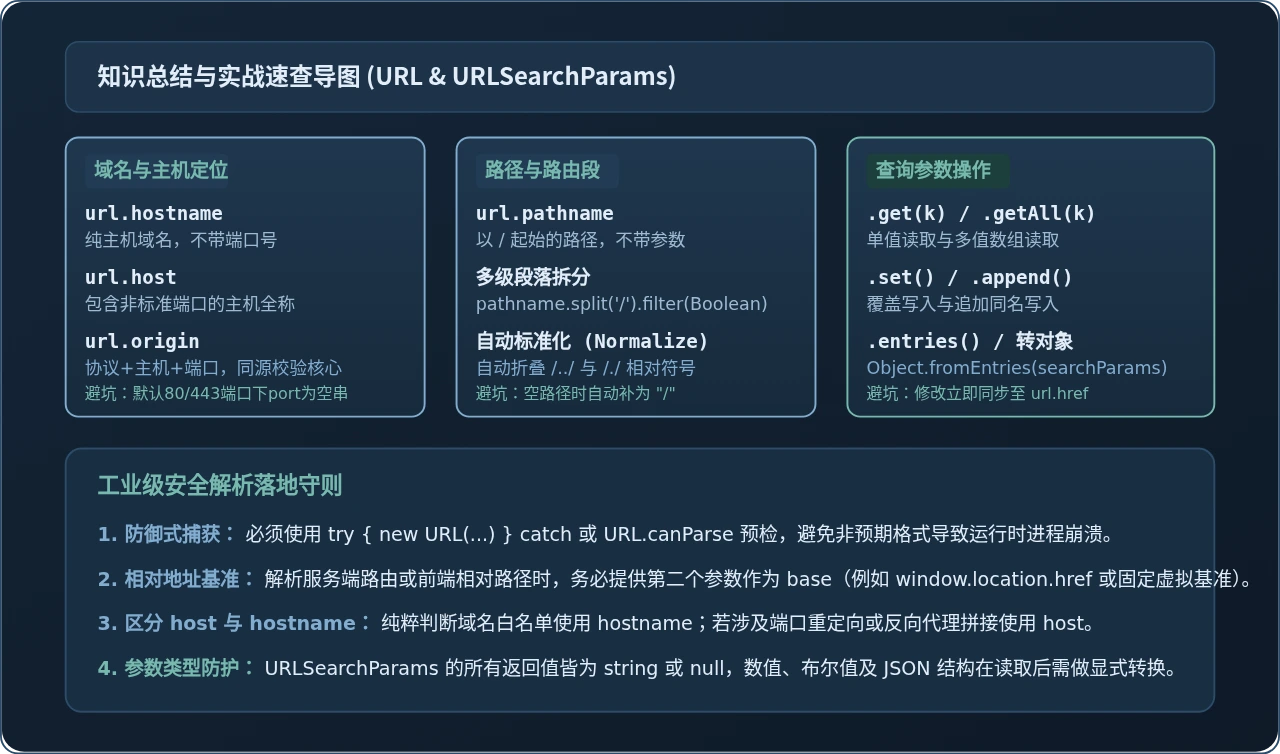
try...catch 块对 new URL() 进行包裹保护;在现代支持 URL.canParse() 的环境中(Chrome 120+、Node.js 19.9.0+),也可先通过静态方法预检有效性。
二、解析域名与主机网络标识
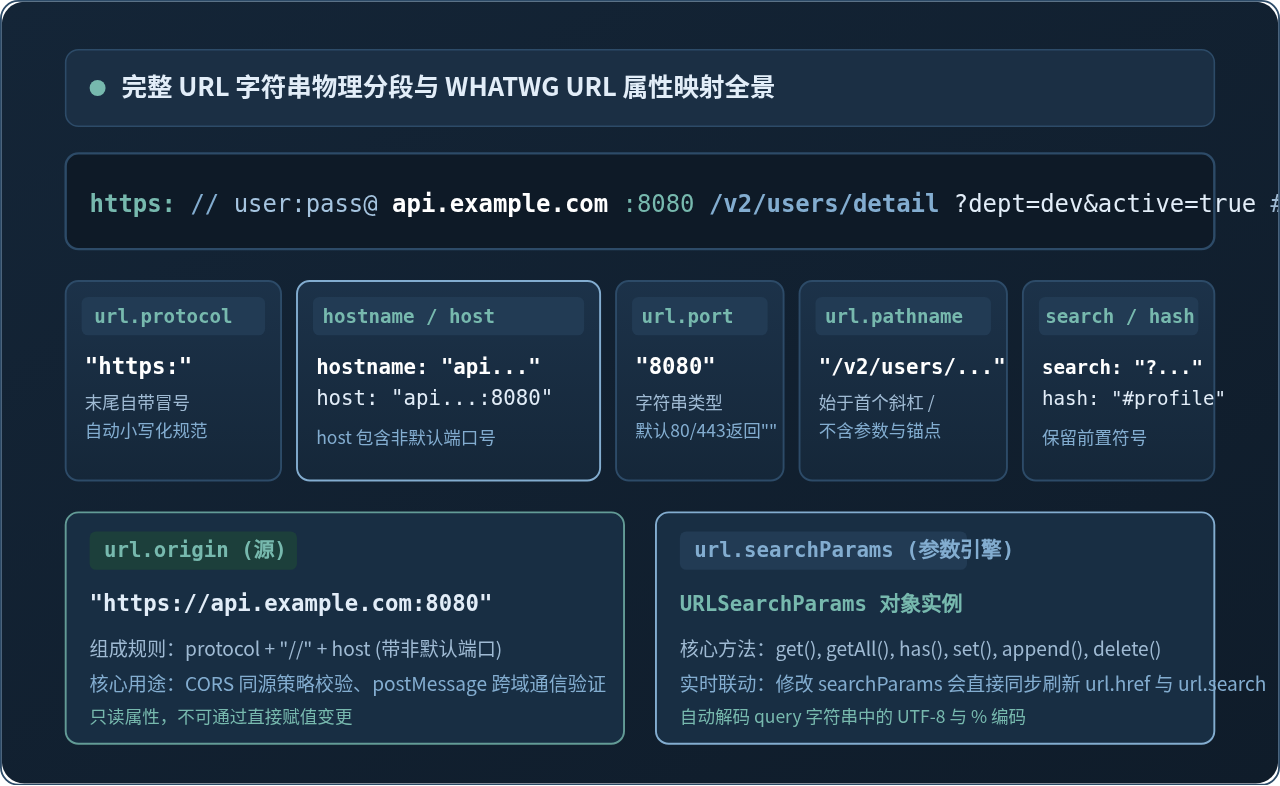
网络定位属性反映了请求目标所在的主机环境。在很多安全校验(如跨域鉴权白名单、防钓鱼重定向验证)中,开发者最常混淆的是 hostname 与 host 的边界:
url.hostname:返回纯粹的主机域名或 IP 地址,不包含任何端口号。例如对于https://api.example.com:8080,其值为"api.example.com"。在进行域名合法性校验时,务必使用该属性。url.host:返回完整的主机标识。如果 URL 显式指定了非默认端口(例如:8080或:3000),该属性会完整包含端口号(即"api.example.com:8080")。当端口为协议默认端口(如 HTTP 的 80,HTTPS 的 443)时,host与hostname返回相同值。url.port:返回明确指定的端口号字符串。如果 URL 中省略了端口或使用了协议默认端口,该属性返回空字符串""。url.protocol:返回请求所采用的协议方案,例如"https:"或"http:"。注意该属性末尾包含英文冒号,且会自动被转换为全小写。url.origin:返回只读的源(Origin),由协议、纯域名和有效端口共同拼接组成(例如"https://api.example.com:8080")。它是判断同源策略(Same-Origin Policy)的核心依据。
const url = new URL("https://api.example.com:8080/v2/users/detail?dept=dev&active=true#profile");

console.log("纯域名 (hostname):", url.hostname); // "api.example.com"
console.log("完整主机 (host):", url.host);         // "api.example.com:8080"
console.log("网络端口 (port):", url.port);         // "8080"
console.log("协议前缀 (protocol):", url.protocol); // "https:"
console.log("安全源 (origin):", url.origin);       // "https://api.example.com:8080"
三、解析与处理路由路径
路径部分决定了服务端网关的分发路由或前端应用的页面定位。通过 url.pathname 属性,可以直接拿到剔除了主机、查询参数以及哈希之后的纯路径字符串:
url.pathname始终以斜杠/开头。即使原始输入为"https://example.com"这样省略末尾斜杠的简写形式,URL 对象也会自动将其规范化为"/"。- 该属性不会包含
?及其后续的查询参数,也不会包含#及其后续的哈希值。 - URL 构造器具备自动规范化能力(Normalization),诸如
/v2/users/../goods/./list这样的相对目录跃迁符号会被自动折叠为最终的标准路径/v2/goods/list。
在实际业务中,我们常需要把多级路径拆分为层级数组。使用 split('/') 配合布尔过滤器即可快速获得整洁的路由段落:
const url = new URL("https://api.example.com/v2/products/electronics/item-9021");

// 提取完整路径字符串
const path = url.pathname; // "/v2/products/electronics/item-9021"

// 拆解为各层级路由段(过滤首尾空字符串)
const segments = path.split("/").filter(Boolean);
console.log(segments);
// 输出示例:["v2", "products", "electronics", "item-9021"]

// 快速获取末级业务资源 ID
const itemId = segments[segments.length - 1]; // "item-9021"
四、使用 URLSearchParams 精确解析与操作查询参数
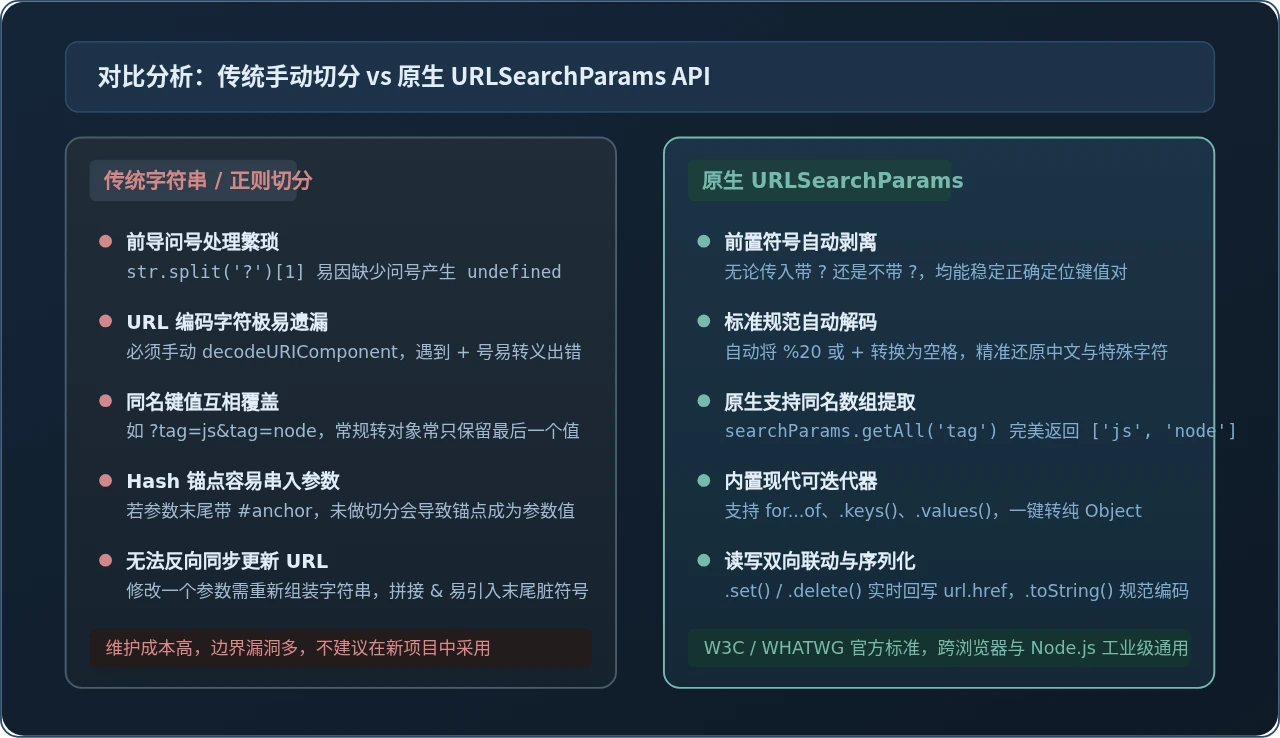
在传统方式下,开发者往往对 url.search(例如 ?dept=dev&active=true)进行截取和正则匹配。但这种做法极易在应对中文编码、特殊字符(如 + 与 %20)、以及同名多参数时出现漏洞。
url.searchParams 是一个预先绑定的 URLSearchParams 接口实例。它不仅支持快速的只读查找,还支持原地增删改查,并且所有的参数变更都会自动同步回 url.href 和 url.search。
1. 读取单值与多值同名参数
const sample = "https://example.com/search?keyword=%E5%89%8D%E7%AB%AF&tag=js&tag=react&page=1";
const url = new URL(sample);
const params = url.searchParams;

// 1. 读取单值(自动完成 URI 解码)
console.log(params.get("keyword")); // "前端"(已自动将 %E5%89%8D%E7%AB%AF 转回中文)
console.log(params.get("page"));    // "1"(注意:返回值均为 string 类型)
console.log(params.get("notExist"));// null(查找不存在的键时安全返回 null,而非报错)

// 2. 读取同名多值参数
// 普通 get 只会返回首个匹配项
console.log(params.get("tag"));     // "js"
// 使用 getAll 会以数组形式返回所有对应的值
console.log(params.getAll("tag"));  // ["js", "react"]

// 3. 检查键是否存在
console.log(params.has("keyword")); // true
console.log(params.has("order"));   // false
2. 遍历所有参数与转换为普通对象
URLSearchParams 实现了标准的可迭代协议(Iterable)。我们可以直接利用 for...of 进行遍历,或利用 Object.fromEntries() 快速转换为普通的键值对对象:
// 方式一:迭代器直接遍历
for (const [key, value] of url.searchParams) {
  console.log(`${key}: ${value}`);
}

// 方式二:一键导出为纯 JavaScript 对象(仅保留末尾同名值)
const paramObject = Object.fromEntries(url.searchParams.entries());
console.log(paramObject);
// 输出示例:{ keyword: "前端", tag: "react", page: "1" }

// 方式三:完整保留同名数组的高阶导出函数
function parseQueryWithArrays(searchParams) {
  const result = {};
  for (const [key, value] of searchParams.entries()) {
    if (Object.prototype.hasOwnProperty.call(result, key)) {
      if (Array.isArray(result[key])) {
        result[key].push(value);
      } else {
        result[key] = [result[key], value];
      }
    } else {
      result[key] = value;
    }
  }
  return result;
}
3. 动态修改与反向同步
当对 searchParams 调用 set()、append() 或 delete() 时,底层 URL 的整体结构会被实时刷新,无需手动再拼装字符串:
const url = new URL("https://example.com/list?page=1&sort=asc");

// 更新已有键值
url.searchParams.set("page", "2");

// 追加新参数
url.searchParams.append("status", "active");

// 删除指定参数
url.searchParams.delete("sort");

// 查看整体 URL,已全部自动联动并编码
console.log(url.href);
// 输出:"https://example.com/list?page=2&status=active"
五、常见边界陷阱与排查清单
在实际项目封装过程中,初学者常在以下四个场景中踩坑,需要特别留意:
| 场景 / 易错点 | 典型错误现象 | 底层原因分析 | 正确处理方法 |
|---|---|---|---|
| 相对路径直接实例化 | TypeError: Invalid URL 抛出致命异常 |
缺少协议与主机构成完整 URI,WHATWG 标准不接受无 base 的相对地址 | 补齐第二个参数 new URL(input, window.location.href) 或固定虚拟基准 |
| 端口判断失误 | url.port 读取结果为 "" 空串 |
标准规定 HTTP 默认端口 80 与 HTTPS 默认端口 443 会自动省略以精简 URL | 若需要数值端口,做缺省回退:url.port || (url.protocol === 'https:' ? '443' : '80') |
| 数值与布尔类型误判 | if (url.searchParams.get("active")) 始终判定为真 |
get() 提取的 "false" 或 "0" 是非空字符串,JS 中隐式转为 true |
严格比对字符串内容:params.get("active") === "true" |
| Hash 锚点干扰参数 | 参数后附带了 #section 字符 |
非标准写法将 # 置于 ? 前方导致协议解析器将后续内容归为 hash |
严格遵守标准格式 /path?query#hash;通过 url.hash 独立读取锚点 |
六、高可用工程化解析封装
综合上述的特性与边界防护,在实际前端工程或 Node.js 中间件中,推荐使用一个工业级健壮的工具函数进行统一收口:
/**
 * 健壮的 URL 解析工具函数
 * @param {string} input 待解析的 URL 字符串(支持绝对与相对路径)
 * @param {string} [base] 基准地址(在无 window 环境下回退到安全虚拟地址)
 * @returns {object|null} 结构化的解析结果对象,格式错误时返回 null
 */
function safeParseUrl(input, base) {
  if (!input || typeof input !== "string") return null;

  try {
    // 自动适配浏览器或虚拟降级 Base
    const fallbackBase = base || (typeof window !== "undefined" ? window.location.href : "http://localhost");
    const parsed = new URL(input, fallbackBase);

    // 解析并聚合查询参数为对象
    const query = {};
    for (const [key, value] of parsed.searchParams.entries()) {
      if (Object.prototype.hasOwnProperty.call(query, key)) {
        query[key] = Array.isArray(query[key]) ? [...query[key], value] : [query[key], value];
      } else {
        query[key] = value;
      }
    }

    return {
      href: parsed.href,
      origin: parsed.origin,
      protocol: parsed.protocol.replace(":", ""),
      hostname: parsed.hostname,
      host: parsed.host,
      port: parsed.port || (parsed.protocol === "https:" ? "443" : "80"),
      pathname: parsed.pathname,
      pathSegments: parsed.pathname.split("/").filter(Boolean),
      query,
      hash: parsed.hash ? parsed.hash.slice(1) : "",
      raw: parsed
    };
  } catch (error) {
    console.error("URL 解析失败:", error);
    return null;
  }
}

// 验证测试:
const info = safeParseUrl("https://admin.service.io:9000/app/v1/orders?cat=office&cat=digital&status=1#top");
console.log(info.hostname);     // "admin.service.io"
console.log(info.pathSegments); // ["app", "v1", "orders"]
console.log(info.query);        // { cat: ["office", "digital"], status: "1" }
console.log(info.hash);         // "top"
借助现代原生 URL 和 URLSearchParams,不仅省去了第三方依赖库(如 query-string),代码更加简洁轻量,而且从规范层面杜绝了手工字符切分产生的边界 Bug,是现代 JavaScript 开发中处理网络地址的标准方案。
JavaScript continue结合标签的用法:跳过指定外层循环迭代
2026-11-19 18:33:32
JS使用正则表达式处理多分隔符字符串转数组
2026-11-19 18:23:40
JS数组按值删除指定元素的方法
2026-11-19 13:46:53
JavaScript流程图库怎么选?GoJS、X6与LogicFlow特性对比
2026-11-19 13:26:54
JS Map怎么遍历:forEach与for...of用法示例
2026-11-19 11:28:11







