JS使用正则表达式处理多分隔符字符串转数组
深入讲解在JavaScript中使用String.prototype.split配合正则表达式将包含多种分隔符的字符串转换为纯净数组的方法、底层机制与避坑指南。
String.prototype.split() 搭配正则表达式是最精准、性能最高的解法。本文通过拆解字符集语法、量词组合、规避捕获组副作用及两端空白清洗,建立一套适用于真实业务场景的标准化转数组流水线。
一、为什么固定字符 split 无法胜任与正则切分的基本语法
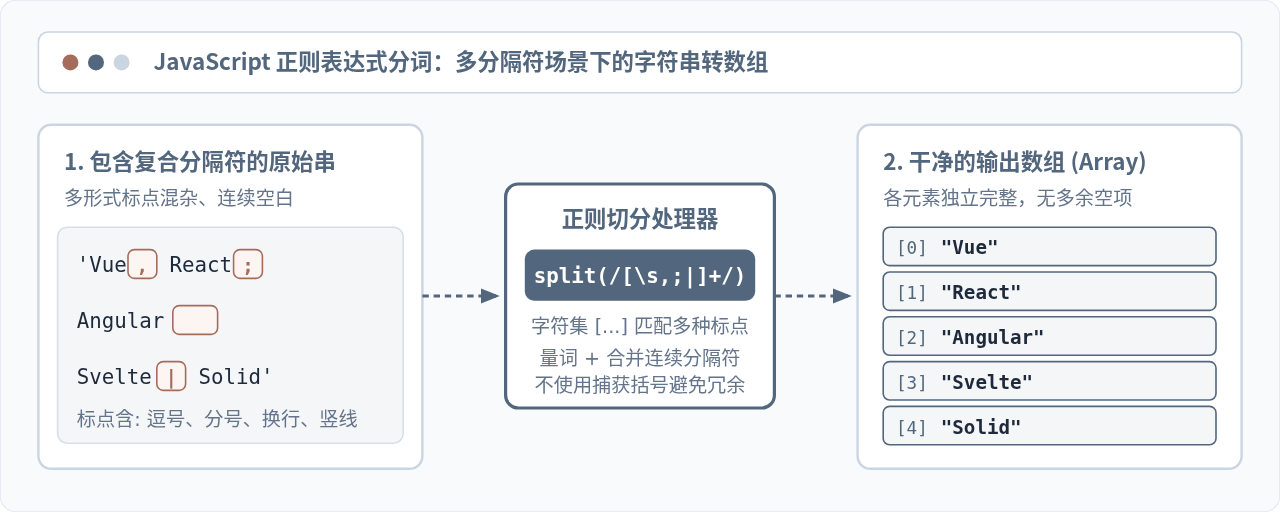
在很多数据交互场景中,用户输入或系统导出的文本往往不够规范。例如用户在标签栏输入 "JavaScript, Vue; React | Node.js",其中混用了半角逗号、分号与竖线。
若使用传统的字面量字符串调用 str.split(','),JavaScript 仅会在遇到精确匹配的单字符逗号时进行截断,分号与竖线会直接作为普通字符滞留在切分后的元素中,后续往往需要编写复杂的嵌套循环二次遍历修剪。
// 传统固定字符串切分的局限
const rawInput = "Vue, React; Angular | Svelte";
const naiveResult = rawInput.split(',');

console.log(naiveResult);
// 示例输出:
// [ "Vue", " React; Angular | Svelte" ]
在上述输出中,除了第一个元素被切出外,其余三个框架名称完全粘连在了一起。根本原因在于固定字符串参数只能建立单点精确比对,缺乏动态分支匹配能力。
而 split() 方法原生支持传入 RegExp 对象。正则表达式中的字符集(Character Class)语法 [...] 允许我们定义一个符号集合,只要字符命中其中任意一个,就会被视作合法的切分断点。
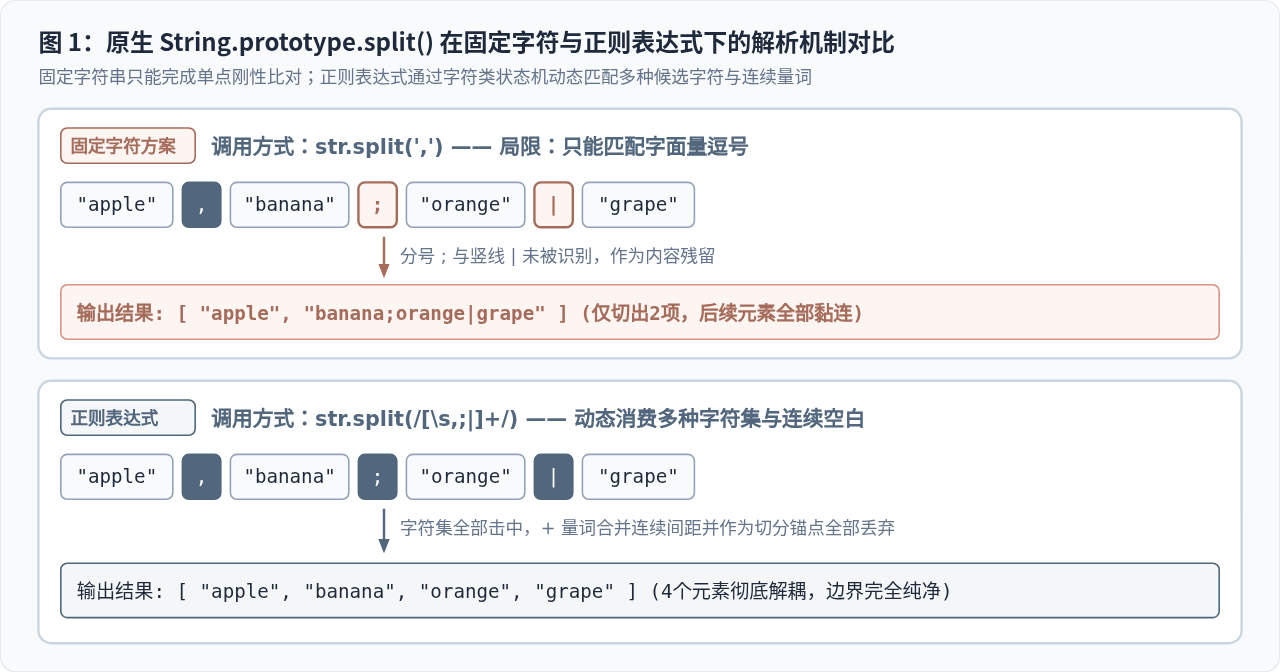
如图 1 所示,通过字符集 /[\s,;|]+/,正则引擎会在扫描字符串时,将命中空白符 \s、逗号 ,、分号 ; 或竖线 | 的位置均标记为切割断点,从而一次性将所有片段彻底解耦。
二、核心操作流水线:从原始脏文本到纯净数组的四步法
在真实业务工程中,直接调用 split() 往往还会面临两端多余空串、全半角标点混杂等边界问题。为了保证解析出的数组具备高度的确定性与数据纯净度,推荐遵循以下四步操作流水线:
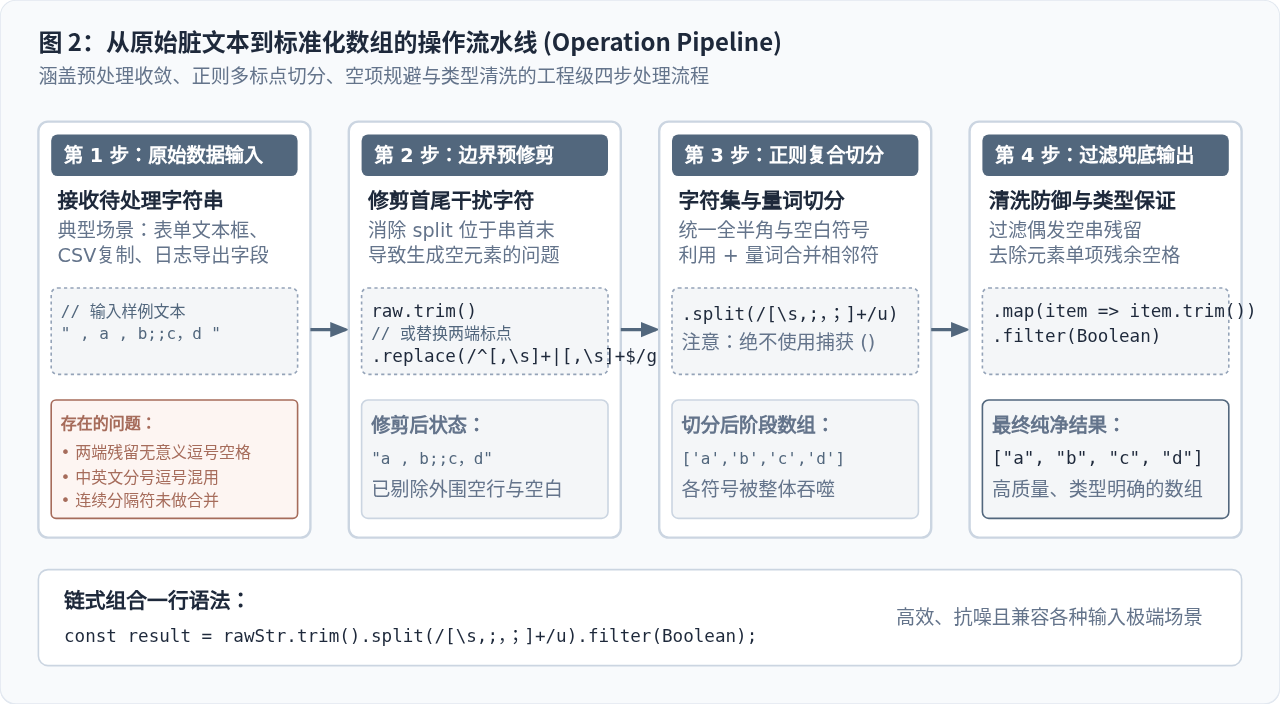
步骤 1:两端预修剪(Pre-trimming)
当输入的字符串以分隔符或空格开头/结尾时(例如 ", a, b, c, "),若直接切分,split() 会在首部和尾部各切出一个无意义的空字符串 ""。在执行切分前调用 str.trim() 是快速收敛边界的第一道防线。
步骤 2:构建涵盖全半角的中英文符号字符集
国内用户在表单或数据录入时,常在中文输入法下键入全角逗号 ,、全角分号 ; 以及顿号 、。在字符集中一并加入这些符号,配合 Unicode 修饰符 u,能极大提升解析的鲁棒性:
// 兼容中英文逗号、分号、顿号、竖线及连续空白的字符集模式
const DELIMITER_REGEX = /[\s,;,;、|]+/u;
步骤 3:结合贪婪量词 + 吞噬连续分隔符
很多时候连续的标点会被连续键入,例如 "item1;;;item2 , , item3"。如果在字符集后不加量词 +,引擎在相邻两个分号之间就会切出一个空项。加上 + 之后,正则引擎会把连续的多个标点或空白视作一个整体切分单元,一次性吞噬。
步骤 4:过滤偶发空串与去除多余空白
最后链式调用 .filter(Boolean) 可以清除所有虚值(包括空字符串 ""),确保返回的数组中每一项都是具有实际内容的字符串。若内容内部两端仍有残余空格,可配合 .map(s => s.trim()) 处理。
完整实现代码与运行验证
/**
 * 将包含多种分隔符的字符串转换为纯净数组
 * @param {string} text - 待处理的原始字符串
 * @returns {string[]} - 切分清洗后的字符串数组
 */
function splitMultiDelimiters(text) {
  // 防御性校验:非字符串或纯空白直接返回空数组
  if (typeof text !== 'string' || !text.trim()) {
    return [];
  }

  return text
    .trim()
    .split(/[\s,;,;、|]+/u)
    .map(item => item.trim())
    .filter(Boolean);
}

// 执行测试
const dirtyInput = " , 苹果 , 香蕉;; 橙子,草莓、葡萄 | 桃子

 梨 ";
const cleanArray = splitMultiDelimiters(dirtyInput);

console.log("解析结果数组:", cleanArray);
console.log("数组项数量:", cleanArray.length);三、深入底层细节:量词与捕获括号的致命陷阱
在使用正则配合 split() 时,有两个极易被忽视但后果严重的语法细节。理解它们的底层工作原理,可以彻底避免生产环境中的暗坑。
陷阱 1:缺少量词 + 导致的空字符串溢出
对比以下两段看似相近的调用:
const sample = "alpha,,beta";

// 模式 A:无量词
console.log(sample.split(/[,]/));
// 示例输出: [ "alpha", "", "beta" ]

// 模式 B:带量词 +
console.log(sample.split(/[,]+/));
// 示例输出: [ "alpha", "beta" ]
在模式 A 中,字符集匹配单个逗号。当扫描到第一个逗号时,左侧产出 "alpha";紧接着扫描第二个逗号时,两个逗号之间的空内容被提取为长度为 0 的空字符串 ""。在需要连续标点自动合并的场景下,量词 + 是不可或缺的。
陷阱 2:使用捕获括号 ( ) 导致分隔符被塞入数组
很多开发者习惯在书写正则表达式时随手添加圆括号 (pattern),但在 split() 中,圆括号代表捕获组(Capturing Group)。
split() 的正则表达式包含捕获组时,每次该捕获组成功匹配到的子串,都会被当作数组的一个正式元素插入到返回的数组中!
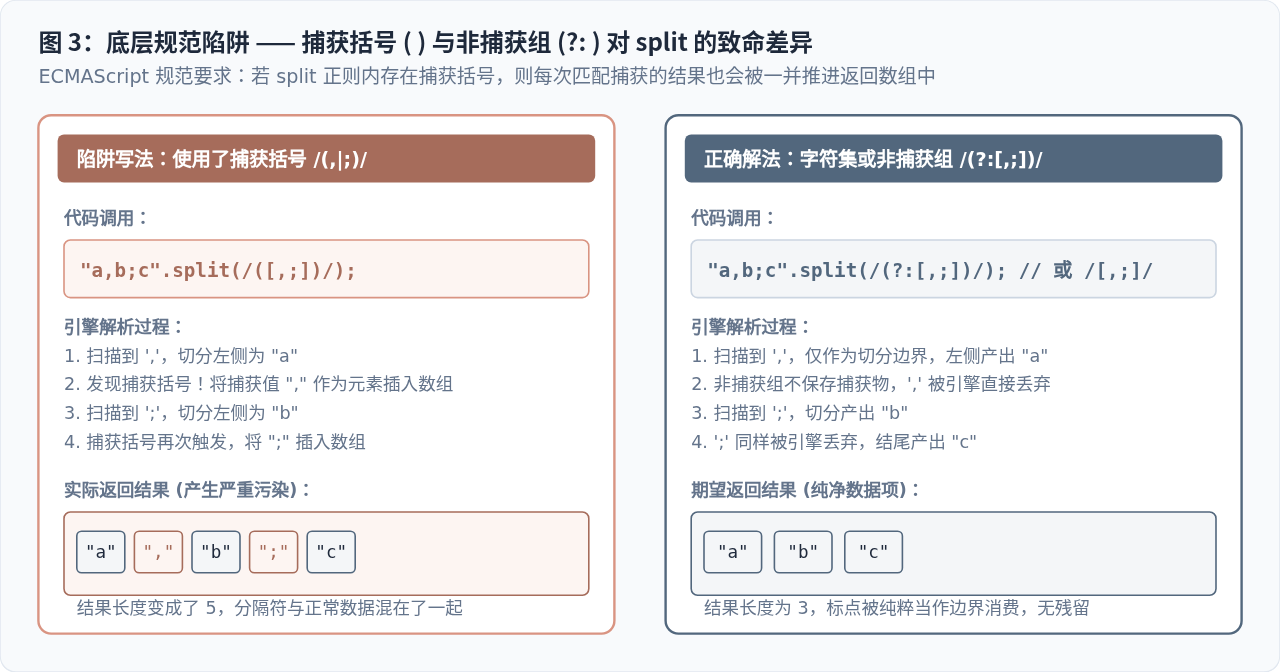
如图 3 所示,如果书写了 "a,b;c".split(/([,;])/),返回的结果不是三个字符的数组,而是 ["a", ",", "b", ";", "c"]。分隔符本身被保留到了数组中,导致数组长度异常暴增。
如果需要对复杂分隔符进行分组(例如复合短语分支),必须明确使用非捕获括号 (?:...):
// 错误写法:捕获组导致分隔符被加入数组
const wrongResult = "A,B;C".split(/([,;])/);
// 示例输出: [ "A", ",", "B", ";", "C" ] (长度为 5)

// 正确写法 1:直接使用字符类方括号
const rightResult1 = "A,B;C".split(/[,;]/);
// 示例输出: [ "A", "B", "C" ] (长度为 3)

// 正确写法 2:必须分组时使用非捕获组 (?:)
const rightResult2 = "A,B;C".split(/(?:[,;])/);
// 示例输出: [ "A", "B", "C" ] (长度为 3)
四、进阶场景:特殊元字符转义与多字符复合分隔符
日常业务数据往往不仅包含简单的逗号或分号,有时分隔符本身是正则表达式的保留字符,或者由多个字符甚至单词组合而成。
场景 1:包含点号、竖线、星号等正则元字符
在正则表达式中,.、*、+、?、|、^、$、(、)、[、{ 等均属于元字符。
在字符集 [...] 内部,许多元字符(例如 .、*、+)会自动退化为字面量字符,但在字符集中,以下四个字符必须谨慎:
- 反斜杠
\:始终表示转义,自身必须写作\\; - 右方括号
]:表示字符集闭合,在集合内部必须转义写作\]; - 连字符
-:若置于集合内部两字符之间会被解析为范围(如a-z),若作为普通分隔符,建议放在字符集的最开头或最末尾,或者转义为\-; - 脱字符
^:若放在字符集首位表示非字符集,作为普通分隔符切分时应避免置于首位或进行转义\^。
// 切分由 点号、竖线、下划线、斜杠及反斜杠 组成的复杂字符串
const mixedSymbols = "module.service|handler/controller\\helper";
const symbolArray = mixedSymbols.split(/[\.|/\\_]+/);

console.log(symbolArray);
// 示例输出:
// [ "module", "service", "handler", "controller", "helper" ]
场景 2:单字符与多字符/关键词复合切分
当分隔符不仅仅是单个字符,还包含类似于 SQL 或搜索语法中的逻辑词 " AND "、" OR " 或双冒号 "::" 时,字符集 [...] 无法直接表达长度大于 1 的序列。此时必须借助非捕获分支组合 (?:\s+AND\s+|::|[,;]):
// 混合了单词分隔符 " AND "、双冒号 "::" 与单字符逗号、分号
const queryText = "status::active AND level::admin, role::editor; guest";

// 模式解析:非捕获组内通过 | 分支并联多字符模式与单字符集,末尾加 i 忽略大小写
const complexRegex = /(?:\s+AND\s+|::|[,;])+/i;

const tokens = queryText
  .trim()
  .split(complexRegex)
  .map(s => s.trim())
  .filter(Boolean);

console.log(tokens);
// 示例输出:
// [ "status", "active", "level", "admin", "role", "editor", "guest" ]
五、工程化总结与模式速查决策
在大型前端应用或服务端 Node.js 任务中,如果需要对成千上万行数据进行批量切分,正则表达式的实例化方式对性能具有不可忽视的影响。
每次调用 str.split(/.../) 时,若将字面量写在循环内部,JavaScript 引擎虽然具备一定级别的正则缓存,但抽离到函数外部作为常量预编译不仅能保证零分配开销,还能使业务意图更加清晰。
// 推荐:在模块或类顶部抽离预编译正则常量
const CSV_SPLIT_REGEX = /[\s,;,;]+/u;

function parseBatchRecords(records) {
  const parsedRows = [];
  for (let i = 0; i < records.length; i++) {
    // 重复利用已编译好的正则常量,安全且高效
    parsedRows.push(records[i].trim().split(CSV_SPLIT_REGEX).filter(Boolean));
  }
  return parsedRows;
}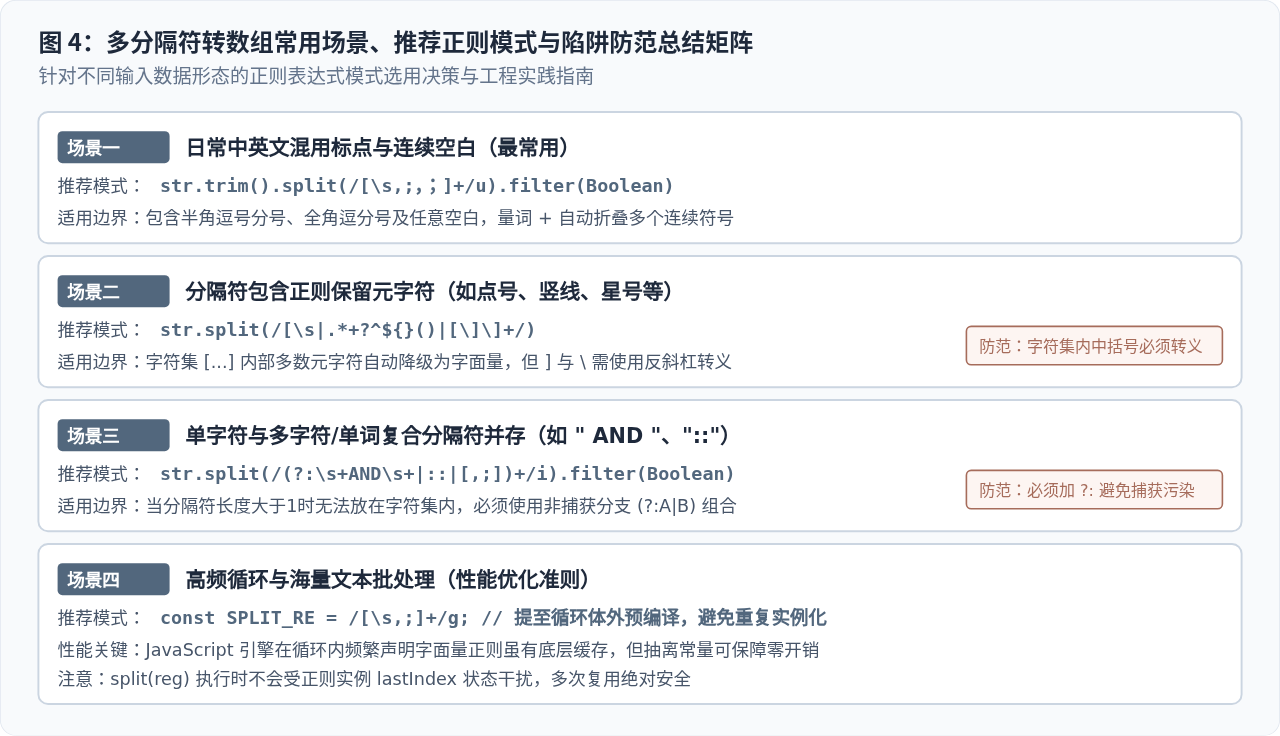
常用场景正则模式速查表
| 需求场景 | 推荐正则表达式模式 | 关键特性与说明 |
|---|---|---|
| 中英文常见标点与空白 | /[\s,;,;、|]+/u |
覆盖半角与全角逗分号、顿号、竖线及换行符,自动合并相邻空白 |
| 包含正则特殊元字符 | /[\s.\-+*\\/|]+/ |
注意 - 放在开头或末尾,\ 自身双反斜杠转义 |
| 长短复合分隔符(如 AND / OR) | /(?:\s+(?:AND|OR)\s+|[,;])+/i |
严格使用非捕获组 (?:),防止逻辑词作为数组元素输出 |
| 高吞吐批量解析 | const RE = /[\s,;]+/g; |
提至外层预编译常量;split() 不受 lastIndex 状态影响 |
总结而言,在 JavaScript 中处理多分隔符字符串转数组,核心在于善用字符集 [...] 圈定候选范围、利用量词 + 合并连续边界,并时刻警惕捕获组 () 对结果集的干扰。配合 trim() 与 filter(Boolean),即可在不同复杂度的数据输入下获得稳定可靠的纯净数组。
JavaScript continue结合标签的用法:跳过指定外层循环迭代
2026-11-19 18:33:32
JS数组按值删除指定元素的方法
2026-11-19 13:46:53
JavaScript流程图库怎么选?GoJS、X6与LogicFlow特性对比
2026-11-19 13:26:54
JS Map怎么遍历:forEach与for...of用法示例
2026-11-19 11:28:11
JS原地快速排序怎么写?双指针法减少内存占用
2026-11-19 10:22:09