

JS字符串开头大小写不敏感匹配怎么实现?
详细解析在 JavaScript 中实现字符串开头大小写不敏感匹配的高效方案,涵盖 slice 局部比对、RegExp 动态前缀转义、Intl.Collator 国际化对比与性能优化。
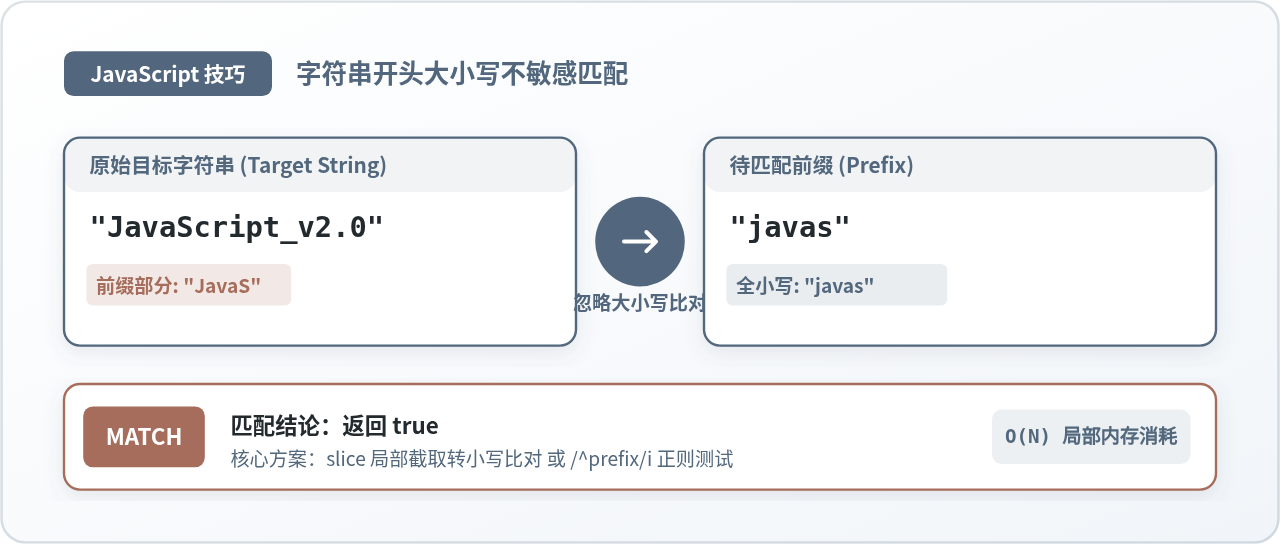
在 JavaScript 中检查一个字符串是否以特定前缀开头(即忽略字母大小写的 startsWith 行为),最直接有效的方法根据使用场景分为两类:对于固定的前缀字符,使用带 i 修饰符的正则表达式 /^prefix/i.test(str) 最为简练;而对于用户输入或变量形式的动态前缀,截取对应长度切片后统一转小写比对 str.slice(0, prefix.length).toLowerCase() === prefix.toLowerCase() 则是最稳妥且高性能的通用方案。下面我们将逐步拆解具体实现方式、原理解释、潜在陷阱及场景选型。
一、直观做法及其性能损耗:整串转小写
很多开发者在刚接触这个问题时,最先想到的做法是把原字符串与前缀均通过 toLowerCase() 转换后再调用 ES6 原生提供的 startsWith() 方法:
// 做法一:全量转小写后再进行比对
function startsWithIgnoreCaseNaive(str, prefix) {
  return str.toLowerCase().startsWith(prefix.toLowerCase());
}

// 示例输出
console.log(startsWithIgnoreCaseNaive("JavaScript_ES6", "javas")); // 输出: true
console.log(startsWithIgnoreCaseNaive("README.md", "read"));        // 输出: true
console.log(startsWithIgnoreCaseNaive("TypeScript", "java"));       // 输出: false
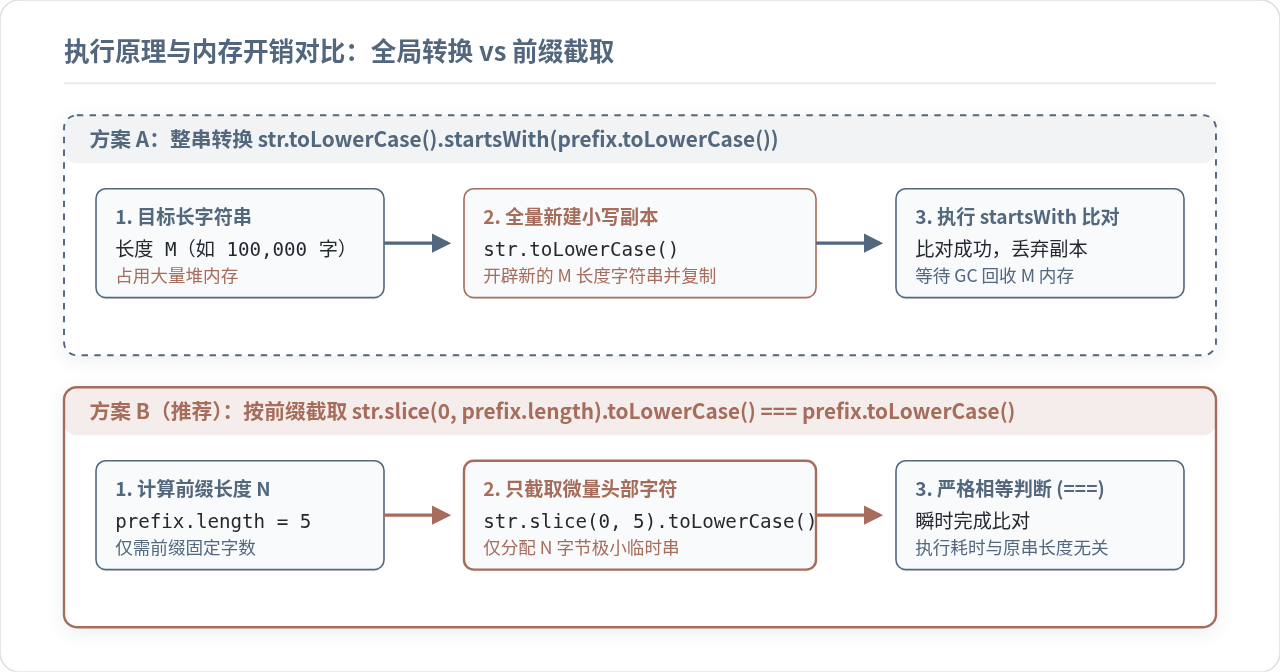
这种写法逻辑直观、易读易写,但在实际业务开发中潜藏着不必要的内存开销。JavaScript 中的字符串是不可变(immutable)的原语值。当目标字符串 str 是一段长文本(例如数万字的文章、大体积 JSON 字符串或代码片段)时,str.toLowerCase() 会在内存堆中完整克隆并生成一个等长的新字符串。
然而,判断“开头匹配”仅仅需要确认前若干个字符,为了前 5 个字母的比对而完整复制 10 万字的长文本,不仅白白消耗内存空间,还会给垃圾回收(GC)带来额外压力。
二、高性能通用方案:前缀切片比对(slice)
针对上述内存损耗,优化的核心在于“按需截取”。既然只需要验证开头长度为 prefix.length 的子串,我们只需通过 String.prototype.slice() 截取目标字符串的头部片段,再将该短片段转为小写进行相等性校验。
// 做法二(推荐):基于切片的低开销匹配函数
function startsWithIgnoreCase(str, prefix) {
  // 基础防御性检查
  if (typeof str !== 'string' || typeof prefix !== 'string') {
    return false;
  }
  // 空前缀恒成立
  if (prefix === '') {
    return true;
  }
  // 目标字符串长度不足前缀长度,直接判定失败
  if (str.length < prefix.length) {
    return false;
  }

  // 仅截取与前缀等长的头部字符,执行局部大小写折叠
  return str.slice(0, prefix.length).toLowerCase() === prefix.toLowerCase();
}

// 验证示例
console.log(startsWithIgnoreCase("Mozilla/5.0 Chrome", "mozilla")); // 输出: true
console.log(startsWithIgnoreCase("HTTP://example.com", "http://")); // 输出: true
console.log(startsWithIgnoreCase("Dev", "development"));            // 输出: false
这种实现的优势在于:无论目标字符串 str 有多长,参与 toLowerCase() 运算和内存分配的字符数量永远等于 prefix.length。时间复杂度保持在 O(N)(N 为前缀字符数),完全与被检索文本的整体长度 M 脱钩,在长文本日志分析或批量文件路径过滤场景中尤为高效稳固。
三、正则表达式实现与动态安全转义
正则表达式在模式匹配上拥有天然的语法优势。正则的 ^ 锚点代表匹配字符串开头,而标志位 i(ignoreCase)则表示匹配时忽略大小写。
1. 固定前缀场景(字面量正则)
如果前缀在编写代码时就是明确的字面量常量(例如检测 URL 协议、判定特定命令关键词),直接使用正则字面量测试最为简洁高效:
// 判定是否以 http:// 或 https:// 开头(不区分大小写)
const isHttpUrl = (url) => /^https?:\/\/\/i.test(url);

console.log(isHttpUrl("HTTP://localhost:3000")); // 输出: true
console.log(isHttpUrl("https://github.com"));     // 输出: true
console.log(isHttpUrl("ftp://files.local"));      // 输出: false
JavaScript 引擎会在代码解析阶段对正则表达式字面量进行预编译与优化,其执行效率极高。
2. 动态变量前缀场景(必须转义特殊字符)
当匹配的前缀来自用户输入或运行期变量时,通过 new RegExp() 动态拼接必须格外小心。如果前缀中包含正则表达式的元字符(如 . * + ? ^ $ { } ( ) [ ] | \ /),未转义的字符串会导致正则解析错误,甚至改变匹配规则。
// 正则特殊字符转义工具函数
function escapeRegExp(string) {
  return string.replace(/[.*+?^${}()|[\]\\]/g, '\\$&');
}

// 动态正则安全匹配函数
function startsWithIgnoreCaseRegExp(str, prefix) {
  if (typeof str !== 'string' || typeof prefix !== 'string') return false;
  if (!prefix) return true;

  // 将变量前缀进行安全转义,并绑定开头锚点 ^ 与 i 修饰符
  const pattern = new RegExp('^' + escapeRegExp(prefix), 'i');
  return pattern.test(str);
}

// 特殊字符前缀测试示例
const query = "[v1.0]";
const logItem = "[V1.0] System initialized.";
console.log(startsWithIgnoreCaseRegExp(logItem, query)); // 输出: true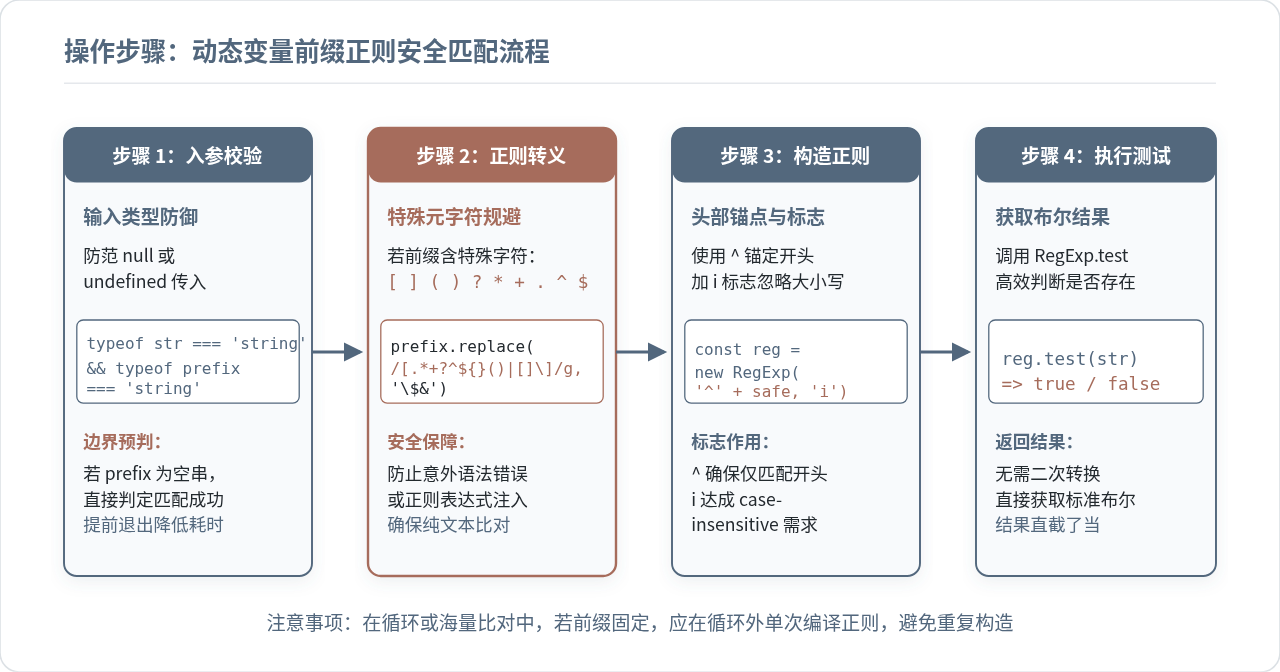
input 搜索提示)中处理同一个前缀,应在循环外部完成 new RegExp() 的构造,避免单次循环产生重复编译的额外开销。四、容易忽略的边界情况与国际化字符(Unicode)
实际生产环境中,除了常规的英文字符匹配外,字符串比对往往还会遇到以下特殊边界情况:
1. 空字符串与非字符串入参防御
在 ECMAScript 规范中,任何字符串都以空字符串 "" 开头。因此原生 "hello".startsWith("") 的返回值为 true。自定义工具函数应当保持这一约定,避免在遇到空字符串时返回异常值。此外,当外部传入 null 或 undefined 时,缺乏类型防护的代码容易直接抛出 Uncaught TypeError 异常中断执行。
2. 语言学大小写折叠(Locale-Sensitive)
标准的 toLowerCase() 与正则 i 修饰符是基于 Unicode 默认的大小写折叠(Default Case Folding)规则运行的。对于大部分拉丁与亚洲文字已足够使用,但在特定语区(例如土耳其语、阿塞拜疆语)中,带点字母 i 与不带点字母 I 的转换规则与标准英文不一致:
- 在土耳其语中,大写字母
I的小写形式是不带点的ı; - 带点大写字母
İ的小写形式才是i。
如果业务系统服务于国际化多语言场景,需要依据特定语区规则进行开头比对,可采用 Intl.Collator 配合切片进行精准比对:
// 国际化大小写不敏感前缀匹配(以指定语言区规则为准)
function startsWithIgnoreCaseLocale(str, prefix, locale = undefined) {
  if (typeof str !== 'string' || typeof prefix !== 'string') return false;
  if (prefix === '') return true;
  if (str.length < prefix.length) return false;

  // 截取头部相同长度字符
  const chunk = str.slice(0, prefix.length);

  // sensitivity: 'accent' 表示忽略大小写差异(但保留重音差异)
  // sensitivity: 'base' 表示同时忽略大小写与重音符号
  const collator = new Intl.Collator(locale, {
    sensitivity: 'accent',
    usage: 'search'
  });

  return collator.compare(chunk, prefix) === 0;
}

// 示例:德语特殊字母 ß 与 SS 比较
console.log(startsWithIgnoreCaseLocale("STRASSE", "straße", "de")); // 输出: true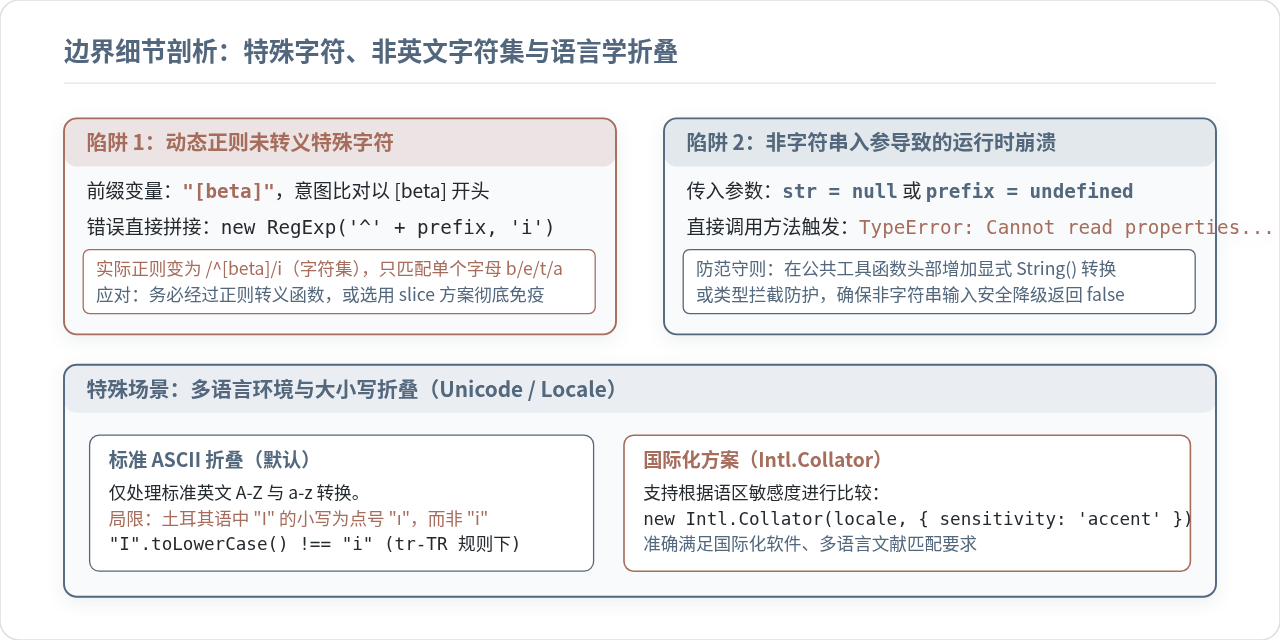
五、综合选型建议与场景总结
为便于在工程中做出最合理的技术决策,下表汇总了不同实现方案在性能、复杂度与适用范围上的对比:
| 方案 | 适用典型场景 | 时间复杂度 | 内存占用 | 注意事项 |
|---|---|---|---|---|
| 整串 toLowerCase + startsWith | 极短字符串、快速验证原型 | O(M + N) | 较高(全量复制) | 长文本容易造成内存浪费与 GC 峰值 |
| 局部切片 slice + toLowerCase | 通用工具库、用户动态前缀搜索(推荐) | O(N) | 极低(仅截取前缀长度) | 无需考虑正则转义,鲁棒性最强 |
| 字面量正则 /^.../i.test() | 已知固定前缀(URL 协议、文件扩展名等) | O(N) | 极低 | 编译优化最好,代码最简洁 |
| 动态 RegExp + escape | 需要复杂前缀规则组合的场景 | O(N) + 编译 | 低 | 必须进行字符转义防御,避免运行时报错 |
| Intl.Collator 比对 | 全球化、多语言文学排版及专业语区匹配 | O(N) | 中等 | 计算开销稍大,建议复用 Collator 实例 |
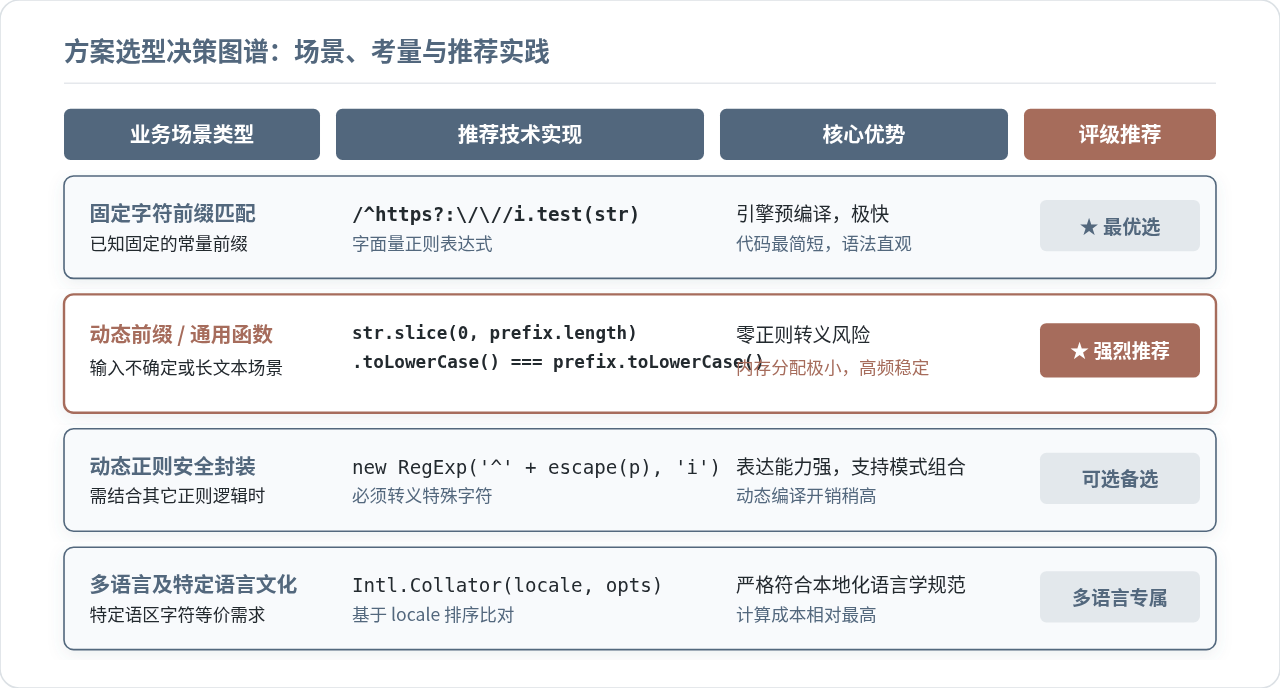
最终总结:在日常 JavaScript 开发中,如果不涉及复杂的多语言特定规则,推荐首选“局部切片法”封装一个 startsWithIgnoreCase 通用辅助函数。它避开了正则表达式复杂的转义与潜在注入风险,同时在内存使用和运行效率上达到了最优平衡;如果是针对固定模式字符,则直接书写 /^prefix/i.test(str) 最具表现力。
JS数组转字符串:join()方法指定分隔符详解
2026-11-19 19:05:31
date-fns实现JS日期加减的代码示例
2026-11-19 18:29:50
JS怎么保留输入数字的指定位数小数
2026-11-19 16:38:29
JavaScript常用内置函数与对象方法分类速查
2026-11-19 16:15:39
JS数组随机打乱:为什么不建议用sort实现洗牌
2026-11-19 15:36:04







