

JavaScript常用内置函数与对象方法分类速查
全面梳理JavaScript核心内置函数与常用标准对象方法,涵盖全局函数、Object、Array、String、Number/Math以及JSON/Date的分类速查、选型推导、核心区别与避坑指南。
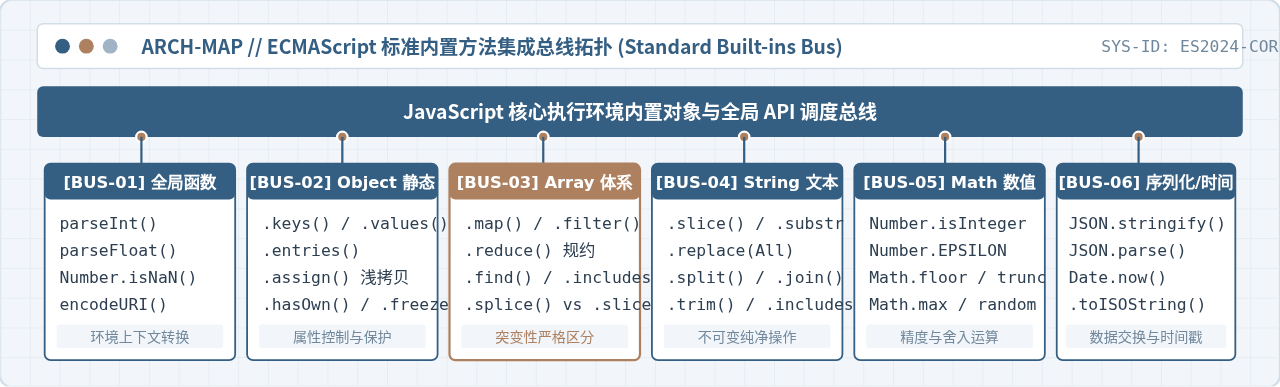
在 JavaScript 开发中,内置函数与标准对象方法是构建业务逻辑的核心基石。面对数量庞大的 API,清晰掌握其分类归属、入参与返回值特征、是否存在“原地突变”(In-Place Mutation)副作用,以及各类边界条件的判断逻辑,是写出稳定高效代码的关键。本文将常用内置 API 分为全局函数、Object 静态方法、Array 数组操作、String 文本处理、Number 与 Math 数值运算以及 JSON/Date 序列化与时间六大模块,通过参数规则、行为对比、完整代码及避坑指南,提供系统化分类速查。
一、全局内置函数速查与类型解析机制
全局内置函数直接挂载于全局执行上下文(浏览器中为 window,Node.js 中为 global)。它们主要承担字符串解析、非数值判断以及网络传输编解码等通用任务。
1. 数值解析与强制类型转换
在提取字符串中的数值时,parseInt、parseFloat 与包装函数 Number() 存在本质上的解析策略分歧:
parseInt(string, radix):解析整数。该函数会忽略前导空白符,从首个有效字符逐位扫描,直到遇到当前进制下的非法字符即截断停止。永远显式传入第二个参数radix(基数 2~36),避免在不同环境或前缀引发八进制/十六进制歧义解析。若首个非空格字符无法转换为数字,返回NaN。parseFloat(string):解析浮点数。遵循类似的前缀扫描机制,支持小数点与科学计数法(例如"3.14e-2"返回0.0314),只支持十进制。Number(value):执行 ECMAScript 规范的严格ToNumber强制转换。一旦字符串内包含任何非数字字符(前导和后置空白除外),整串解析直接失败返回NaN。注意特殊值的转换:Number("") === 0、Number(null) === 0、Number(undefined) === NaN。
// 示例 1:数值提取与全量强转的差异
const rawInput = "42px";
console.log(parseInt(rawInput, 10)); // 输出示例: 42 (容错截断)
console.log(Number(rawInput));        // 输出示例: NaN (严格整串校验失败)

// 示例 2:空值转换对比
console.log(parseInt("", 10)); // 输出示例: NaN
console.log(Number(""));       // 输出示例: 0
console.log(Number(null));     // 输出示例: 0
console.log(Number(undefined));// 输出示例: NaN
2. NaN 校验机制:全局 isNaN 与 Number.isNaN 的安全分流
由于 NaN === NaN 返回 false,判断一个值是否为 NaN 不能使用全等比较运算符。JavaScript 提供了两个校验函数,但机制截然不同:
isNaN(value):会先隐式调用Number(value)强制转换输入,再对转换结果进行判断。因此,传入任何无法转为数值的参数(如非空字符串"abc"、未定义undefined、空对象{})都会得到true,产生严重假阳性误判。Number.isNaN(value):严格校验。不进行任何隐式类型转换。仅当传入值的类型本身就是number且值为NaN时,才会返回true。这是现代工程规范中的唯一推荐用法。
// 示例:全局 isNaN 缺陷与 Number.isNaN 严格安全对比
console.log(isNaN("hello"));        // 输出示例: true (隐式 Number("hello") 得到 NaN)
console.log(Number.isNaN("hello")); // 输出示例: false (类型为 string,直接判定安全)
console.log(Number.isNaN(NaN));     // 输出示例: true (仅自身是 NaN 时为 true)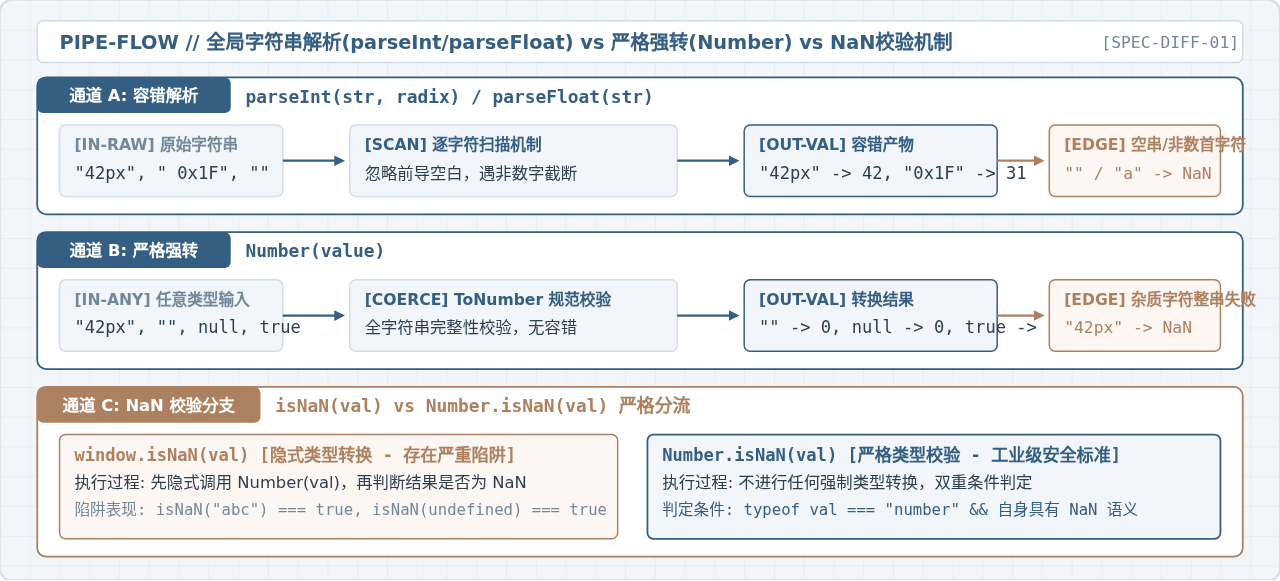
3. URI 编解码函数选型
在网络请求与 URL 处理中,encodeURI 与 encodeURIComponent 的编码范围不同:
encodeURI(URI):用于对完整 URI 进行编码。它假定输入是一个完整的地址,因此不会转义 URI 保留字符(如; , / ? : @ & = + $ #)。encodeURIComponent(URIChunk):用于对 URI 的某个片段(如 Query 参数的值)进行编码。它会将除了字母、数字及- _ . ! ~ * ' ( )之外的所有特殊保留字符(包括&、=、/、?、#)全部转义为 UTF-8 百分比编码。如果将未经处理的 Query 参数直接拼接到 URL 中,必须使用此函数,防止参数内部的特殊符号破坏 URL 结构。
// 示例:URL 参数拼接安全实践
const queryVal = "A&B=C+D/E";
const url1 = "https://example.com/api?keyword=" + encodeURI(queryVal);
// 结果示例: "https://example.com/api?keyword=A&B=C+D/E" (无法阻断 & 和 =,导致参数解析错乱)

const url2 = "https://example.com/api?keyword=" + encodeURIComponent(queryVal);
// 结果示例: "https://example.com/api?keyword=A%26B%3DC%2BD%2FE" (正确转义为单一安全参数值)
二、Object 核心静态方法与属性内存操控
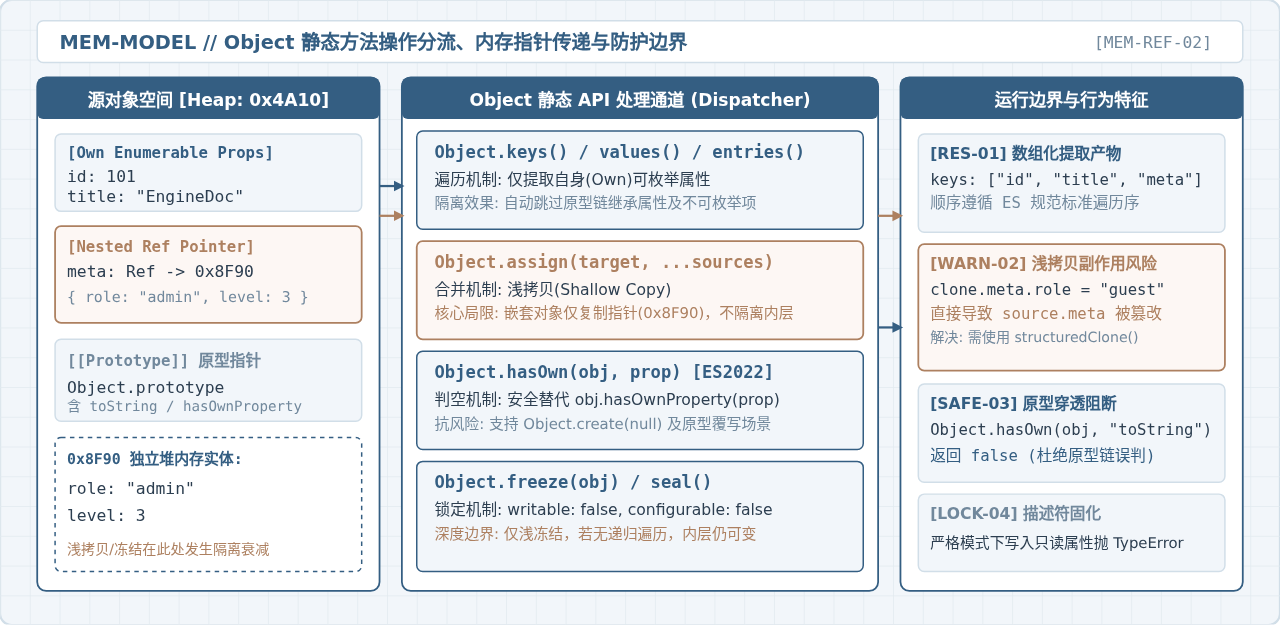
Object 构造函数的静态方法主要用于对象属性的提取、合并、原型链接以及属性状态保护。理解这些方法对对象引用的影响是避免浅拷贝共享状态 bug 的核心。
1. 属性枚举提取:keys、values 与 entries
对于普通对象的遍历,传统 for...in 循环会沿原型链向上追溯继承属性,需要手动调用 hasOwnProperty 过滤。而 Object 的静态提取方法则具备清晰的作用域边界:
Object.keys(obj):返回包含对象自身所有可枚举属性名(字符串)的数组。Object.values(obj):返回对象自身所有可枚举属性值的数组。Object.entries(obj):返回对象自身所有可枚举属性键值对[key, value]的二维数组,通常配合for...of解构或直接转换为new Map(Object.entries(obj))。
Object.getOwnPropertySymbols() 或 Reflect.ownKeys() 获取)。
const userConfig = { id: 101, title: "Report", 2: "second", 1: "first" };
console.log(Object.keys(userConfig));
// 输出示例: ["1", "2", "id", "title"] (整数键优先且升序,随后为字符串键)

for (const [key, value] of Object.entries(userConfig)) {
  console.log(`${key} -> ${value}`);
}
2. 对象合并与浅拷贝陷阱:Object.assign
Object.assign(target, ...sources) 将一个或多个源对象自身的可枚举属性复制到目标对象 target 中,并返回修改后的 target。
- 原地修改目标:它会直接突变首个参数
target。若需要纯函数式合并,必须以空对象作为首参:Object.assign({}, source1, source2)。 - 浅拷贝局限:对于基础类型属性复制其值;对于对象或数组属性,复制的仅仅是堆内存地址指针。修改克隆对象中的嵌套对象,源对象的对应属性会同步改变。
const source = { id: 1, info: { role: "admin" } };
const shallowCopy = Object.assign({}, source);

shallowCopy.info.role = "guest";
console.log(source.info.role);
// 输出示例: "guest" (源对象嵌套属性被意外污染!)
3. 安全属性判定:Object.hasOwn
以往检查属性是否在对象自身常用 obj.hasOwnProperty(prop),但这存在两大安全隐患:一是通过 Object.create(null) 创建的无原型对象不存在该方法(调用会抛出 TypeError: obj.hasOwnProperty is not a function);二是对象自身可能定义了名为 hasOwnProperty 的覆盖属性。ES2022 引入的 Object.hasOwn(obj, prop) 直接解决了这些问题:
// 针对字典对象与原型覆写场景
const pureDict = Object.create(null);
pureDict.key = "data";

// 传统做法抛错: pureDict.hasOwnProperty("key");
console.log(Object.hasOwn(pureDict, "key")); // 输出示例: true (安全稳定)

const trickyObj = { hasOwnProperty: () => false, valid: 123 };
console.log(Object.hasOwn(trickyObj, "valid")); // 输出示例: true (不受自身同名属性遮蔽)
4. 对象状态冻结与防护等级
JavaScript 提供了三种递进式的对象修改限制方法:
| 方法 | 添加新属性 | 删除现有属性 | 修改现有属性值 | 修改属性描述符 |
|---|---|---|---|---|
Object.preventExtensions(obj) |
❌ 禁止 | ✅ 允许 | ✅ 允许 | ✅ 允许 |
Object.seal(obj) (密封) |
❌ 禁止 | ❌ 禁止 | ✅ 允许 | ❌ 禁止 |
Object.freeze(obj) (冻结) |
❌ 禁止 | ❌ 禁止 | ❌ 禁止 | ❌ 禁止 |
Object.freeze() 仅对对象顶层属性生效。如果属性值是另一个对象,该嵌套对象仍然处于可写状态。如需彻底锁定,需要递归冻结或在更新时依赖不可变架构。
三、Array 核心操作与方法选型推导
数组操作是前端与全栈开发中调用最频繁的部分。选择数组方法的第一准则是明确操作是否会原地修改原数组。在现代基于状态驱动(如 React、Vue)的架构中,意外的原地突变往往是导致组件不重新渲染或数据混乱的直接根源。
1. 原地突变型方法(Mutating Methods)
以下方法直接在原数组内存区域上进行修改,不创建新数组实例:
push(...items)/pop():尾部添加/移除元素。时间复杂度为 O(1)。push返回操作后数组的新长度;pop返回被移除的元素。unshift(...items)/shift():头部添加/移除元素。需要移动后续所有元素的内存索引,时间复杂度为 O(n)。splice(start, deleteCount, ...items):从指定索引开始删除指定数量元素,并在此处插入新元素。返回值是被删除的元素数组,原数组被直接截断或重塑。sort(compareFn):原地排序。极其重要的陷阱:当省略比较函数时,默认将所有元素转为字符串后按 UTF-16 字典码位升序排列。例如[10, 2, 5].sort()会得到[10, 2, 5]。数值排序必须显式传入(a, b) => a - b。reverse():原地倒转数组。
toSorted()、toReversed()、toSpliced() 以及替换指定索引的 with(index, value)。它们均返回一个全新的数组,保持原数组不变。
// 示例:数值排序与 splice 操作行为
const scores = [10, 2, 50, 3];
scores.sort((a, b) => a - b);
console.log(scores); // 输出示例: [2, 3, 10, 50] (必须显式传参)

const removed = scores.splice(1, 2, 99);
console.log(removed); // 输出示例: [3, 10] (被删除的元素集合)
console.log(scores);  // 输出示例: [2, 99, 50] (原数组已被改变)
2. 不可变与映射过滤方法(Non-mutating Methods)
纯函数式处理遵循“输入不变,产出新值”的原则:
slice(start, end):提取索引区间[start, end)内的浅拷贝新数组。支持负数索引(负数代表从末尾向前倒数,如-1代表最后一个元素)。常用于安全截取或浅复制整个数组arr.slice()。map(callback(currentValue, index, array)):对每个元素应用映射函数,返回等长的新数组。filter(predicate):对每个元素执行真值测试,仅保留返回真值的元素组成新数组。flat(depth):按照指定深度递归拉平嵌套数组(默认深度为 1,传入Infinity可展开任意嵌套层级)。flatMap(callback):先执行map映射,再对结果执行深度为 1 的flat扁平化。相比先.map().flat(),单次遍历性能更优。
// flatMap 拆解词频场景
const sentences = ["hello world", "javascript core"];
const words = sentences.flatMap(s => s.split(" "));
console.log(words); // 输出示例: ["hello", "world", "javascript", "core"]
3. 检索与判定方法选型
根据查找目标与判定维度的不同,选择最语义化的 API:
includes(searchElement, fromIndex):判断数组是否包含某个基础值,返回布尔值。使用SameValueZero比较算法,能够正确检测NaN。indexOf(searchElement):查找元素的第一个索引,未找到返回-1。使用严格全等(===),无法检测NaN。find(predicate):查找满足断言函数的首个元素本身,未找到返回undefined。findIndex(predicate):查找满足断言函数的首个元素索引,未找到返回-1。(ES2023 新增从后往前查找的findLast与findLastIndex)。some(predicate):只要有一个元素满足条件即返回true,具备短路求值特性。every(predicate):必须所有元素均满足条件才返回true。注意:空数组调用every始终返回true(空真命题)。
// 检索 NaN 的差异
const listWithNaN = [1, NaN, 3];
console.log(listWithNaN.indexOf(NaN));  // 输出示例: -1 (严格全等匹配失败)
console.log(listWithNaN.includes(NaN)); // 输出示例: true (SameValueZero 正常识别)
4. 聚合计算:reduce 核心范式
reduce(callback(accumulator, currentValue, currentIndex, array), initialValue) 将数组归约为单个实体(数值、对象、分组映射等)。
initialValue!如果省略该参数,reduce 会把数组第一个元素作为初始累加器,并从第二个元素开始迭代。如果数组为空且未提供 initialValue,执行时将抛出 TypeError: Reduce of empty array with no initial value。
// 示例:将列表转换为按类别分组的哈希表
const items = [
  { name: "Apple", type: "fruit" },
  { name: "Carrot", type: "vegetable" },
  { name: "Banana", type: "fruit" }
];

const grouped = items.reduce((acc, item) => {
  const key = item.type;
  if (!acc[key]) {
    acc[key] = [];
  }
  acc[key].push(item.name);
  return acc;
}, {}); // 显式初始空对象

console.log(grouped);
// 输出示例: { fruit: ["Apple", "Banana"], vegetable: ["Carrot"] }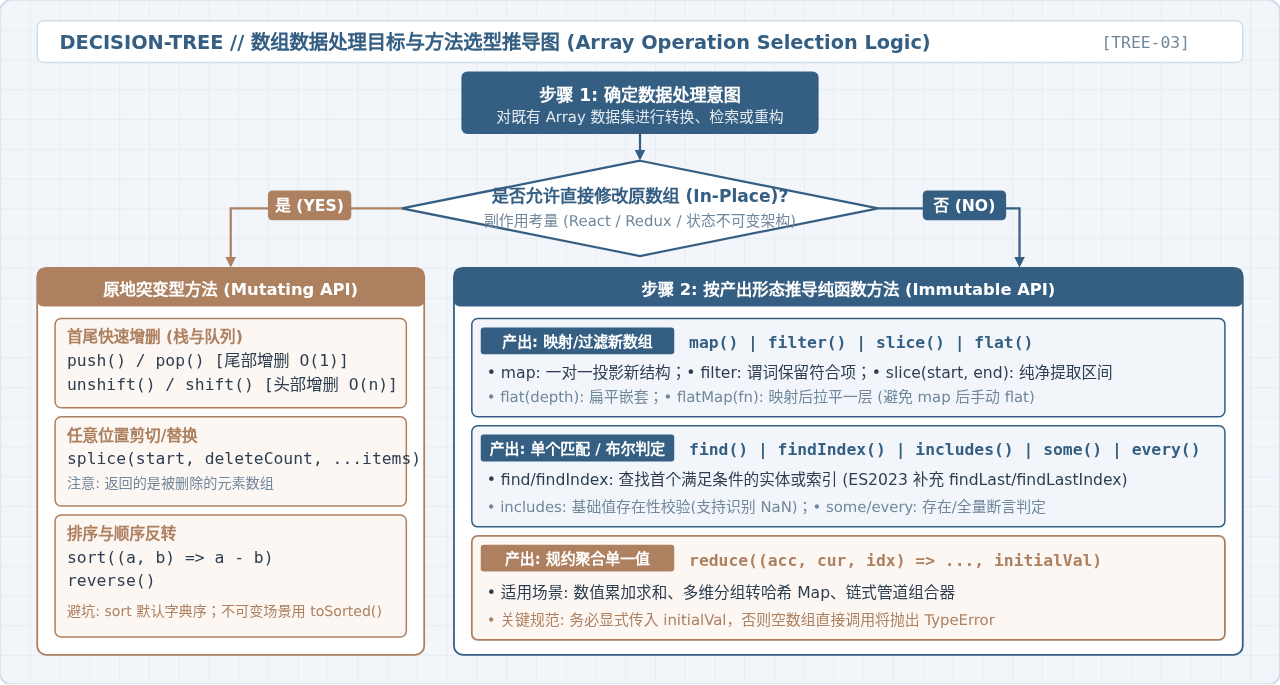
四、String 字符串常用处理方法与模式
在 JavaScript 中,字符串(String)是不可变基元类型(Primitive)。所有字符串方法均不会修改原字符串,而是返回一个新的字符串或数组。
1. 子串切片:slice vs substring
提取子串主要使用 slice 与 substring,建议在所有工程中统一使用 slice,原因如下:
str.slice(start, end):提取从start到end(不包含end)的字符。若参数为负数,会自动转为length + index,便于直接提取尾部子串(例如str.slice(-4)提取最后 4 位)。str.substring(start, end):不支持负数。如果传入负数会被隐式强制视为0;同时如果start > end,它会自动对调两个参数的值,容易掩盖逻辑计算错误。
const text = "2026-11-18";
console.log(text.slice(-2));      // 输出示例: "18" (从倒数第2位截取到末尾)
console.log(text.substring(-2));   // 输出示例: "2026-11-18" (负数被强转为0,截取全量)
2. 字符替换:replace 与 replaceAll
字符串替换是极为常见的踩坑点:
str.replace(pattern, replacement):当pattern为普通字符串时,仅替换第一个匹配项!后续匹配项将被保留。若要替换全部,必须传入携带全局修饰符的正则表达式/pattern/g。str.replaceAll(pattern, replacement):ES2021 引入。当pattern为字符串时,自动替换全部匹配项。若pattern为正则表达式,必须显式添加g标志,否则会直接抛出TypeError。
const phrase = "blue and blue and blue";
console.log(phrase.replace("blue", "red"));    // 输出示例: "red and blue and blue" (仅首个被替换)
console.log(phrase.replaceAll("blue", "red")); // 输出示例: "red and red and red" (全量替换)
3. 分割、去空与对齐填充
split(separator, limit):根据分隔符将字符串拆分为数组。传入空字符串""可按字符拆分(注意多字节 Emoji 可能会被拆解为代理对,复杂 Unicode 推荐使用Array.from(str))。trim()/trimStart()/trimEnd():移除字符串两端、仅头部或仅尾部的空白字符(空格、制表符及换行符)。padStart(targetLength, padString)/padEnd(targetLength, padString):若当前字符串长度未达到targetLength,在开头或末尾重复填充padString直至满足长度。常用于日期补零、订单号或卡号脱敏对齐。
// 补齐 2 位数日期
const month = "5";
console.log(month.padStart(2, "0")); // 输出示例: "05"
五、Number 与 Math 数值计算方法与精度
JavaScript 按照 IEEE 754 双精度 64 位浮点数格式存储所有数值。这带来了极高的数据灵活性,但同时也引入了数值精度边界与取整截断特性。
1. 安全整数范围与类型校验
浮点数的尾数位有限,安全整数范围为 [-((2^53) - 1), (2^53) - 1](即 -9007199254740991 到 9007199254740991)。常量为 Number.MIN_SAFE_INTEGER 与 Number.MAX_SAFE_INTEGER。超过此范围的整数加减将丢失精度,应使用 BigInt。
Number.isInteger(value):判断是否为整数。注意Number.isInteger(5.0)为true,因为在底层存储中5.0与5无区别。Number.isSafeInteger(value):判断是否在安全整数区间内。Number.EPSILON:表示 1 与大于 1 的最小浮点数之间的差值(约为2.22e-16)。由于浮点精度问题,经典计算0.1 + 0.2 === 0.30000000000000004并不等于0.3。浮点数比较应使用公差判定:
// 浮点数安全相等性判定规范
function numbersEqual(a, b) {
  return Math.abs(a - b) < Number.EPSILON;
}
console.log(0.1 + 0.2 === 0.3);         // 输出示例: false
console.log(numbersEqual(0.1 + 0.2, 0.3)); // 输出示例: true
2. 四种截断舍入方法的行为差异
对于正负数值,四种取整函数的表现存在明确分水岭:
| 输入值 | Math.floor (向下取整) | Math.ceil (向上取整) | Math.round (四舍五入) | Math.trunc (直接丢弃小数) |
|---|---|---|---|---|
3.7 |
3 |
4 |
4 |
3 |
-3.7 |
-4 |
-3 |
-4 |
-3 |
-3.5 |
-4 |
-3 |
-3 (朝正无穷舍入) |
-3 |
在涉及负数的坐标或像素截断时,应首选 Math.trunc(),其行为始终朝 0 的方向去除小数部分,最符合常规数学截断直觉。
3. 极值与区间随机数
Math.max(...values)/Math.min(...values):计算参数最大最小值。若通过展开运算符Math.max(...largeArray)处理超大数组(超过数万个元素),可能引发调用栈溢出(Maximum call stack size exceeded)。超大数组建议使用arr.reduce((max, cur) => cur > max ? cur : max, -Infinity)。Math.random():返回[0, 1)区间的伪随机浮点数。生成包含端点[min, max]的随机整数标准公式为:
function getRandomIntInclusive(min, max) {
  const minCeil = Math.ceil(min);
  const maxFloor = Math.floor(max);
  return Math.floor(Math.random() * (maxFloor - minCeil + 1)) + minCeil;
}
六、JSON 与 Date 序列化与时间处理
1. JSON 转换边界与自定义处理
JSON.stringify 与 JSON.parse 在处理复杂对象时具备特定的忽略与异常规则:
- 数据类型丢弃:在对象序列化中,若属性值为
undefined、函数(Function)或Symbol,该键值对会被直接忽略;若在数组中,则会被转为null。 - 循环引用:若对象内部存在自我引用(Circular Reference),
JSON.stringify会抛出TypeError: Converting circular structure to JSON。 - 高级参数:
JSON.stringify(value, replacer, space)中,replacer支持传入数组白名单或转换回调函数;space传入数字(如2)可格式化输出缩进 JSON。JSON.parse(text, reviver)则支持在还原过程中修复特定字段(如将 ISO 日期字符串直接还原为Date对象)。
// 示例:JSON.parse reviver 恢复日期对象
const rawJson = '{"createdAt":"2026-11-18T05:00:00.000Z","status":"active"}';
const parsed = JSON.parse(rawJson, (key, value) => {
  if (key === "createdAt") return new Date(value);
  return value;
});
console.log(parsed.createdAt instanceof Date); // 输出示例: true
2. Date 时间戳与格式化规范
Date.now():获取当前时刻的 Unix 毫秒时间戳,相较于new Date().getTime()避免了创建实例的开销。new Date().toISOString():返回 ISO 8601 标准零时区(UTC)格式字符串(例如2026-11-18T05:49:28.000Z),是前后端接口交互的首选标准。- 本地化格式化推荐使用
Intl.DateTimeFormatAPI 或date.toLocaleString(),避免自行拼凑字符串导致时区计算偏移。
七、综合速查总结与高频易错避坑清单
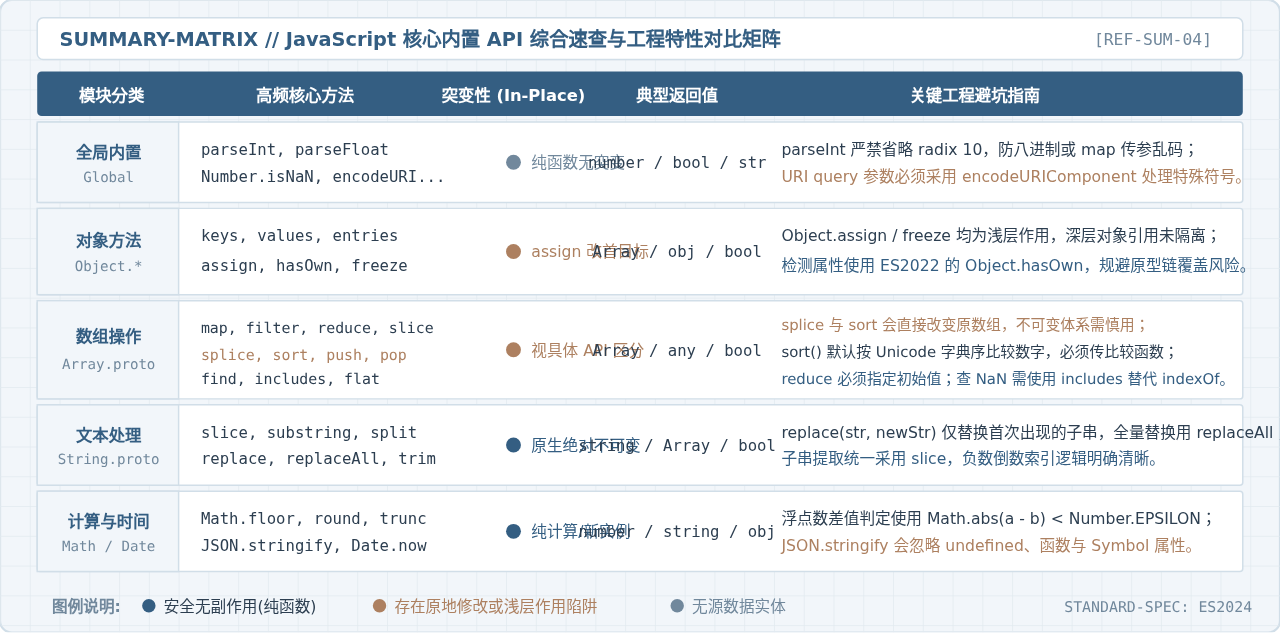
高频核心陷阱深度复盘
-
经典
['1', '7', '11'].map(parseInt)陷阱:
预期输出[1, 7, 11],实际输出为[1, NaN, 3]。
根本原因:map传递给回调的参数是(item, index)。这导致parseInt依次执行:parseInt('1', 0)(radix 0 按十进制返回 1);parseInt('7', 1)(一进制中无 7,返回 NaN);parseInt('11', 2)(二进制中 11 对应十进制 3)。
正确写法:['1', '7', '11'].map(num => parseInt(num, 10))或['1', '7', '11'].map(Number)。 -
数组
sort()默认字典序导致数值混乱:
无论数组内部存储的是数字还是字符串,无参sort()都会将其元素转为字符串比较。因此[10, 2, 5].sort()产生[10, 2, 5]。
正确写法:始终显式传入比较函数arr.sort((a, b) => a - b)。 -
Object.assign浅拷贝导致的嵌套状态污染:
深层嵌套的对象只是复制了引用指针,并非深隔离。若需对包含嵌套对象的配置进行完全克隆,现代浏览器与 Node.js 17+ 应优先采用原生structuredClone(obj),它支持循环引用、Date、RegExp、Map、Set 等复杂类型。 -
indexOf检索NaN始终返回 -1:
indexOf依赖全等符===进行匹配,而NaN === NaN为false。判断数组中是否存在NaN必须使用arr.includes(NaN)或arr.findIndex(Number.isNaN)。 -
空数组调用
reduce缺失初始值崩溃:
当数据源可能为空数组时,未提供第二个初始值参数会直接触发运行时TypeError。在任何业务聚合操作中,应养成显式声明初始值的工程规范。
JS怎么保留输入数字的指定位数小数
2026-11-19 16:38:29
JS数组随机打乱:为什么不建议用sort实现洗牌
2026-11-19 15:36:04
JS中正整数与非负整数的正则区别是什么?
2026-11-19 14:28:20
JavaScript获取当前毫秒时间戳的常用方法
2026-11-19 14:19:28
JavaScript的异步机制真的比Python难掌握吗
2026-11-19 13:48:10







