

JS中正整数与非负整数的正则区别是什么?
深入对比JavaScript中正整数与非负整数的正则表达式差异,详解^[1-9]\d*$与^(0|[1-9]\d*)$的推导逻辑、前导零防御策略及工程化校验实践。
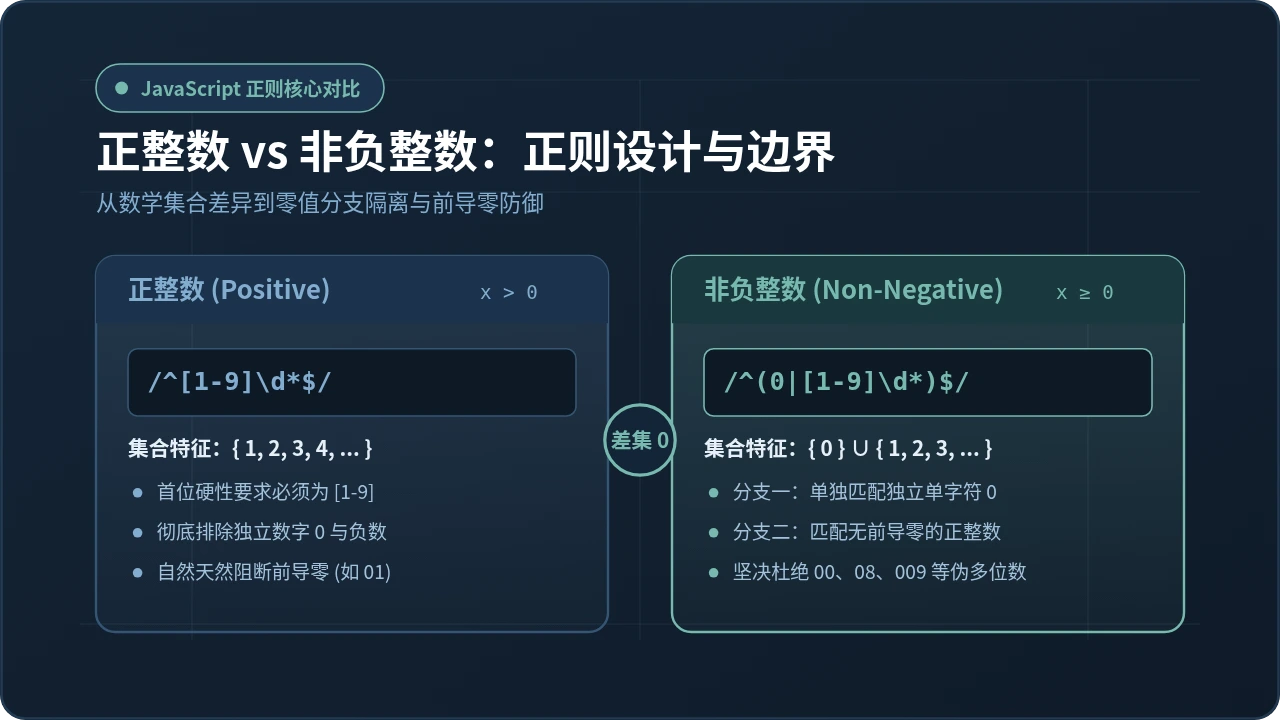
假设你正在开发一个电商后台管理系统,表单中有两个关键的数值输入项:一个是分页组件中的“当前跳转页码”(页码必须从 1 开始),另一个是商品编辑面板中的“当前可用库存”(商品售罄时库存为 0 是完全合法的)。如果开发者为了图方便,直接在两处统一套用 ^\d+$,就会立刻引发业务逻辑漏洞——既可能放行“跳转第 0 页”的非法请求,又可能放行诸如 "00"、"012" 这类带有无效前导零的异常字符串,给后续的数据持久化与金额计算埋下隐患。
这两类需求所对应的数学对象与正则设计有着清晰的边界界定:正整数(Positive Integer)是严格大于 0 的整数集合,其标准 JavaScript 正则为 /^[1-9]\d*$/;而非负整数(Non-negative Integer)则包含了 0 以及所有正整数,其标准 JavaScript 正则为 /^(0|[1-9]\d*)$/。两者在正则写法上的最本质区别,正是是否容纳字符 0 以及如何通过分支隔离来杜绝多重零与前导零。
一、数学集合与正则字符集的映射关系
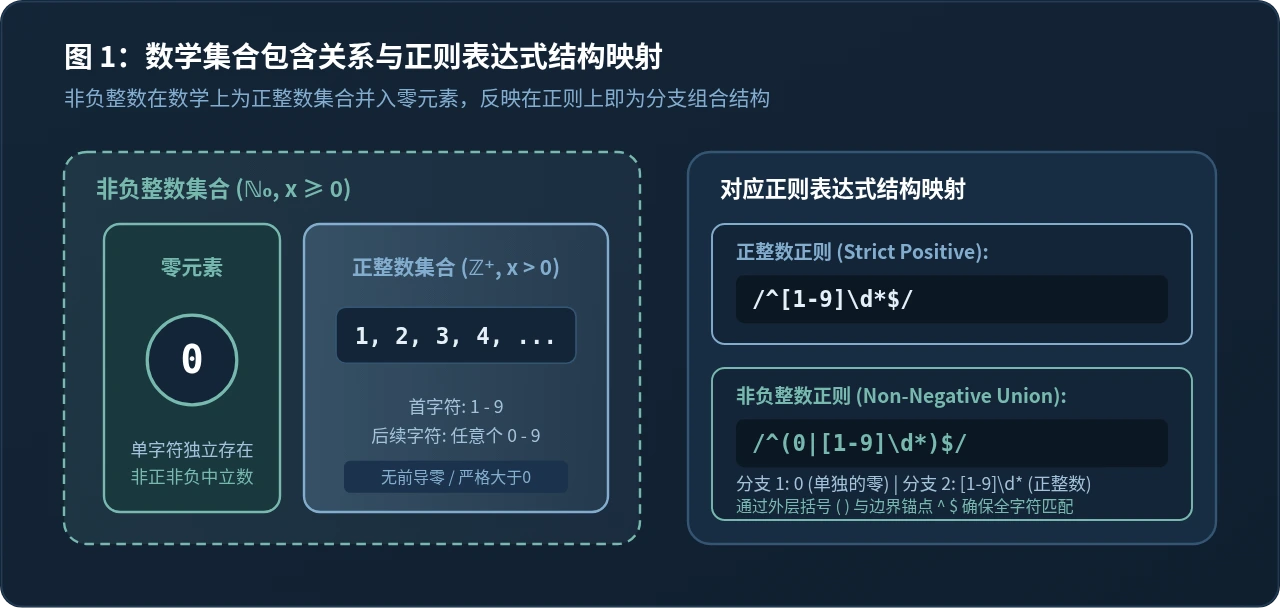
在理解正则表达式之前,首先需要明确数学层面的定义差异:
- 正整数集合(ℤ⁺):{ 1, 2, 3, 4, ... }。它的任何一个元素都严格大于 0。映射到字符串结构上,其首个字符必须是数字
1 ~ 9中的某一个,绝对不能是0。 - 非负整数集合(ℕ₀):{ 0, 1, 2, 3, 4, ... }。它是在正整数集合的基础上,额外并入了单元素集合 { 0 }。因此有等式:非负整数 = 正整数 ∪ { 0 }。
正是因为“0”既不是正数也不是负数的中立特性,当它并入正整数集合时,在正则中不能简单地把首位字符集放宽为 [0-9]。如果直接写 [0-9]\d*,就无法阻止 "012" 这类以 0 开头但后续仍有数字的情况。正确的做法是将集合关系映射为正则的“分支逻辑”:要么精准匹配单独的单字符 0,要么匹配标准正整数结构 [1-9]\d*。
二、为什么不能写 ^\d+$?前导零陷阱与推导过程
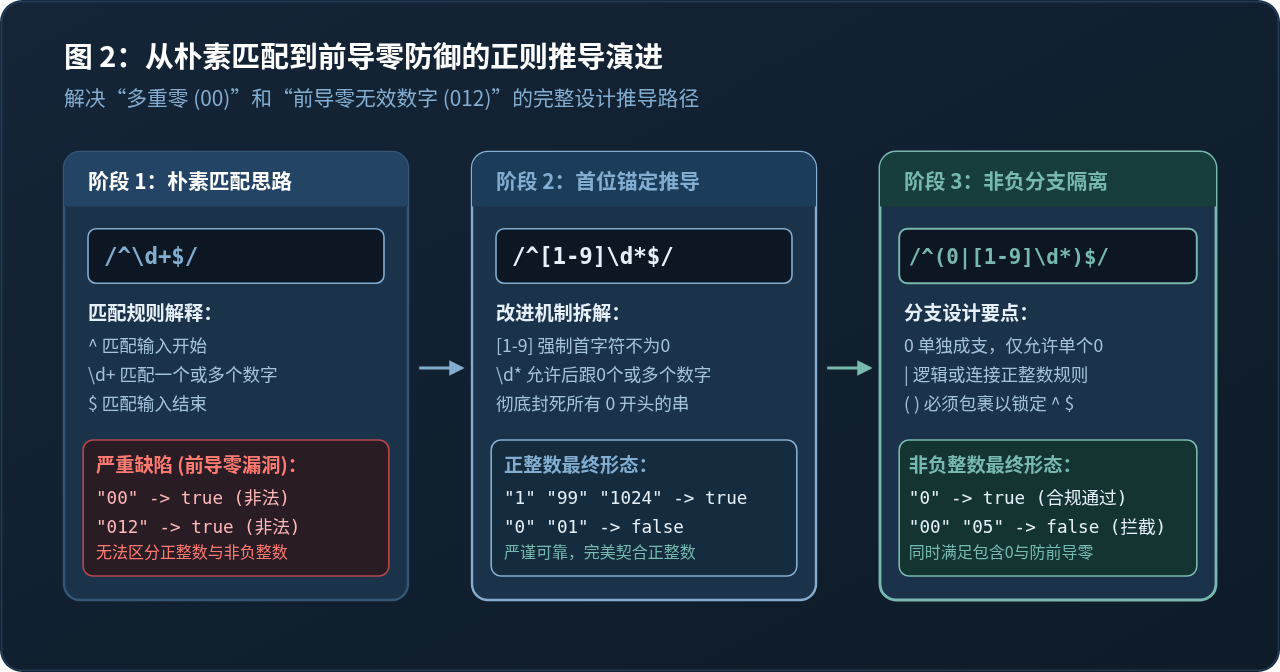
很多初学者在编写数值校验时喜欢直接使用 /^\d+$/,认为只要“全是数字”就足够了。但在严谨的 Web 与后端交互中,单纯的 /^\d+$/ 存在两大致命缺陷:
- 前导零污染(Leading Zeros):
"007"、"012"会被/^\d+$/判定为合法。在 JavaScript 中,带有前导零的数值字符串如果传给非严格模式下的解析器,可能被误当成八进制数处理;或者存入数据库后再格式化回显时丢失前导零,导致前后端数据摘要不一致。 - 多重零漏洞(Multiple Zeros):
"00"、"000"会顺利通过校验,这在任何正规表单中都是毫无意义且非法的输入格式。
正整数正则的推导步骤
为了构建一个无漏洞的正整数正则,我们按字符位置分步推导:
- 第一位字符:必须在 1 到 9 之间,字符集记作
[1-9]。这一步直接将数字0与负号排除在外。 - 后续字符:首位之后可以跟任意个(0个或多个)数字
0 ~ 9,使用量词*,记作\d*。 - 首尾边界锚点:使用
^锚定起始,$锚定结束,防止在长字符串中发生部分匹配。组合后即为:/^[1-9]\d*$/。
非负整数正则的分支推导步骤
非负整数只允许两种合法外观:
- 外观一:纯粹的单个字符
0,绝不允许后面再追加任何数字(如00非法)。模式记作0。 - 外观二:严格的正整数,由
[1-9]\d*覆盖。 - 分支与优先级合并:使用正则的管道符
|连结两组互斥分支,并必须用圆括号包裹建立优先级作用域:/^(0|[1-9]\d*)$/。如果省略圆括号写成/^0|[1-9]\d*$/,则会变成“以 0 开头或者以正整数结尾”,造成灾难性的匹配范围溢出。
三、JavaScript 实战校验函数封装与执行流水线
在实际工程代码中,直接调用 regex.test() 还需要配合类型防护与边界检查。以下提供生产环境可直接复用的通用校验模块:
/**
 * 数值与整型校验工具模块
 */
const REG_POSITIVE_INT = /^[1-9]\d*$/;
const REG_NON_NEGATIVE_INT = /^(0|[1-9]\d*)$/;

/**
 * 校验是否为合法正整数(严格大于0,无前导零,安全整型范围内)
 * @param {string|number} val
 * @returns {boolean}
 */
function isPositiveInteger(val) {
  // 1. 过滤空值、对象、Symbol等非法入参
  if (val === null || val === undefined || typeof val === 'boolean') {
    return false;
  }

  // 2. 清洗首尾空白字符
  const str = String(val).trim();
  if (!str) return false;

  // 3. 正则精准形态匹配
  if (!REG_POSITIVE_INT.test(str)) {
    return false;
  }

  // 4. 边界安全判定:防范超出 JS 最大安全整数溢出
  const num = Number(str);
  return Number.isSafeInteger(num) && num > 0;
}

/**
 * 校验是否为合法非负整数(大于等于0,无前导零,安全整型范围内)
 * @param {string|number} val
 * @returns {boolean}
 */
function isNonNegativeInteger(val) {
  if (val === null || val === undefined || typeof val === 'boolean') {
    return false;
  }

  const str = String(val).trim();
  if (!str) return false;

  if (!REG_NON_NEGATIVE_INT.test(str)) {
    return false;
  }

  const num = Number(str);
  return Number.isSafeInteger(num) && num >= 0;
}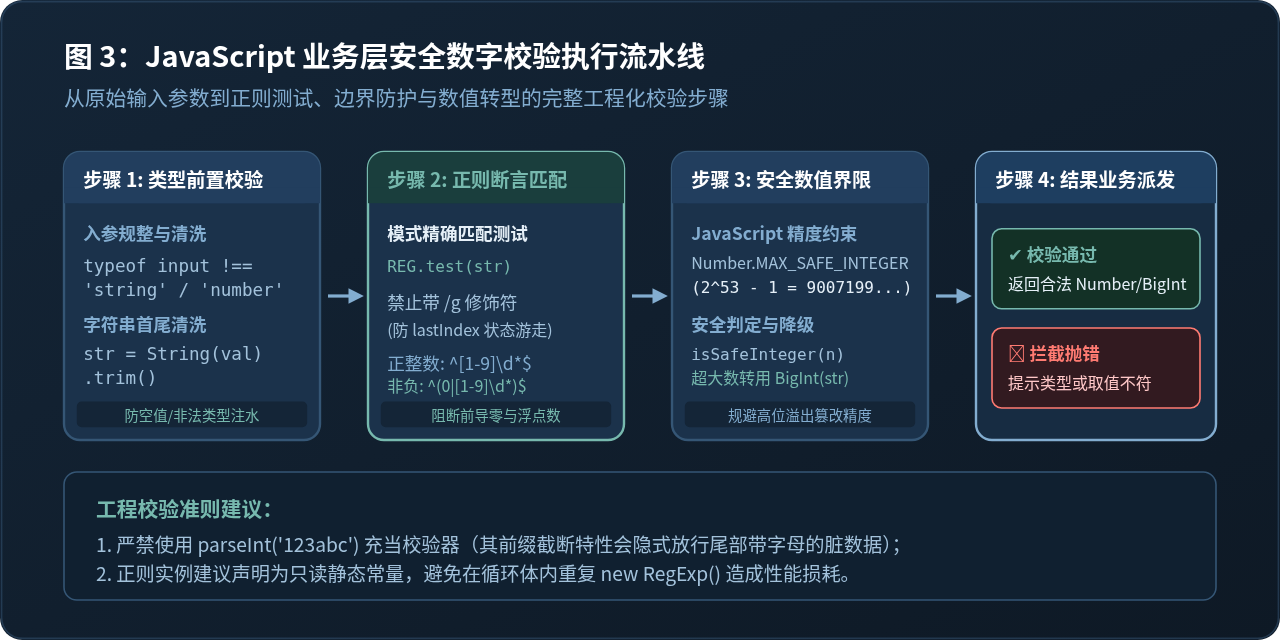
Number.MAX_SAFE_INTEGER(即 253 - 1 = 9007199254740991)。此时仅依赖正则通过即可安全传给 BigInt(str) 处理,切忌调用 Number(str) 造成尾数精度丢失。
四、常见边界用例响应矩阵与场景选型速查
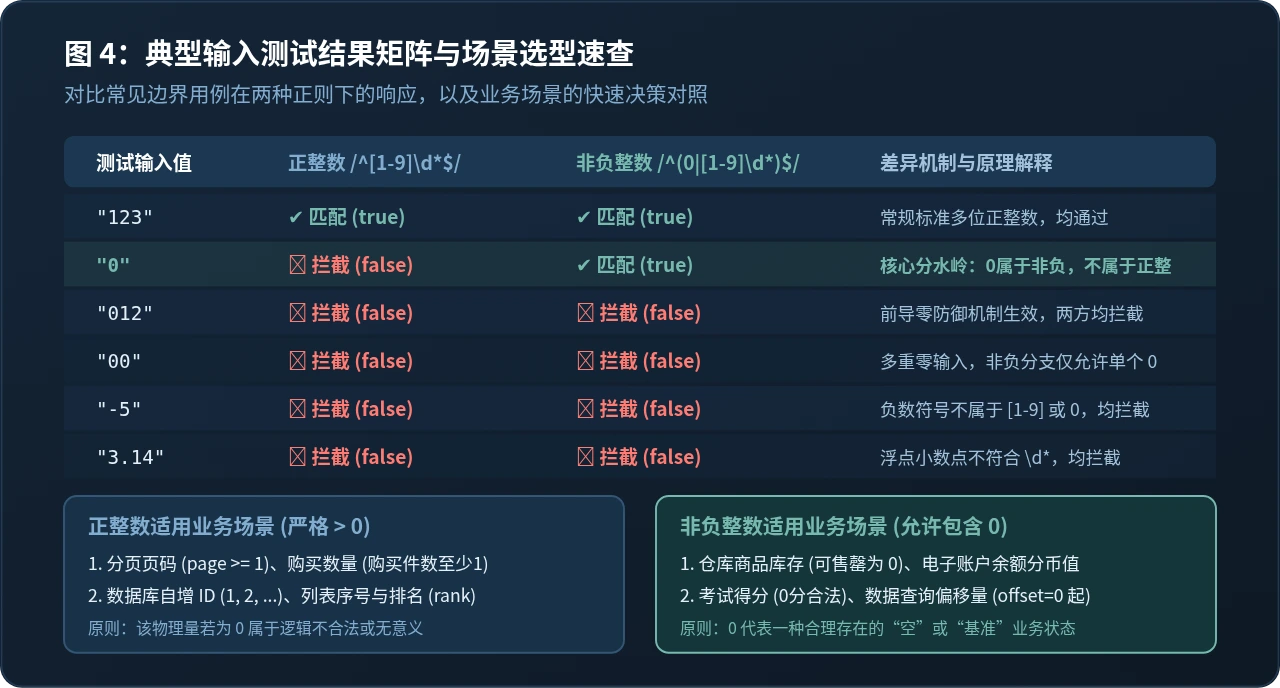
为了直观对比正整数正则与非负整数正则在不同边界场景下的反应差异,下表列出了常见输入值的检验结果:
| 输入值 (字符串) | 正整数正则 /^[1-9]\d*$/ |
非负整数正则 /^(0|[1-9]\d*)$/ |
校验原理解析 |
|---|---|---|---|
"1" |
✔ true | ✔ true | 最小正整数,均完全合法 |
"100" |
✔ true | ✔ true | 首位非零,后续包含双零,符合标准整型 |
"0" |
❌ false | ✔ true | 核心分水岭:正整数排除0,非负整数专属接纳 |
"01" / "007" |
❌ false | ❌ false | 前导零防御机制起效,首位为0但长度大于1,被双双拦截 |
"00" |
❌ false | ❌ false | 非负分支仅精确放行单字符 "0",多重零被拦截 |
"-5" |
❌ false | ❌ false | 带负号字符,不属于正数或零 |
"+8" |
❌ false (默认模式) | ❌ false (默认模式) | 默认不含符号位;如需支持显式正号需单独扩展 \+? |
"3.14" |
❌ false | ❌ false | 包含小数点,被 \d* 严格阻断 |
"" (空字符串) |
❌ false | ❌ false | 量词至少要求首位存在字符,拒绝空串 |
五、JavaScript 开发中的 3 个常见误区与避坑指南
1. 全局标志 /g 带来的 lastIndex 状态游走
很多开发者习惯性地给所有正则加上 /g 修饰符(例如 /^[1-9]\d*$/g)。在 JavaScript 中,带有 g 标志的 RegExp 实例是有内部状态的。调用 test() 会更新其 lastIndex 属性,当连续对不同字符串调用同一个正则实例时,会出现“初次检验返回 true,第二次同一参数却返回 false”的诡异 bug。表单验证务必确保不使用 /g 标志。
2. 误用 parseInt 代替正则格式校验
部分项目尝试使用 parseInt(str, 10) > 0 来代替正则校验正整数。这是极其危险的,因为 parseInt 采用的是“前缀贪婪解析”机制。对于输入 "123abc",parseInt("123abc", 10) 会静默截断并返回 123,从而使得校验条件成立,放行脏数据进入数据库。
3. 非字符串传参时的隐式 toString 陷阱
当直接将非字符串变量传入 regex.test(val) 时,引擎会在内部隐式执行 val.toString()。例如:
- 浮点数
1.0:在 JS 引擎中(1.0).toString()的计算结果是"1",从而意外通过了/^[1-9]\d*$/; - 特大数值
1e21:其toString()会输出科学计数法"1e+21",其中包含字符'e'和'+',导致直接被整型正则误拒。
因此,对于表单或接口入参,优先保持原始字符串形式进行正则匹配,确认格式绝对纯粹后再按需转换为数值。
JavaScript获取当前毫秒时间戳的常用方法
2026-11-19 14:19:28
JavaScript的异步机制真的比Python难掌握吗
2026-11-19 13:48:10
在无界面iOS应用中怎么使用OC执行JS脚本
2026-11-19 13:19:20
使用ES6 Class重构JavaScript俄罗斯方块代码结构
2026-11-19 11:50:31
JS数组中使用splice插入字符元素
2026-11-19 11:16:51







