

何时使用indexOf而非正则?JS字符串匹配性能与适用性对比
深入对比 JavaScript 中 indexOf 与正则表达式在字符串匹配中的底层执行机制、性能吞吐、安全边界与适用场景,提供清晰的决策流程与工程重构建议。
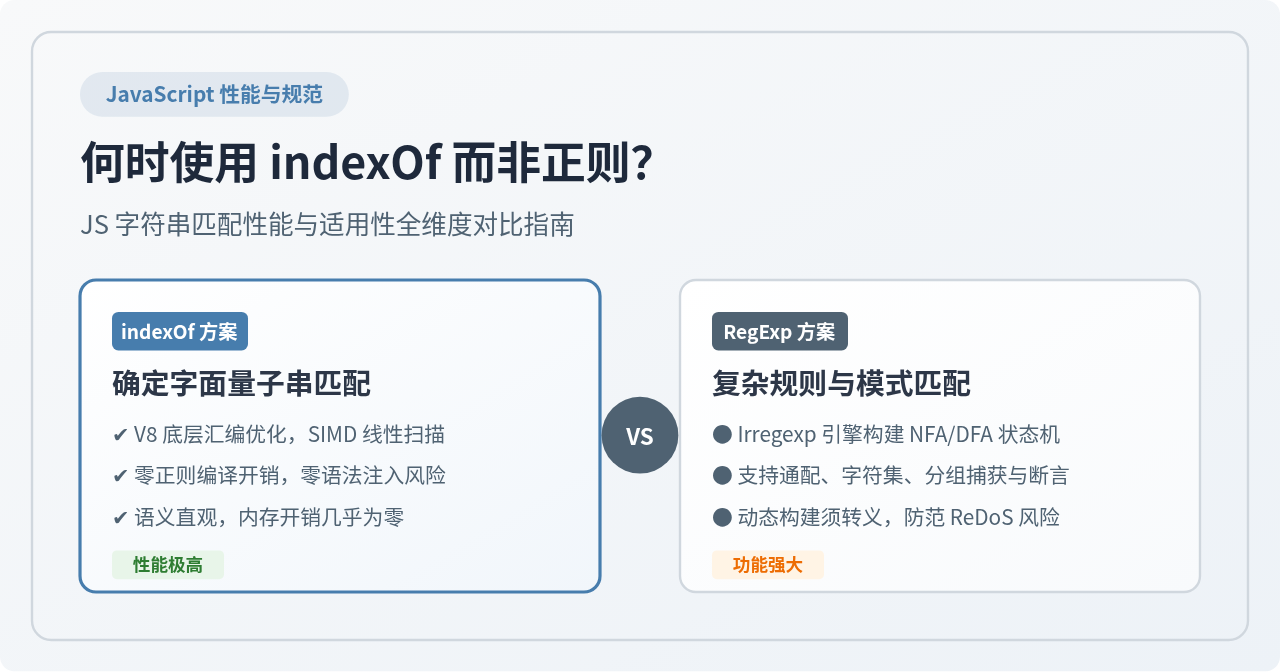
封面概览:String.prototype.indexOf 与 RegExp 的核心能力与定位对比
indexOf(或现代语义化的 includes);只有当需求涉及模式规则、字符集抽象、变长通配、多选分支或结构捕获时,才应当使用正则表达式。在纯字面量匹配场景中,滥用正则不仅会带来 3 至 10 倍的引擎构建与匹配开销,还潜藏着特殊字符未转义导致的运行时语法崩溃与 ReDoS 拒绝服务风险。
一、底层执行原理差异:汇编级扫描 vs 状态机引擎
许多开发者在日常编码中倾向于随手书写正则,例如 /token/.test(str) 或 new RegExp(keyword).test(str),认为现代 V8 等 JavaScript 引擎对一切代码都有高水平优化。然而从底层实现来看,indexOf 与正则引擎在计算模型与资源消耗上有着根本性的鸿沟。
String.prototype.indexOf 在各大现代 JS 引擎(如 Google V8、JavaScriptCore、SpiderMonkey)中属于高度特化的底层纯 C++ / 汇编快速路径。针对短文本,引擎直接使用 SIMD(单指令多数据流)向量化指令并发比对多个字节;针对长文本,则自动采用 Boyer-Moore 或 Two-Way 线性扫描算法。在整个匹配过程中,引擎仅传入字符内存指针与长度,完全无需分配新的堆内存对象,时间复杂度始终稳定在严格的 O(N)。
与此相对,正则表达式(V8 中由 Irregexp 引擎负责)是一个完备的有穷自动机(NFA/DFA)与状态机回溯系统。当执行正则匹配时,引擎必须经历词法解析、字节码生成、捕获组状态栈维护以及多分支回溯。即使模式简单到只有一个单词,引擎仍需构建完整的运行上下文。
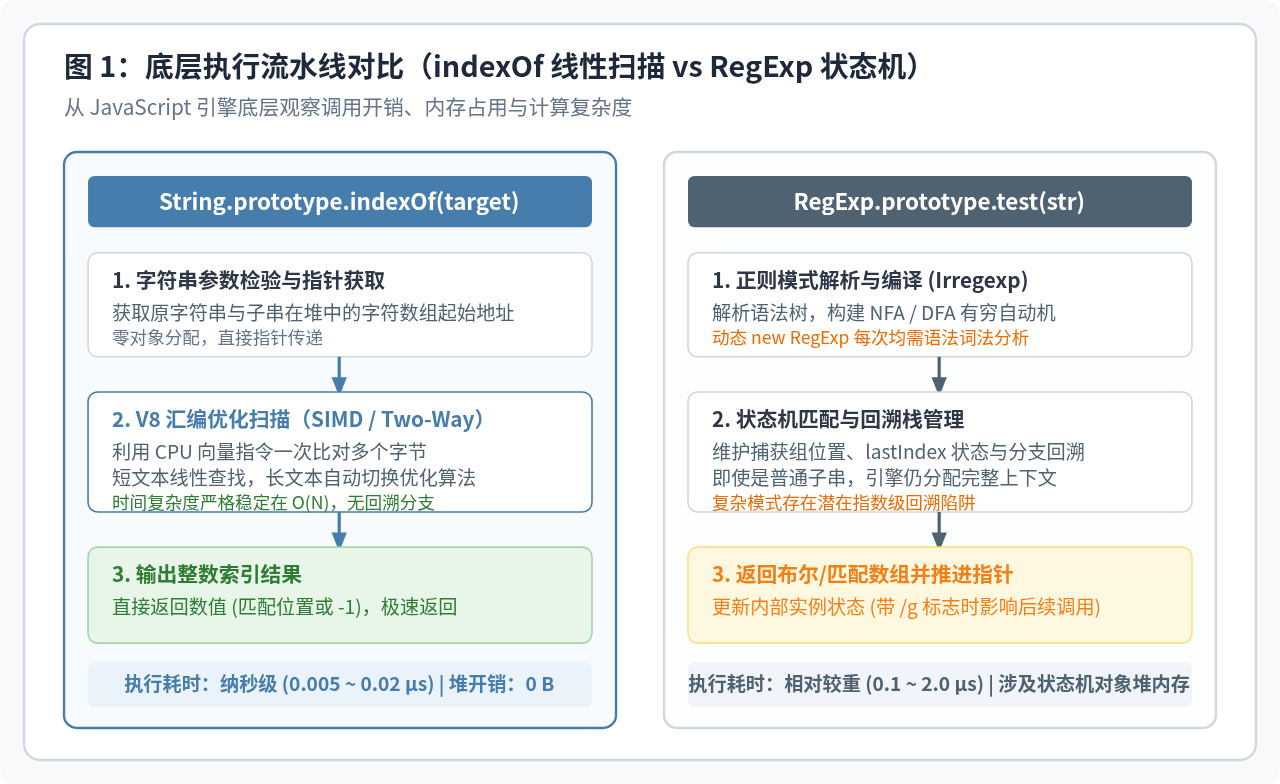
图 1:indexOf 线性快速扫描机制与 RegExp 状态机匹配流水线对比
特别需要注意的是动态正则构建:如果写成 new RegExp(variable).test(target) 并放在循环或频繁触发的高频函数(例如输入框 input 监听、高频表格过滤)中,JavaScript 每次执行都会重新触发正则语法编译与对象实例化,带来可观的 CPU 瞬时毛刺与垃圾回收(GC)停顿。
二、适用性与选型决策:什么时候该用什么?
在实际工程中,选择字符串匹配手段并不是“越高级越好”,而是讲究“手段与需求精确匹配”。我们可以通过以下几个判断分支快速锁定最合适的 API:
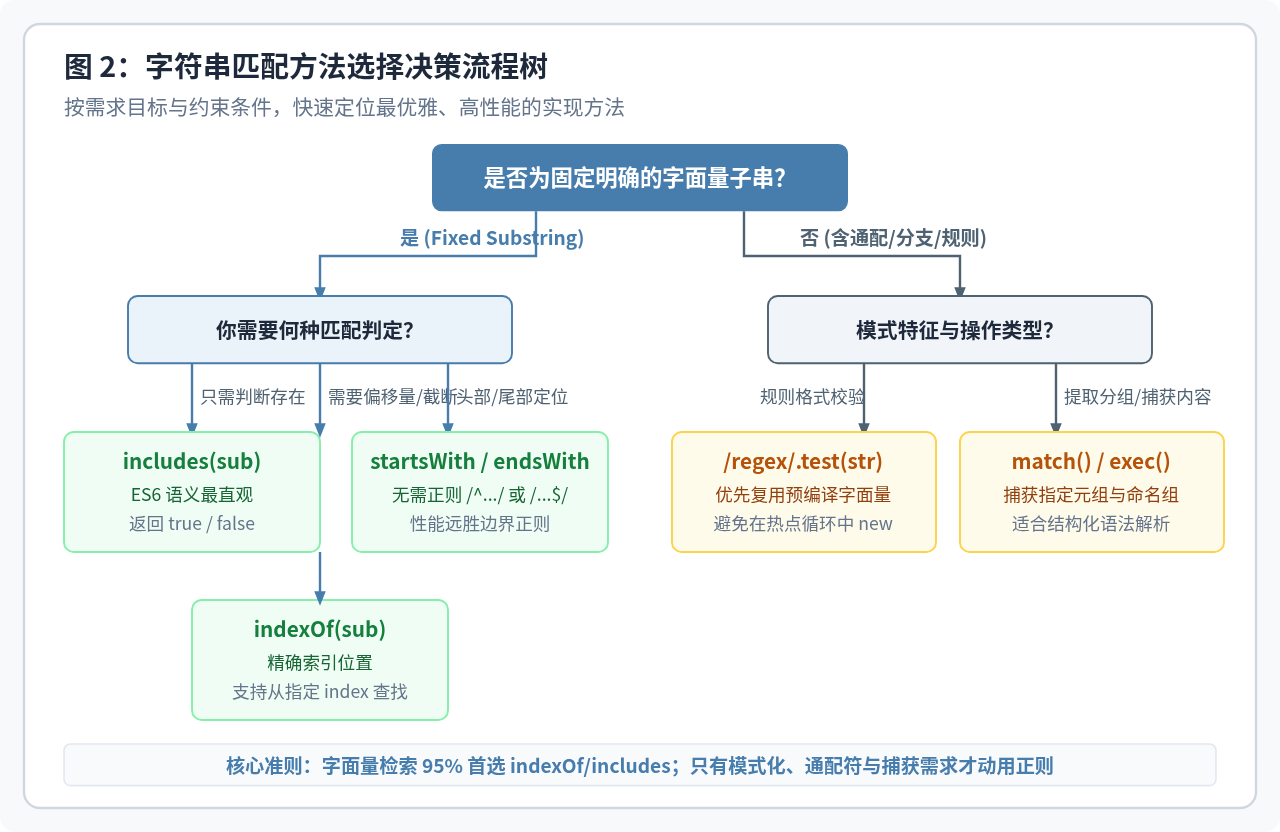
图 2:JavaScript 字符串匹配技术选型决策流程树
1. 仅判断存在性:includes 与 indexOf 优先
如果你只想判断某个固定字面量是否在母串中,代码的首要考量是语义清晰度与执行速度。
// ❌ 冗余且性能较差的做法(创建了正则状态机)
if (/admin/.test(userRole)) { ... }

// ❌ 动态正则且缺乏转义的危险写法
if (new RegExp(targetWord).test(documentText)) { ... }

// ✅ 推荐做法 1:ES6 语义最直观(纯存在性判断)
if (userRole.includes('admin')) { ... }

// ✅ 推荐做法 2:需要兼容旧环境或获取具体偏移量
const position = documentText.indexOf(targetWord);
if (position !== -1) {
  console.log(`子串出现在第 ${position} 位`);
}
2. 边界位置判断:startsWith 与 endsWith 替代 ^ 和 $
许多开发者习惯用 /^https:/.test(url) 或 /\.png$/.test(filename) 来判断前缀与后缀。事实上,ES6 提供的原生方法在直观度和性能上均全面胜出:
// ❌ 产生正则开销
const isHttps = /^https:/.test(url);
const isPng = /\.png$/.test(filename);

// ✅ 原生直接切片指针比对,无需正则引擎接入
const isHttps = url.startsWith('https:');
const isPng = filename.endsWith('.png');
3. 真正必须使用正则表达式的场景
当遇到以下不可替代的需求时,才应当引入正则表达式:
- 模糊与通配规则:匹配任意连续数字
\d+、空白字符\s+或特定字符集[a-zA-Z_]。 - 重复次数与结构限定:如手机号
^1[3-9]\d{9}$、身份证号或 IPv4 地址校验。 - 多选分支匹配:如同时匹配多种协议
/^(https?|ftp|ws):\/\/\/。 - 捕获组提取(Capture Groups):从 URL 或模板字符串中提取特定键值,例如
str.match(/item-(\d+)/)。 - 全局替换并应用动态回调:例如
str.replace(/\{(\w+)\}/g, (_, k) => map[k])。
三、安全性警示:动态输入与 ReDoS 灾难
除了纯粹的纳秒级性能差距,两者在系统健壮性与安全边界上的表现差异往往是线上事故的根源。
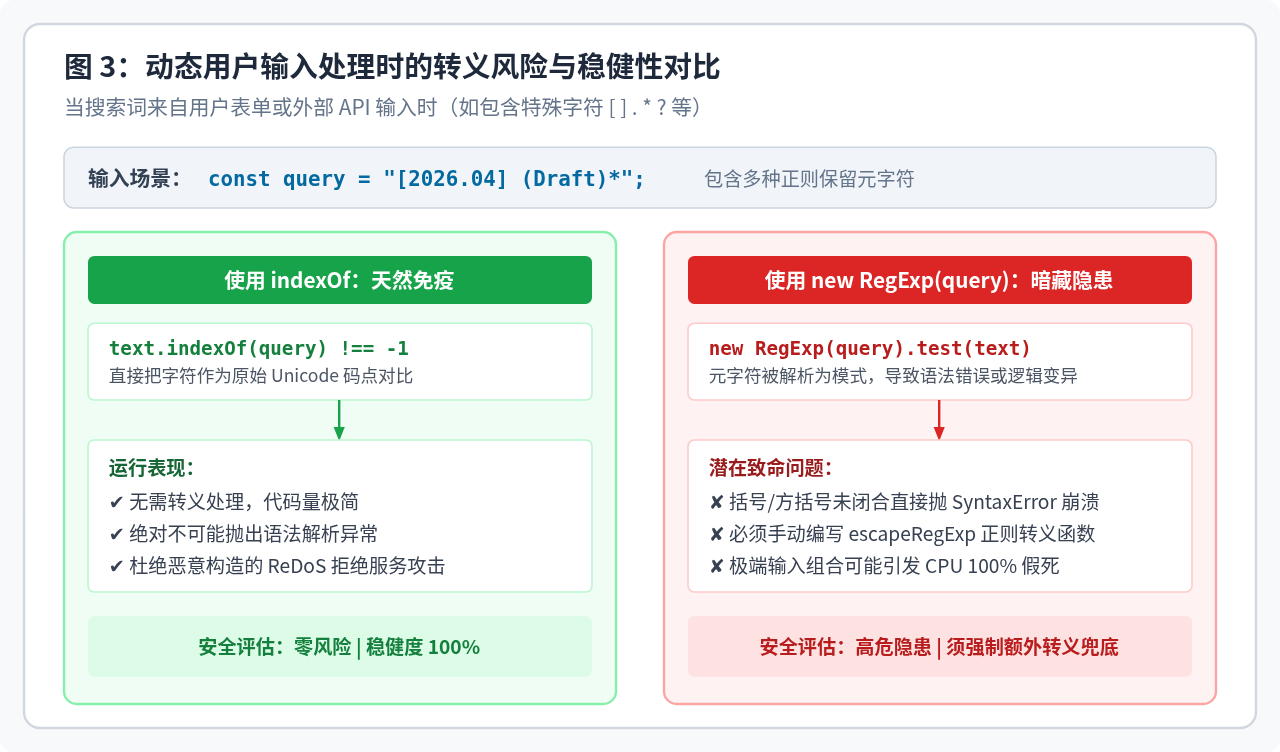
图 3:当搜索输入来自不可控外部源时,indexOf 与 RegExp 的风险表现对比
假设前端有一个实时搜索框,允许用户键入关键字高亮列表项。如果使用 new RegExp(query):
-
直接崩溃风险:若用户输入未闭合的符号(例如输入单独的
[、(或*),new RegExp("[")会立即抛出SyntaxError: Invalid regular expression: Unterminated character class。若无外层try-catch,整个页面脚本直接崩溃白屏。 -
语义被篡改:若用户输入
test.demo,原本意图搜索包含点的字面量,由于.在正则中代表“匹配除换行符外任意字符”,导致test-demo和testXdemo均被意外匹配。 - ReDoS(正则表达式拒绝服务):精心构造的嵌套重复模式输入可能导致 NFA 引擎陷入灾难性回溯(Catastrophic Backtracking),使浏览器主线程或 Node.js 进程 CPU 飙升至 100% 假死。
// 针对必须动态构建正则的安全转义工具函数
function escapeRegExp(string) {
  return string.replace(/[.*+?^${}()|[\]\\]/g, '\\$&');
}

// 安全构建
const safeRegex = new RegExp(escapeRegExp(userInput), 'i');
而对于普通的子串包含检查,直接使用 text.toLowerCase().indexOf(userInput.toLowerCase()) !== -1 可以在零转义成本的前提下,彻底杜绝上述一切语法错误与安全风险。
四、全维度特性与适用性矩阵
为了方便日常代码评审(Code Review)与架构选型,我们将几种主要方法的关键特性整理如下:
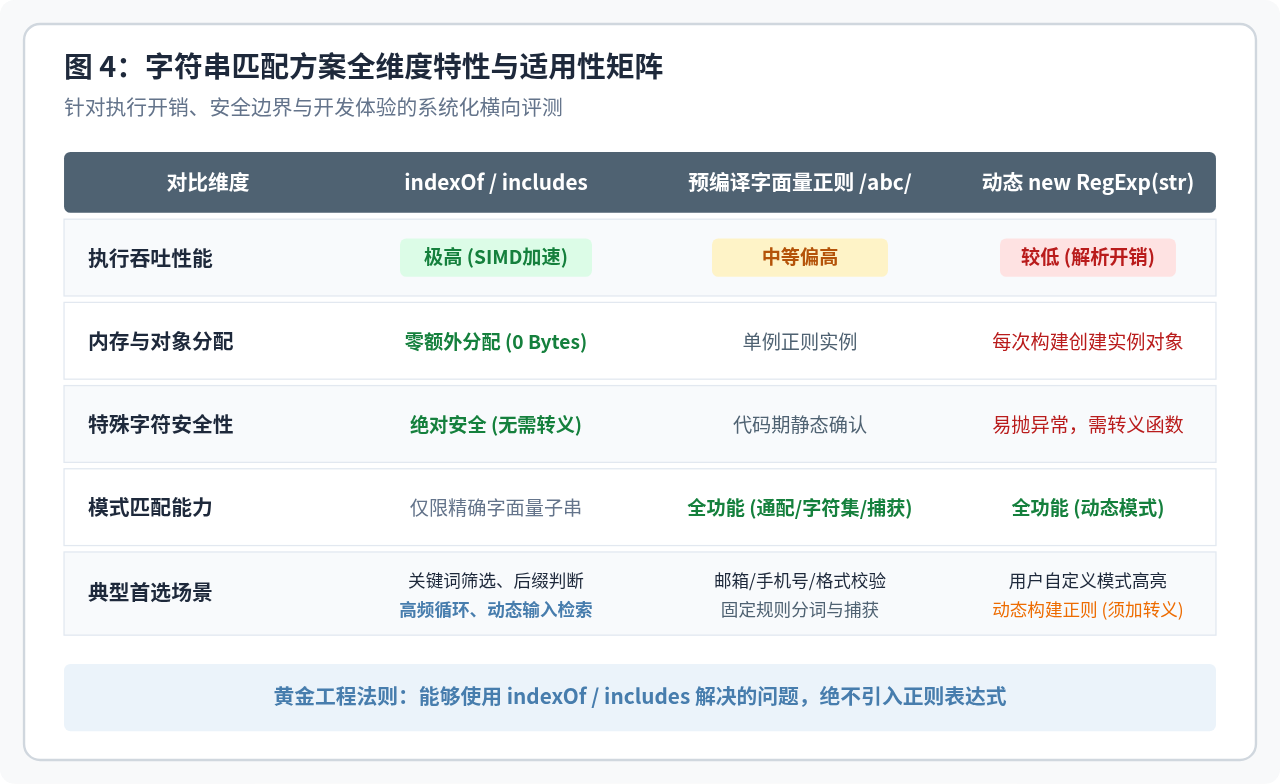
图 4:JavaScript 字符串匹配方案全维度特性与适用性矩阵
| 方案 / 方法 | 典型语法 | 吞吐性能 | 内存分配 | 字符安全 | 最适场景 |
|---|---|---|---|---|---|
| String.indexOf | str.indexOf('abc') |
极高 (~10x) | 0 字节 | 天然安全 | 字面量子串定位、截取、确定偏移量 |
| String.includes | str.includes('abc') |
极高 (~10x) | 0 字节 | 天然安全 | 单纯判断子串存在与否(语义最强) |
| startsWith / endsWith | str.startsWith('http') |
极高 (~10x) | 0 字节 | 天然安全 | 前缀、后缀判定,替代 /^.../ 与 /...$/ |
| 预编译静态正则 | const re = /abc/i; |
中等偏高 | 单例常驻 | 编译期确定 | 固定复杂格式校验(邮箱、手机号等) |
| 动态 new RegExp | new RegExp(sub).test(str) |
较低 | 每次分配对象 | 高危(需转义) | 动态配置的高级模式分词、富文本高亮 |
五、实际代码重构范式
范式 1:重构高频敏感词/扩展名检查
// 🔴 重构前:每次调用都创建临时正则,性能差且容易漏转义
function isImageFile(filename) {
  return /\.(png|jpe?g|gif|webp)$/i.test(filename);
}

// 🟢 重构后:对于简单的单项检查或列表匹配,数组 + endsWith 表现更清晰稳定
const IMAGE_EXTENSIONS = ['.png', '.jpg', '.jpeg', '.gif', '.webp'];

function isImageFileFast(filename) {
  const lower = filename.toLowerCase();
  return IMAGE_EXTENSIONS.some(ext => lower.endsWith(ext));
}
范式 2:避免在循环体内重复实例化正则
// 🔴 重构前:在 10,000 次循环中重复创建正则
function filterLogs(logs, targetKeyword) {
  return logs.filter(log => new RegExp(targetKeyword).test(log));
}

// 🟢 重构后:若仅为字面量匹配,直接使用 includes
function filterLogsFast(logs, targetKeyword) {
  return logs.filter(log => log.includes(targetKeyword));
}
六、总结
在现代 JavaScript 软件工程中,“能够使用 indexOf / includes 解决的问题,绝不引入正则表达式”是一条应当被广泛践行的原则。
这并不是说正则表达式不优秀——在处理抽象模式、复杂语法分词和动态正则捕获时,正则依然是不可替代的利器。然而,面对占日常开发 90% 以上的字面量子串定位、前后缀检查和关键词包含问题,回归 indexOf、includes、startsWith 和 endsWith,不仅能赋予应用汇编级别的极限吞吐表现,更能彻底消除输入转义隐患,交付更加清爽、安全且易于维护的高质量代码。
JS使用Web Crypto API实现AES加解密完整示例
2026-11-19 17:30:40
Web开发中JSP与JavaScript的分工与协作关系
2026-11-19 15:29:43
JavaScript前端安全设计:防御XSS与CSRF攻击的最佳实践
2026-11-18 23:50:09
JS怎么遍历三维数组:三重循环与flat方法对比
2026-11-18 21:23:44
优化HTML页面加载:JS脚本放置位置与加载策略
2026-11-18 21:00:16
相关标签:







