

为什么Web标准推荐JS文件使用UTF-8编码?
深入解析Web标准(WHATWG、RFC 9239与ECMA-262)推荐JavaScript文件统一使用UTF-8编码的核心原因,从底层字节特征、浏览器解析机制、ASCII兼容性到全链路工程配置实践与避坑指南。
假设你在维护一个多语言前端工程,在代码中添加了一条提示文案:const tip = "操作成功!欢迎使用 ✨";。在本地开发环境测试一切正常,但代码合并上线后,部分用户界面的提示框中却弹出了类似 鎿嶄綔鎴愬姛锛佹杩庝娇鐢 的乱码,甚至某些旧版移动端直接报错 Uncaught SyntaxError: Invalid or unexpected token 导致页面白屏。排查后发现,问题并非业务逻辑有误,而是该 JS 文件在创建时被本地编辑器以操作系统默认的 ANSI/GBK 格式保存,而生产环境又未显式下发编码标头,导致现代浏览器直接采用标准默认的 UTF-8 方式进行反解。
现代 Web 标准(包括 WHATWG HTML 规范、RFC 9239 以及 ECMA-262 规范)明确推荐并确立将 UTF-8 作为 JavaScript 文件的基线字符编码。本文将从规范演进、浏览器解码决策、底层字节机制及全链路工程实践四个维度,讲透这一推荐背后的技术原因与落地步骤。
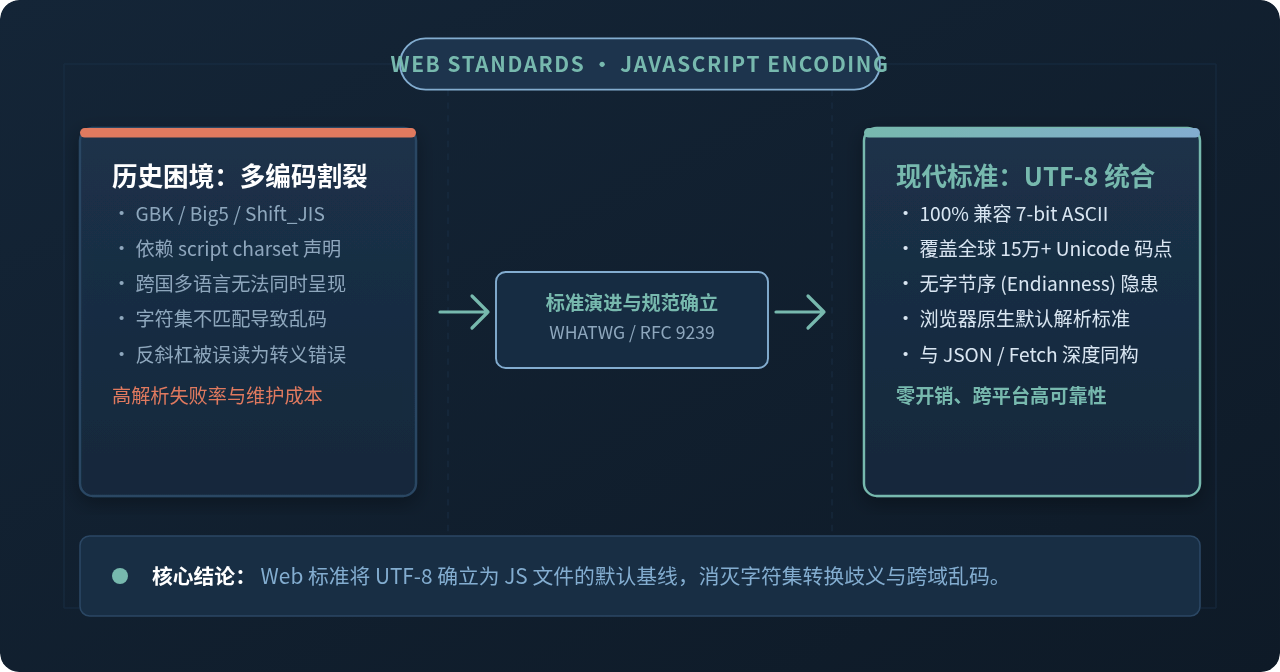
一、Web 标准对 JavaScript 编码的演进与明确规定
在早期的 Web 开发中,不同语言区域存在各自专属的编码方案,例如中文常用的 GB2312、GBK、Big5,日文的 Shift_JIS,以及西欧语言的 ISO-8859-1。这种地域割裂导致跨语言资源共享极易产生解码错误。随着 Web 技术的成熟,国际标准组织通过多项核心规范完成了编码标准的收敛:
- RFC 9239(替代 RFC 4329)更新 MIME 类型规范:该规范正式将
text/javascript确立为 JavaScript 唯一的标准 MIME 类型(淘汰了历史上的application/javascript与application/x-javascript),并明确指出在网络交换中,JavaScript 文本应当使用 UTF-8 编码进行传输。 - WHATWG HTML 规范对脚本编码的默认规约:现代 HTML 规范明确规定,当浏览器获取外部
<script>脚本资源时,若没有检测到 Byte Order Mark(BOM)且 HTTP 响应头未提供字符集声明,浏览器必须默认采用 UTF-8 编码进行解码,而不再像过往那样回退并继承宿主 HTML 页面的编码。 - 废弃
<script charset="...">属性:在 HTML5 标准中,<script>标签上的charset属性已被正式标记为过时废弃(Obsolete)。W3C 与 WHATWG 建议开发者直接确保脚本本身及其传输链路符合 UTF-8 规范,而不是依赖 HTML 标签上的局部修补。
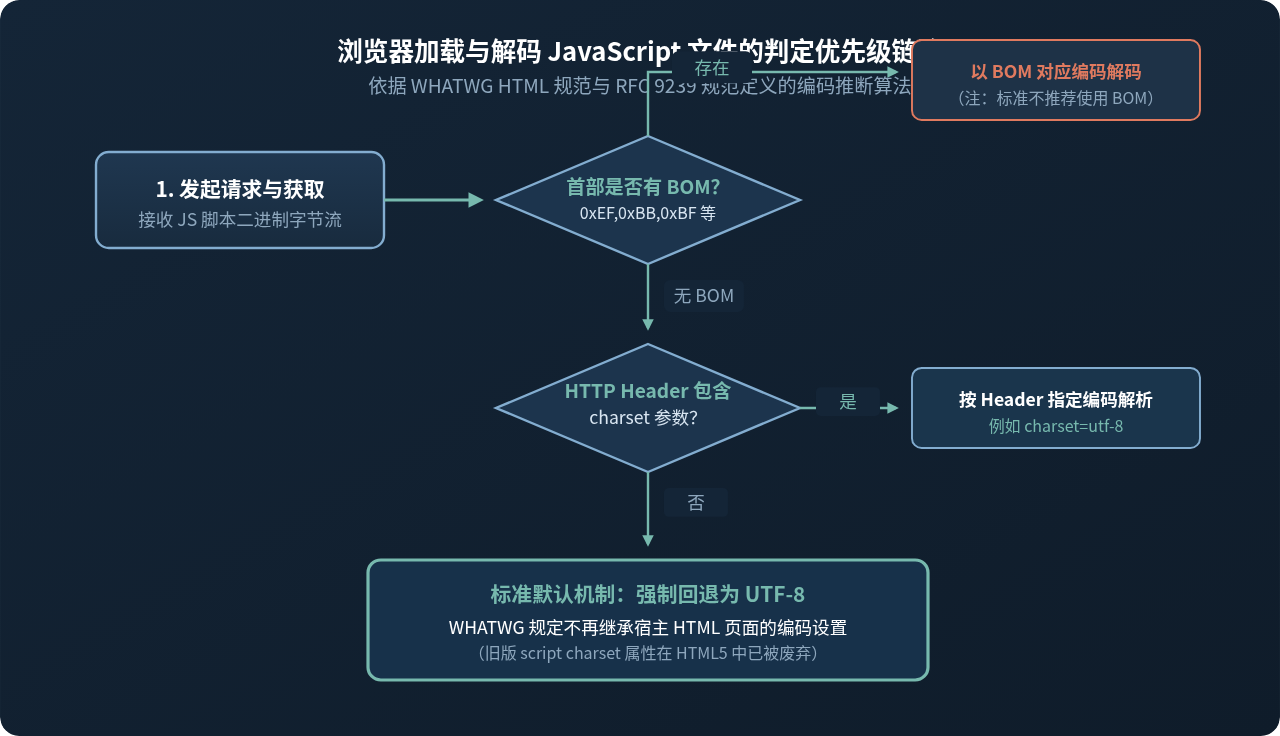
二、浏览器解析 JavaScript 脚本的编码推断机制
当浏览器在 DOM 树构建过程中遇到 <script src="app.js"></script> 时,必须先将从网络接收到的原始二进制字节序列解码为字符序列,才能将其送入 JavaScript 引擎构建抽象语法树(AST)。浏览器推断编码的严格优先级链路如下:
- BOM(字节顺序标记)检测:浏览器首先检查文件前几个字节。如果存在有效的 UTF-8 BOM(
0xEF, 0xBB, 0xBF)或 UTF-16 BOM,则依据 BOM 确定编码。然而,Web 标准和 ECMAScript 均不建议在 UTF-8 文本中使用 BOM。 - HTTP 响应头中的字符集参数:若无 BOM,浏览器将解析 HTTP 响应头
Content-Type。如果包含charset=utf-8,浏览器将严格按照该参数指示的字符集进行解码。 - 规范强制默认回退:若 HTTP 标头中未指定
charset,现代符合规范的浏览器将无条件回退为 UTF-8 编码进行解析。
三、为什么是 UTF-8?底层设计的四大技术优势
Web 标准之所以全盘推荐并确立 UTF-8,并非偶然的妥协,而是由其优异的底层二进制设计与现代计算机网络协议的特性所决定的。
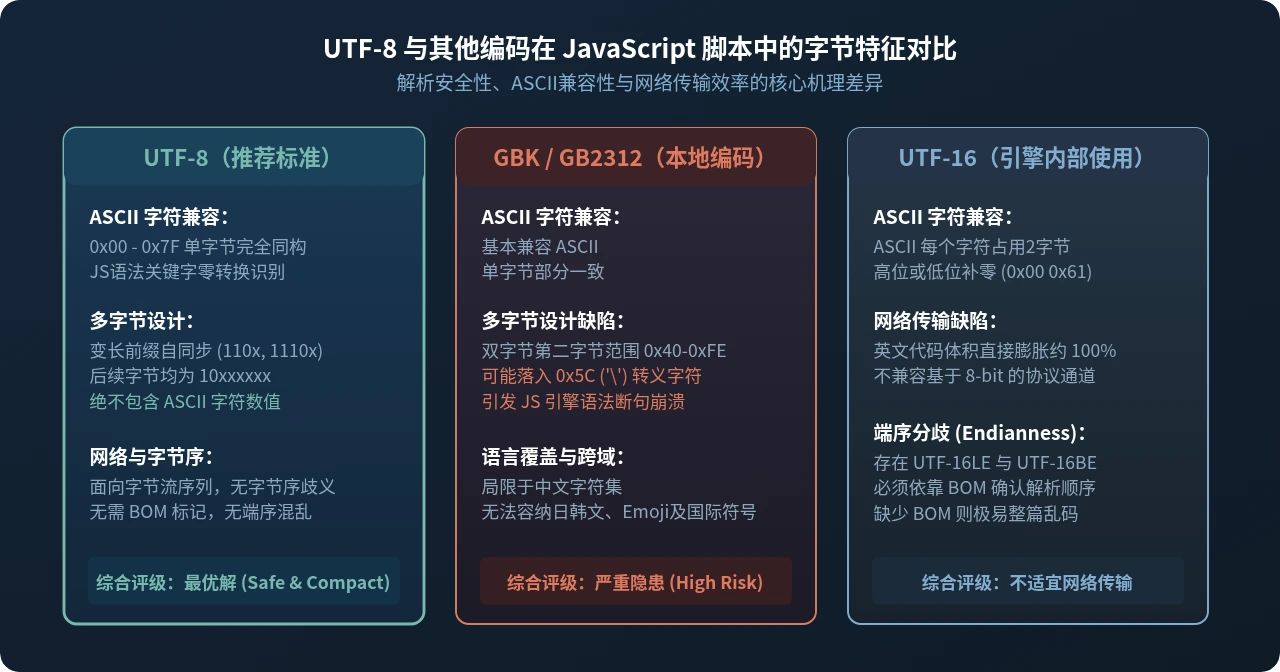
1. 完美向下兼容 7-bit ASCII,语法解析零损耗
JavaScript 语法的所有核心保留字(如 function、class、const、return、if 等)、操作符(+、-、=、&)以及基础标点符号均落在 ASCII 字符范围(0x00 至 0x7F)内。UTF-8 采用单字节对 ASCII 进行一对一直接编码,其字节值与 ASCII 码完全一致。
这意味着 JavaScript 引擎的词法分析器(Lexer)在扫描代码结构时,无需进行任何复杂的编码转换或查表操作,即可直接复用高效的单字节处理管线,这为现代 V8、JavaScriptCore 等高性能引擎的代码预解析与即时编译(JIT)奠定了速度基石。
2. 自同步变长前缀机制,杜绝“反斜杠转义”语法断裂
传统多字节字符集(如 GBK、GB2312)采用双字节编码汉字,其第二字节的取值范围为 0x40 - 0xFE。这一范围与 ASCII 中的部分控制字符和符号产生了重叠。最典型的灾难就是 ASCII 字符 0x5C,它对应反斜杠符号 \。
在 GBK 编码下,如果某个汉字的第二个字节恰好是 0x5C,一旦传输截断或被部分 ASCII 优先扫描器处理,JavaScript 解析器就会误将该字节识别为转义符,从而将后续的单引号、双引号或回车符连带转义,引发致命的语法错误:
// 假设文件以 GBK 编码保存,汉字 "構" 的 GBK 编码十六进制为:B9 5C
// 当 JS 引擎扫描字符串字面量时:
var str = "構";
// 引擎误将第二字节 0x5C 识别为转义符 \,把后面的闭合双引号 " 转义成了普通字符 \"
// 导致字符串无法闭合,直接抛出异常:
// Uncaught SyntaxError: Invalid or unexpected token
而在 UTF-8 中,所有多字节字符的后续字节均被严格约束在 10xxxxxx(0x80 至 0xBF)区间内,没有任何多字节字符的组成字节会落入 ASCII 范围(0x00 至 0x7F)。这种严格的单向互斥机制,从底层数学逻辑上彻底杜绝了代码误断句与转义符混淆问题。
3. 无字节序(Endianness)困扰,天生契合网络数据流
UTF-16 和 UTF-32 均以多字节字(16 位或 32 位)作为基本编码单元,这导致它们必然面临计算机硬件底层的大端序(Big-Endian)与小端序(Little-Endian)选择分歧。如果在传输中没有携带明确的 BOM,或者网络边界节点交换顺序出错,整篇文档就会彻底沦为乱码。
UTF-8 则是一种纯粹以单字节为序列单元的编码方案,各个字节在网络流中的传输先后顺序完全确定,根本不存在字节序概念。无论服务端服务器架构是 x86(小端)还是 ARM/MIPS,输出的字节序列都保持一致,极为适应分布式无状态的网络传输。
4. 与现代 Web 技术栈全面同构
现代前端开发高度依赖周边标准与 API:
- JSON 规范(RFC 8259):明确规定在网络交换中,JSON 文本必须使用 UTF-8 编码,不再允许使用 UTF-16 或 UTF-32。
- Fetch API 与 TextDecoder:浏览器原生的
TextDecoder构造函数在不传参时,默认解码字符集即是utf-8。 - WebAssembly 文本段与字符串交换:Wasm 规范中的字符串导出和导入接口原生绑定 UTF-8 字节偏移。
四、工程落地:全链路确保 UTF-8 编码的操作步骤
为了保证团队协作与生产环境中所有 JavaScript 文件的编码合规,应当在编辑器、构建工具、Web 服务器以及持续集成四个关口建立统一配置。
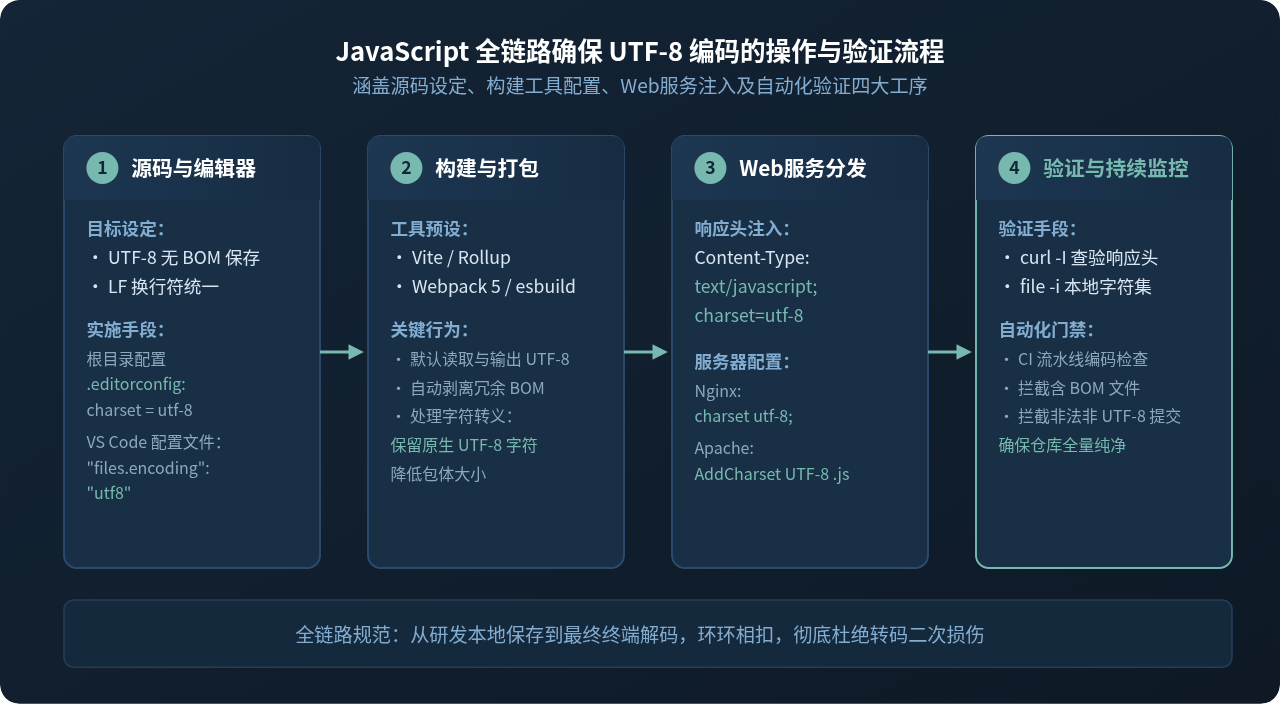
步骤一:项目根目录配置 .editorconfig 统一编辑器行为
在工程根目录建立 .editorconfig 文件,显式约束所有源码文件的字符集与换行规则,主流 IDE(VS Code、WebStorm、Sublime Text)均会自动识别:
# .editorconfig
root = true

[*]
charset = utf-8
end_of_line = lf
insert_final_newline = true
trim_trailing_whitespace = true

[*.{js,jsx,ts,tsx,mjs,cjs,json}]
charset = utf-8
步骤二:构建工具输出与字符逃逸处理
现代打包工具(Vite、Webpack 5、Rollup、esbuild)默认均以 UTF-8 读写源文件。但需要注意压缩工具的字符逃逸配置。以 Terser 为例,默认情况下可以直接输出原生 UTF-8 中文字符,以节省包体体积并保持源码可读性:
// terser / vite 生产构建选项配置示例
// vite.config.js
import { defineConfig } from 'vite';

export default defineConfig({
  build: {
    minify: 'terser',
    terserOptions: {
      format: {
        ascii_only: false, // 保持原生 UTF-8 字符输出,避免转化为 \uXXXX 增大体积
        comments: false
      }
    }
  }
});
步骤三:Web 服务器与 CDN 显式注入字符集响应头
即使文件本身已正确保存为 UTF-8,如果 Web 服务器配置缺失,依然可能触发部分旧设备代理或安全中间件的歧义处理。应当在 Nginx 或 Apache 中显式声明 MIME 与编码:
# Nginx 配置文件 (nginx.conf / vhost.conf)
http {
    include       mime.types;
    default_type  application/octet-stream;

    # 显式全局指定字符集为 UTF-8
    charset utf-8;

    server {
        listen 80;
        server_name example.com;

        location ~* \.(js|mjs)$ {
            # 确保返回 Content-Type: text/javascript; charset=utf-8
            add_header Content-Type "text/javascript; charset=utf-8";
            expires 30d;
        }
    }
}
步骤四:本地与 CI 流水线编码自动化校验
可以通过 Linux 原生命令或 Node.js 脚本在持续集成(CI)环节中加入编码门禁,拦截非 UTF-8 或包含 BOM 的非规范提交:
# 1. 使用 Linux file 命令检查指定 JS 文件的编码
file -i src/main.js
# 期望输出示例:
# src/main.js: text/javascript; charset=utf-8

# 2. 使用 curl 校验线上部署后的服务器标头
curl -I https://example.com/assets/app.js
# 期望检查响应标头:
# Content-Type: text/javascript; charset=utf-8
五、常见开发误区与高频踩坑点
Windows 记事本等历史编辑器在保存 UTF-8 文本时,常会在文件起始位置强制插入 3 个字节的 BOM 头(
0xEF, 0xBB, 0xBF)。这会导致严重隐患:
- Node.js CLI 执行带
#!/usr/bin/env node的可执行脚本时,BOM 会阻断 Shebang 声明解析,直接抛出语法错误。 - 部分旧版本打包器或工具链直接将包含 BOM 的多个文件简单串联合并(Concatenate),导致合成后的中间代码插入了非法不可见字符,从而在运行时报 SyntaxError。
- 解决准则:统一要求使用 UTF-8 without BOM(无签名 UTF-8)格式保存所有代码文件。
2. JavaScript 运行时的 UTF-16 与 Unicode 码点操作
需要厘清的一个核心概念是:文件的存储与传输编码为 UTF-8,但 JavaScript 引擎内部的字符串内存表示依据 ECMAScript 规范采用的是 UTF-16 代码单元(Code Units)。
对于超出基本多语言平面(BMP,即码点大于 0xFFFF)的字符(例如大多数 Emoji ✨、复杂数学符号或部分生僻字),在 JS 内部会拆分成两个 16 位的代理对(Surrogate Pair):
const text = "✨"; // Emoji 或特殊符号
// 使用传统的 .length 属性与 charCodeAt 会得到代理对长度
console.log(text.length); // 可能是 1 或 2,取决于字符是否在 BMP 内部

// 正确的多语言与 Unicode 遍历姿势:使用 ES6 展开运算符或 for...of
const realLength = [...text].length;

// 正则表达式务必添加 'u' (Unicode) 标志位以确保正确识别码点:
const regex = /^\p{Emoji}$/u;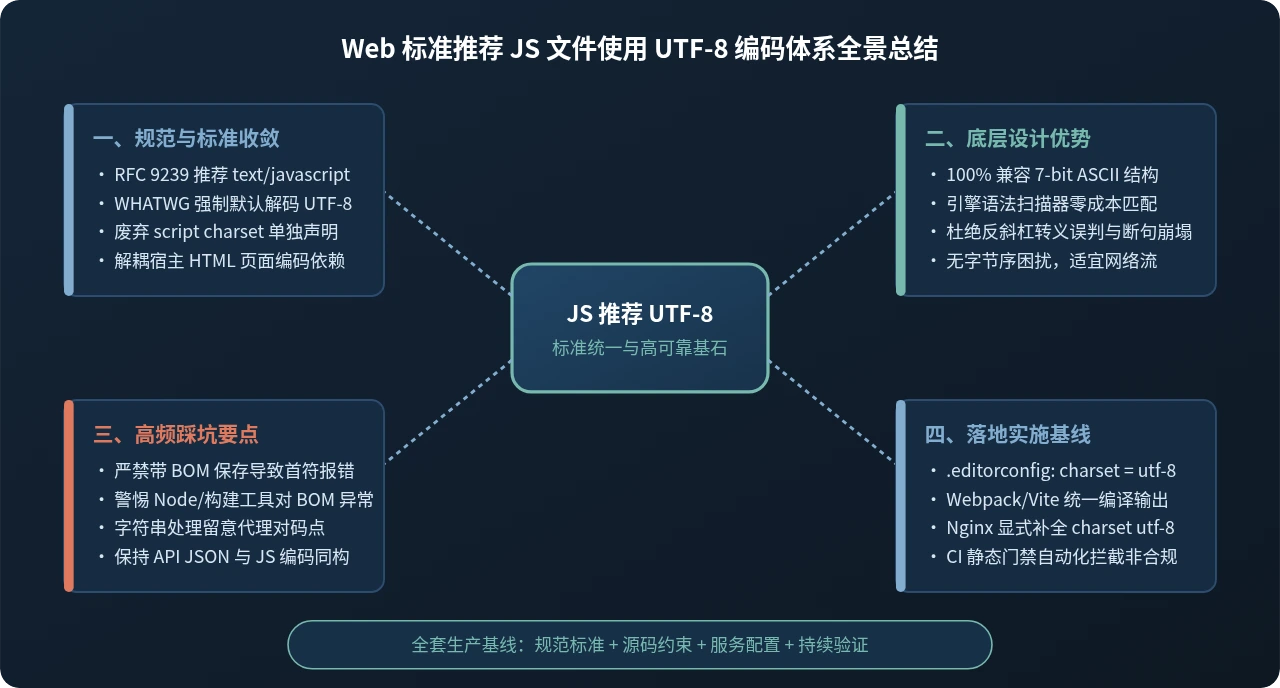
六、实践总结与基线检查清单
Web 标准之所以将 UTF-8 确定为 JavaScript 文件的唯一推荐基线,是基于语法解析性能、跨语言互通性、网络传输可靠性以及历史兼容性做出的最优技术选择。在现代工程实践中,保持全链路 UTF-8 无 BOM 已成为不可妥协的基础工程质量标准。
| 检查维度 | 标准要求 | 达标验证方法 |
|---|---|---|
| 源码编码格式 | 严格 UTF-8 Without BOM,LF 换行符 | 根目录 .editorconfig 约束,编辑器底栏显示 UTF-8 |
| HTML 引入语法 | 无 charset 属性,直接 <script src="..."> |
符合现代 HTML5 语法校验要求 |
| HTTP 响应标头 | Content-Type: text/javascript; charset=utf-8 |
curl -I 或开发者工具 Network 栏响应头验证 |
| 构建与数据交换 | JSON 接口及 Web 资产统一纯净 UTF-8 | API 数据交互无转码双重编解码损耗 |
Webpack与Vite构建中怎么自动化处理JS兼容性
2026-11-19 15:37:19
JS项目配置文件格式对比:JSON、JS模块与.env怎么选
2026-11-18 18:07:51
Google Forms 新增 Gemini 数据分析:识别跨题关联并生成改进建议
2026-11-10 14:40:39
JavaScript项目常见配置文件详解:package.json、tsconfig与构建配置
2026-11-04 21:34:42
React 项目集成 Mock.js 的最佳实践与配置详解
2026-11-03 22:33:26







