

JavaScript字符串去除空格与大小写转换实战
深入讲解JavaScript字符串去除空格与大小写转换的核心方法与实战技巧。涵盖trim家族、正则表达式深度清洗、Unicode与本地化大小写转换特例,以及生产级字符串规范化管道构建。
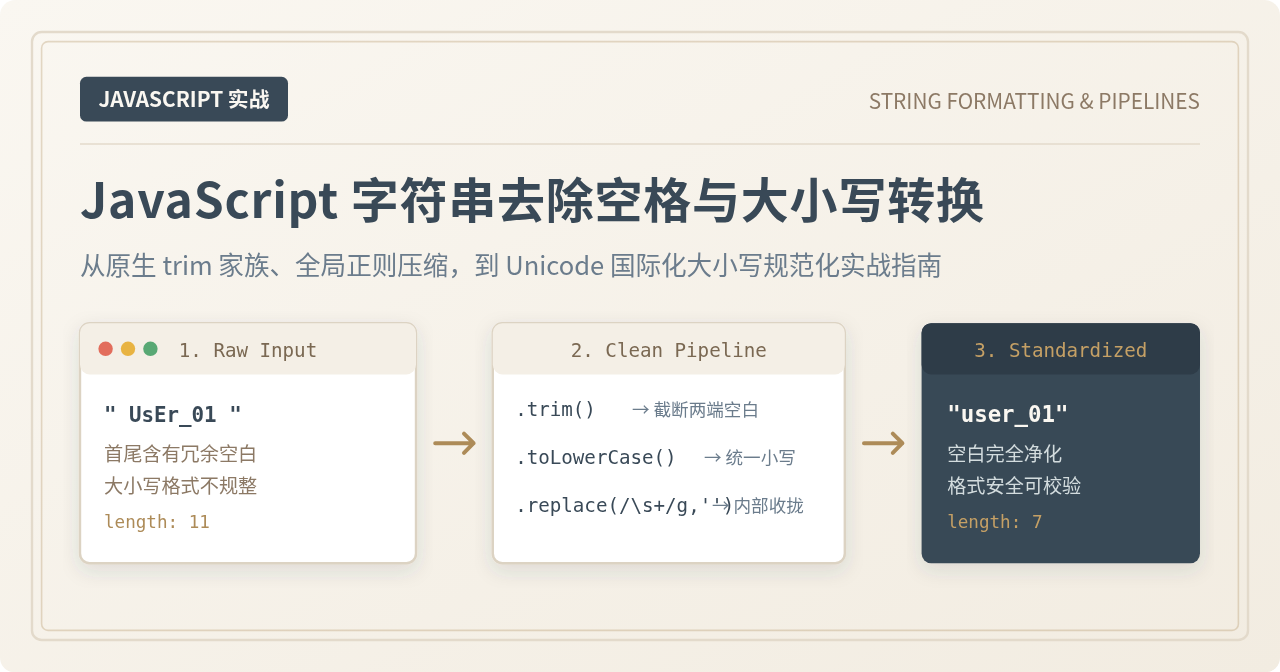
在 Web 前端与 Node.js 应用程序中,用户输入收集、URL 参数解析与数据清洗是最基础也是最频繁的工作环节。由于 JavaScript 中的字符串属于基本类型且具备不可变(Immutable)特性,所有针对字符串的修剪与转换操作均返回一个全新的字符串对象,原值始终保持不变。本文针对字符串去除空格(两端修剪、深度剔除、多余空格压缩)与大小写规范化转换(标准转换、Title Case、国际化特殊语言映射),提供直接可落地的方法、边界条件与实战管道实现。
一、去除首尾空格:原生 trim 家族方法
在表单数据录入(例如用户名、邮箱、验证码)场景中,用户常因复制粘贴而无意中带入开头或末尾的空白。ES5 引入的 trim() 及后续 ES2019 标准化的 trimStart()、trimEnd() 是解决这类问题的最直接工具。
1. String.prototype.trim() 的匹配范围
trim() 会移除字符串开头和末尾的所有空白符,包括半角空格、制表符( )、换行符(
、 )以及 Unicode 空白字符(如不间断空格 对应的 、全角空格 )。需要注意的是,它绝不会触碰字符串内部夹杂的空格。
const rawInput = "  	  alex@example.com
 ";
const cleaned = rawInput.trim();

console.log(cleaned); // 示例输出: "alex@example.com"
console.log(rawInput.length); // 示例输出: 25
console.log(cleaned.length);  // 示例输出: 16
2. 单向修剪:trimStart() 与 trimEnd()
当特定业务要求仅清理前置缩进(如解析代码行前置空格)或仅清理行末尾随空格时,可以使用定向修剪方法。在早期的浏览器实现中它们被称为 trimLeft() 和 trimRight(),但 ECMAScript 规范已将 trimStart() / trimEnd() 定为主方法以与 padStart() / padEnd() 保持一致命名。
const query = "   SELECT * FROM users   ";

console.log(query.trimStart()); // 示例输出: "SELECT * FROM users   "
console.log(query.trimEnd());   // 示例输出: "   SELECT * FROM users"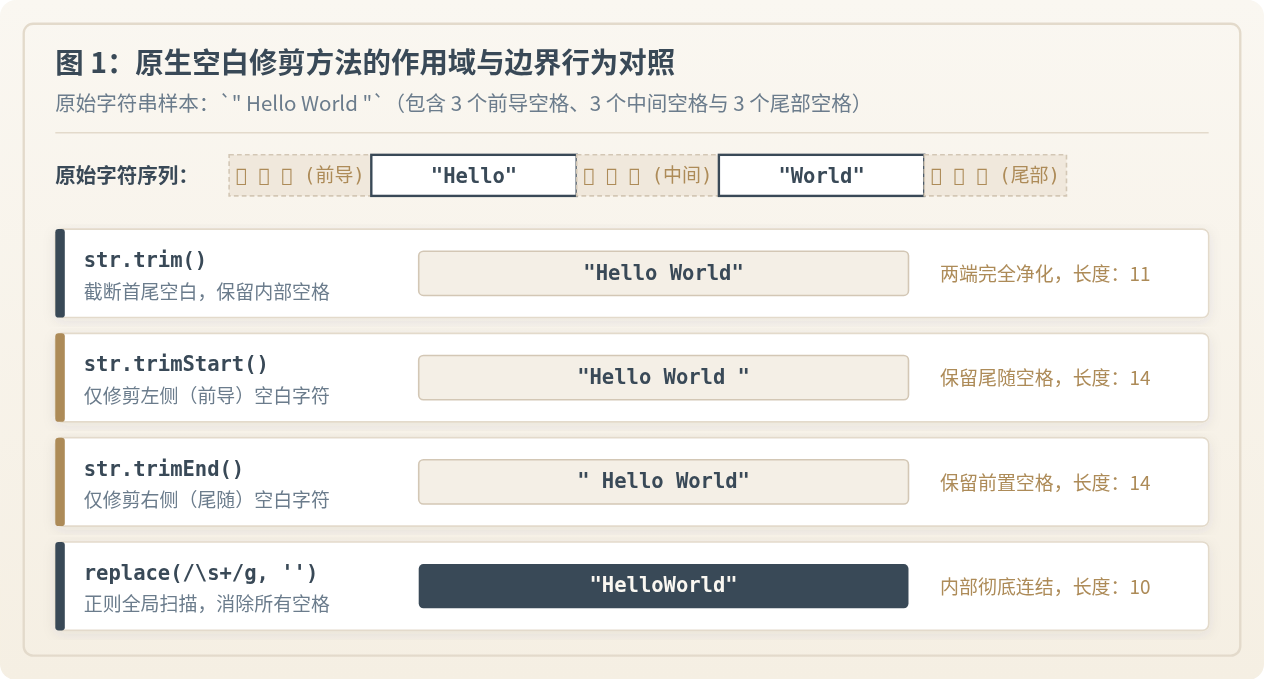
二、深度去除:全局剔除与中间连续空白压缩
原生 trim 只能作用于首尾两侧。如果业务场景需要彻底消除内部空格(例如手机号、身份证号、银行卡号清洗),或者需要将多重连续空格折叠为单一标准空格(例如搜索关键词规范化),则需要借助正则表达式配合 replace 或 replaceAll。
1. 全量剔除所有空白字符
使用正则表达式元字符 \s(匹配任何空白字符,包含空格、制表符、换页符等)并配合全局修饰符 g,能够将字符串中分散在各处的所有空格完全剔除。
const phoneNumber = " 138  0013   8000 ";
// 使用正则全局替换
const pureNumber = phoneNumber.replace(/\s+/g, '');

console.log(pureNumber); // 示例输出: "13800138000"
console.log(pureNumber.length); // 示例输出: 11
2. 将内部连续空格压缩折叠为单个空格
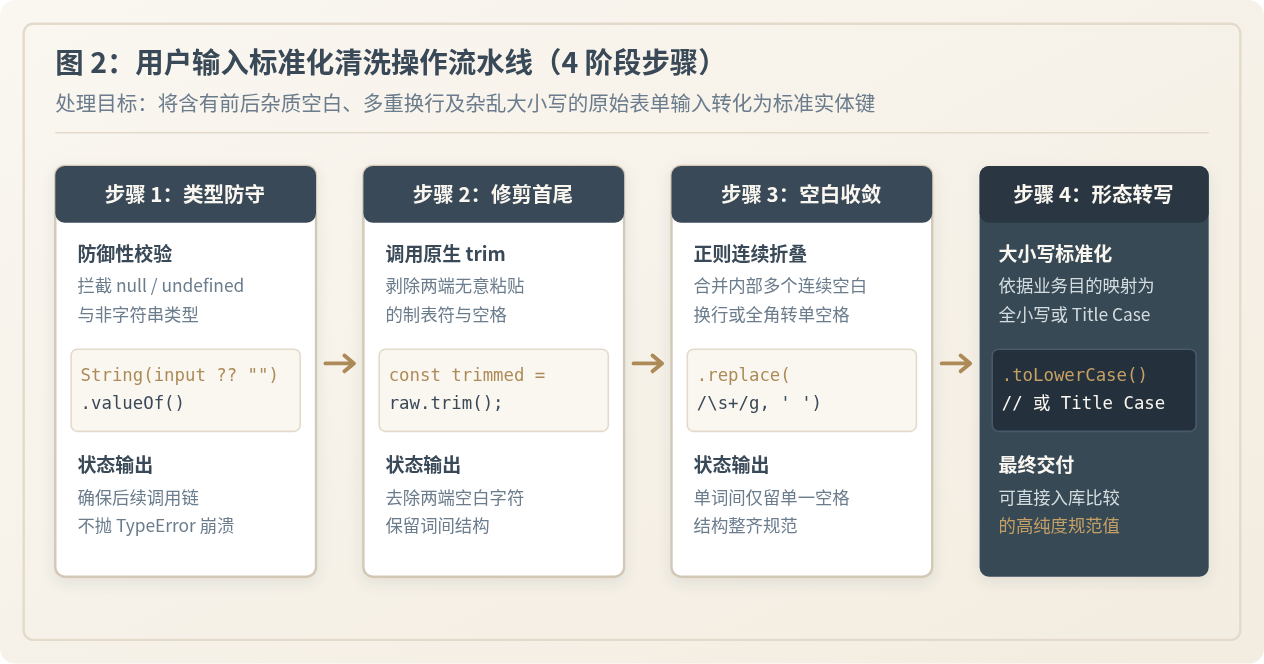
在处理多行文本、用户输入的搜索语句或多单词组合时,用户可能不慎连续敲击多次空格或掺杂换行符。此时若直接剔除所有空格会导致词与词粘连,因此推荐“先首尾修剪、再将中间连续空白合并为一个半角空格”的组合策略。
const searchPrompt = "   JavaScript   string    formatting   pipeline   ";

// 规范化中间空格:合并连续空白为一个标准空格
const normalizedPrompt = searchPrompt.trim().replace(/\s+/g, ' ');

console.log(normalizedPrompt); // 示例输出: "JavaScript string formatting pipeline"
在部分开源代码中会见到利用数组分割来压制空格的写法:str.split(' ').filter(Boolean).join(' ')。虽然该方法在逻辑上直观,但其内部会生成临时数组、遍历过滤并重新拼接,在处理中大型字符串时产生额外的内存分配和垃圾回收开销。在性能敏感路径中,优先采用 replace(/\s+/g, ' ')。
三、大小写转换:常规处理与国际化陷阱
大小写转换是实现字符串无视大小写比对、账号归一化及排版美化的关键操作。JavaScript 提供了基础转换与本地化感知两组 API。
1. 通用大小写转换方法
基础转换方法为 toLowerCase() 和 toUpperCase()。它们按照 Unicode 标准字符映射转换英文字母:
const brand = "GitHub Desktop";

console.log(brand.toLowerCase()); // 示例输出: "github desktop"
console.log(brand.toUpperCase()); // 示例输出: "GITHUB DESKTOP"
2. 忽略大小写比对的最佳实践
在做用户鉴权或字符串匹配时,切忌直接使用 strA.toUpperCase() === strB.toUpperCase() 硬比对。由于转换过程涉及新字符串对象的分配,在密集判断场景下建议使用原生 Intl.Collator 或 localeCompare:
const tagA = "VueJS";
const tagB = "vuejs";

// 方式一:快速全量小写比对(适用于常规 ASCII / 英文场景)
const isEqualByLower = tagA.toLowerCase() === tagB.toLowerCase();

// 方式二:更具语义且零临时字符串分配的国际化比对
const isEqualByCompare = tagA.localeCompare(tagB, undefined, { sensitivity: 'accent' }) === 0;

console.log(isEqualByLower);   // 示例输出: true
console.log(isEqualByCompare); // 示例输出: true
3. 国际化与本地化转换特例(Locale Trap)
在涉及非纯 ASCII 的多语言业务中,toLocaleLowerCase() 与 toLocaleUpperCase() 可以接收地区语言标识(BCP 47 语言标记)。在特定语系中,常规大小写映射会导致严重的数据失真:
-
土耳其语(tr)与阿塞拜疆语(az):拉丁字母 "I" 与 "i" 在土耳其语中有两个独立的对立字母——带点的
i / İ与无点的ı / I。如果直接对土耳其语环境下的"I"执行toLowerCase(),会得到英文字母"i";而符合当地语法的转换应为无点小写"ı"。 -
德语小写字母 ß(Eszett):当执行
"ß".toUpperCase()时,输出结果为双字符"SS"。这意味着大小写转换后的字符串长度可能会变长,切勿在业务中假定str.toUpperCase().length === str.length。
// 1. 土耳其语特殊处理
const turkishI = "I";
console.log(turkishI.toLowerCase()); // 示例输出: "i" (通用Unicode转换)
console.log(turkishI.toLocaleLowerCase('tr')); // 示例输出: "ı" (符合土耳其语法的无点i)

// 2. 德语长度变化特例
const germanWord = "straße";
const upperGerman = germanWord.toUpperCase();
console.log(upperGerman); // 示例输出: "STRASSE"
console.log(germanWord.length); // 示例输出: 6
console.log(upperGerman.length); // 示例输出: 7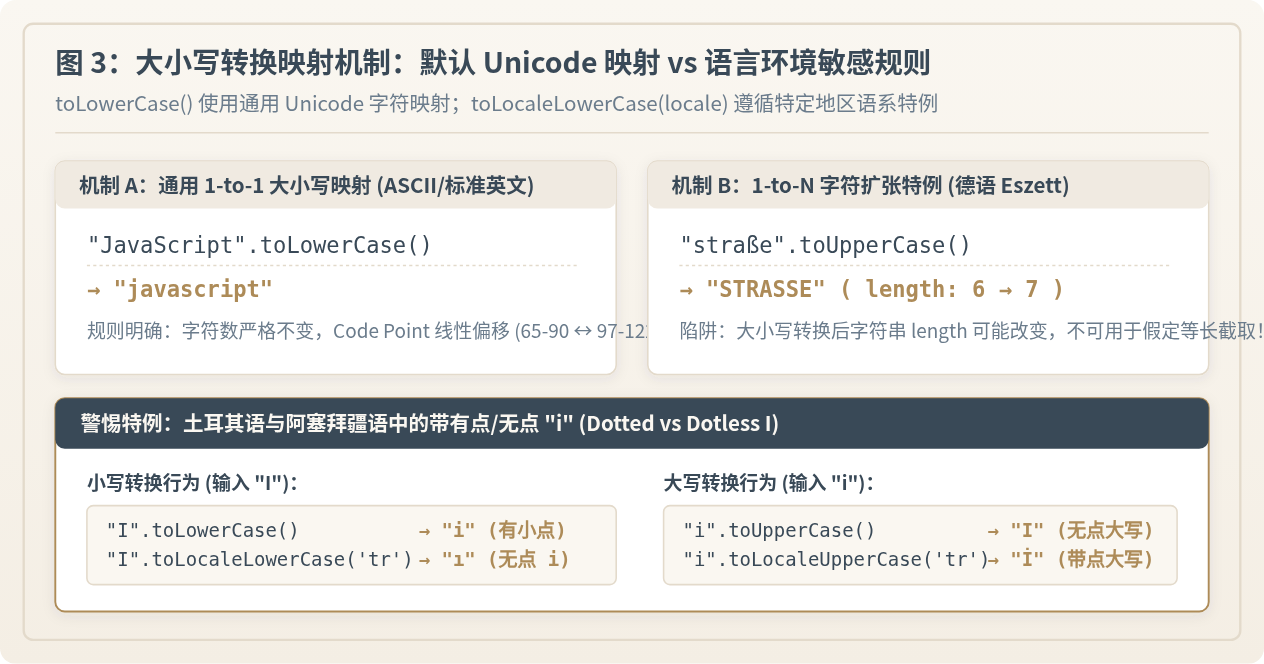
四、综合实战:构建健壮的文本清洗与规范化管道
在真实的工程项目中,去除空格与大小写转换往往协同工作。通过函数式组合或链式调用,可以建立高容错、可复用的清洗管道。
实战案例 1:用户输入账号/邮箱规范化清洗器
在注册和登录逻辑中,用户输入的邮箱应当不区分大小写,且绝对不允许首尾多余空格:
/**
 * 安全清洗用户邮箱输入
 * @param {unknown} input - 原始用户输入
 * @returns {string} 规范化后的纯净小写邮箱
 */
function sanitizeEmail(input) {
  if (typeof input !== 'string') {
    return '';
  }
  // 步骤:剔除所有内部空格(防御意外键入)并统一转为全小写
  return input.trim().replace(/\s+/g, '').toLowerCase();
}

// 验证清洗效果
console.log(sanitizeEmail("  John.Doe @Example.COM
")); // 示例输出: "john.doe@example.com"
console.log(sanitizeEmail(null)); // 示例输出: ""
实战案例 2:英文短语 Title Case(首字母大写)格式化
在展示文章标题、英文姓名或分类标签时,常需将每个单词首字母大写、其余字母小写,同时自动收拢词间混乱的空格:
/**
 * 将任意混杂大小写与混乱空格的英文字符串转为 Title Case
 * @param {string} str - 原始短语
 * @returns {string} 标准化后的短语
 */
function toTitleCase(str) {
  if (!str || typeof str !== 'string') return '';

  return str
    .trim()
    .toLowerCase()
    .replace(/(^|\s+)\S/g, (match) => match.toUpperCase())
    .replace(/\s+/g, ' ');
}

console.log(toTitleCase("  fULL-STACK    jAVASCRIPT    DEVELOPER  "));
// 示例输出: "Full-Stack Javascript Developer"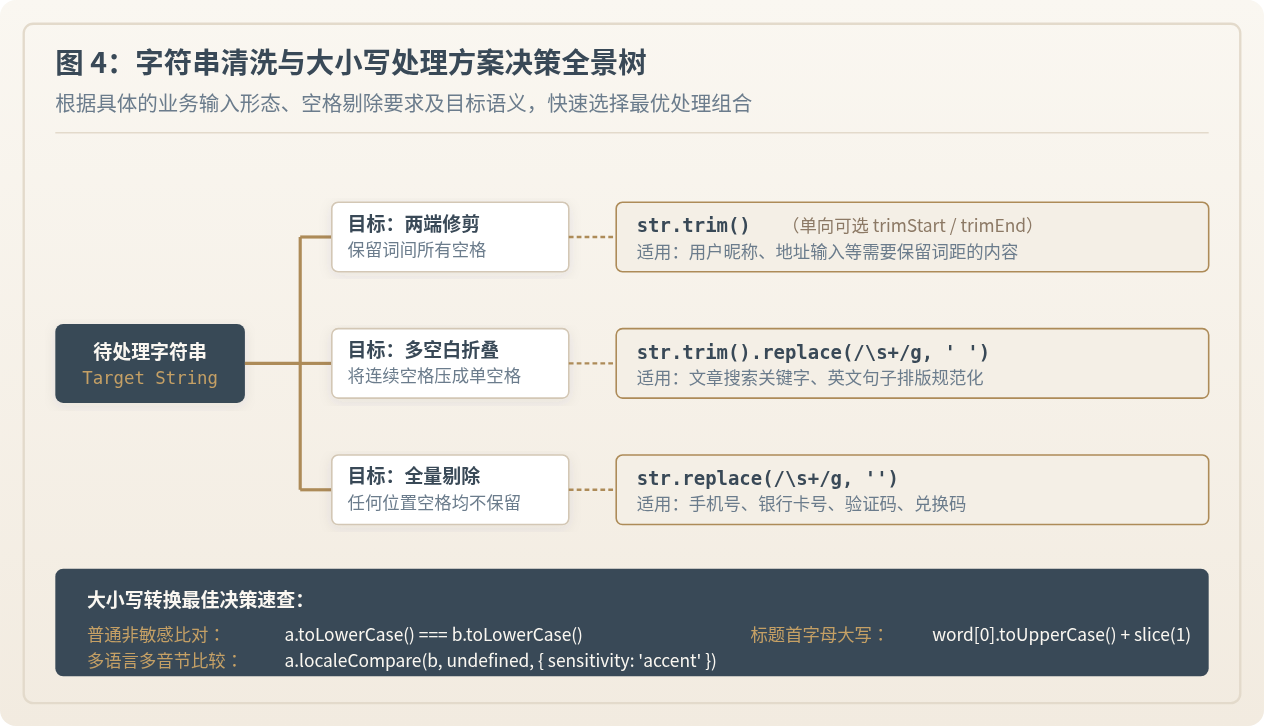
五、生产环境注意事项与方法速查
在日常编码中,为了确保代码的高可用性与可维护性,建议关注以下 3 项关键规范:
-
严防空值崩溃(Null/Undefined Defense):直接在
null或undefined变量上调用.trim()或.toLowerCase()会抛出无法捕获的TypeError: Cannot read properties of undefined。在现代 ES 中,务必使用可选链操作符:input?.trim()?.toLowerCase() ?? ''。 -
理解不可变性(Immutability):初学者常犯错误:直接写
str.trim();并期望str内部变干净。必须重新赋值:str = str.trim();。 -
特殊空白符识别:
\s正则表达式覆盖半角空格、以及绝大部分 Unicode 空白符。但在极个别旧式数据场景中,若遇到特定零宽字符(如零宽空格),trim()与\s均无法匹配,此时需额外针对性匹配/[\s]+/g。
| 业务场景 | 推荐处理方式 | 返回值示例说明 |
|---|---|---|
| 去除表单输入两端无意空格 | str.trim() |
保留内部词间距,两端空白清除 |
| 去除搜索关键词多余连击空格 | str.trim().replace(/\s+/g, ' ') |
折叠中间多个空白为单一空格 |
| 纯数字/卡号/验证码清洗 | str.replace(/\s+/g, '') |
所有位置空白彻底清除 |
| 账号/邮箱等凭证无感比对 | str.trim().toLowerCase() |
去除两端空白并统一转换为全小写 |
| 国际化/非英语字符大小写转换 | str.toLocaleLowerCase(locale) |
遵循指定语言环境的特殊音节映射规则 |
JS 获取当前年份并格式化为四位字符串的方法
2026-11-18 15:27:56
Python和JavaScript自学哪家强:社区资源与调试体验对难度的影响
2026-11-18 15:03:09
为什么复杂JS跨域请求会触发OPTIONS预检及失败排查
2026-11-18 11:12:34
JS日历插件中文本地化配置失败怎么解决
2026-11-18 10:49:09
怎么解决JS获取星期几的时区偏差问题
2026-11-18 09:22:47







