

JS怎么使用栈和队列实现树的非递归遍历
全面讲解在JavaScript中使用栈(Stack)和队列(Queue)实现树的非递归遍历。深入分析前序、中序、后序与层序遍历的迭代解法、核心状态演变、代码模板与性能优化注意事项。
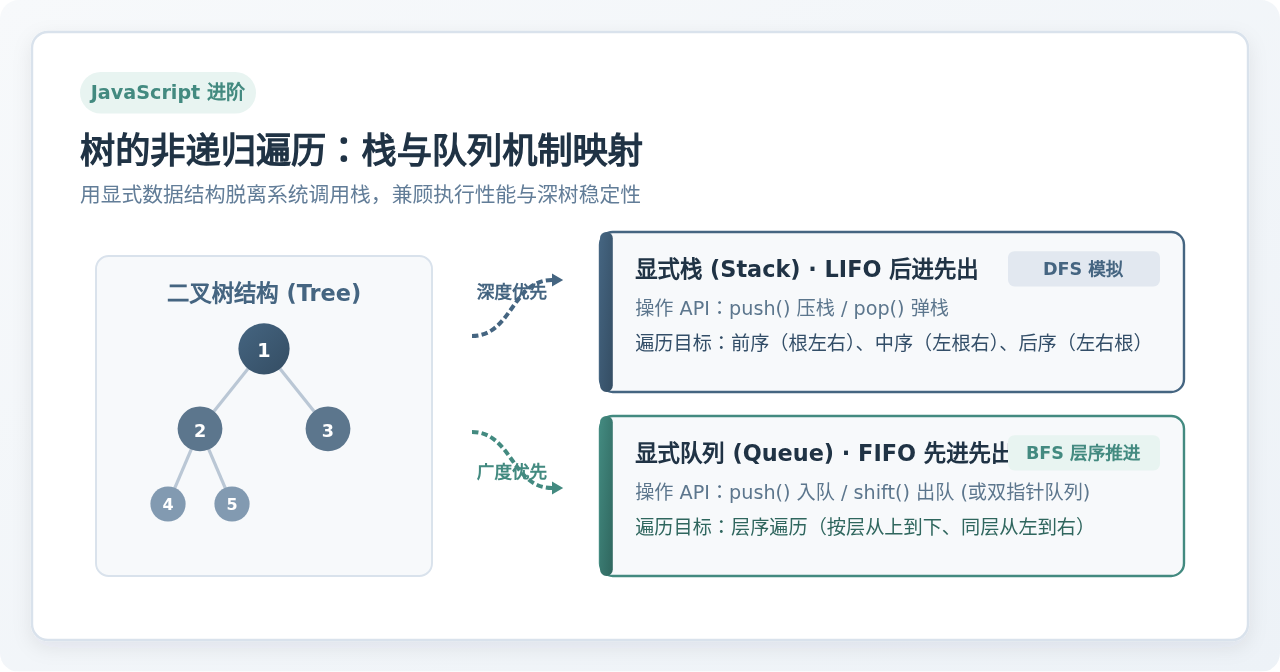
树的递归遍历直观且代码简短,但当树的层级极深时,递归调用会频繁占用宿主环境的函数调用栈(Call Stack),一旦深度超出限制便会抛出 Maximum call stack size exceeded 异常。在 JavaScript 中实现树的非递归遍历,核心方法是将运行时的函数隐式调用栈替换为我们在堆内存中手动维护的显式数据容器:对于具备“深层探索后回溯”(后进先出,LIFO)特性的深度优先遍历(前序、中序、后序),使用栈(Stack)模拟;对于具备“自上而下逐层扫描”(先进先出,FIFO)特性的广度优先遍历(层序遍历),则使用队列(Queue)推进。本文将系统拆解这两种容器在非递归遍历中的算法设计与 JavaScript 实际编码落地。
一、为什么能用栈和队列代替递归?
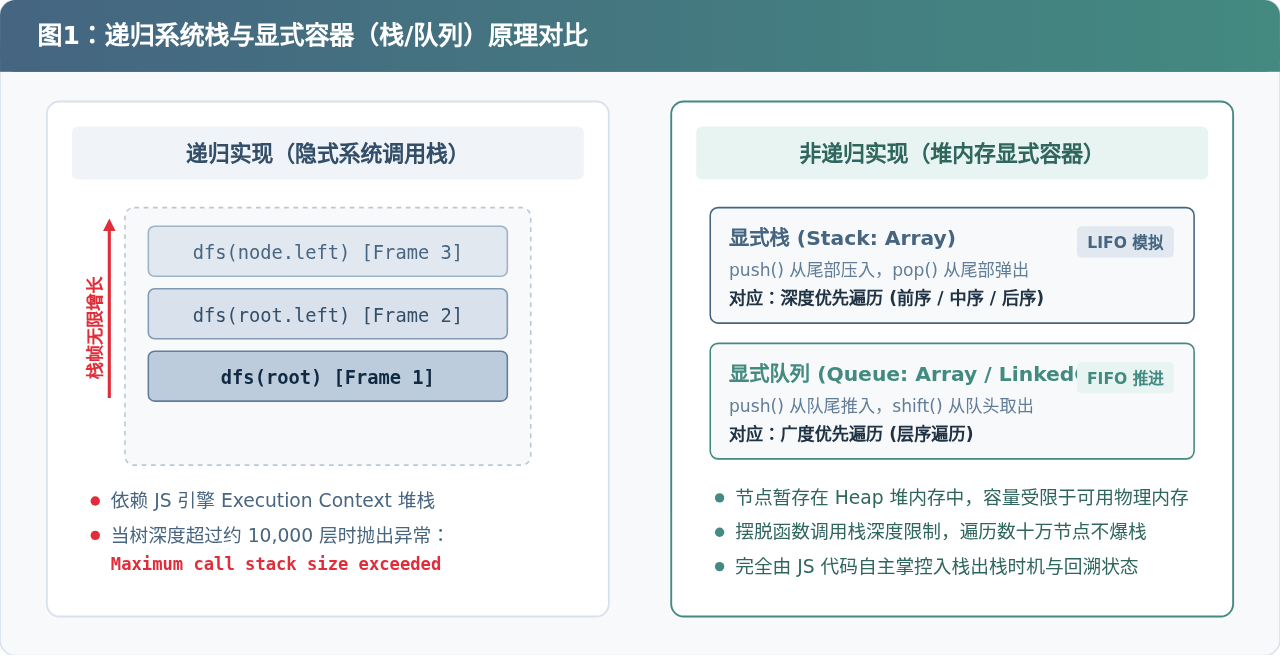
在理解代码前,首先需要弄清楚计算机执行递归的底层逻辑。当在 JavaScript 中调用一个函数时,V8 引擎会在调用栈中为当前函数分配一个栈帧(Stack Frame),保存局部变量、参数和返回地址。在递归遍历树时,深度优先搜索不断深入左子树,系统调用栈随之加深;到达叶子节点后,最深层的函数执行完毕并返回,上一层函数接着处理右子树。这种“由深及浅、逐层回溯”的规律,本质上就是后进先出(Last In, First Out)。
因此,我们完全可以在堆内存中创建一个普通数组作为显式栈,手动保存尚未处理完毕的节点对象。这不仅能突破系统调用栈数千至上万层的深度限制,还能让我们更精准地控制每个节点出入栈的时机。而当我们的遍历需求转变为“先把第 1 层的节点全部读完,再读第 2 层,接着读第 3 层”时,先被发现的节点需要先被处理,这就自然切换成了先进先出(First In, First Out)规律,对应的容器即为队列。
为了后续示例代码统一步调,我们先定义一个标准的 JavaScript 二叉树节点类:
// 定义统一的二叉树节点结构
class TreeNode {
  constructor(val, left = null, right = null) {
    this.val = val;
    this.left = left;
    this.right = right;
  }
}
二、使用栈实现深度优先遍历(DFS)
深度优先遍历分为前序、中序和后序三种形态。三者的访问顺序各不相同,因此在利用栈实现非递归时,入栈与出栈的触发时机存在关键差异。
1. 前序遍历(Preorder:根 → 左 → 右)
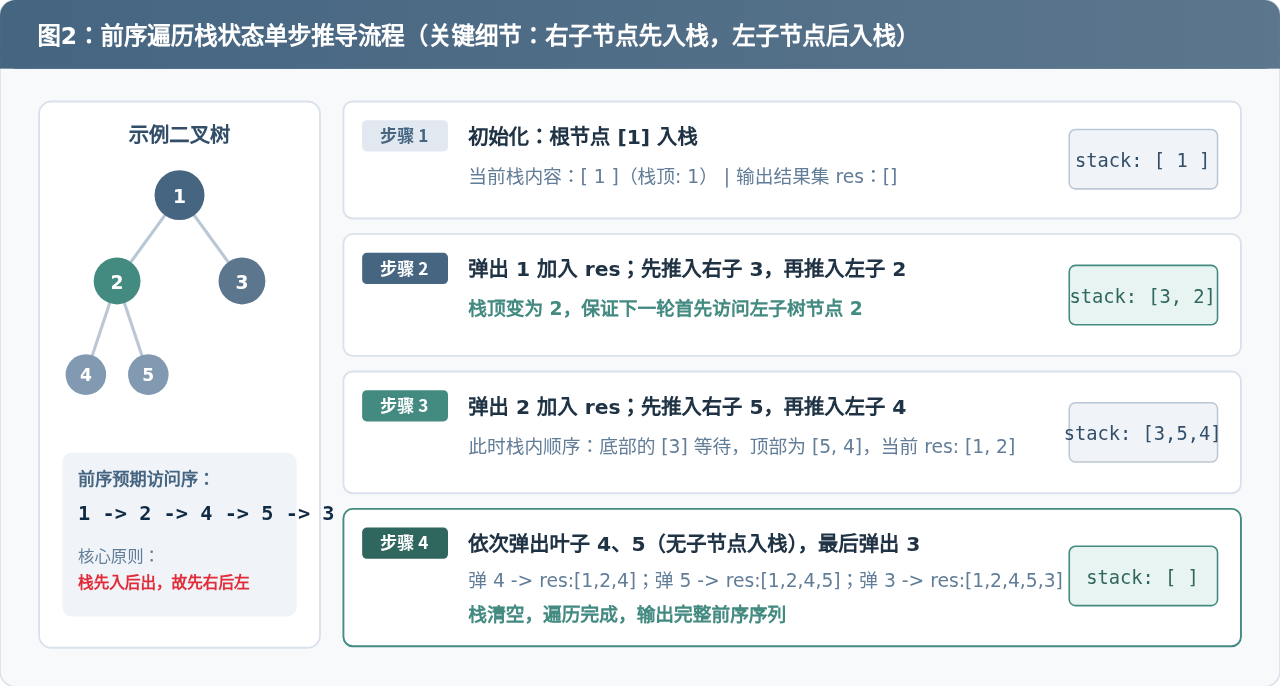
前序遍历的规则是:每遇到一个节点,立即访问该节点的值,然后继续深入左子树,最后处理右子树。在非递归实现中,核心步骤如下:
- 若根节点为空直接返回空数组;否则创建栈
stack,将根节点推入栈中。 - 开启
while (stack.length > 0)循环。 - 弹出栈顶节点
node,将其值记录到结果数组res中。 - 关键细节:先将右子节点入栈,再将左子节点入栈。因为栈是“后进先出”,右子节点先入栈会沉在下方,左子节点后入栈会处于栈顶,在下一次循环迭代时,左子节点就会被优先弹出处理,从而保证了“根 → 左 → 右”的顺序。
/**
 * 前序遍历非递归实现(根 -> 左 -> 右)
 * @param {TreeNode} root
 * @return {number[]}
 */
function preorderTraversal(root) {
  if (!root) return [];
  const res = [];
  const stack = [root];

  while (stack.length > 0) {
    const curr = stack.pop();
    res.push(curr.val);

    // 注意:先右后左入栈,确保左子节点先出栈
    if (curr.right) stack.push(curr.right);
    if (curr.left) stack.push(curr.left);
  }

  return res;
}
2. 中序遍历(Inorder:左 → 根 → 右)
中序遍历要求优先访问整棵子树最左侧的叶子节点,返回时才访问当前子树的根,最后转向右子树。由于不能在第一次遇到根节点时就访问其值,因此我们需要借助一个游标指针 curr 配合栈来追踪深入路径:
- 初始化指针
curr = root和一个空栈stack = []。 - 循环条件设定为
while (curr !== null || stack.length > 0)。 - 一直向左深入到底:只要
curr不为空,就将curr压入栈中,并执行curr = curr.left。这一步会将访问沿途的所有根节点暂存到栈里。 - 当
curr为空时,说明已经到达当前路径的最左侧尽头。此时从栈中弹出栈顶节点,记录该节点的值(此时为“左”或“根”)。 - 将
curr指向弹出节点的右子节点curr = curr.right,进入下一轮循环,开始探索右子树。
/**
 * 中序遍历非递归实现(左 -> 根 -> 右)
 * @param {TreeNode} root
 * @return {number[]}
 */
function inorderTraversal(root) {
  const res = [];
  const stack = [];
  let curr = root;

  while (curr !== null || stack.length > 0) {
    // 1. 一路向左将沿途节点全部压栈
    while (curr !== null) {
      stack.push(curr);
      curr = curr.left;
    }

    // 2. 到达最左侧尽头,回溯弹出栈顶节点并访问
    curr = stack.pop();
    res.push(curr.val);

    // 3. 转向右子树
    curr = curr.right;
  }

  return res;
}null 时,才弹出栈顶并输出其值。对于二叉搜索树(BST),中序遍历能够天然输出单调递增的有序序列。
3. 后序遍历(Postorder:左 → 右 → 根)
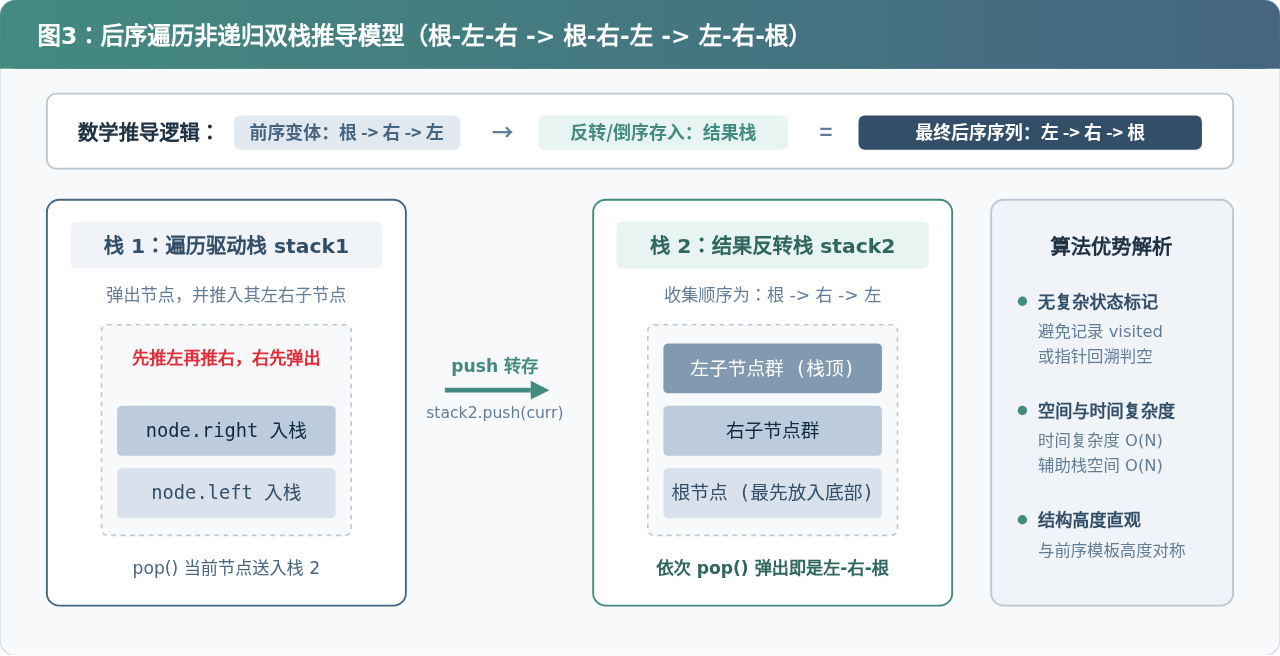
后序遍历要求左子树和右子树全部访问完毕后,最后才访问根节点。如果用单栈实现,需要额外维护一个 lastVisited 指针来判断右子树是否已经处理完毕,逻辑相对容易出错。工程中最优雅直观的非递归方案是双栈法(或逆序前序变体法)。
观察访问顺序的对称性:
- 前序遍历顺序:根 → 左 → 右
- 调整子节点入栈顺序后(先左后右入栈,使得右先弹出):根 → 右 → 左
- 将上述序列整体反转:左 → 右 → 根,恰好就是后序遍历!
基于此,我们使用第一个栈 stack1 按照“根 → 右 → 左”的顺序遍历,每次弹出时不立即输出,而是压入第二个栈 stack2(或者直接调用数组的 unshift / 最后 reverse)。当 stack1 遍历结束时,依次从 stack2 中弹出的顺序即为严格的“左 → 右 → 根”。
/**
 * 后序遍历非递归实现(左 -> 右 -> 根)- 双栈法
 * @param {TreeNode} root
 * @return {number[]}
 */
function postorderTraversal(root) {
  if (!root) return [];
  const stack1 = [root];
  const stack2 = [];

  while (stack1.length > 0) {
    const curr = stack1.pop();
    stack2.push(curr); // 转存到结果栈中

    // 注意:先推入左子节点,再推入右子节点
    // 这样 stack1 下次弹出时会先处理右子节点(形成 根->右->左 顺序)
    if (curr.left) stack1.push(curr.left);
    if (curr.right) stack1.push(curr.right);
  }

  // 依次弹出 stack2,得到完整的 左->右->根 序列
  const res = [];
  while (stack2.length > 0) {
    res.push(stack2.pop().val);
  }

  return res;
}
三、使用队列实现广度优先遍历(BFS)
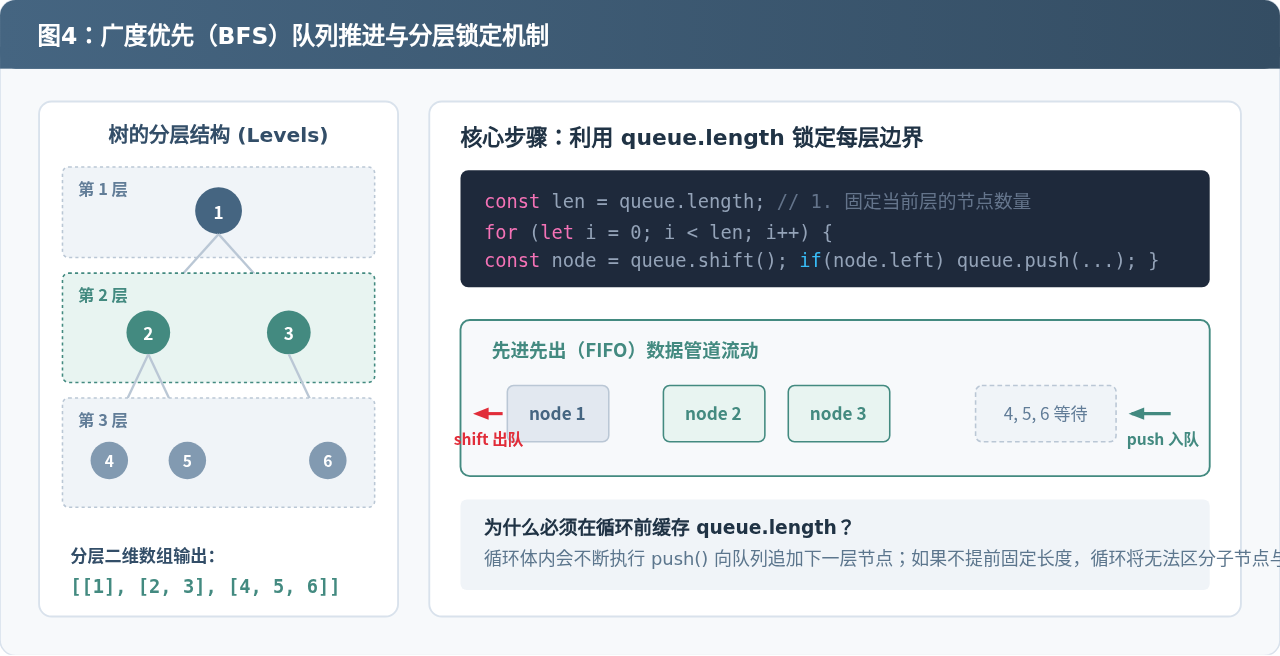
广度优先遍历(层序遍历)的特点是按层探索:先访问距离根节点距离为 0 的节点(根自身),再访问距离为 1 的全部子节点,以此类推。由于同层的节点需要严格按照“从左到右被发现的先后顺序”进行访问,这种场景与队列(Queue)的“先进先出”原则完全契合。
层序遍历标准分层模板
在实际开发与算法题中,通常要求以二维数组形式输出每一层的节点(如 [[1], [2, 3], [4, 5]])。实现的关键技巧在于:在处理当前层之前,先用 const len = queue.length 将当前队列的元素个数锁定下来。因为在循环遍历当前层的 len 个节点并将其 shift() 出队时,它们的子节点也会被 push() 进队;如果动态读取 queue.length,会导致内层循环无法区分当前层与下一层。
/**
 * 二叉树层序遍历(按层输出二维数组)
 * @param {TreeNode} root
 * @return {number[][]}
 */
function levelOrder(root) {
  if (!root) return [];
  const result = [];
  const queue = [root]; // 初始化队列,放入根节点

  while (queue.length > 0) {
    // 关键步骤:锁定当前层的节点数量
    const levelSize = queue.length;
    const currentLevel = [];

    // 严格循环当前层节点数次,避免与下一层混淆
    for (let i = 0; i < levelSize; i++) {
      const node = queue.shift();
      currentLevel.push(node.val);

      // 依次将当前节点的左右子节点推入队尾(下一层)
      if (node.left) queue.push(node.left);
      if (node.right) queue.push(node.right);
    }

    result.push(currentLevel);
  }

  return result;
}
四、JavaScript 数组模拟栈与队列的性能注意事项
JavaScript 没有原生的 Stack 或 Queue 类,我们普遍使用标准内置的 Array 进行模拟。然而,二者的底层时间复杂度在不同场景下差异显著:
| 操作类型 | 对应 JS 方法 | 时间复杂度 | 底层原因与性能说明 |
|---|---|---|---|
| 栈操作:入栈 (Push) | array.push(item) |
O(1) 均摊 | 直接在数组末尾追加元素,极少触发内存连续扩容,效率极高。 |
| 栈操作:出栈 (Pop) | array.pop() |
O(1) | 直接弹出末尾元素并缩容,无需移动其余元素位置,性能优异。 |
| 队列操作:入队 (Enqueue) | array.push(item) |
O(1) 均摊 | 队尾插入,开销与入栈相同。 |
| 队列操作:出队 (Dequeue) | array.shift() |
O(n) | 移除头部元素后,后续所有元素的索引必须向前平移一位,节点量大时性能严重下降。 |
queue.shift() 会导致整体时间复杂度从期望的 $O(N)$ 退化为 $O(N^2)$。优化方案是使用双指针偏移(不真正删除元素,只移动 head 指针),或者手写一个极简的基于链表实现的真实队列。
// 针对大数据量层序遍历的“双指针模拟队列”优化技巧
function levelOrderOptimized(root) {
  if (!root) return [];
  const res = [];
  const queue = [root];
  let head = 0; // 读指针,避免调用 shift() 产生 O(n) 平移开销

  while (head < queue.length) {
    const levelSize = queue.length - head;
    const currentLevel = [];

    for (let i = 0; i < levelSize; i++) {
      const node = queue[head++]; // O(1) 读取并后移指针
      currentLevel.push(node.val);

      if (node.left) queue.push(node.left);
      if (node.right) queue.push(node.right);
    }

    res.push(currentLevel);
  }

  return res;
}
五、全景总结与选择依据
为了在实际业务或算法设计中快速做出正确的技术选型,我们将四种主要的非递归遍历方法汇总如下表:
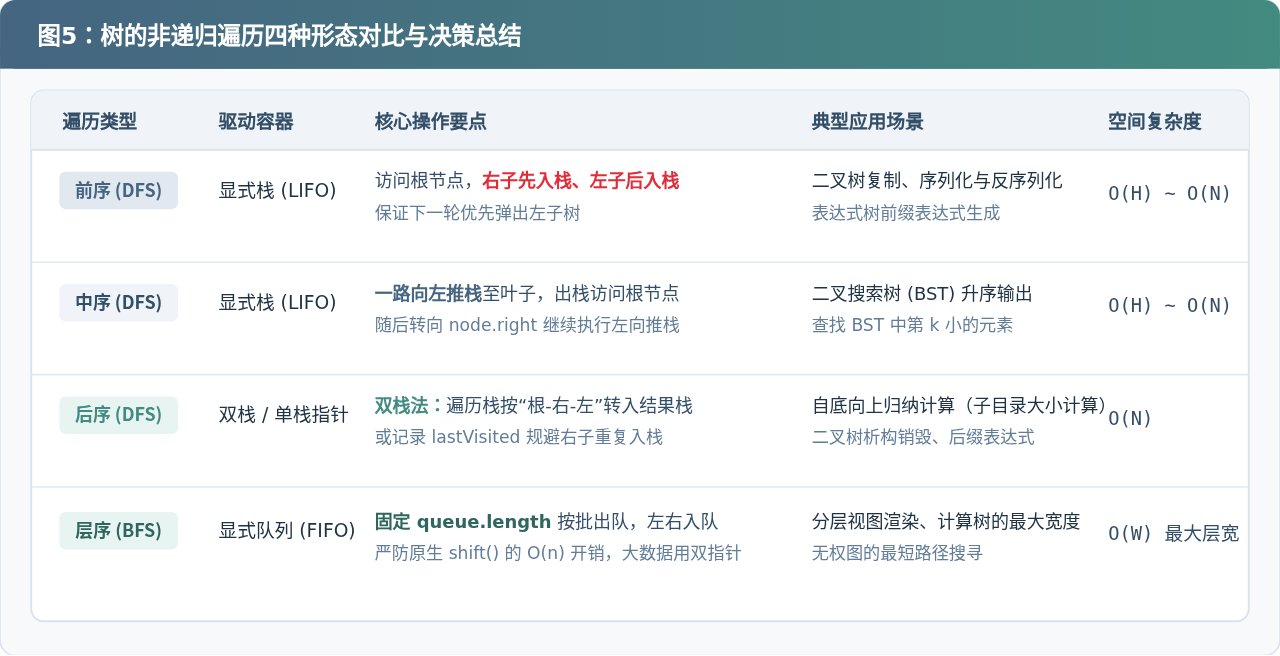
总结来说,使用 JavaScript 实现树的非递归遍历并不复杂,核心在于牢牢掌握数据流动与物理容器的对应关系:
- 需要深度优先(前序/中序/后序),立刻联想栈(Stack)。写代码时重点关注入栈顺序:由于栈的后进先出特性,前序遍历中要先压右子再压左子;中序遍历中要一路沿左指针深入压栈到底;后序遍历则优先采用双栈法(先得到根右左,再反转输出)。
- 需要广度优先(层序遍历),立刻联想队列(Queue)。写代码时务必注意循环前提取
queue.length锁定层宽,若数据量极大则应使用双指针代替原生shift()。
掌握这套规则后,无论树的深度与分叉多么复杂,均可写出逻辑清晰、健壮不爆栈的高质量 JavaScript 遍历代码。
JS利用replace方法在匹配位置插入字符
2026-11-18 20:02:25
JS网络请求方案对比:Fetch、XMLHttpRequest与Axios怎么选
2026-11-18 18:26:07
JS函数表达式与函数声明的区别:提升机制解析
2026-11-18 18:11:53
JS实现验证码发送60秒倒计时禁用按钮
2026-11-18 16:23:57
JavaScript中XMLHttpRequest怎么实现请求超时处理
2026-11-18 15:56:39







