JS怎么用正则解析非标准格式字符串为数组
详细讲解在JavaScript中如何使用正则表达式将包含混合分隔符、带引号保护项、键值对以及转义字符的非标准格式字符串精确解析为数组。对比split与matchAll两种核心方案,提供步骤流程、原理拆解、实战示例与避坑指南。
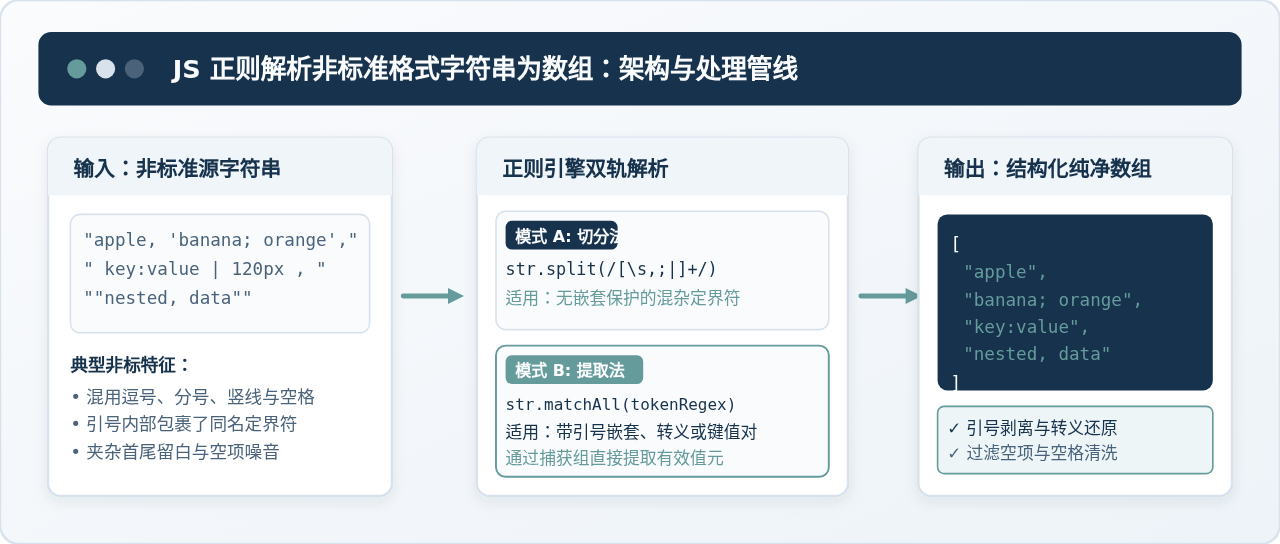
在 JavaScript 中将非标准格式字符串解析为数组,核心思路取决于字符串中是否存在“受保护内容”:如果仅是逗号、分号、空格混杂且值本身不包含定界符,使用 str.split(/[\s,;|]+/).filter(Boolean) 即可快速按分隔符切开;但如果数据项内部包含引号、括号或转义字符(例如 "apple, banana", orange 中的逗号绝不能当作分隔符),则必须放弃切分定界符的思路,转而使用 matchAll 直接提取符合有效词元(Token)特征的目标值。理解这两种策略的适用场景,是写出高健壮性解析代码的关键。
一、轻度非标:混合分隔符与连续留白的切分处理
日常业务中最常见的一种非标准字符串,是由于用户手工输入或多源数据拼凑导致的定界符混乱。比如用户可能同时混用了英文逗号、分号、竖线以及若干空格(如 "apple, banana; orange | grape")。
面对这类结构,每个元素的内部都不包含定界符,仅仅是“两端和中间的间隔不规范”。此时无需构建复杂的词法扫描器,利用 String.prototype.split() 搭配字符集(Character Class)和量词即可解决:
// 示例 1:混合空格、逗号、分号与连续空位的切分
const rawInput = "  apple,  banana ; orange  | grape , , peach ; ";

// 正则解析逻辑:
// 1. [\s,;|]+ 匹配一个或多个连续的空白符、逗号、分号或竖线
// 2. filter(Boolean) 滤除因首尾分隔符产生的空字符串元素
const result = rawInput
  .split(/[\s,;|]+/)
  .filter(Boolean);

console.log(result);
// 示例输出: ["apple", "banana", "orange", "grape", "peach"]String.prototype.split() 若在字符串开头或结尾匹配到定界符,或者字符串两端包含空白,会向数组推入空字符串 ""。在切分之后链式调用 .filter(Boolean) 或在切分前先调用 .trim() 是不可忽略的基础防护。
二、机制对比:为什么包含引号保护时 split 会失效?
当非标准字符串进一步复杂化时,split 方案就会遭遇理论极限。例如 CSV 导出数据、命令行参数或包含描述性文本的字符串中,某些数据项本身就被单双引号包裹,且引号内部恰好包含了逗号或空格:
const sample = 'apple, "pear, peach", orange';此时如果仍然使用逗号切分,正则引擎无法感知“引号内部的逗号是数据,引号外部的逗号才是定界符”,结果会导致 "pear 和 peach" 被错误撕裂成两个破碎的元素。
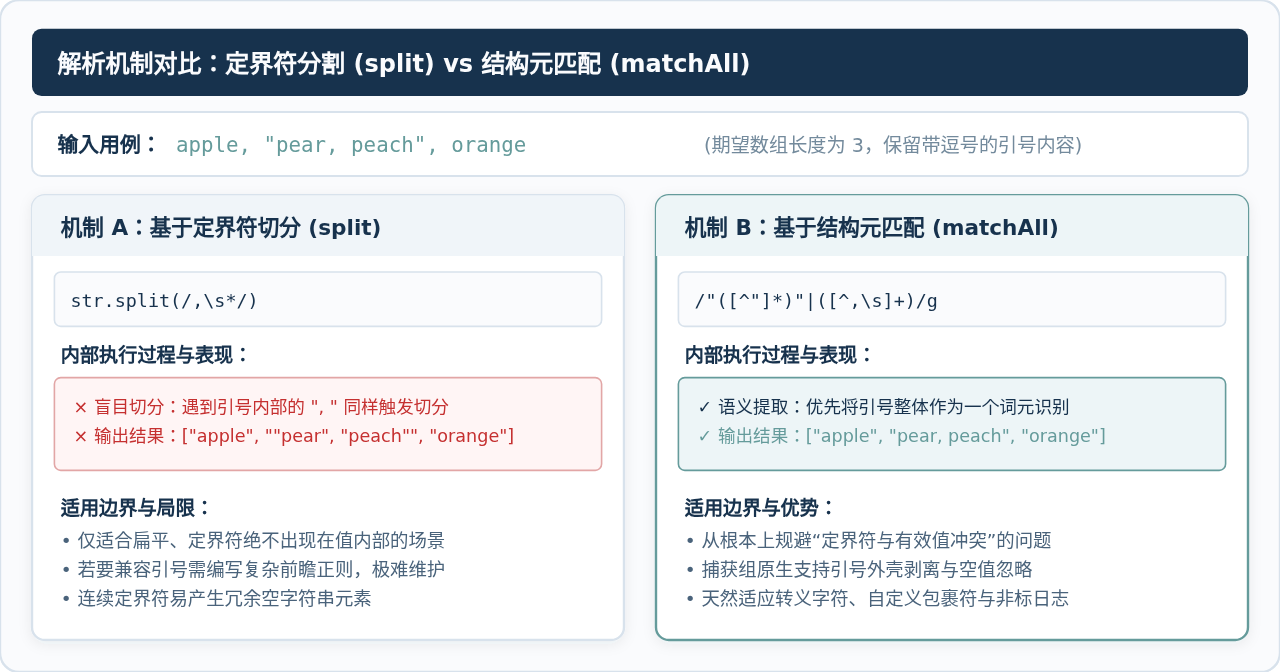
这种场景下的根本解决之道,是将思维从“寻找分隔符切断字符串”转变为“定义有效内容并逐个提取(Token Matching)”。有效内容要么是一个“被引号包裹的整体”,要么是一个“不包含分隔符的普通裸词”。JavaScript 提供的 String.prototype.matchAll() 配合多分支捕获组,正是实现这一匹配哲学的标准工具。
三、四步实现法:使用 matchAll 解析复合非标字符串
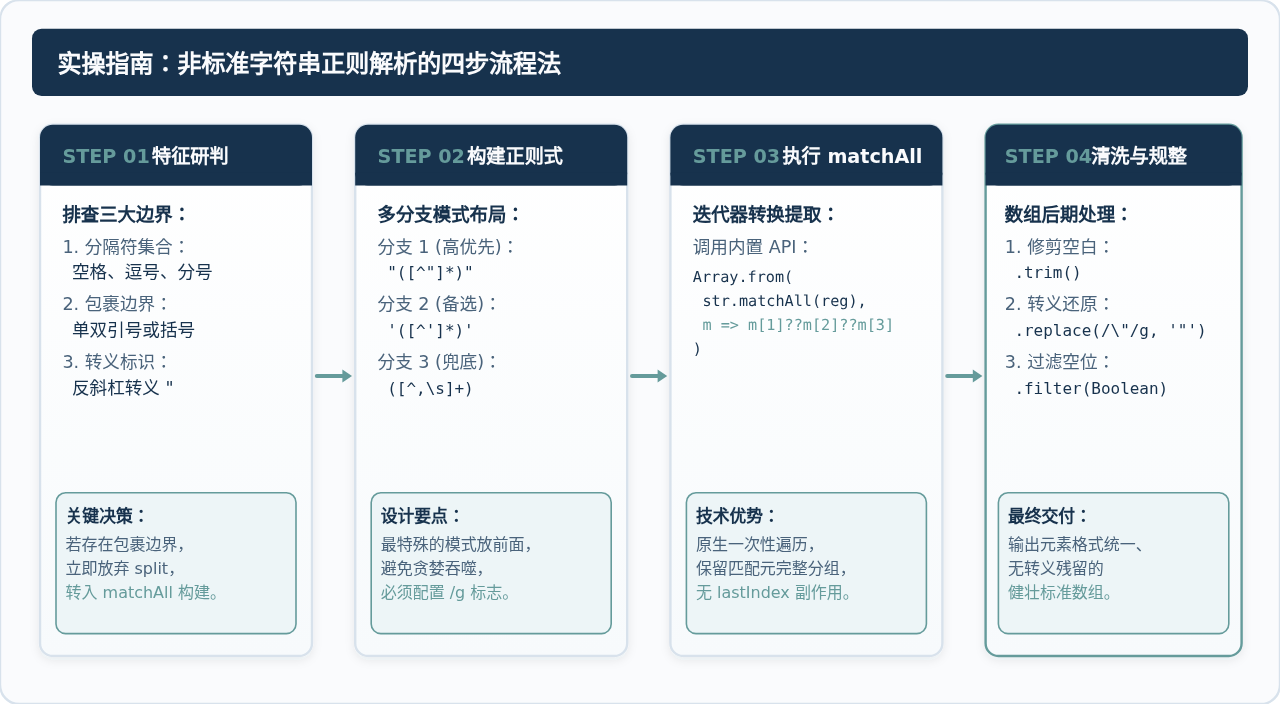
掌握结构元匹配需要建立严谨的分析与构建步骤。按照以下四个步骤操作,可以解决绝大多数包含嵌套引号与混合定界符的解析需求:
步骤 1:分析输入特征与提取边界
观察原始字符串,明确两件事:第一,可能存在的定界符有哪些(如逗号、分号、换行或空格);第二,被保护的值由什么符号包围(通常是单引号 ' 或双引号 ")。
步骤 2:构建多分支排他捕获正则式
利用正则的管道符 | 构建优先分支。让“特征更特殊、边界更严格的模式”排在前面,常规的裸值模式排在最后兜底。例如:
- 分支一(双引号):
"([^"]*)"捕获双引号内部所有非引号字符; - 分支二(单引号):
'([^']*)'捕获单引号内部所有非单引号字符; - 分支三(普通值):
([^,;\s]+)捕获不含定界符的连续字符序列。
步骤 3:使用 matchAll 提取并解构捕获组
matchAll 会返回一个包含所有匹配结果及其分组信息的迭代器。我们在遍历每个匹配对象时,通过空值合并运算符 ?? 即可直接获取真正命中内容的那个捕获组,同时天然剥离外层的引号:
// 步骤 2 与 步骤 3 的代码落实:
function parseCustomString(input) {
  if (!input || typeof input !== "string") return [];

  // 全局修饰符 /g 是 matchAll 必须的
  const tokenRegex = /"([^"]*)"|'([^']*)'|([^,;\s]+)/g;

  // 使用 Array.from 遍历迭代器并映射出对应命中的捕获组
  return Array.from(input.matchAll(tokenRegex), match => {
    // match[1]: 双引号内容, match[2]: 单引号内容, match[3]: 无引号裸值
    return match[1] ?? match[2] ?? match[3];
  });
}

// 结果验证
const inputData = 'item1, "item2, with comma", \'item3; with semicolon\', item4';
console.log(parseCustomString(inputData));
// 示例输出: ["item1", "item2, with comma", "item3; with semicolon", "item4"]
步骤 4:后置清洗与类型化转换
提取出来的数组元素可能还带有前后的零星空白,或者存在转义字符(如 " 被写成了文本中的反斜杠与引号)。在此步骤进行映射修剪或类型解析(如转换数值、布尔值):
const cleanArray = rawArray.map(item => item.trim());四、原理剖析:拆解支持转义符的高健壮性正则
在实际生产环境中,非标准格式还经常引入转义字符。例如在双引号内部允许出现被反斜杠转义的双引号 "he said \"hello\", world"。如果单纯使用 [^"]*,遇到第一个 " 就会提前断开并破坏结构。
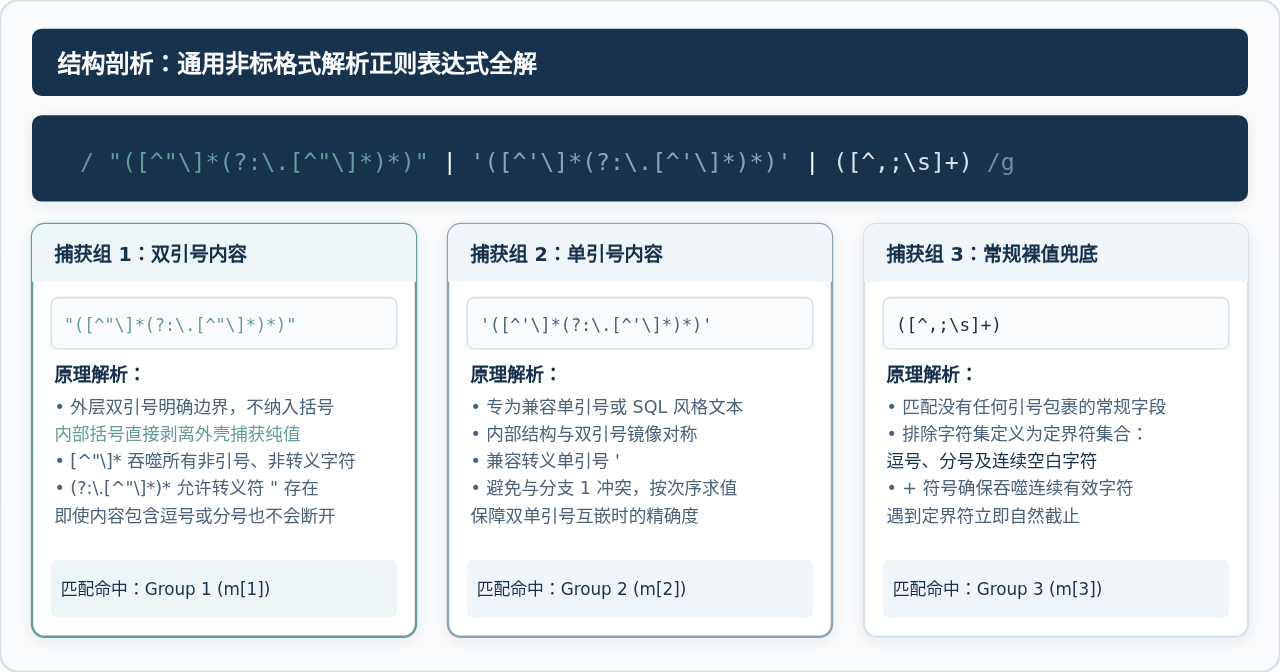
为了支持转义符,双引号分支的捕获规则需要升级为展开式循环:
"([^"\\]*(?:\\.[^"\\]*)*)"该正则各段的具体运作逻辑如下:
[^"\\]*:贪婪匹配任意数量的“既不是双引号也不是反斜杠”的常规字符。(?:\\.[^"\\]*)*:这是一个非捕获组。当遇到反斜杠\时,\\.会强制吞掉反斜杠及其后面的任意紧跟字符(无论后面是引号还是其他字符),随后继续由[^"\\]*吞噬后续常规字符。- 外层
*表示上述转义段可以重复零次或多次,直到遇到真正未转义的闭合双引号为止。 - 捕获括号
(...)仅包裹双引号内部,外层引号作为边界匹配被丢弃,直接实现了“去壳”提取。
五、高频实战场景与完整代码实现
场景 A:提取非标准键值对或配置项为二维数组
在解析非标准 URL 查询串、自定义 CSS 声明或旧版服务端日志时,常见形如 "theme: dark; timeout=3000, debug:true;" 的混合格式:
function parseKeyValueList(str) {
  // 匹配形如 key:value 或 key=value 的词元,支持带引号的值
  const kvRegex = /(?[\w-]+)\s*[:=]\s*(?:"([^"]*)"|'([^']*)'|([^,;\s]+))/g;
  const entries = [];

  for (const match of str.matchAll(kvRegex)) {
    const key = match.groups.key;
    const value = match[1] ?? match[2] ?? match[3];
    entries.push([key, value]);
  }
  return entries;
}

const configStr = 'host: localhost; port=8080, name:"Main Database"; ssl:true';
console.log(parseKeyValueList(configStr));
// 示例输出: [
//   ["host", "localhost"],
//   ["port", "8080"],
//   ["name", "Main Database"],
//   ["ssl", "true"]
// ]
场景 B:提取数值与单位混合的样式尺寸列表
在解析复合 CSS 属性值(如 padding: 10px 20.5rem auto 0;)时,需要将各类非标准单位项拆解为有序数组:
function parseCssTokens(cssValue) {
  // 匹配带单位的数值、百分比、纯数字或特定关键字(如 auto/inherit)
  const tokenRegex = /-?\d*\.?\d+(?:px|rem|em|%|vh|vw)?|[a-zA-Z-]+/g;
  return cssValue.match(tokenRegex) || [];
}

const paddingStr = "12.5px  0rem   auto  -5px";
console.log(parseCssTokens(paddingStr));
// 示例输出: ["12.5px", "0rem", "auto", "-5px"]
六、避坑指南与性能考量
- 警惕 RegExp 对象的 lastIndex 状态泄露:当使用
RegExp.prototype.test()或RegExp.prototype.exec()配合/g标志时,正则对象会记录上一次匹配结束的字符索引lastIndex。复用全局正则实例容易导致偶发性漏配。建议优先使用str.matchAll(),或者在每次执行前重置reg.lastIndex = 0。 - 防御回溯陷阱(ReDoS):在构建包含重叠重复项(如
(a+)+)的复杂正则时,输入未闭合的超长引号可能导致计算时间呈指数级上升。保证排除字符集互斥(如使用[^"]*而非.*?)能有效杜绝灾难性回溯。 - 未闭合引号的容错机制:如果用户输入的字符串最后存在未闭合的单双引号(例如
'apple, "broken item'),纯粹的包裹匹配将丢失末尾项。如果业务对容错要求极高,可以在末尾分支增加(?:"[^"]*"?|'[^']*'?)的宽松匹配。
七、总结与选型决策
解析非标准格式字符串并不存在唯一的最优解,而是应当依据数据特征的复杂度做出针对性权衡:
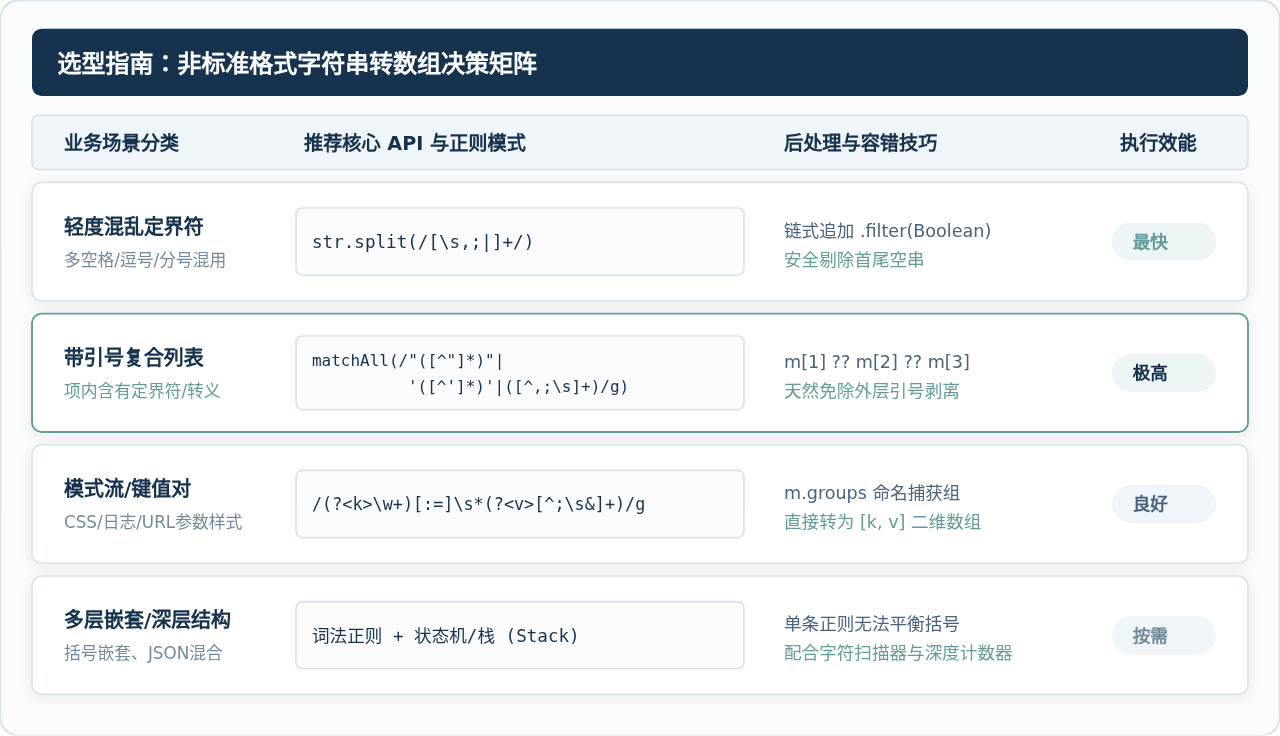
综上所述,当数据格式仅存在分隔符混乱时,优先使用 split(/[\s,;|]+/).filter(Boolean),代码最为精简且执行速度极快;而一旦数据涉及到引号包裹、转义字符或定界符混入内容内部,应毫不犹豫地采用 matchAll 词元捕获方案。先研判数据边界,再选择合适的分支模型,就能在保证解析效率的同时确保系统处理异构文本的健壮性。
JS怎么获取对象属性个数:Object.keys().length用法详解
2026-11-18 17:21:11
JS数组转字符串:join()自定义分隔符与toString()默认逗号的区别
2026-11-18 16:43:36
JavaScript常用库有哪些?按功能分类的精选清单
2026-11-18 14:39:29
怎么让JavaScript对象像结构体一样不可修改
2026-11-18 12:53:38
邵山欢JavaScript笔记:核心知识点与代码案例汇总
2026-11-17 23:06:09