

JS获取DOM元素的5种常用方法详解
深入解析JavaScript中获取DOM元素的5种常用方法:getElementById、getElementsByClassName、getElementsByTagName、querySelector与querySelectorAll。包含API语法、返回值类型、动态集合与静态快照差异及工程选型建议。
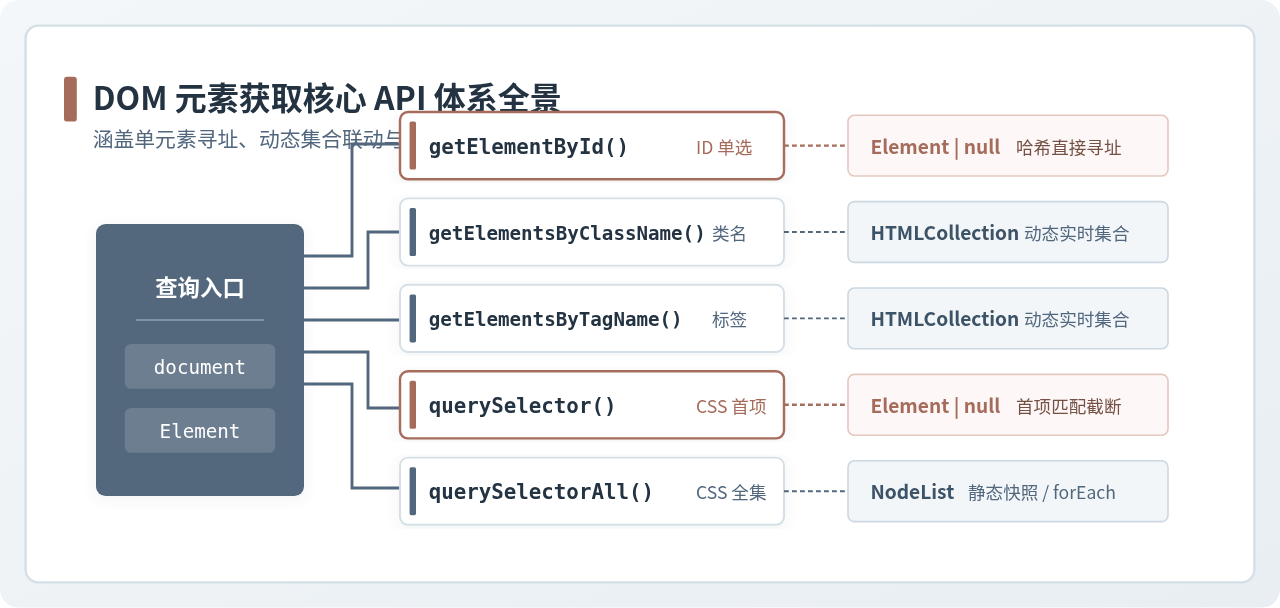
document 或具体 Element 上调用的查询 API。其中最常用、也是面试与日常编码中最高频的 5 种方法分别为:getElementById、getElementsByClassName、getElementsByTagName、querySelector 以及 querySelectorAll。这 5 种方法并非单纯的语法糖区别,它们在选择器语法支持、执行性能、底层哈希映射以及返回对象是“动态集合(HTMLCollection)”还是“静态快照(NodeList)”等机制上存在本质差异。本文将逐一深入拆解各方法的具体用法、底层原理与最佳实践。
一、核心查询执行流程与作用域判定
在调用任何获取方法前,首先要明确查询的作用域(Context)。除了 getElementById 只能在全局 document 对象上调用外,其余 4 种方法均可在具体的 Element 节点上直接执行。缩小查询范围不仅能提升检索效率,还能有效避免全局命名冲突。
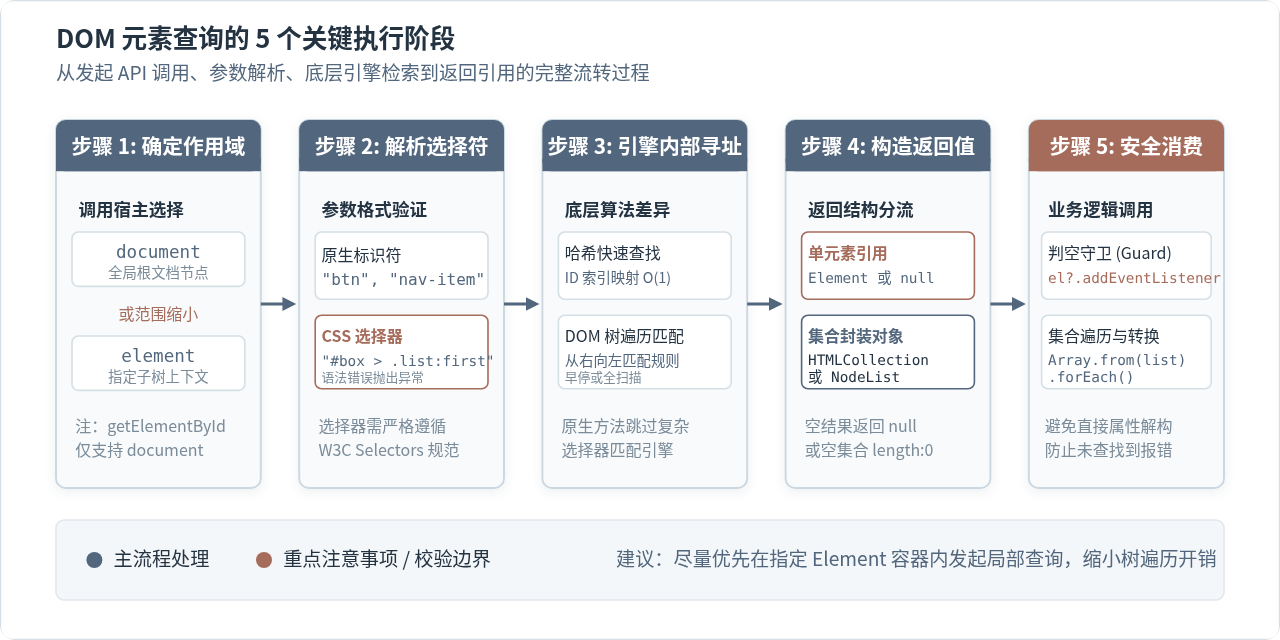
一次完整的 DOM 获取通常经历五个阶段:从确定宿主上下文、解析选择符、引擎执行底层二分或树状深度遍历、构造返回值包装,到最后的安全性业务判空。理解这一流转机制是避免 TypeError: Cannot read properties of null 的基础。
二、方法详解 1:document.getElementById()
getElementById 是浏览器历史最悠久且执行速度最快的元素查找方法。它接收一个字符串形式的 id 属性值,返回文档中首个匹配该 ID 的 Element 引用;若未匹配到则返回 null。
1. 语法规范与使用示例
// 基础语法:element = document.getElementById(idString);

// HTML 示例:<button id="submit-btn">提交数据</button>
const submitButton = document.getElementById('submit-btn');

if (submitButton !== null) {
  submitButton.addEventListener('click', () => {
    console.log('按钮被点击');
  });
} else {
  console.warn('未能找到 ID 为 submit-btn 的元素');
}
2. 核心特性与注意事项
- 仅支持全局 document 调用:规范中并未在
Element.prototype上定义getElementById,因此无法通过parentDiv.getElementById(...)进行局部查询。若需在特定容器内按 ID 获取,应使用parentDiv.querySelector('#id')。 - 底层哈希表直接映射:大多数现代浏览器引擎(如 Blink、WebKit)会在解析 HTML 时构建 ID 到 DOM 节点的哈希索引表。因此通过 ID 查找通常达到 O(1) 的时间复杂度,性能极高。
- ID 重复时的回退行为:根据 HTML 规范,页面中的 ID 必须唯一。若页面存在脏数据导致 ID 重复,该方法仅返回在 DOM 树中深度优先顺序出现的第一个元素,后续同名元素会被直接忽略。
- 参数区分大小写:在标准 HTML 页面中,ID 匹配对大小写敏感,
document.getElementById('navBar')无法匹配id="navbar"。
三、方法详解 2 与 3:按类名与标签名获取(动态集合)
当需要批量获取一类元素时,传统 DOM API 提供了 getElementsByClassName 和 getElementsByTagName。二者的显著共性在于:它们均返回一个只读的动态集合 HTMLCollection。
1. document.getElementsByClassName()
该方法接收一个或多个以空格分隔的类名,返回当前上下文中所有包含指定类名的元素集合。可直接在 document 或任意 Element 节点上调用。
// 查找页面中所有带有 active 类的元素
const activeItems = document.getElementsByClassName('active');

// 在某个父容器下查找同时具备 item 与 highlight 类的元素
const parentContainer = document.getElementById('news-list');
if (parentContainer) {
  const highlightedNews = parentContainer.getElementsByClassName('item highlight');
  console.log('匹配到的新闻条数:', highlightedNews.length);
}
2. document.getElementsByTagName()
该方法按标签名称(如 div、p、li)检索子孙节点。传入通配符 '*' 可以获取当前上下文下的全部元素节点。
// 获取页面中所有的 input 表单控件
const inputs = document.getElementsByTagName('input');

for (let i = 0; i < inputs.length; i++) {
  console.log(`第 ${i + 1} 个输入框类型:`, inputs[i].type);
}

// 局部查找特定列表下的所有 li 项
const menu = document.getElementById('main-menu');
const menuItems = menu ? menu.getElementsByTagName('li') : [];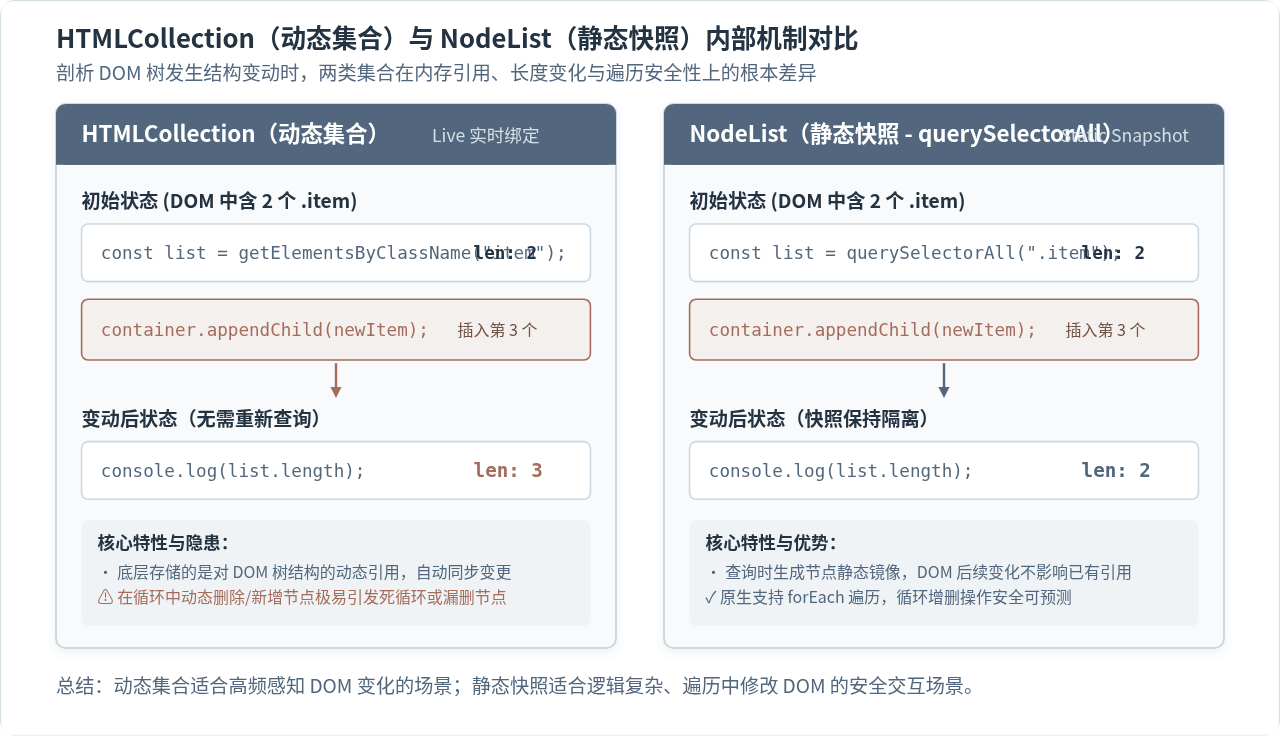
HTMLCollection 是“活”的集合(Live Collection)。它内部维持着对 DOM 树结构的直接引用。当脚本在页面中动态新增或删除元素时,集合的 length 和索引会即时发生改变,无需重新调用查询。常见隐患:在遍历动态集合时执行节点删除操作会导致索引错位。例如:
// 错误写法:由于集合动态缩短,会导致跳过部分元素
const badges = document.getElementsByClassName('badge');
for (let i = 0; i < badges.length; i++) {
  badges[i].remove(); // 删除后 badges.length 动态减少,下一个元素移动到当前索引,导致漏删!
}

// 正确做法 1:逆序遍历
for (let i = badges.length - 1; i >= 0; i--) {
  badges[i].remove();
}

// 正确做法 2:先转换为静态纯数组
const staticList = Array.from(badges);
staticList.forEach(el => el.remove());
四、方法详解 4 与 5:现代选择器 querySelector 与 querySelectorAll
Selectors API 规范为浏览器引入了类似 CSS 选择器的强大定位能力。querySelector 与 querySelectorAll 支持伪类、复合选择器、属性选择器等几乎所有标准 CSS 选择语法,大幅简化了复杂 DOM 结构的抓取成本。
1. Element.querySelector()
接收合法的 CSS 选择器字符串,返回匹配到的第一个 Element 节点。如果未找到匹配项,返回 null;如果传入的选择器语法非法,则抛出 DOMException: SyntaxError。
// 1. 获取选中的单选框
const checkedGender = document.querySelector('input[name="gender"]:checked');

// 2. 获取具有特定自定义数据属性的卡片
const targetCard = document.querySelector('.card-wrapper > [data-role="primary"]');

// 3. 安全调用与可选链
console.log(checkedGender?.value);
2. Element.querySelectorAll()
返回包含文档中所有与指定选择器匹配的元素的静态集合 NodeList。若未找到匹配项,返回一个长度为 0 的空 NodeList,而不是 null。
// 获取表格中所有的偶数行
const evenRows = document.querySelectorAll('table.data-grid tr:nth-child(even)');

// 原生支持 .forEach 迭代
evenRows.forEach((row, index) => {
  row.classList.add('bg-striped');
});
3. 现代选择器的底层匹配原理与静态快照特性
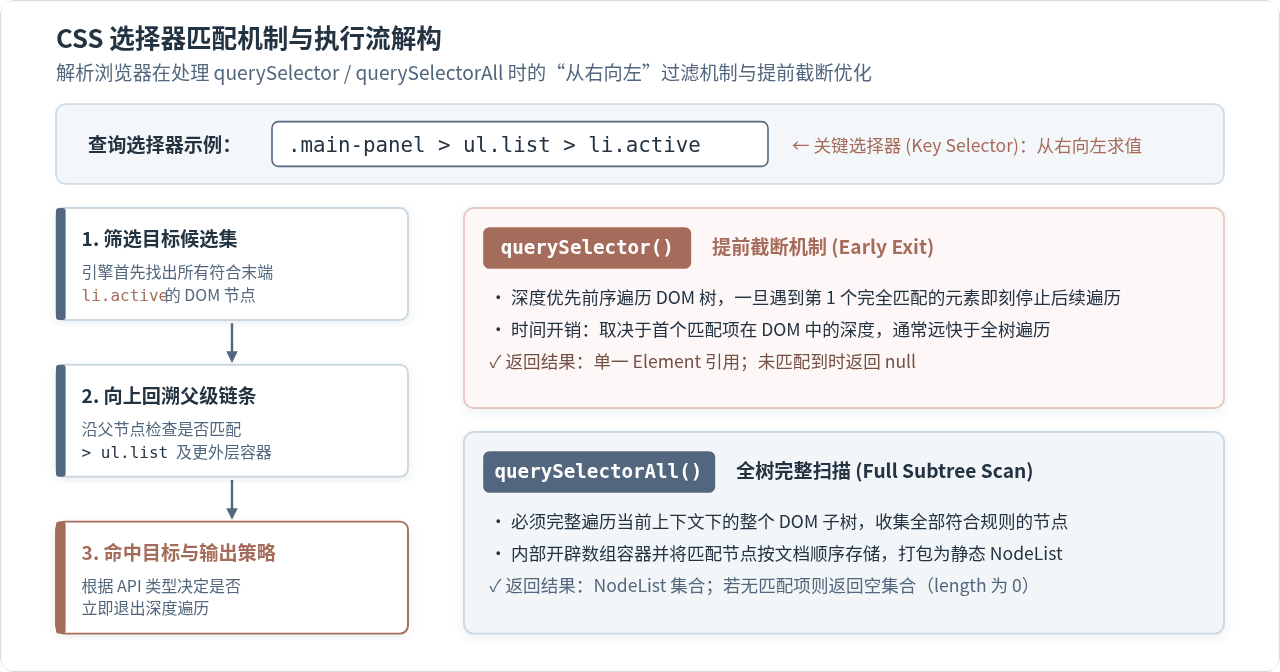
- 从右向左的匹配规则(Right-to-Left Matching):例如对于选择器
.container ul.nav > li.active,浏览器解析器会首先检索 DOM 树中所有的li.active作为候选集(Key Selector),然后向上回溯其父节点是否为ul.nav,最后验证祖先容器。 - 提前截断优化(Early Exit):
querySelector在深度优先遍历中只要确认了第一个匹配成功的节点,便立即中断底层树遍历并返回;而querySelectorAll必须完整扫描指定上下文的整棵子树以收集全部候选结果。 - 静态快照(Static Snapshot):由
querySelectorAll返回的NodeList是查询瞬间 DOM 状态的快照。在获取该集合后,无论后续在 DOM 中如何新增、删除或移动匹配元素,该集合的长度和包含的节点指针均固定不变。这保证了在复杂遍历与批量修改 DOM 时的绝对确定性。 - 伪元素与伪类限制:CSS 伪元素(如
::before、::after)不属于实际 DOM 节点,因此不能通过选择器 API 获取;若需读取伪元素样式,应使用window.getComputedStyle(element, '::before')。
五、5 种常用方法的综合特性对比
为了让不同场景下的 API 选用更加直观,下表对这 5 种方法的参数类型、返回值接口、作用域支持、动态联动性以及遍历能力进行了全方位对比:
| 方法名称 | 调用作用域 | 参数规则 | 返回值类型 | 实时性机制 | 支持 forEach 遍历 |
|---|---|---|---|---|---|
getElementById |
仅 document |
纯 ID 字符串(无 #) | Element | null |
单对象直接引用 | 不适用(单元素) |
getElementsByClassName |
document / Element |
纯类名(空格分隔多个) | HTMLCollection |
动态实时 (Live) | 否(需先转数组) |
getElementsByTagName |
document / Element |
标签名或 * |
HTMLCollection |
动态实时 (Live) | 否(需先转数组) |
querySelector |
document / Element |
标准 CSS 选择器语法 | Element | null |
单对象直接引用 | 不适用(单元素) |
querySelectorAll |
document / Element |
标准 CSS 选择器语法 | NodeList |
静态快照 (Static) | 是(内置支持) |
六、工程实践中的选型原则与常见避坑指南
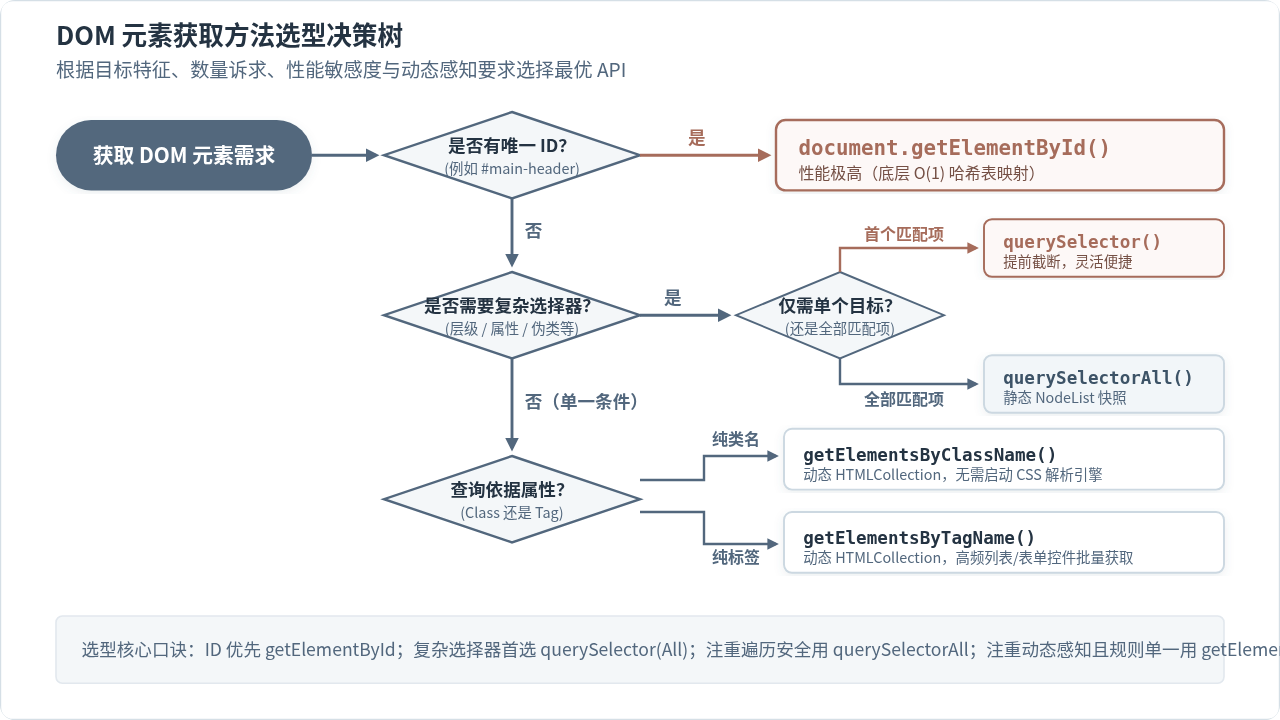
在实际业务代码或前端工程组件开发中,选择何种方法不仅影响代码的可读性与健壮性,也与渲染性能紧密相关。我们可以依据以下选型决策树进行技术选型:
1. 常见错误场景与防御性编程实践
-
在 DOM 树构建完成前执行脚本:
浏览器在由上至下解析 HTML 时,如果
<script>标签位于<head>且未使用defer或DOMContentLoaded监听,直接调用获取方法会返回null。// 规范方案:将脚本放在 body 底部,或通过事件监听确保 DOM 准备就绪 document.addEventListener('DOMContentLoaded', () => { const mainBtn = document.getElementById('main-btn'); // 此时可以安全访问 }); -
将 HTMLCollection 误当做 Array 进行 map/filter 操作:
HTMLCollection和NodeList属于类数组对象(Array-like),具有length和数字索引,但其原型链上并没有map、filter、reduce等方法。若直接调用会触发TypeError: ... is not a function。const items = document.getElementsByClassName('item'); // 推荐方案:使用 ES6 展开运算符或 Array.from() 进行显式类型转换 const itemTexts = [...items].map(el => el.textContent.trim()); -
忽视特殊字符的选择器转义:
使用
querySelector时,如果 ID 或类名中包含 CSS 保留符号(如点号、冒号、方括号,例如id="user:123"),直接传入querySelector('#user:123')会将冒号误解析为伪类导致报错。必须使用CSS.escape()进行转义:const rawId = 'user:123'; // 错误写法:document.querySelector('#' + rawId); // 报错! // 正确写法: const escapedSelector = '#' + CSS.escape(rawId); const target = document.querySelector(escapedSelector);
1. 唯一定位首选
getElementById:在有清晰 ID 标识且性能敏感的场景下,它的查找速度无与伦比。2. 单一复杂匹配用
querySelector:语法优雅、表达能力强大,利用截断机制保证效率。3. 批量元素操作首选
querySelectorAll:静态快照机制能够规避循环增删 DOM 时的索引变动隐患,且原生支持 .forEach()。4. 超大批量纯类名或标签名渲染场景:
getElementsByClassName 避免了 CSS 选择器编译开销,在底层循环性能微基准中仍占优势,但使用时需时刻注意其 Live 集合的更新特性。
JS获取屏幕高度:innerHeight、clientHeight与scrollHeight的区别
2026-11-18 18:14:26
JS获取radio选中项对应的label文本内容
2026-11-18 13:29:03
JS中parentNode与parentElement有什么区别
2026-11-18 12:51:00
JS修改CSS样式的三种核心方法:style、className与classList对比
2026-11-18 08:17:25
JS批量设置多个表单字段为只读
2026-11-18 08:07:01







