JS强制刷新页面清除缓存的常用方法
详解JavaScript强制刷新页面与绕过浏览器缓存的常用方法,包括URL动态参数、location.reload局限、fetch缓存策略、Cache Storage与Service Worker清理步骤及服务端配合要点。
出于安全隔离考虑,浏览器没有向网页中的 JavaScript 提供“一键清空所有本地 HTTP 磁盘缓存”的接口。前端常说的“JS 强制刷新页面清除缓存”,实际是通过变更请求 URL 参数、设置 fetch 缓存模式或清理 Cache Storage 与 Service Worker,让浏览器绕过旧副本并重新向服务器获取最新资源。下文按适用场景依次说明具体写法、执行前提和常见误区。
先搞清楚浏览器为什么会继续使用旧页面
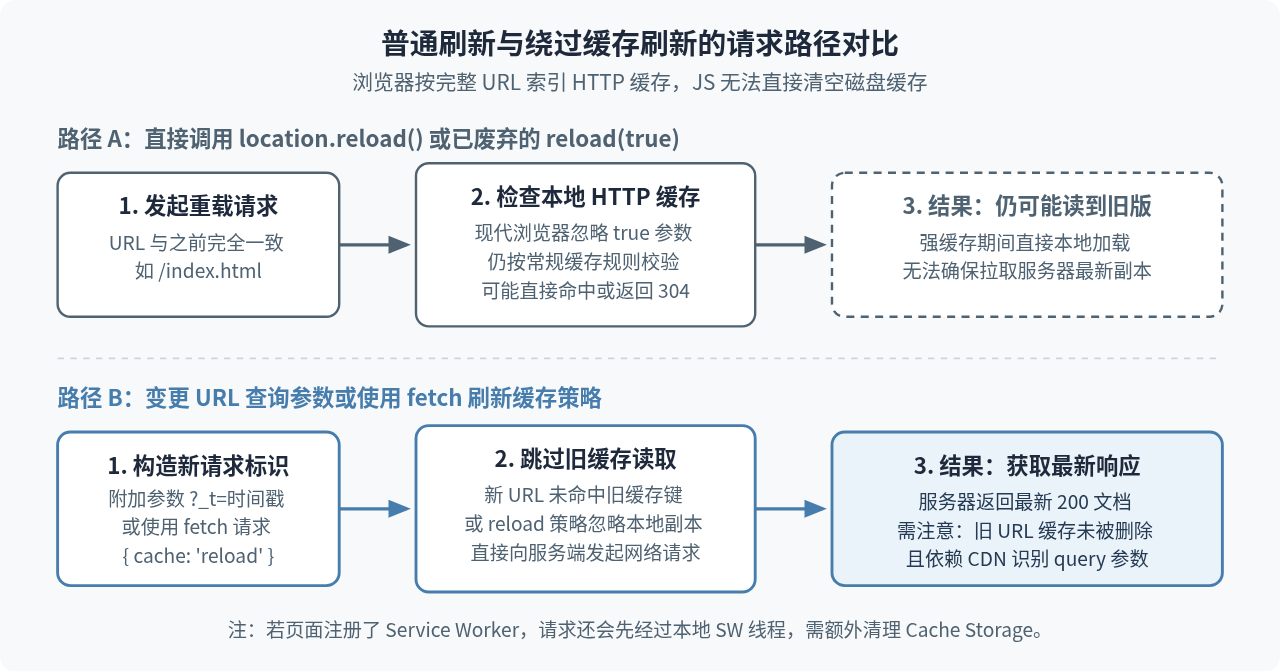
浏览器保存 HTTP 缓存时,通常以完整请求 URL(包含路径与查询参数)作为索引键。如果服务器返回的响应头带有 Cache-Control: max-age=...,在有效期内再次访问同一地址,浏览器会直接从本地读取副本而不再联网校验;即使进入协商缓存阶段,浏览器也可能仅收到 304 Not Modified。
这也是很多人在代码里调用 window.location.reload() 后依然看到旧内容的原因。要让页面真正获取新版本,必须让浏览器认定“这是一次新请求”,或者先更新本地缓存中的对应条目。
通过 URL 添加动态时间戳或版本号(最通用)
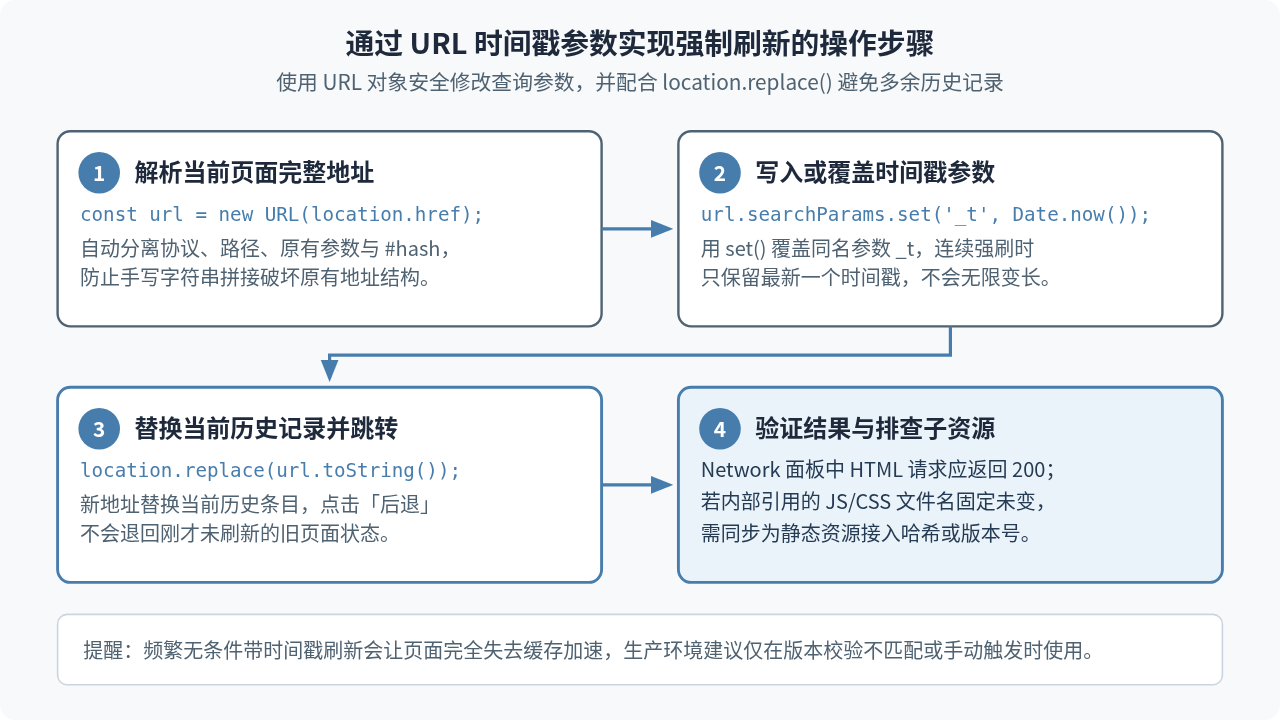
在当前页面 URL 后面附加一个会变化的参数(常见为时间戳 Date.now() 或发布版本号),是兼容性最广、最直接的绕过缓存方式。由于查询字符串改变后 URL 成为全新的缓存键,浏览器不会读取之前缓存的 HTML 文档。
实际编写时,建议用标准 URL 对象操作参数并配合 window.location.replace() 跳转,避免直接字符串拼接导致出现多个 ? 或重复追加多个 _t 参数,也避免在浏览器历史记录里留下一串无效旧记录。
// 在浏览器页面脚本中执行:为当前地址写入最新时间戳并替换跳转
function forceRefreshWithTimestamp() {
  const url = new URL(window.location.href);
  url.searchParams.set('_t', String(Date.now()));
  window.location.replace(url.toString());
}

// 调用示例:例如在检测到版本更新或用户点击「刷新最新版本」按钮时触发
// forceRefreshWithTimestamp();执行后页面跳转到
https://example.com/report?tab=2&_t=1731336500123#summary,原有参数 tab=2 与锚点 #summary 均会保留;打开浏览器开发者工具 Network 面板查看文档请求,状态应为 200 而非 200 (from disk cache)。
同样的思路也适用于动态加载的 JavaScript、CSS 或图片资源。如果页面中需要通过脚本重新拉取某个配置文件或样式表,可以把构建版本号或时间戳拼在资源地址后面:
// 动态插入带版本号的脚本,避免命中旧版 JS 缓存
function loadFreshScript(src, version) {
  const url = new URL(src, window.location.origin);
  url.searchParams.set('v', version || String(Date.now()));

  const script = document.createElement('script');
  script.src = url.toString();
  document.head.appendChild(script);
}_t 访问原地址,依然可能命中旧缓存;第二,如果网站前方接入了 CDN 且配置了“忽略查询参数(Ignore Query String)”,更改 ?_t=... 后 CDN 仍可能直接返回旧节点缓存,此时需要在 CDN 规则中开启按查询参数回源,或采用文件名哈希(如 app.8f3a1c.js)。
为什么不要依赖 location.reload(true)
许多早期教程会推荐 window.location.reload(true),认为传入 true 就能强制浏览器从服务器重新下载页面。这个参数最初属于部分浏览器(如早期 Firefox)的非标准扩展,用于指示浏览器绕过缓存重新获取当前文档。
在现代 HTML 规范中,location.reload() 不再接受强制刷新参数;主流浏览器(Chrome、Edge、Safari 以及新版 Firefox)都会忽略传入的布尔值,location.reload(true) 与不传参的 location.reload() 行为完全相同。在 TypeScript 项目中,新版 DOM 类型定义也已将其标记为只接受零参数或废弃写法。
因此,只有在“页面已经靠服务端响应头或版本号控制好缓存,单纯需要重新执行当前页面”时,才使用无参的 window.location.reload();如果目的是绕过强缓存,不应再依赖 reload(true)。
利用 fetch 缓存策略更新副本或检测新版本
如果不想修改地址栏参数,或者希望在后台先确认服务器是否有新版本后再刷新页面,可以使用 fetch() 的 cache 配置项。它主要有两种实用用法:
用 cache: 'reload' 更新浏览器对当前 URL 的缓存
将 cache 设为 'reload' 时,浏览器不会读取本地已有缓存,而是直接向服务器发起请求,并用拿到的新响应替换本地缓存中该 URL 的副本。随后再调用 location.reload(),页面就更有机会读取到刚写入的新文档。
// 在同源页面中执行:先刷新当前文档在 HTTP 缓存中的副本,再重载页面
async function refreshDocumentCacheAndReload() {
  try {
    await fetch(window.location.href, {
      method: 'GET',
      cache: 'reload',
      credentials: 'same-origin'
    });
  } catch (err) {
    // 网络异常时记录日志,视业务决定是否继续重载
    console.warn('更新缓存失败,尝试直接重载:', err);
  }
  window.location.reload();
}
需要注意这种方法的作用范围:它只更新了 window.location.href 这一份 HTML 文档的缓存,页面内引用的外部 JS、CSS 如果仍然使用固定文件名且处于强缓存有效期内,还是需要配合资源版本号或构建哈希来更新。
用 cache: 'no-store' 检测版本后再刷新(适合单页应用)
对于 React、Vue 等单页应用(SPA),用户长期停留在页面不关闭时,发布新版本很容易因为旧 JS 找不到已被替换的异步 chunk 而报错。常见做法是在构建时生成一个极小的 version.json,前端用 cache: 'no-store' 定期比对版本号,确认变化后再提醒或执行跳转刷新。
// 假设构建产物根目录提供 /version.json,内容示例:{"version":"20261111.2"}
const CURRENT_VERSION = '20261111.1';

async function checkUpdateAndRefresh() {
  const res = await fetch('/version.json', { cache: 'no-store' });
  if (!res.ok) return;

  const data = await res.json();
  if (data.version && data.version !== CURRENT_VERSION) {
    const url = new URL(window.location.href);
    url.searchParams.set('_v', data.version);
    window.location.replace(url.toString());
  }
}
cache: 'no-store' 会指示浏览器既不从本地缓存读取,也不把本次响应写入缓存,确保每次检查拿到的都是服务端最新版本号。
清理 Cache Storage 与 Service Worker 缓存
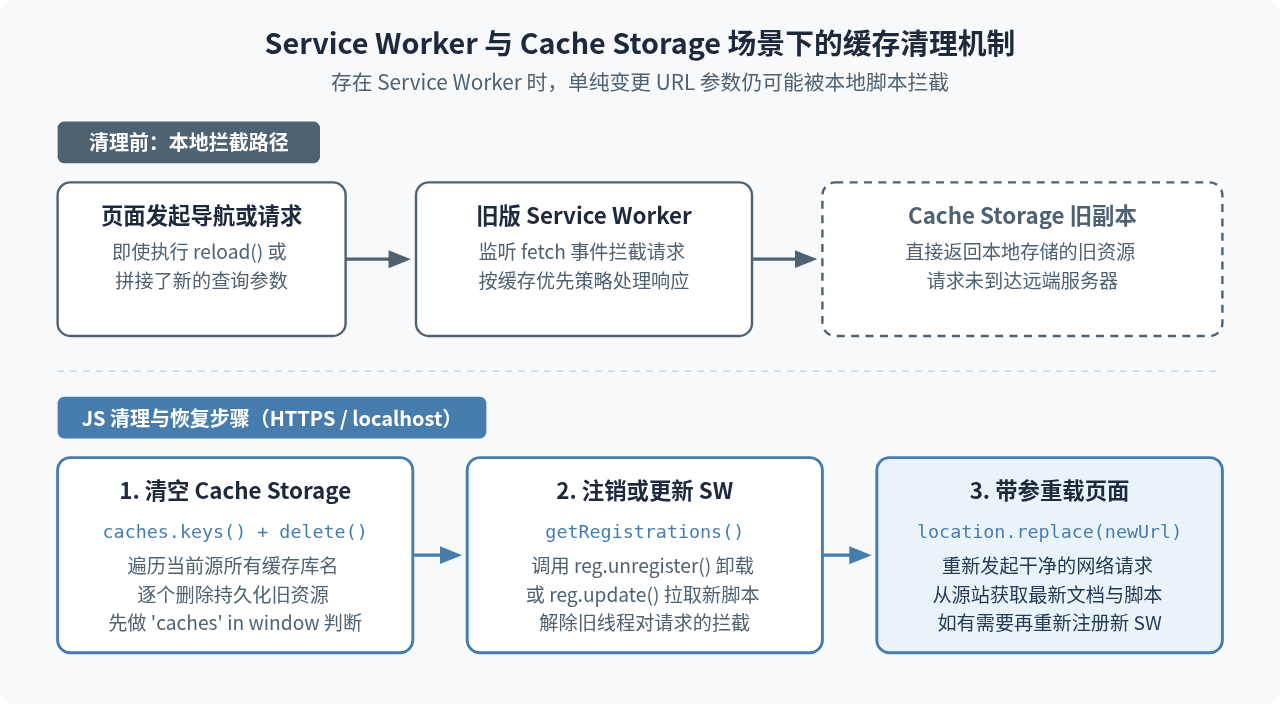
如果网站接入了 PWA(渐进式 Web 应用)或注册过 Service Worker,即使修改了 URL 参数甚至按下了浏览器的普通刷新键,网络请求依然可能先被本地运行的 Service Worker 线程拦截,并从 Cache Storage 中直接返回旧版本文件。
排查此类“怎么刷新都是旧页面”的问题时,可以通过 JavaScript 主动清空站点下的 Cache Storage,并检查更新或注销旧的 Service Worker,然后再重载页面:
// 需在 HTTPS 或 localhost 安全上下文中执行
async function clearPwaCachesAndReload() {
  // 1. 清空当前源下的所有 Cache Storage 缓存
  if ('caches' in window) {
    const cacheNames = await caches.keys();
    await Promise.all(cacheNames.map((name) => caches.delete(name)));
  }

  // 2. 注销已注册的 Service Worker(如只需触发更新检查,可改为 registration.update())
  if ('serviceWorker' in navigator) {
    const registrations = await navigator.serviceWorker.getRegistrations();
    await Promise.all(registrations.map((reg) => reg.unregister()));
  }

  // 3. 重新加载页面,让浏览器直接从网络获取最新资源
  const url = new URL(window.location.href);
  url.searchParams.set('_t', String(Date.now()));
  window.location.replace(url.toString());
}window.caches 与 navigator.serviceWorker 仅在安全上下文(https:// 协议或本地 localhost / 127.0.0.1)中可用。在普通 http:// 非本机域名下,这两个对象会是 undefined,因此代码中需要先做特性判断。
避免旧页面反复出现的服务端与前端配合
如果每次发版都要靠客户端 JS 强制刷新,往往意味着入口 HTML 本身被设置成了强缓存。一旦旧版 HTML 里引用的就是旧版 JS,甚至连“触发强制刷新的新逻辑”都不会被用户加载到。
- 入口 HTML 禁用强缓存:在 Nginx、CDN 或后端服务中,为
index.html等入口文档设置响应头Cache-Control: no-cache, must-revalidate(或no-store)。这样浏览器每次打开页面都会先向服务器校验文档是否有更新,不需要靠 JS 补救。 - 静态资源使用内容哈希命名:JS、CSS 和图片通过构建工具生成带哈希的文件名(如
main.c4a91b.js)并配合长期缓存。新 HTML 自动指向新的哈希文件名,无需手动加时间戳。 - 不要把希望寄托在 HTML
<meta>标签上:在页面头部写<meta http-equiv="Cache-Control" content="no-cache">只能作为辅助提示,中间代理服务器(如 CDN)和多数现代浏览器主要依据真实 HTTP 响应头控制缓存,无法替代服务端配置。
不同场景下的方法选择总结
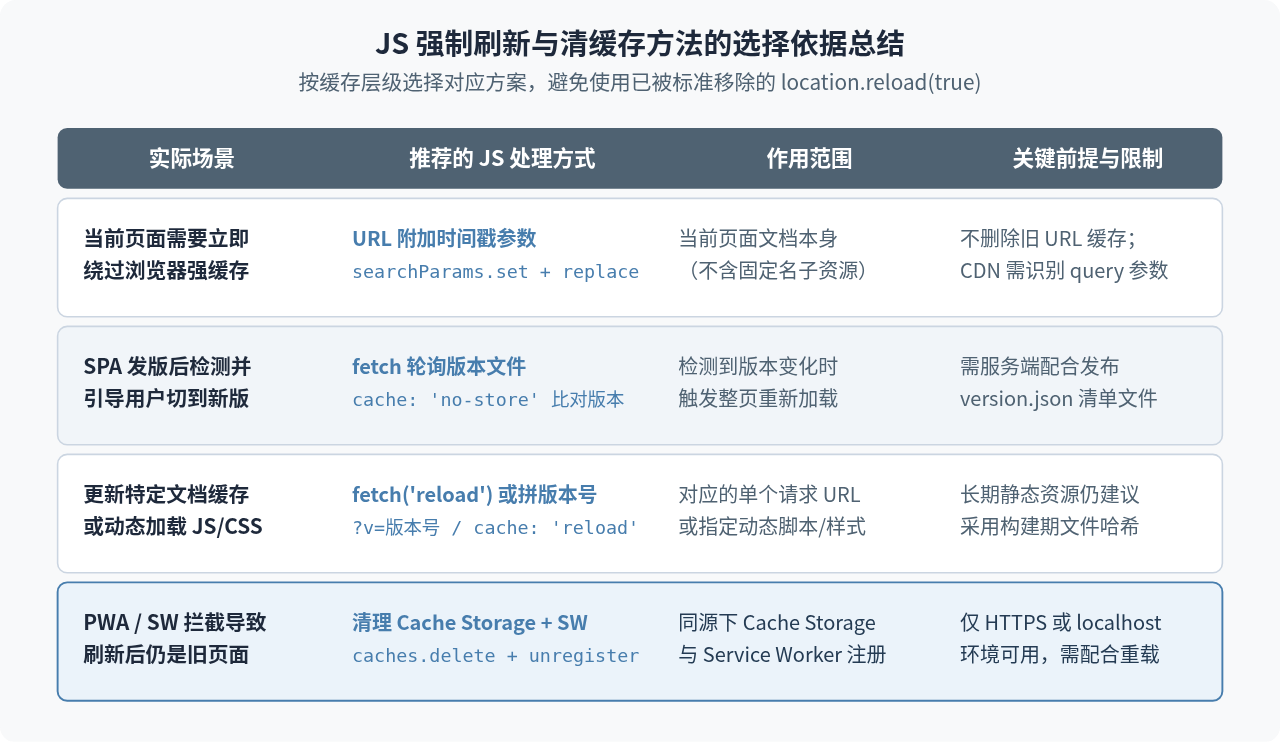
实际开发中应先定位缓存卡在哪一层,再挑选对应写法。下表汇总了常用 JS 方法的适用范围与限制条件,方便按需选用:
JavaScript中replaceAll与replace去除空格的性能差异
2026-11-17 23:12:34
JS DOM查询性能优化:缓存选择器结果与减少重排
2026-11-17 19:33:38
JS数组push、unshift、splice的性能差异与适用场景
2026-11-17 18:27:58
JS动画与高频渲染中requestAnimationFrame替代定时循环的实践
2026-11-17 10:50:00
手写JS快速排序比Array.prototype.sort更快吗?
2026-11-17 09:40:02