

JS数组push、unshift、splice的性能差异与适用场景
深入对比解析JavaScript中push、unshift与splice在底层内存排列、索引迁移机制上的性能差异,通过算法复杂度推导、基准场景代码与认知误区辨析,帮助开发者在日常与高性能场景做出合理的工程选型。
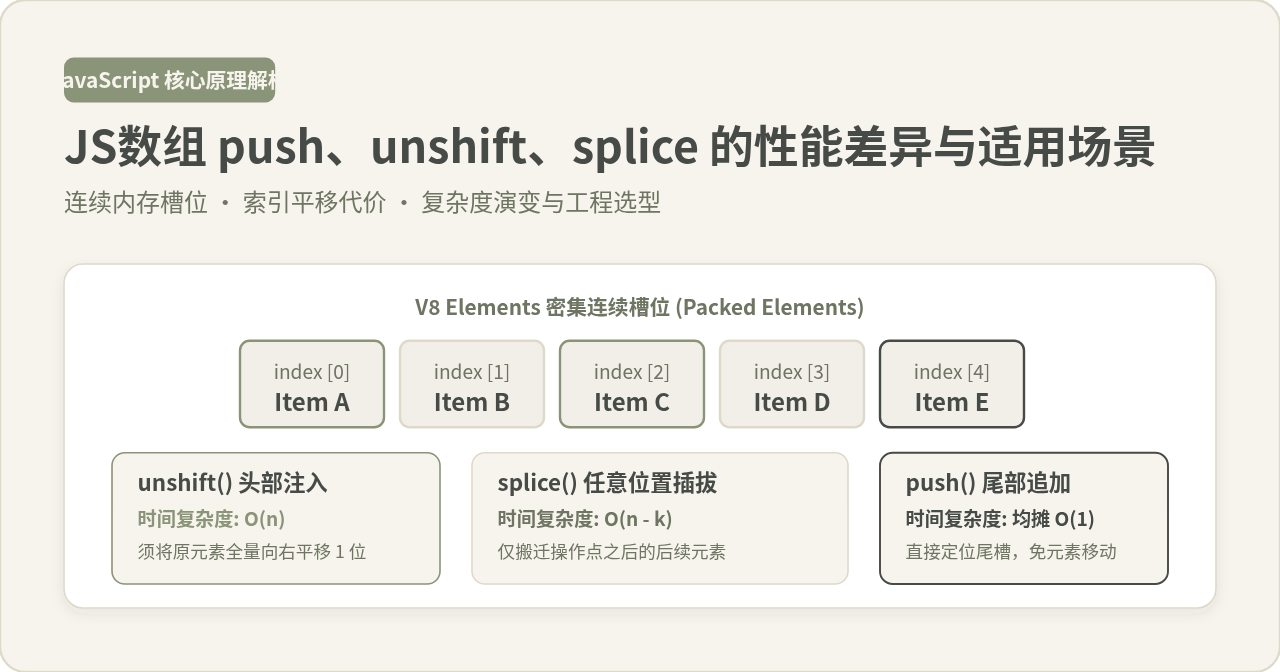
push、unshift 与 splice 最本质的性能差异来源于它们对底层连续物理内存和元素索引的处理逻辑。push 作用于数组尾部,通常只需在连续分配的缓冲区末端写入新指针,均摊时间复杂度为 O(1);unshift 作用于数组头部,为了在索引 0 腾出空间,必须将后续全部已有元素向后位移一位,时间复杂度为 O(n);splice 则根据指定索引切割并重排,必须整体搬移操作点之后的所有元素,时间复杂度为 O(n - index + k)。在百级以内的小规模数组中,三者的微秒级执行开销对交互无任何可感影响;但在万级数据量或高频循环体中,unshift 与中段 splice 会引发明显的二次方时间开销(O(N²))。本文将从底层内存原理、推导模型、认知误区辨析以及工程替代实践展开完整解析。
一、底层机制:连续内存与元素索引的搬移代价
JavaScript 是一门高级动态语言,但在主流现代引擎(如 Chrome 与 Node.js 搭载的 V8 引擎、Safari 的 JavaScriptCore 等)内部,标准的密集数组通常会被分配为连续的内存区域(在 V8 中称为 Packed Elements)。每个索引位置对应着紧密排列的指针或标量值。正是这种连续紧凑的内存布局,决定了不同位置插入与删除的物理代价差异。
1. push 的尾端写入与扩容机制
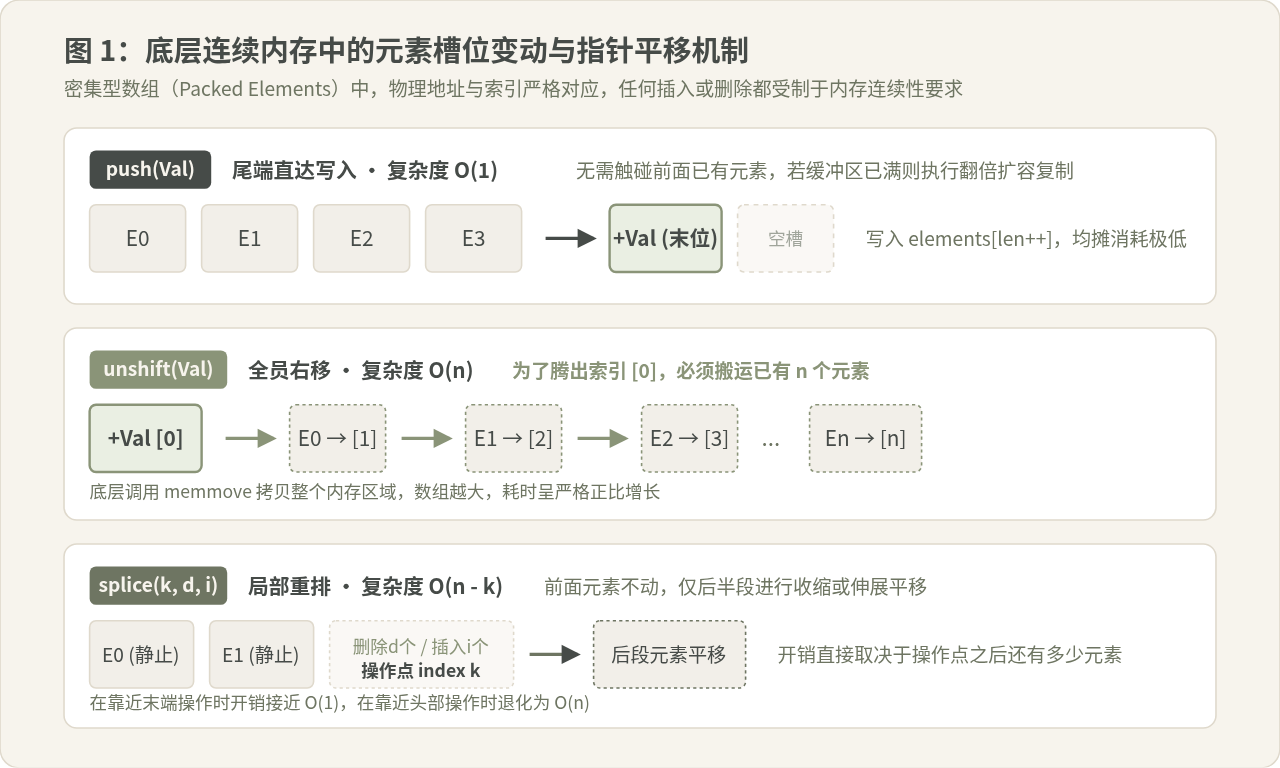
push 的设计目标是向数组末端追加一个或多个元素。由于引擎在底层为数组对象维护了当前长度 length 以及实际申请的底层缓冲区容量(Capacity),向尾部追加元素时,引擎只需通过 基址 + length * 指针步长 直接定位到目标内存单元并赋值,然后将 length 自增 1 即可。该过程完全不需要变更既有元素的物理地址与索引映射。
只有当预先申请的内存缓冲区被填满时,引擎才会触发重新分配(通常按倍数扩容,如 1.5 倍或 2 倍),申请一块更大的连续内存并将现有指针复制过去。因为扩容发生的频率随数组变长呈对数级衰减,所以其总体均摊复杂度(Amortized Time Complexity)稳定在 O(1)。
2. unshift 的头部插入与全量位移
unshift 负责向数组索引 0 的位置注入新项。因为数组要求索引必须从 0 开始严格连续递增,在没有额外偏移指针优化的场景下,若要在索引 0 插入数据,就必须把原先处于 0 到 length - 1 的全部现有元素,整体向后推移一个位置(原本索引为 i 的元素变为 i + 1)。
在底层实现中,引擎必须调用类似于 C 标准库中的 memmove 内存拷贝操作,将整个内存数据段向高地址方向平移。每次调用 unshift,搬移的指针数量与当前数组现存长度 n 完全相等,因此其时间复杂度为无条件的 O(n)。
3. splice 的任意位置插拔与后段搬移
splice(start, deleteCount, ...items) 是功能最灵活的数组变更方法,可同时完成“在任意位置删除指定数量元素”与“在该位置插入若干新元素”。其执行过程分为三个阶段:
- 前半段保持不动:索引从
0到start - 1的元素完全不受影响,保持在原内存槽位。 - 计算后半段位移差值:计算
items.length - deleteCount的差值。若差值为正,说明元素总数增加,操作点之后的元素需要整体向后平移;若差值为负,说明元素总数减少,操作点之后的元素需要整体向前收缩平移以填补空洞。 - 写入新项并重置 length:在腾出或预留出的
start槽位写入新元素,最终更新数组长度。
因此,splice 的时间开销与操作位置紧密相关:如果 start 处于数组最末端,其开销接近 push/pop 的 O(1);如果 start 接近 0,其开销等同于 unshift/shift 的 O(n)。综合时间复杂度可表述为 O(n - start + k)。
二、性能差异的量级演变与推导过程
单次操作的微秒级差异往往会被开发者忽视,但当这些操作被放置在批量导入、日志收集、网络轮询或高频任务队列的循环体内时,算法复杂度的鸿沟会迅速转化为灾难性的性能瓶颈。
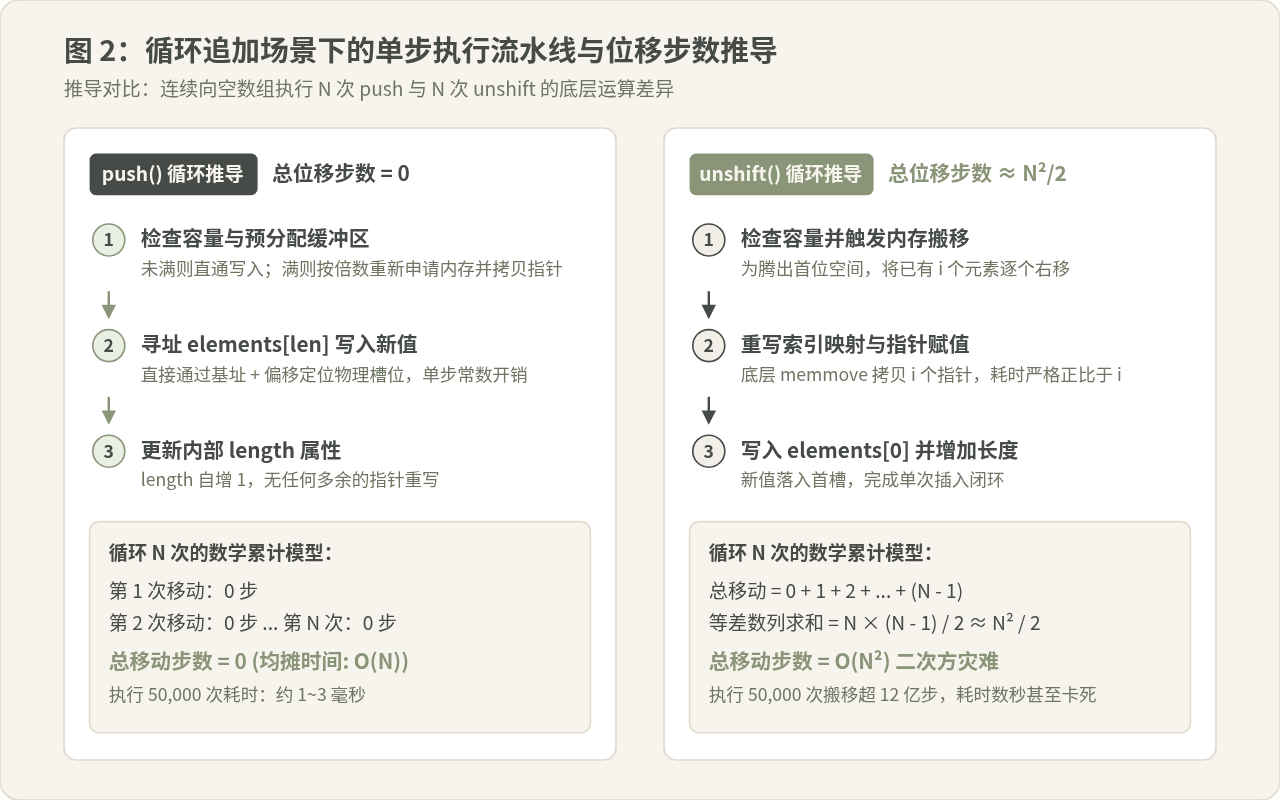
1. 循环追加 N 次的数学位移推导
假设我们有一个空数组,需要将外部流入的 N 条数据依次追加进去:
- 使用 push 累积:每次 push 均只需直接落入尾槽,没有任何元素需要位移。
N次 push 的元素总位移步数为0 + 0 + ... + 0 = 0。哪怕计入偶发的容量倍增指针拷贝,总耗时依然与N呈线性关系,算法耗时为 O(N)。 - 使用 unshift 累积:第 1 次插入移动 0 步,第 2 次插入移动 1 步,第 3 次插入移动 2 步……直至第
N次插入需要移动N - 1步。底层累计移动步数构成了一个典型的等差数列:
S = 0 + 1 + 2 + ... + (N - 1) = N * (N - 1) / 2 ≈ N² / 2。
这意味着单次 O(n) 的操作在循环体中被放大成了 O(N²) 的二次方级运算。
2. 基准测试场景代码与耗时对比
为了直观展现这一推导结果,以下提供一段在标准 Node.js 或现代浏览器控制台中均可直接执行的验证代码。代码分别测试 5 万次循环追加与 5 万次中段 splice 插入的实际执行耗时:
// 环境要求:Node.js 18+ 或 Chrome / Firefox / Safari 开发者控制台
// 目标:对比循环向空数组追加 50,000 个元素时不同方法的耗时表现

const COUNT = 50000;

// 1. 测试 push (尾部追加)
const arrPush = [];
console.time('[Benchmark] push 5万次');
for (let i = 0; i < COUNT; i++) {
  arrPush.push(i);
}
console.timeEnd('[Benchmark] push 5万次');

// 2. 测试 unshift (头部插入)
const arrUnshift = [];
console.time('[Benchmark] unshift 5万次');
for (let i = 0; i < COUNT; i++) {
  arrUnshift.unshift(i);
}
console.timeEnd('[Benchmark] unshift 5万次');

// 3. 测试 splice (中段插入)
const arrSplice = [];
console.time('[Benchmark] splice(中间) 5万次');
for (let i = 0; i < COUNT; i++) {
  const mid = Math.floor(arrSplice.length / 2);
  arrSplice.splice(mid, 0, i);
}
console.timeEnd('[Benchmark] splice(中间) 5万次');[Benchmark] push 5万次: 2.15ms
[Benchmark] unshift 5万次: 1680.42ms
[Benchmark] splice(中间) 5万次: 792.18ms
测试结果显示:在 5 万次数据规模下,push 仅需约 2 毫秒;而在中间插入的 splice 耗时接近 0.8 秒;头部插入的 unshift 耗时飙升至 1.6 秒以上,两者相差数百倍。这一测试切实印证了数学推导中 N²/2 与 N 之间的悬殊差距。
三、常见认知误区与边界辨析
在工程讨论中,围绕数组性能常常存在一些片面或容易走极端的观点。理清这些说法背后的适用前提,能帮助我们在代码整洁度与执行效率之间找到最佳平衡。
误区一:“unshift 性能太差,工程代码中必须彻底杜绝?”
对于一个长度为 10 的配置列表,向其首位 unshift 一个“全部”选项,引擎底层仅需移动 10 个指针,耗时在十几个纳秒级别,用户完全不可能感知。此时 unshift 能够清晰表达“置顶新项”的业务语义;如果强行为了“优化”而先 reverse() 再 push() 再 reverse(),反而凭空增加了代码维护成本与理解心智负担。因此:禁止在万级大数组或高频循环中使用 unshift,但在百级以内的低频离散操作中,完全可以放心使用。
误区二:“V8 优化极强,小数据量下三者没有任何性能差异?”
这种观点之所以产生,是因为现代 CPU 配备了极速的 L1/L2 缓存以及单指令多数据流(SIMD)加速指令,对数十字节小内存块的 memmove 复制几乎能在一个时钟周期内完成,使得表面测试呈现出“耗时均为 0ms”的假象。
但这绝不意味着算法复杂度被抹平了。如果在组件开发初期因数组长度小而随意在循环中使用 unshift,一旦后续业务变更引入了“无限滚动”、“全量历史数据导出”或“长连接消息推送”,数据规模由几十项悄然膨胀至几千上万项,原本潜伏的二次方复杂度就会瞬间引爆,导致界面直接掉帧甚至失去响应。理解底层原理的价值正在于能够预见数据增长带来的性能拐点。
误区三:“splice 仅仅删除一个元素(deleteCount=1),不插入任何新值,为什么不能像 pop 那样快?”
很多开发者认为“我不插入新元素,只是删一个,应该很快”。但如前所述,JavaScript 数组是连续密集的。pop 只需要将末尾有效索引递减 1,物理槽位无须向前填补;而当执行 splice(i, 1) 时,为了防止数组在索引 i 处留下空洞(Holey Elements),从 i + 1 到最后一个元素的所有指针,都必须强制向前位移 1 个单位。如果数组有一万项而你在索引 0 处删除了一个元素,仍然要搬运 9,999 个指针。因此删除操作同样受制于 O(n - index) 的后段搬移法则。
四、性能敏感场景下的工程替代方案
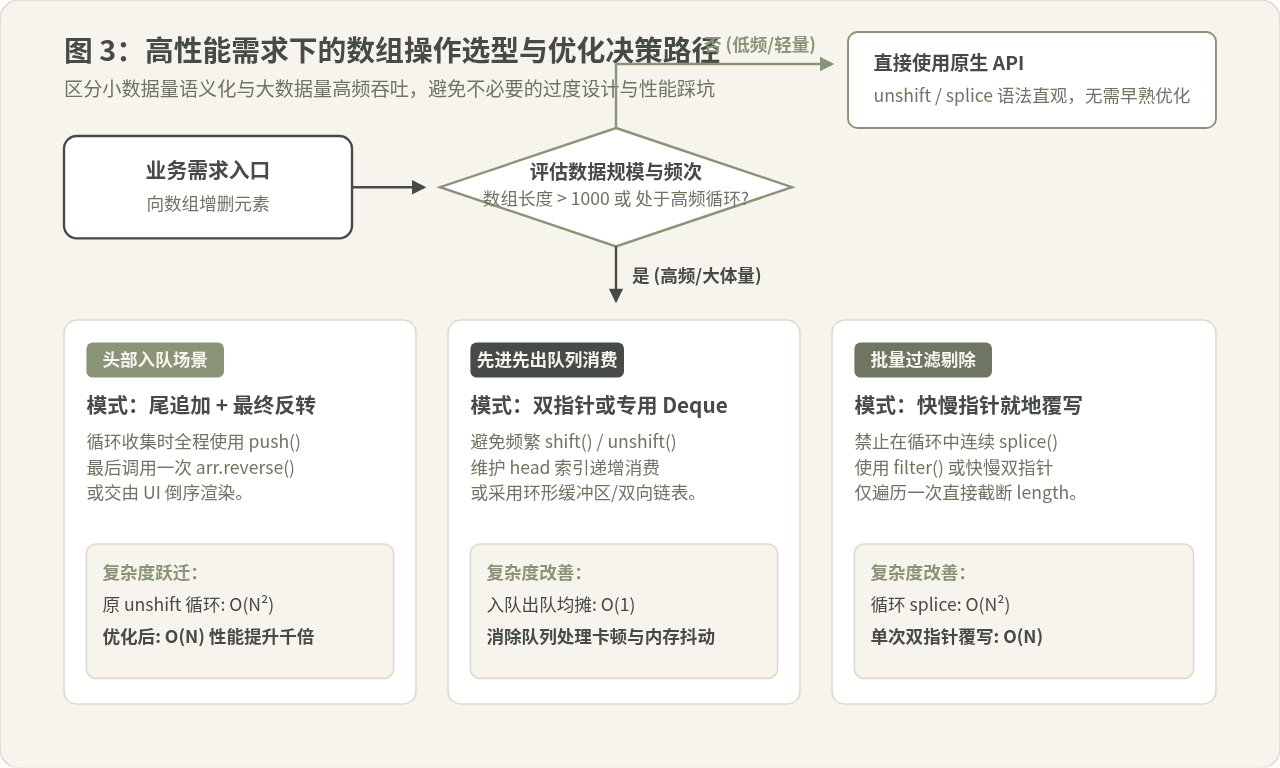
当业务确实面临大容量数据、高频吞吐或实时流处理时,我们可以通过改变数据处理范式,绕开 unshift 和 splice 的连续内存搬迁瓶颈。
方案 1:尾部追加 + 一次性反转(替代循环 unshift)
当需要将多批次外部数据以“倒序”形式组织时,不要在循环体中逐项 unshift。正确的做法是全程使用 push 收集,在数据流接收完毕后,调用一次 reverse(),或者直接在前端视图渲染层通过反向遍历呈现:
// 优化前:耗时 O(N²) 的反模式
function collectLogsSlow(stream) {
  const list = [];
  for (const item of stream) {
    list.unshift(item); // 频繁头部平移
  }
  return list;
}

// 优化后:耗时 O(N) 的高效模式
function collectLogsFast(stream) {
  const list = [];
  for (const item of stream) {
    list.push(item);    // O(1) 尾部写入
  }
  return list.reverse(); // 单次 O(N) 双指针原地对调
}
方案 2:双指针游标(模拟先进先出 FIFO 队列)
若业务需要一个先进先出的缓冲队列(如网络请求重试队列、动画帧调度器),使用 push() 入队结合 shift() 出队会导致每次出队都引发全员前移。可以使用一个 head 索引指针记录当前读取位置,当出队元素累积到一定阈值时再做批量回收:
class FastQueue {
  constructor() {
    this.items = [];
    this.head = 0;
  }

  enqueue(val) {
    this.items.push(val); // O(1)
  }

  dequeue() {
    if (this.head >= this.items.length) return undefined;
    const item = this.items[this.head++];
    // 延迟重整:当已消耗数量超过一半且达到规模时裁剪数组
    if (this.head > 1000 && this.head * 2 >= this.items.length) {
      this.items = this.items.slice(this.head);
      this.head = 0;
    }
    return item;
  }
}
方案 3:双指针就地覆写(替代循环中的多次 splice)
在数组中根据条件批量过滤或剔除元素时,若采用遍历并针对符合条件的项调用 splice(i, 1),不仅极易引发索引越界或漏判错误,还会导致每次删除都执行一次内存后移,总体复杂度为 O(N²)。改用原生 filter 或双指针原地覆写能够以单一遍 O(N) 完成:
// 批量就地剔除满足条件的项:单次 O(N) 线性遍历
function removeInPlace(arr, predicate) {
  let writeIndex = 0;
  for (let readIndex = 0; readIndex < arr.length; readIndex++) {
    if (!predicate(arr[readIndex])) {
      arr[writeIndex++] = arr[readIndex];
    }
  }
  arr.length = writeIndex; // 截断数组长度,无多余元素平移
}
五、适用场景与选型决策全景总结
为了帮助读者在日常开发与架构设计中快速确立清晰的选型标准,下表汇总了这三个核心方法在操作位置、复杂度特征、内存影响及适用范围上的关键维度:
| 方法 | 物理操作位置 | 单次时间复杂度 | 循环调用累计开销 | 内存与指针变动 | 推荐适用场景 | 慎用/避免场景 |
|---|---|---|---|---|---|---|
| push | 数组最尾部 | 均摊 O(1) | O(N) 线性 | 无需移动既有项,满额时倍数扩容 | 数据累加、日志收集、栈结构入栈、各种批量汇聚 | 无明显性能风险,优先推荐 |
| unshift | 数组最头部 (index 0) | 严格 O(n) | O(N²) 二次方 | 整段内存全量右移,触发连续 memmove | 小于 100 项的小数组置顶项、单次轻量级 UI 数据插入 | 长数组循环入队、高频数据流写入、消息队列 |
| splice | 任意指定索引位置 | O(n - index + k) | 视频次与位置在 O(N)~O(N²) 浮动 | 操作点之后的所有元素进行伸缩平移 | 明确索引的单项剔除、拖拽就地插拔排序、局部替换 | 遍历循环中连续多次 splice 批量删除项 |
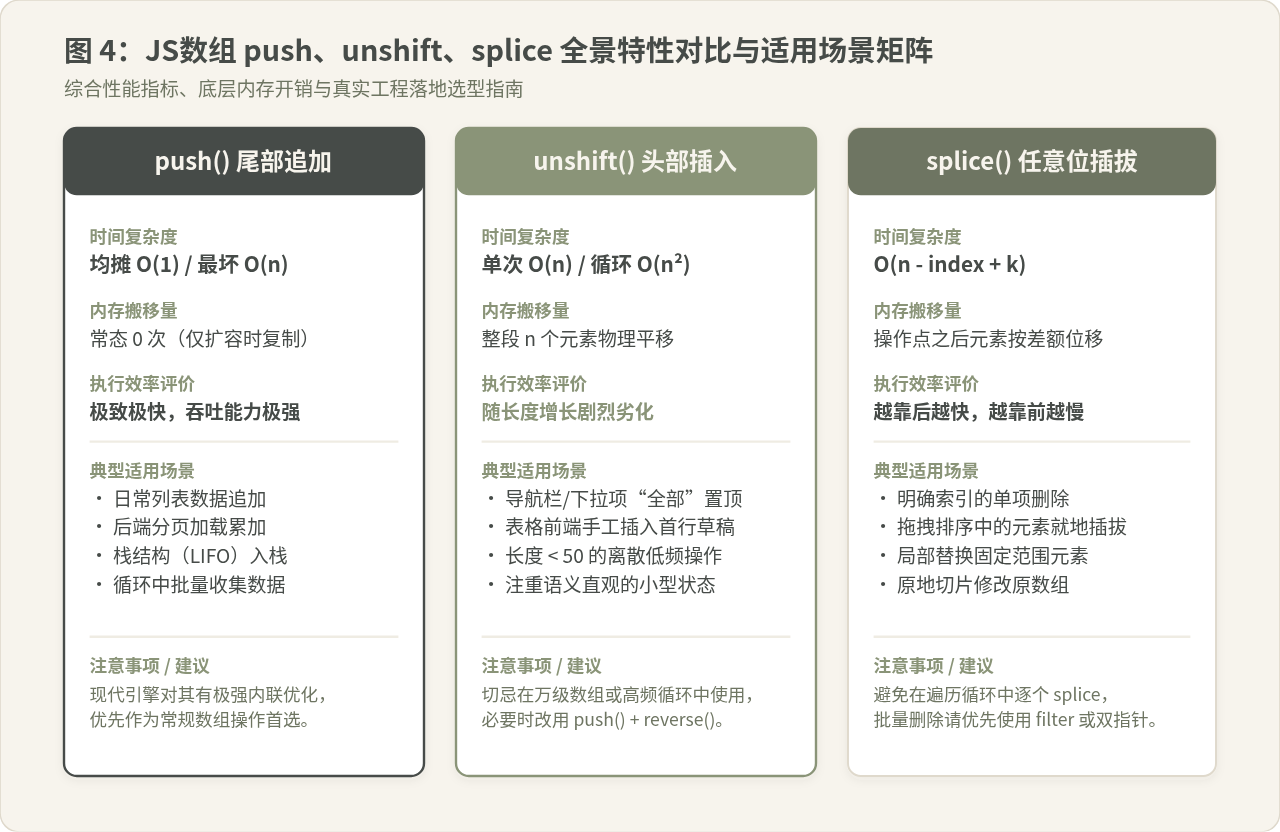
归根结底,JavaScript 数组的高阶抽象赋予了开发者极高的灵活性,但其底层仍然运行在连续内存槽位的物理法则之上。掌握 push、unshift 与 splice 在不同槽位上的平移成本,不在于将所有代码都写成极致的底层优化,而在于清晰理解边界:在小规模低频场景下尊重语义直观,在大规模高频场景下遵循算法规律,从而写出既高可读又健壮高效的代码。
JS动画与高频渲染中requestAnimationFrame替代定时循环的实践
2026-11-17 10:50:00
手写JS快速排序比Array.prototype.sort更快吗?
2026-11-17 09:40:02
JavaScript三目运算符返回值类型不一致的常见陷阱
2026-11-17 08:49:48
Node.js中怎么高效格式化大型JSON文件避免内存溢出
2026-11-17 08:02:15
n8n 1.123.97的安全扫描维护应怎样理解,哪些部署需要评估
2026-11-16 17:29:40







