

JS怎么用正则表达式查找字符串?search与match区别解析
深入解析JavaScript中用正则表达式查找字符串的核心方法,对比String.prototype.search与String.prototype.match在返回值、全局标志g、捕获分组与性能上的本质区别,提供详尽代码示例与避坑指南。
String.prototype.search() 和 String.prototype.match()。简言之:search() 专用于“定位位置”,返回首个匹配子串的字符索引数字或 -1;而 match() 专用于“提取文本”,根据是否携带全局修饰符 g,返回包含捕获组详情的类数组或全部匹配子串构成的扁平数组。理解两者的返回值结构、对修饰符的处理机制及边界表现,能够帮助我们在日常开发中准确做出选型。
一、JS 中用正则表达式查找字符串的核心方式
JavaScript 提供了两套配合正则表达式查找字符串的 API:一类是定义在 RegExp 实例上的方法(如 test() 与 exec()),另一类是直接挂载在 String 原型上的方法(如 search()、match() 以及现代标准补充的 matchAll())。在实际开发中,直接在目标字符串上调用方法更为符合自然语言与直觉习惯。
当我们要对一段字符串执行正则查找时,通常面临两种截然不同的业务诉求:
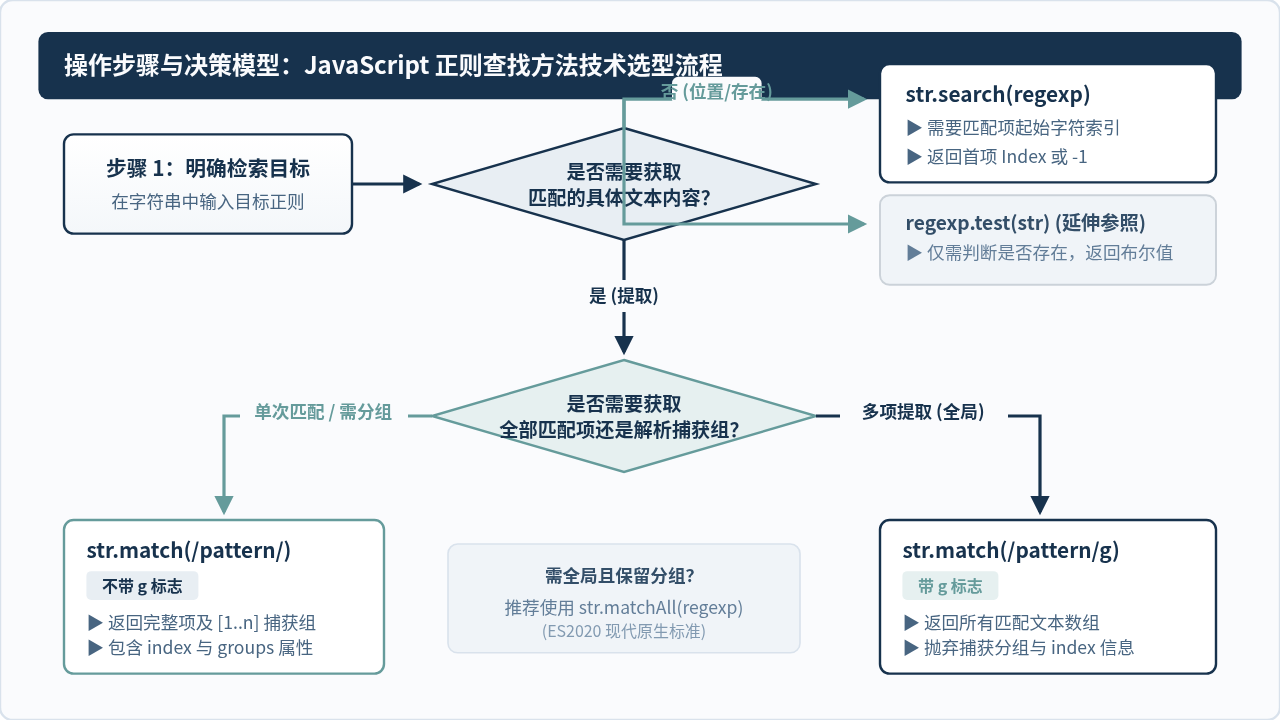
- 诉求 A(位置与存在性):我们只需要知道模式是否出现在字符串中,或者需要获取它出现的字符起始下标,以便后续使用
slice()或substring()进行截取。 - 诉求 B(内容提取与解析):我们需要把匹配的具体内容拿出来,甚至需要提取括号分组(Capturing Groups)里的子字段,或者获取整篇文本中所有符合规则的子串列表。
二、String.prototype.search():定位索引与快速检索
search() 方法接受一个正则表达式作为参数,在调用该方法的字符串中进行检索。它的执行目标非常纯粹:寻找第一个匹配项的起始索引位置。
1. 基本语法与返回值说明
const str = "order-2026-xyz";
const index = str.search(/\d+/);
console.log(index); // 输出:6(首个数字出现在字符下标 6 处)
关于 search() 的返回值,有以下两项确定性规则:
- 匹配成功:返回匹配项在整个源字符串中首次出现的数字索引(从
0开始计算)。 - 匹配失败:返回固定数值
-1。
2. 忽略全局修饰符 g 的内部机制
很多开发者初学时会尝试给 search() 传入带有全局修饰符 g 的正则表达式(例如 str.search(/\d+/g)),期望能得到所有匹配项的位置数组。但事实上,search() 会完全忽略 g 修饰符。无论是否加上 g,它都只在找到第一个匹配项后立即停机并返回该位置。
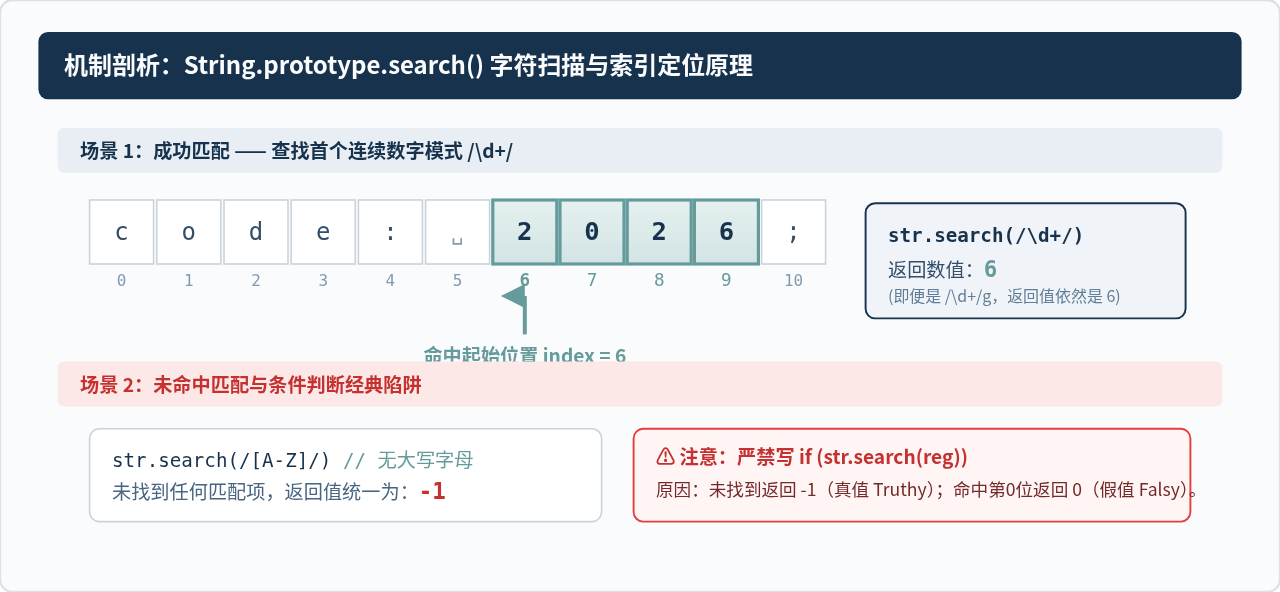
在编写条件判断时,新手极易写出
if (str.search(/pattern/)) { ... }。这是一个非常隐蔽的逻辑 Bug:
- 如果模式刚好在字符串开头(索引为
0)命中,JavaScript 会将0判定为falsy,导致本该命中的分支无法进入! - 如果完全没有匹配项,
search()返回-1,但在 JS 中-1属于非零数值,会被判定为truthy,反而进入了分支!
if (str.search(/pattern/) !== -1) { ... }。
三、String.prototype.match():捕获与提取匹配内容
与仅提供数字位置的 search() 相比,match() 承担的是“数据提取”的职责。它的行为会根据正则表达式是否携带 g(Global 全局修饰符)产生根本性的变化。
1. 模式一:非全局模式(不带 g 修饰符)
当正则表达式没有 g 标志时,match() 只查找第一个匹配项,但会返回一个内容极其丰富的类数组对象(Array Object),它完整记录了匹配的细节:
[0]:匹配到的完整子字符串。[1] ... [n]:正则表达式中各个圆括号()所捕获的分组文本(若未捕获则为undefined)。index属性:完整匹配在源字符串中的起始字符索引。input属性:被检索的原始源字符串引用。groups属性:如果使用了具名捕获组(?<name>...),该属性会包含一个以组名为键的对象;否则为undefined。
const log = "2026-03-15 task finished";
const result = log.match(/(\d4)-(\d2)-(\d2)/);

console.log(result[0]);      // "2026-03-15" (完整匹配)
console.log(result[1]);      // "2026" (分组 1: 年)
console.log(result[2]);      // "03"   (分组 2: 月)
console.log(result[3]);      // "15"   (分组 3: 日)
console.log(result.index);   // 0 (起始位置)
2. 模式二:全局模式(携带 g 修饰符)
一旦为正则表达式添加了 g 标志,match() 的工作模式将彻底转变:它会遍历整段字符串,把所有满足规则的子串依次提取出来,返回一个扁平的纯文本字符串数组。
关键转折:在全局模式下,match() 会丢弃所有捕获组信息,也不会在数组上挂载 index、input 和 groups 属性!
const text = "价格:¥128,优惠后:¥99,运费:¥0";
const prices = text.match(/¥(\d+)/g);

console.log(prices);
// 输出:["¥128", "¥99", "¥0"]
// 注意:小括号中的数字并未单独作为捕获组拆出,且数组无 index 属性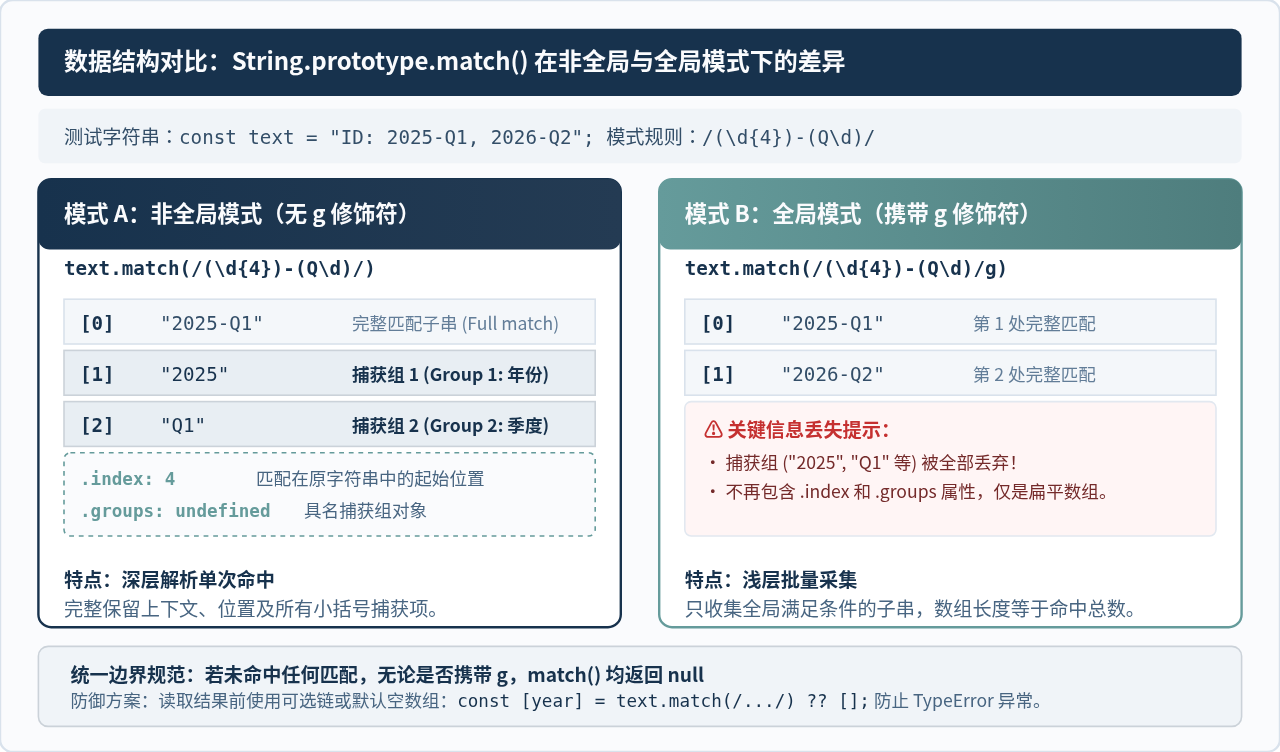
当没有任何文本满足正则规则时,
match() 会返回 null(而不是空数组 [])。如果直接对其进行解构或访问长度属性,会引发运行时崩溃:
// 危险写法:如果未匹配,立即抛出 TypeError: Cannot read properties of null
const [full, year] = str.match(/(\d4)/);

// 安全防范写法:使用空值合并操作符 ?? 赋予默认空数组
const [full, year] = str.match(/(\d4)/) ?? [];
四、search 与 match 的本质区别深度解析
为了在实际开发中准确选型,我们需要从四个核心维度对比两者的差异:
| 比较维度 | String.prototype.search() | String.prototype.match() |
|---|---|---|
| 返回值语义 | 位置定位:返回首个匹配字符的索引(number)或 -1 | 内容获取:返回匹配文本数组(Array)或 null |
| 对修饰符 /g 的处理 | 完全忽略:仅查找首个匹配,无法全局推进 | 显著影响:无 g 返回详细首项;有 g 返回全局所有项 |
| 分组捕获 (Capturing) | 不支持:不保留任何子组内容 | 条件支持:仅在无 g 标志时输出各级捕获组内容 |
| 内存与执行性能 | 极轻量:内部只做字符指针计算,不创建子串对象 | 中等:需要分配数组内存,并对子串进行切片复制 |
| 未匹配时的判断 | 使用 result !== -1 判断 |
使用 result !== null 或可选链 result?.length |
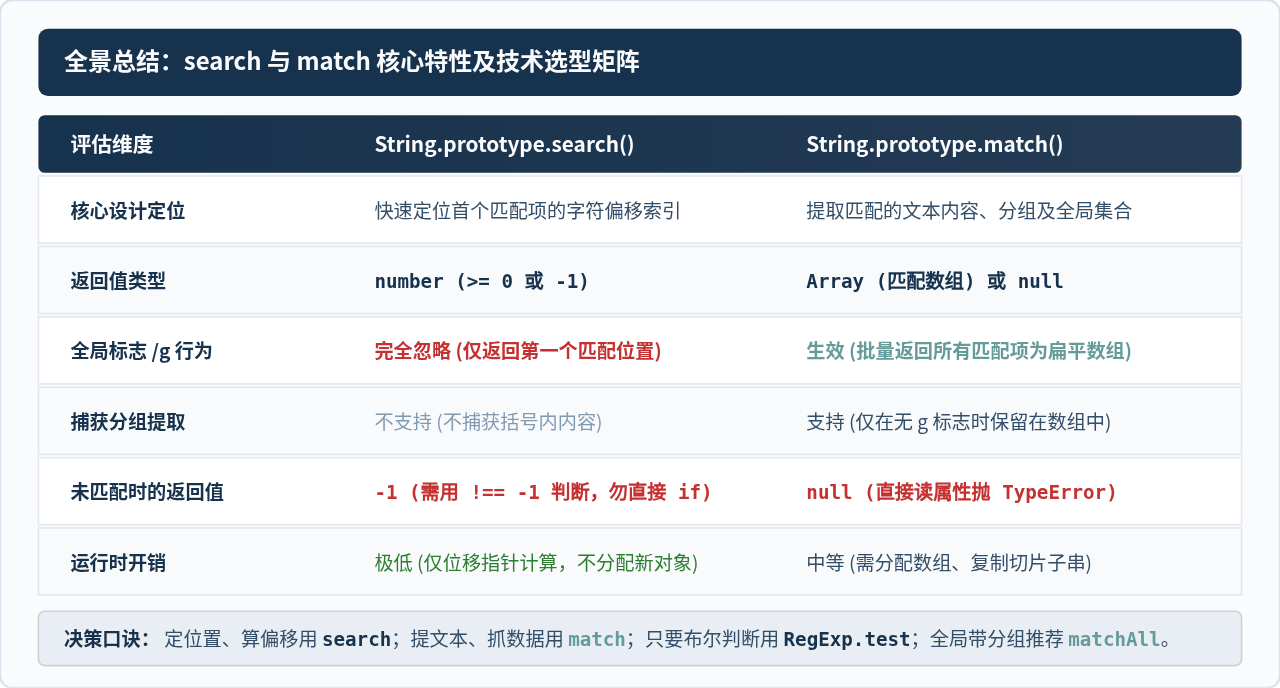
五、开发场景决策:如何选择最合适的查找方法?
结合以上特性,我们可以为具体业务场景梳理出一条清晰的决策路径:
1. 优先使用 search() 的场景
- 需要通过位置进一步切分字符串:例如我们需要从特定符号(如首个冒号、首个换行或特定标签)之后截取剩余字符串,使用
str.slice(str.search(/pattern/))最为精准直接。 - 轻量级索引检测:已经明确需要记录首次出现的字符偏移量,用于光标定位、文本高亮标记或偏移量计算。
2. 优先使用 match() 的场景
- 提取目标数据:例如从文本中抓取手机号、邮箱、身份证号或订单编号,需要拿到具体的字符串进行持久化或渲染。
- 解析复杂结构化文本:利用非全局模式下的捕获组
[1]、[2],一次性将日期分解为年、月、日,或将 URL 分解为协议、域名和路径。 - 统计或批量搜集:利用全局模式
/pattern/g批量收集文本中所有的关键字或标点符号,通过results.length统计出现频次。
3. 需要引入其他延伸方法的补充场景
- 仅判断“是否存在”(不需要位置,也不需要内容):此时既不推荐
search()也不推荐match(),而应优先使用RegExp.prototype.test()。因为test()直接返回布尔值true或false,执行效率最高,且完全避开了0与-1的真假值混淆。 - 既要“全局检索”又要“保留捕获组”:如果文本中有多个目标项,且每一项目标项内都包含需要单独解析的分组,传统的
match(/.../g)会丢弃分组。在现代 JavaScript (ES2020+) 环境下,首选方案是使用String.prototype.matchAll(),它会返回一个迭代器,遍历产出包含每个匹配项及其捕获组的完整数据对象。
六、常见注意事项与陷阱排查
1. 传入非正则对象时的隐式转换机制
search() 和 match() 在接收到非 RegExp 对象(如传入普通字符串)时,在内部会隐式调用 new RegExp(target) 将其强制转换为正则表达式。
这一机制在包含正则特殊元字符时极易引发非预期行为。例如:
const str = "ver 1.0.0";
// 开发者原意想查找字面量 "."
const pos = str.search(".");
console.log(pos); // 输出:0!(因为 "." 被隐式转为正则表达式 /./,匹配了第0位的字符 'v')避坑策略:如果仅在字符串中进行固定字面量的查找,应使用 str.indexOf() 或 str.includes();如果必须用正则查找包含元字符的内容,请务必进行转义(如 str.search(/\./))。
2. 避免 RegExp 实例的 lastIndex 残留状态干扰
在使用 RegExp.prototype.exec() 时,全局正则表达式会把当前的检索进度记录在 regexp.lastIndex 属性上,若不重置可能导致下次检索从中间开始。而 String.prototype.search() 与 String.prototype.match() 在内部会始终从第 0 位开始执行检索,并且在执行完毕后不会产生有副作用的进度状态残留,因此在多处并发复用正则字面量时更为安全可靠。
JS全局对象包含哪些常用内置属性和方法
2026-11-18 10:20:10
JS Map.entries()遍历获取键值对的完整示例
2026-11-18 09:16:06
JavaScript验证中国大陆手机号码的正则表达式
2026-11-18 08:21:16
使用Intl.DateTimeFormat自动获取本地化星期名称
2026-11-17 19:04:32
怎么在 JavaScript 中实现带种子(Seed)的可复现伪随机数
2026-11-17 14:55:13







