

JavaScript验证中国大陆手机号码的正则表达式
深入解析在JavaScript中验证中国大陆11位手机号码的正则表达式写法、工信部号段规则、常见格式数据清洗以及工程落地中的前后端协同策略。
在JavaScript中验证中国大陆11位手机号码,目前工程实践中最推荐的正则表达式是 /^1[3-9]\d{9}$/。该表达式要求首位必须是数字 1,第二位覆盖工信部目前及规划发放的 3 至 9 号段,后续紧跟 9 位任意数字,并通过起止锚点确保总长度严格锁定为 11 位。本文将系统拆解该正则表达式的语法推导、工信部号段分布依据、常见输入格式清洗流水线,以及工程落地中前后端职责的协同边界。
一、核心结论与推荐正则表达式
在日常表单验证与接口调用中,最常见也最稳妥的判定实现如下:
/**
 * 验证是否为合法的中国大陆手机号(纯数字11位)
 * @param {string} phone - 待验证的字符串
 * @returns {boolean} - 格式合法返回 true,否则返回 false
 */
function isValidChinesePhone(phone) {
  const regex = /^1[3-9]\d{9}$/;
  return regex.test(String(phone).trim());
}

// 验证示例
console.log(isValidChinesePhone("13800138000")); // true (经典移动号段)
console.log(isValidChinesePhone("19212345678")); // true (中国广电号段)
console.log(isValidChinesePhone("12345678901")); // false(12开头非手机号段)
console.log(isValidChinesePhone("1380013800"));  // false(少于11位)
console.log(isValidChinesePhone("138001380000"));// false(超出11位)这一结论的优势在于平衡了格式严谨度与长期可维护性。它既杜绝了非法前缀(如 10x、11x、12x),又无需在运营商发放新号段(如广电 192、移动 195、电信 193 等)或用户携号转网时频繁改动代码。
二、中国大陆手机号码编码结构与号段规则
中国大陆的移动电话号码由中华人民共和国工业和信息化部统一分配和管理,在结构上属于国际电信联盟(ITU-T)E.164建议书体系。每一枚完整的境内手机号码包含 11 位十进制数字,划分为三个核心组成部分:
- 网络识别码(第 1 - 3 位):前 3 位指代分配给不同电信运营商的基础号段。第 1 位固定为
1,属于移动通信业务前缀;第 2 位对应分配的网络批次(目前包含 3 至 9);第 3 位则精准区分归属基础运营商或虚拟运营商。 - 地区编码(第 4 - 7 位):也称 H0H1H2H3 码,用于标识该号码初始放号的本地网行政区划代码。
- 用户号码(第 8 - 11 位):共 4 位,由各省市运营商在对应交换机内顺序或随机下发分配给终端用户。
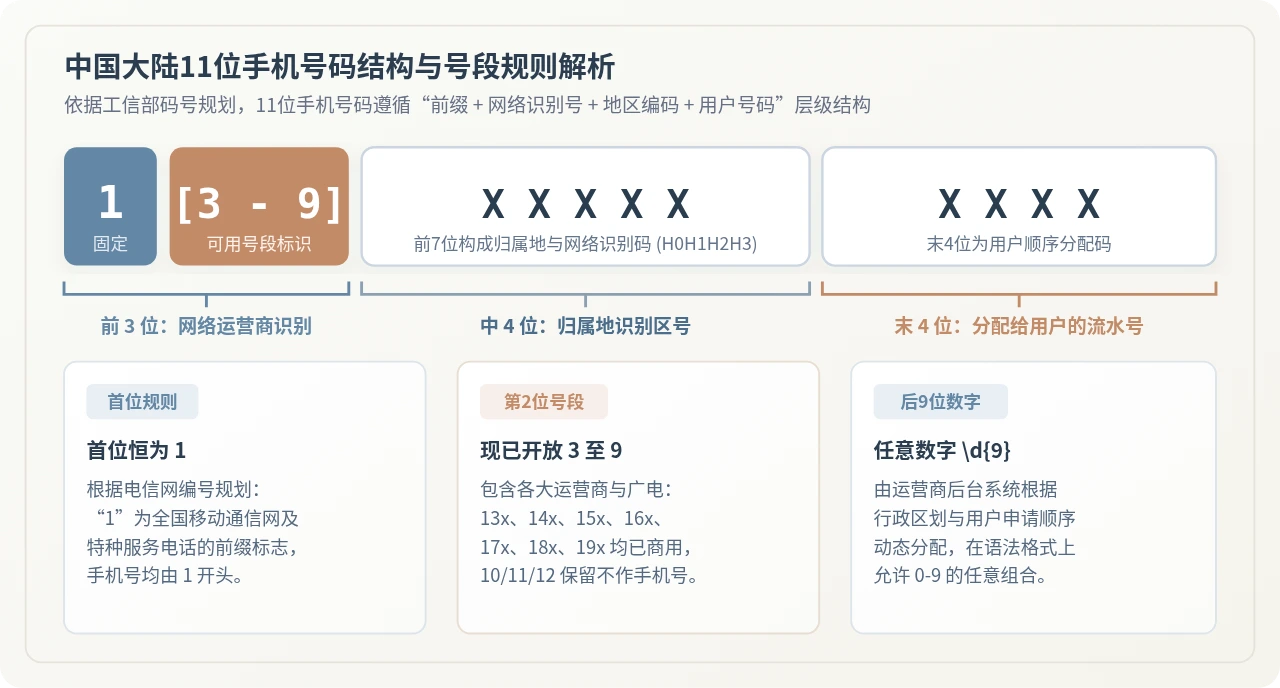
图 1:中国大陆11位手机号码结构与号段规则解析
理解该结构的关键在于明确为什么第二位只能是 3 至 9:
10前缀主要分配给电信运营商内部特服业务及国际入网测试码;11前缀用于特种服务号码(如 110 报警、119 火警、114 查号等);12前缀主要用于民生及公共机构服务号(如 12345 政务便民热线、120 急救中心等)。
因此,移动通信终端号码的第二位有效数字必然落在 3 到 9 的闭区间之内。
三、正则表达式语法逐项推导与匹配原理
正则表达式 /^1[3-9]\d{9}$/ 看似短小,但每个字符都在引擎内部承担明确的匹配职责。如果漏掉边界锚点或量词,极易在生产环境引发安全漏洞或静默误判。
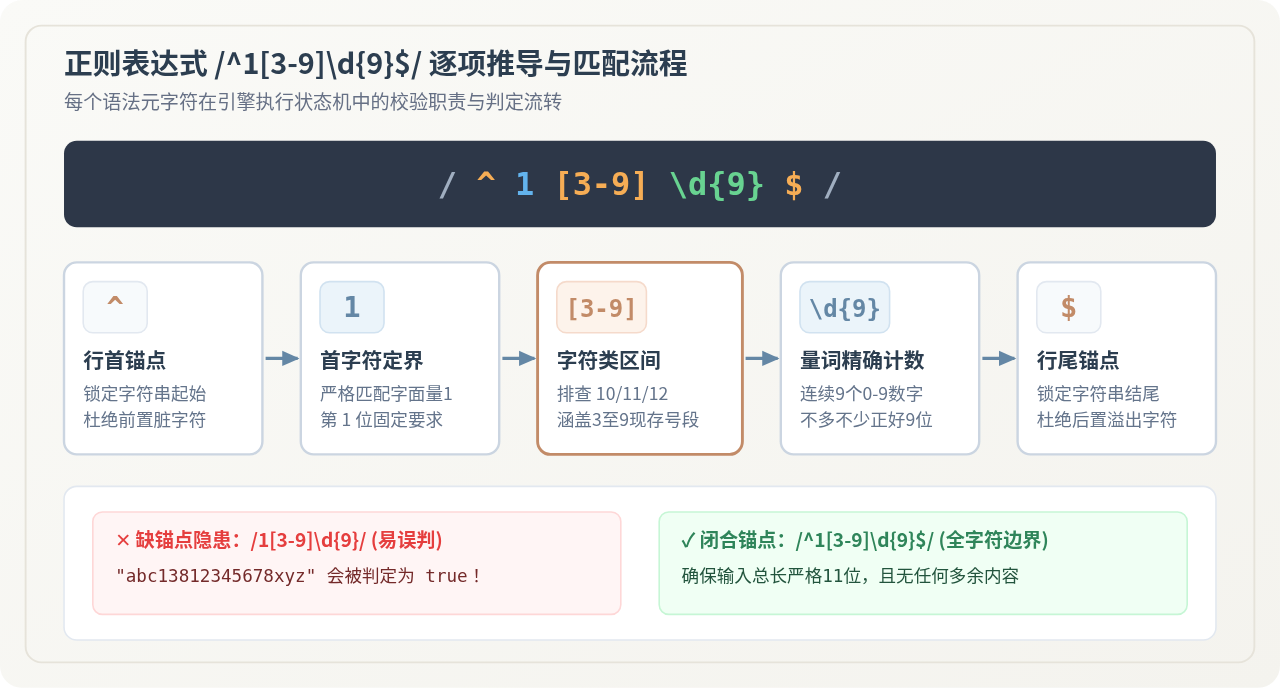
图 2:正则表达式 /^1[3-9]\d9$/ 逐项推导与匹配流程
语法元素逐一拆解
^(脱字符):行首锚点。指示匹配必须从字符串的第一个字符开始。若省略该锚点,输入"abc13800000000"也会被RegExp.test()判定为匹配成功。1(普通字符):精确匹配数字 1。强制规定手机号的第一位字符必须是字符"1"。[3-9](字符类区间):限制第二位有效号段。方括号表示字符集合,3-9表示匹配 ASCII 码在'3'至'9'之间的任意单一数字,排除了0、1、2。\d{9}(元字符与计数花括号):\d等价于[0-9],匹配任意十进制数字;{9}为限定符,要求前面的\d恰好连续重复 9 次。1 + 1 + 9 = 11,确保总长正好 11 位。$(美元符):行尾锚点。指示匹配必须在字符串末尾结束。若省略该锚点,输入"13800000000123"(14位)会被截取前 11 位判定为有效,导致脏数据入库。
避坑提醒:在 JavaScript 中使用 RegExp.prototype.test() 时,务必避免对该正则开启全局修饰符 g。若在全局模式下连续对同一正则实例调用 test(),内部的 lastIndex 游标会保留上次匹配位置,造成“第一次返回 true,紧接着相同参数却返回 false”的经典隐蔽 Bug。
四、常见复杂格式的清洗与预处理流水线
在真实的表单交互中,用户粘贴或自动填写的手机号码往往包含各类噪声,例如带有国家/地区区号(+86、0086、86)、分隔空格(138 0000 0000)或破折号(138-0000-0000)。
很多初学者试图编写一个“包罗万象”的复杂超长正则来直接匹配所有格式,例如 /^(\+?86)?\s?1[3-9]\d([- ]?\d{4}){2}$/。这种做法往往带来严重弊端:正则可读性极差、执行回溯开销增加,且难以容纳用户不规范的混用习惯(例如前半段带横杠、后半段带空格)。
工程上更为推荐的做法是“清洗与校验解耦”:先将输入转化为纯数字的规范标准格式,再使用简洁的正则表达式进行判定。
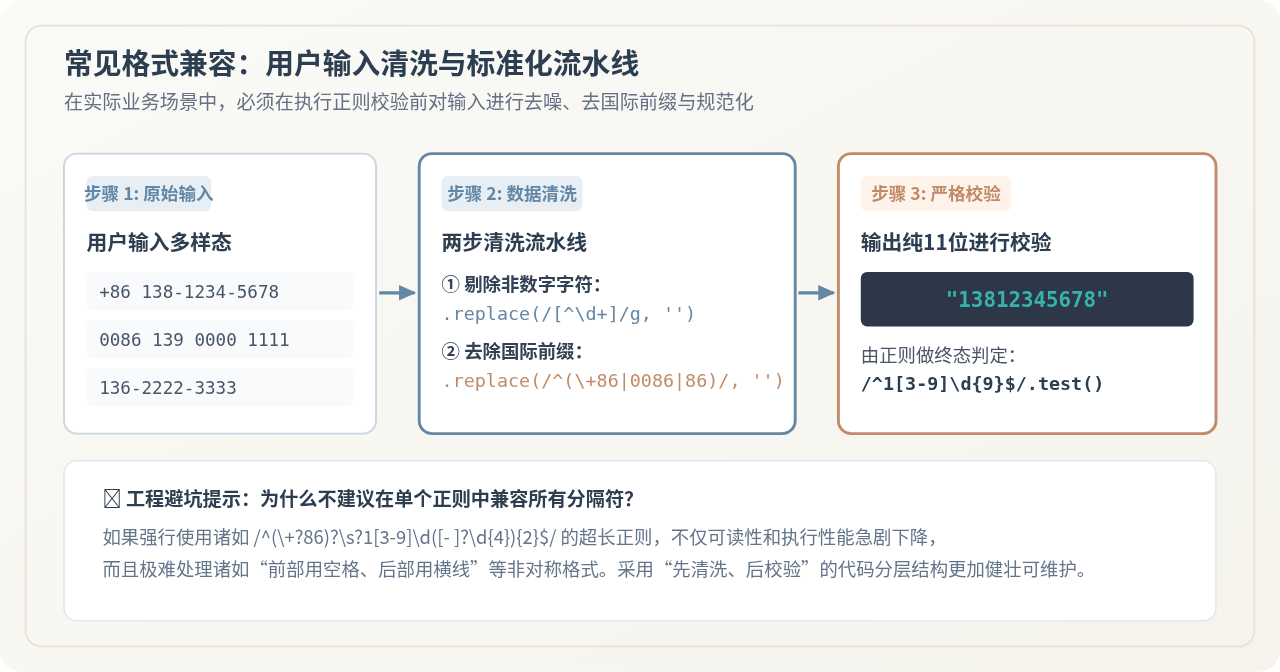
图 3:用户输入清洗与标准化流水线
标准输入清洗实现函数
/**
 * 标准化手机号输入并校验
 * @param {string} rawInput - 用户输入的原始字符串
 * @returns {{ isValid: boolean, normalized: string }} - 校验结果及清洗后的11位纯数字
 */
function normalizeAndValidatePhone(rawInput) {
  if (typeof rawInput !== "string") {
    return { isValid: false, normalized: "" };
  }

  // 1. 过滤除数字与加号外的所有字符(空格、破折号、括号等)
  let cleaned = rawInput.trim().replace(/[^\d+]/g, "");

  // 2. 去除中国大陆国际区号前缀(+86, 0086, 86- 等)
  // 必须确保后面跟随的是以 1 开头的 11 位数字,避免误删以86开头的正常号码段
  if (cleaned.startsWith("+86")) {
    cleaned = cleaned.slice(3);
  } else if (cleaned.startsWith("0086")) {
    cleaned = cleaned.slice(4);
  } else if (cleaned.startsWith("86") && cleaned.length > 11) {
    cleaned = cleaned.slice(2);
  }

  // 3. 执行标准正则表达式检验
  const isValid = /^1[3-9]\d{9}$/.test(cleaned);

  return {
    isValid: isValid,
    normalized: isValid ? cleaned : ""
  };
}

// 验证实际处理效果
console.log(normalizeAndValidatePhone("+86 138-1234-5678"));
// 输出: { isValid: true, normalized: "13812345678" }

console.log(normalizeAndValidatePhone("0086 199 8888 7777"));
// 输出: { isValid: true, normalized: "19988887777" }

console.log(normalizeAndValidatePhone("139 1234 5678 "));
// 输出: { isValid: true, normalized: "13912345678" }

console.log(normalizeAndValidatePhone("123-4567-8901"));
// 输出: { isValid: false, normalized: "" }
五、“严格号段匹配”与“宽松匹配”的权衡分析
在部分技术论坛中,常有开发者给出枚举所有运营商前三位号段的超长正则表达式:
// 不推荐在生产环境直接使用的“超严格”枚举正则(极易误伤)
const strictRegex = /^1(3[0-9]|4[5-9]|5[0-35-9]|6[2567]|7[0-8]|8[0-9]|9[0-35-9])\d{8}$/;
虽然此类严格枚举能够筛掉诸如 140、144 等暂时未对民用公众开放的特殊号段,但在工业级代码中,这种方案往往带来严重的维护负债:
| 对比维度 | 前两位判定模式(/^1[3-9]\d{9}$/) | 全号段枚举模式(严格枚举前三位) |
|---|---|---|
| 新号段前向兼容 | 高。工信部下发新号段(如广电192或新增190等)时自动支持,系统无需升级。 | 差。每次国家下发新号段,若未及时打补丁,新号段用户将直接无法注册/登录。 |
| 携号转网影响 | 无影响。不绑定运营商属性,正常校验。 | 逻辑易混淆。前端即使根据号段识别了运营商,携转后号段已失去归属性意义。 |
| 代码维护成本 | 零维护。逻辑简单稳定,跨项目复用性极强。 | 高维护。需持续跟踪工信部最新分配公告,容易因版本不同步引发故障。 |
| 防误填与防护效果 | 足以拦截 99.9% 的手误、缺位、脏字符和明显假号。 | 与前者相比仅能多拦截数个冷门保留段,边际收益极低。 |
因此,现代中大型 Web 系统一致采纳 /^1[3-9]\d{9}$/ 作为基准方案,而把号段的真实性判定移交给后续的业务验证流程。
六、全链路手机号验证体系与职责边界
必须清晰认识到:正则表达式只能验证输入字符串在“字面格式”上是否符合规范,无法验证该号码在现实中是否真实存在、是否已停机,更无法验证当前操作者是否为该号码的合法持有者。
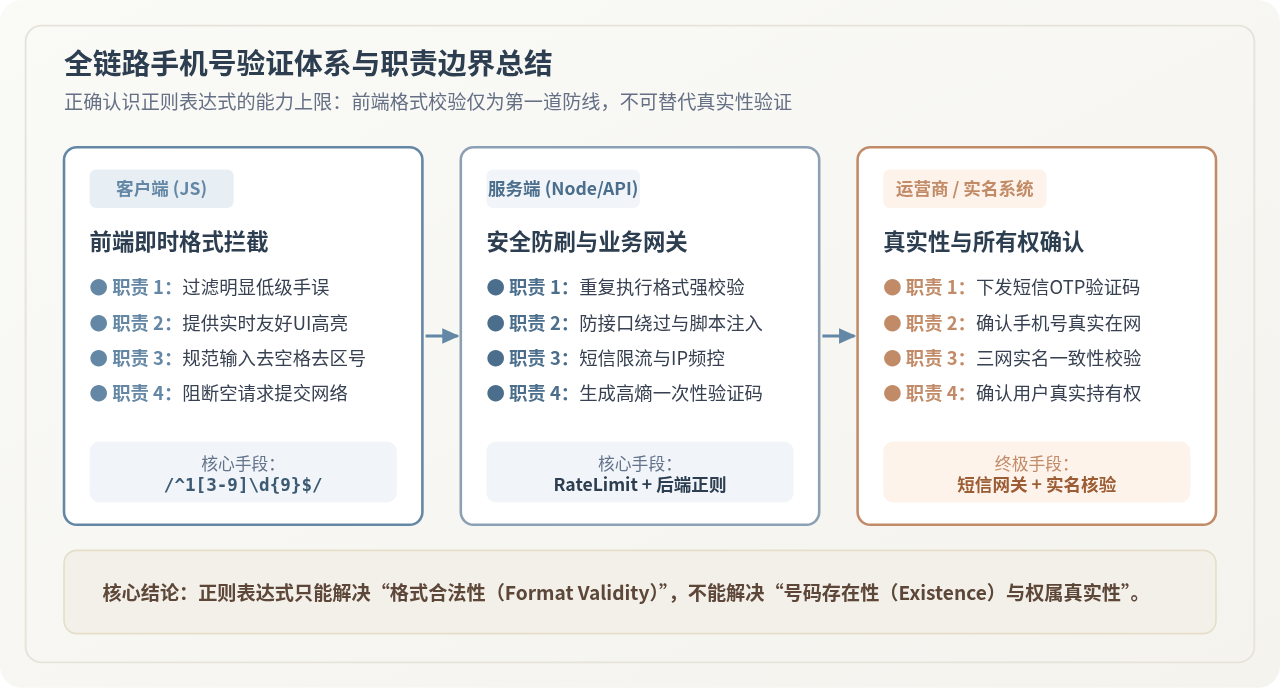
图 4:全链路手机号验证体系与前后端职责边界
在完善的系统架构中,手机号验证由三层防线协同完成:
- 前端客户端(JavaScript 正则):负责输入阶段的实时格式防呆,在用户输入有误时(如漏位、多位、输入中文)立即给出界面提示,并拦截无意义的空请求,节省服务器带宽。
- 服务端网关(API 接口校验):后端必须重复进行一次相同的正则格式校验,防止攻击者绕过浏览器前端直接伪造 HTTP 请求;同时对该接口配置基于 IP 和设备指纹的频次限制(Rate Limiting),防止恶意利用短信接口实施短信轰炸。
- 运营商/通信服务商(短信网关与实名认证):通过向号码发送一次性高熵验证码(SMS OTP),要求用户回填并在限定时间内确认;高安全场景下接入三网实名认证接口(比对“姓名、身份证号、手机号”三要素),完成终极真实性闭环。
七、总结与快速参考指南
中国大陆手机号在 JavaScript 中的验证工作可归纳为以下三条可直接落地的准则:
- 选用核心表达式:日常业务统一采用
/^1[3-9]\d{9}$/,兼顾格式合规与号段扩充的兼容性。 - 先做清洗再做匹配:在调用
test()之前,先利用replace()剔除空白字符、分隔横杠以及+86等国际区号前缀,避免让正则承担过多的字符串排版解析。 - 严禁前端单点信任:前端正则仅用于交互友好性反馈,敏感业务操作必须在服务端进行严格二次校验,并配合短信验证码或运营商实名核验以确保权属真实。
使用Intl.DateTimeFormat自动获取本地化星期名称
2026-11-17 19:04:32
怎么在 JavaScript 中实现带种子(Seed)的可复现伪随机数
2026-11-17 14:55:13
使用SweetAlert2快速实现JavaScript美化确认框
2026-11-17 13:21:24
为什么循环中的JS闭包总是获取最后一个值
2026-11-17 12:36:26
JS Math.random()基础用法与返回值范围
2026-11-17 11:57:09







