爬虫实战:Python调用JS还原前端加密参数
针对现代网站API常见的动态签名、Token等前端加密参数,系统讲解如何使用浏览器开发者工具定位加密逻辑、抽离核心JS代码,并通过Python调用JavaScript引擎完整还原加密参数的实战指南。
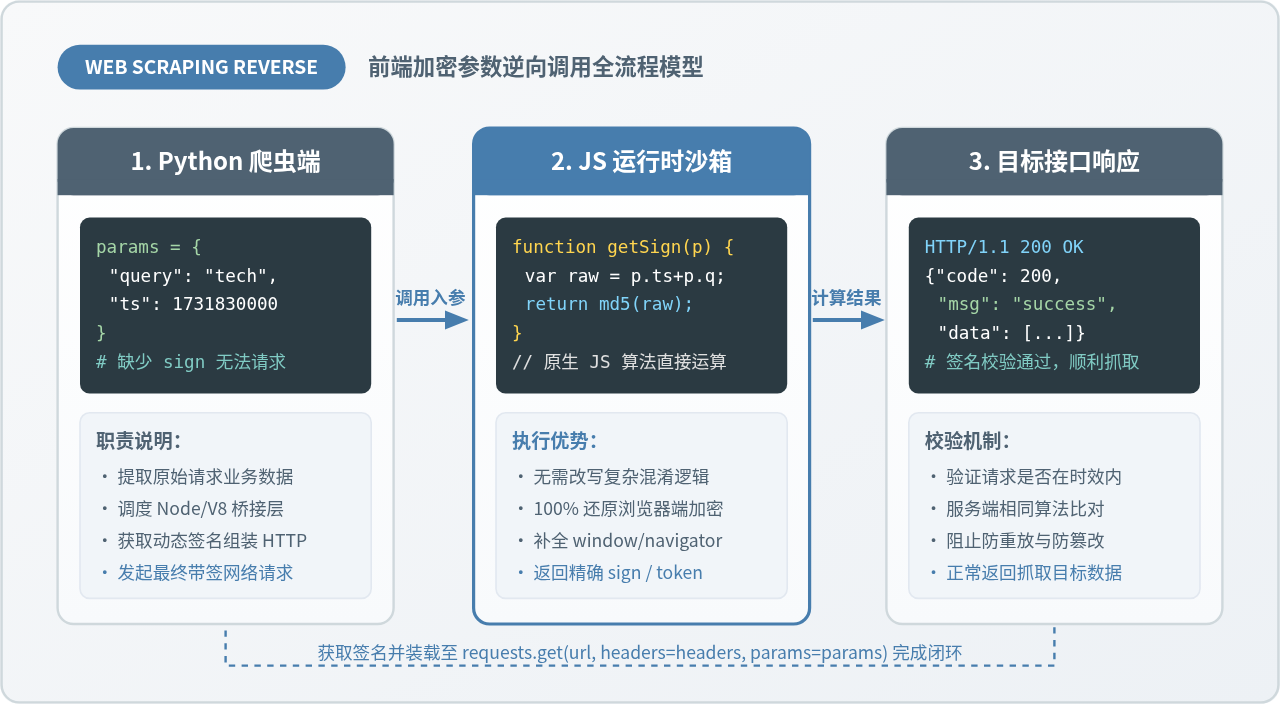
面对带有动态签名(sign、token 或 _signature)的数据接口,直接使用 Python 逆向重写复杂的混淆算法往往费时费力,且一旦前端算法细节微调就会导致整个采集流程失效。最高效且可靠的解决路径,是通过浏览器开发者工具精准定位前端加密函数,将包含算法的核心 JavaScript 脚本独立抽离,并在 Python 爬虫中通过 Node.js 运行时或执行引擎直接调用该函数,动态生成有效签名并拼装发起请求。
为什么选择 Python 调用 JS 还原加密参数
在现代 Web 应用中,服务端为了防爬虫与防止请求重放,通常会要求客户端发送请求时携带由当前时间戳、随机数、URL 路径以及查询参数共同计算得出的哈希值或加密密文。这类前端加密逻辑通常具备以下特征:
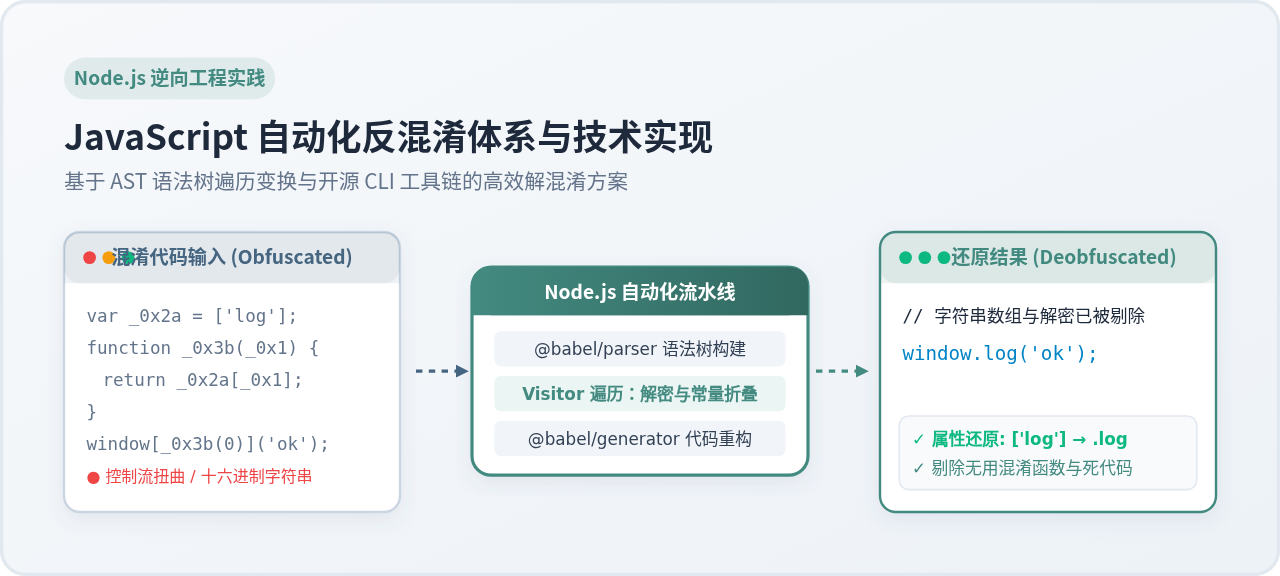
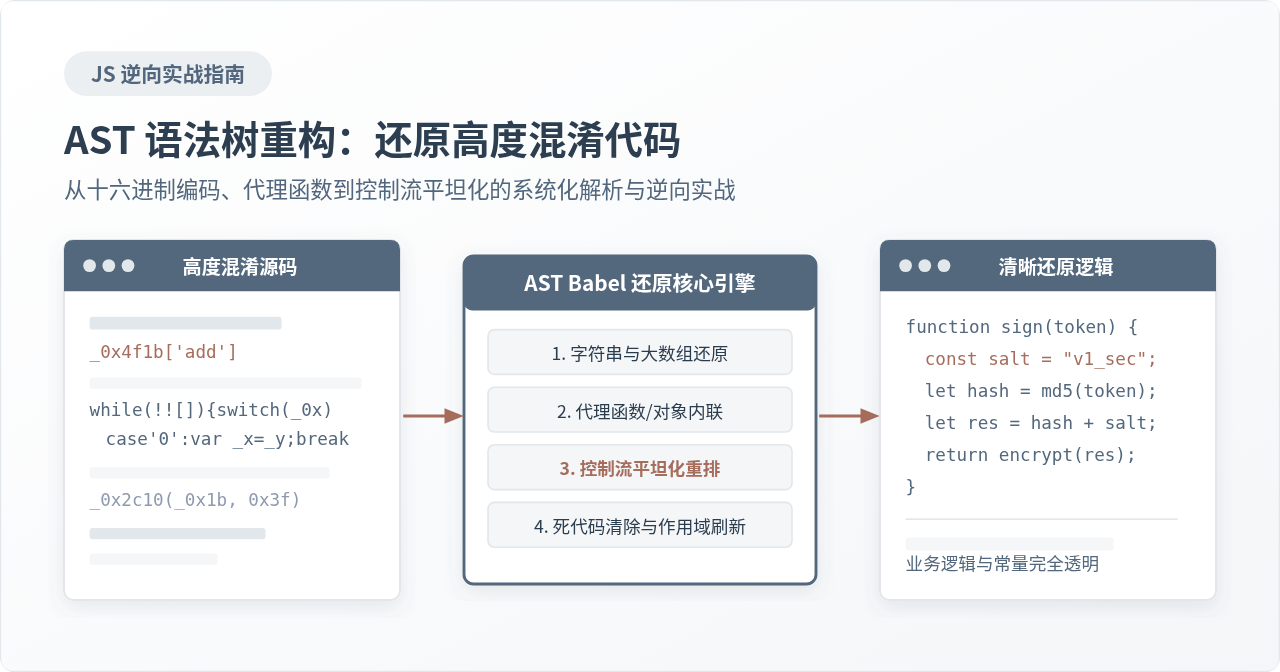
- 深度混淆与压缩:经过 Webpack 打包、OB 混淆(Obfuscator)或多层闭包封装,函数名与变量名被全面替换为无意义字符,人工逐行翻译为 Python 代码的成本极高。
- 依赖特定标准库:前端加密常依赖如 CryptoJS、JSEncrypt 或自定义编码表,Python 的
hashlib在填充方式、编码格式稍有偏差时,生成的哈希值便无法通过服务端校验。 - 多变的时效性:签名往往绑定当前毫秒时间戳与一次性随机 Nonce,服务端在收到请求后只在特定时间窗口内接受该计算值。
直接在 Python 进程中建立与 JavaScript 运行环境的通信桥梁,把“翻译前端代码”转变为“直接复用前端代码”,不仅能大幅缩短逆向分析周期,还能确保输出的签名值与真实浏览器 100% 一致。
定位前端加密函数的三个关键入口
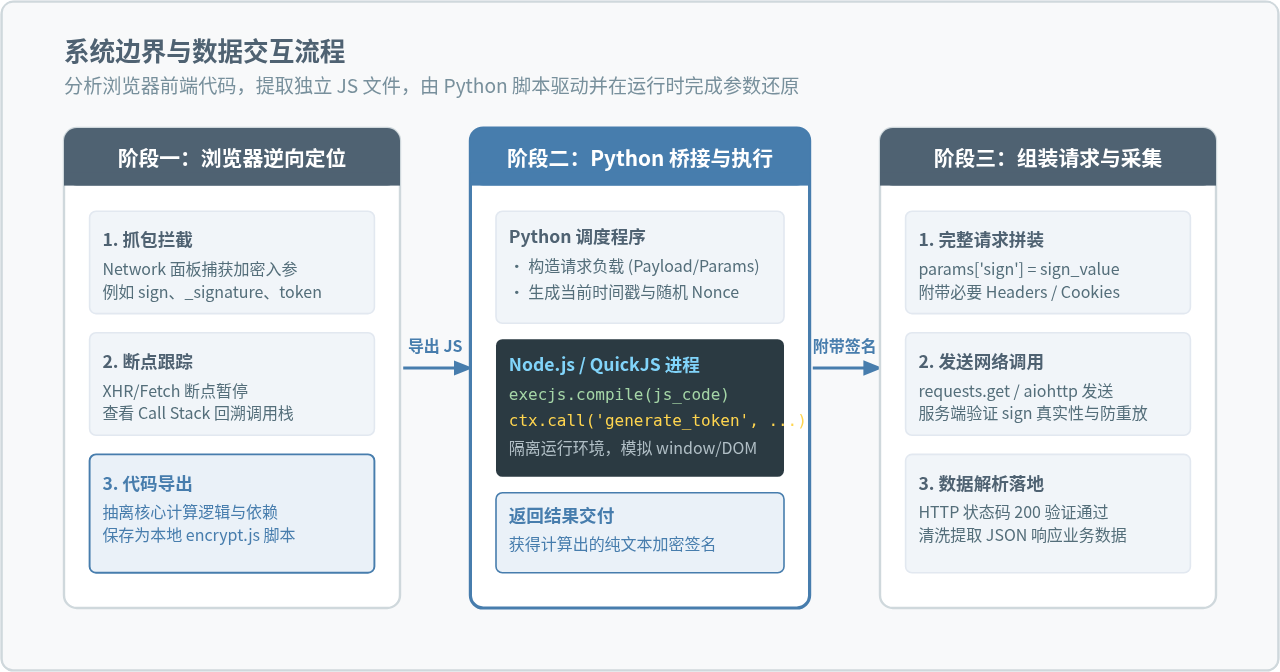
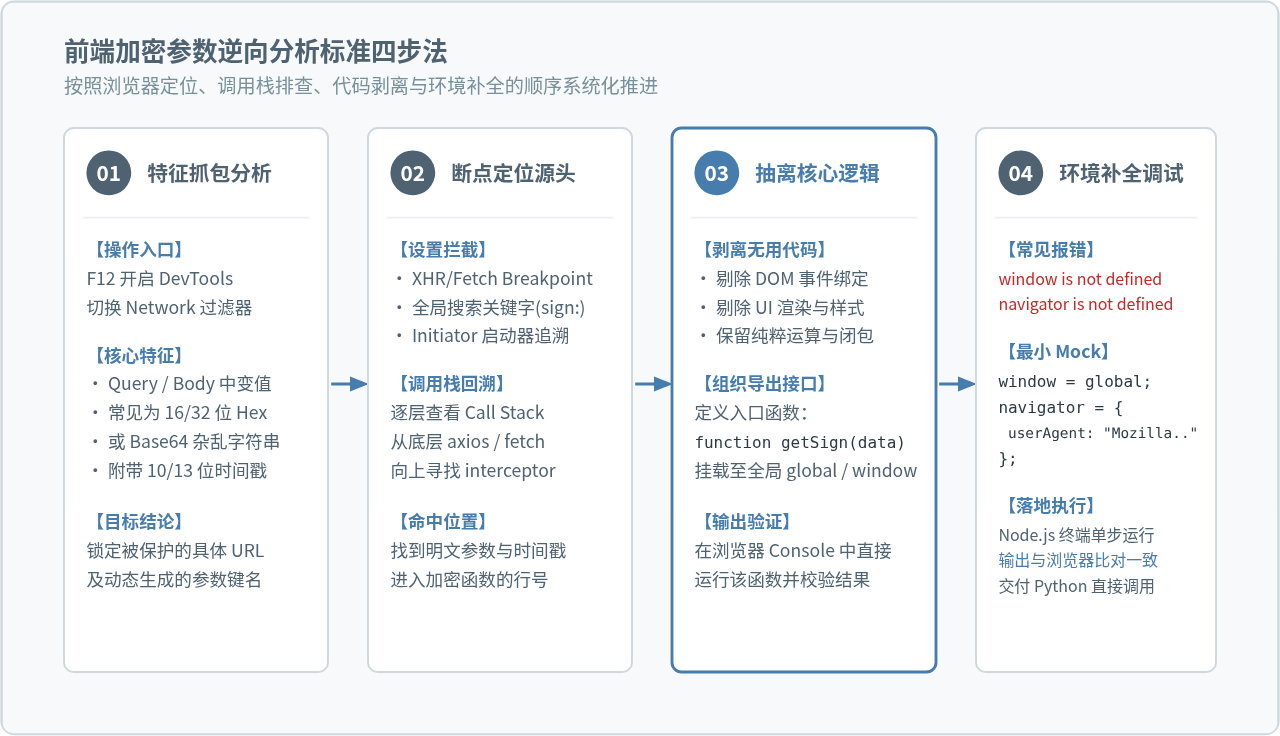
要让 Python 能够调用 JavaScript 代码,首先必须在目标网站中找到负责生成加密参数的具体函数。在 Chrome 等现代浏览器的开发者工具(DevTools)中,有三种标准排查路径。
1. 全局搜索关键字
打开 DevTools,按 Ctrl + Shift + F(Mac 上为 Cmd + Option + F)打开全局搜索抽屉。根据接口中加密参数的键名进行针对性检索,例如输入 sign:、token:、signature: 或 MD5(、AES.encrypt(。在搜索结果中,优先排查带有 api.js、request.js 或 axios 配置的脚本文件。
2. XHR/fetch 拦截断点
如果关键字被压缩混淆无法直接搜出,可以通过网络请求断点进行精准拦截。进入 Sources(源代码)面板,展开右侧的 XHR/fetch Breakpoints 折叠菜单,点击 + 添加一个过滤条件,填入目标接口 URL 的关键路径片段(例如 /api/v1/search)。重新触发页面请求,浏览器便会在即将发送请求的瞬间暂停执行代码。
3. 回溯调用栈(Call Stack)
断点命中时,当前停顿的代码通常是底层的 XMLHttpRequest.send 或 fetch。此时查看右侧的 Call Stack(调用栈),从栈顶依次向下单步回溯。通常在倒数第 2 至 4 层,就可以看到 Axios 的请求拦截器(Request Interceptor)或封装好的业务请求方法,在这里明文参数正被传入某个加密函数进行签名运算。
提取 JS 代码与“补环境”操作
找到核心加密逻辑后,需要将其提取为独立的 .js 脚本。但在 Node.js 脱离浏览器运行提取出的代码时,最常遇到的障碍是 ReferenceError 异常。这是因为前端代码往往引用了浏览器特有的全局对象(如 window、document、navigator、location)。
无需引入庞大的无头浏览器或完整的 JSDOM,只需按运行报错缺什么补什么,使用空对象或基础属性伪造必要的全局变量即可满足绝大多数算法需求。
下面是一个标准的抽离示范文件 encrypt_helper.js,展示了环境补齐与加密函数的挂载:
// 1. 补齐 Node.js 缺失的浏览器全局对象
var window = global;
var navigator = {
    userAgent: "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    platform: "Win32"
};
var document = {
    cookie: "",
    createElement: function(tag) { return {}; }
};
var location = {
    href: "https://example.com/search",
    hostname: "example.com"
};

// 2. 引入加密依赖(或粘贴从前端网页提取出的 MD5/AES 原生实现)
const crypto = require("crypto");

function md5(text) {
    return crypto.createHash("md5").update(text, "utf8").digest("hex");
}

// 3. 还原的前端签名算法逻辑
function generateSignature(params) {
    // 假设服务端规则:将入参按 key 升序排列,拼接 key=value 并加上固定盐值与当前时间戳
    var keys = Object.keys(params).sort();
    var queryParts = [];
    for (var i = 0; i < keys.length; i++) {
        var k = keys[i];
        if (k !== "sign") {
            queryParts.push(k + "=" + params[k]);
        }
    }
    var rawString = queryParts.join("&") + "&salt=SECRET_KEY_2026";
    return md5(rawString);
}

// 4. 导出给命令行或外部调用
module.exports = { generateSignature };

// 若通过命令行参数测试:
if (require.main === module) {
    var inputStr = process.argv[2] || "{}";
    var parsedParams = JSON.parse(inputStr);
    console.log(generateSignature(parsedParams));
}
在本地终端中运行以下命令测试该 JS 文件是否能独立正常输出:
node encrypt_helper.js '{"query":"python","ts":1731830000}'
# 示例输出:e89fe32cb412d4a34b28d7120a4b33c1
Python 调度 JavaScript 的选型与实战代码
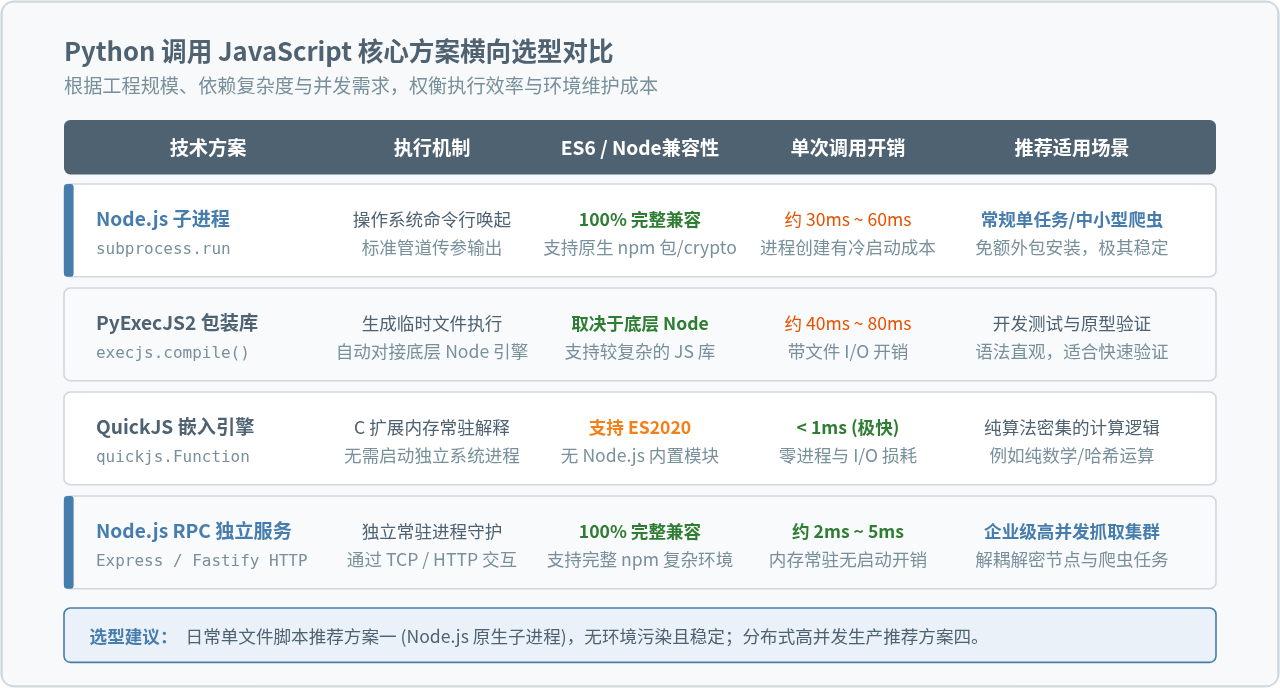
在 Python 中调用 JavaScript,主要有 subprocess 子进程直接调用、PyExecJS2 包装库以及常驻 Node 服务三种模式。
方案一:标准库 subprocess 驱动(稳定推荐)
在生产与爬虫工程中,直接使用 Python 内置的 subprocess.run 调用系统已安装的 Node.js 是最不易出现内存泄漏和底层兼容问题的做法。它不需要第三方非标桥接模块,且 100% 具备 Node 完整功能。
下面是完整的 Python 爬虫调度实战代码 crawler.py:
import json
import subprocess
import time
import requests

def get_signature_by_node(params: dict) -> str:
    """
    通过子进程调用本地 Node.js 脚本获取前端加密签名
    """
    params_json = json.dumps(params, ensure_ascii=False)
    # 调用 node 执行 encrypt_helper.js,将入参作为命令行参数传入
    result = subprocess.run(
        ["node", "encrypt_helper.js", params_json],
        stdout=subprocess.PIPE,
        stderr=subprocess.PIPE,
        text=True,
        check=True,
        encoding="utf-8"
    )
    # 获取输出结果并清理末尾换行符
    signature = result.stdout.strip()
    return signature

def fetch_protected_data(keyword: str):
    target_api = "https://api.example.com/v1/search"

    # 构造基础业务参数与时间戳
    params = {
        "keyword": keyword,
        "page": 1,
        "ts": int(time.time() * 1000)  # 毫秒时间戳
    }

    # 步骤 1:调用 JS 动态计算出签名字段
    sign = get_signature_by_node(params)
    params["sign"] = sign

    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Referer": "https://example.com/search",
        "Accept": "application/json, text/plain, */*"
    }

    # 步骤 2:携带动态计算的参数发起实际抓取请求
    print(f"[*] 正在请求接口,携带签名: {sign}")
    response = requests.get(target_api, headers=headers, params=params, timeout=10)

    if response.status_code == 200:
        data = response.json()
        print(f"[+] 数据抓取成功: {len(data.get('items', []))} 条记录")
        return data
    else:
        print(f"[-] 请求失败,状态码: {response.status_code}, 响应内容: {response.text}")
        return None

if __name__ == "__main__":
    fetch_protected_data("Python逆向实战")
方案二:使用 PyExecJS2 / PyExecJS 内存编译调用
如果希望在 Python 代码中像调用普通函数一样传参并接收返回值,可以使用 PyExecJS2(维护版)。
import execjs

# 读取提取出的 JS 代码
with open("encrypt_helper.js", "r", encoding="utf-8") as f:
    js_code = f.read()

# 编译 JS 环境(底层默认使用 Node)
ctx = execjs.compile(js_code)

# 直接调用 JS 函数
params = {"keyword": "crawler", "ts": 1731830000}
sign = ctx.call("generateSignature", params)
print("计算签名值:", sign)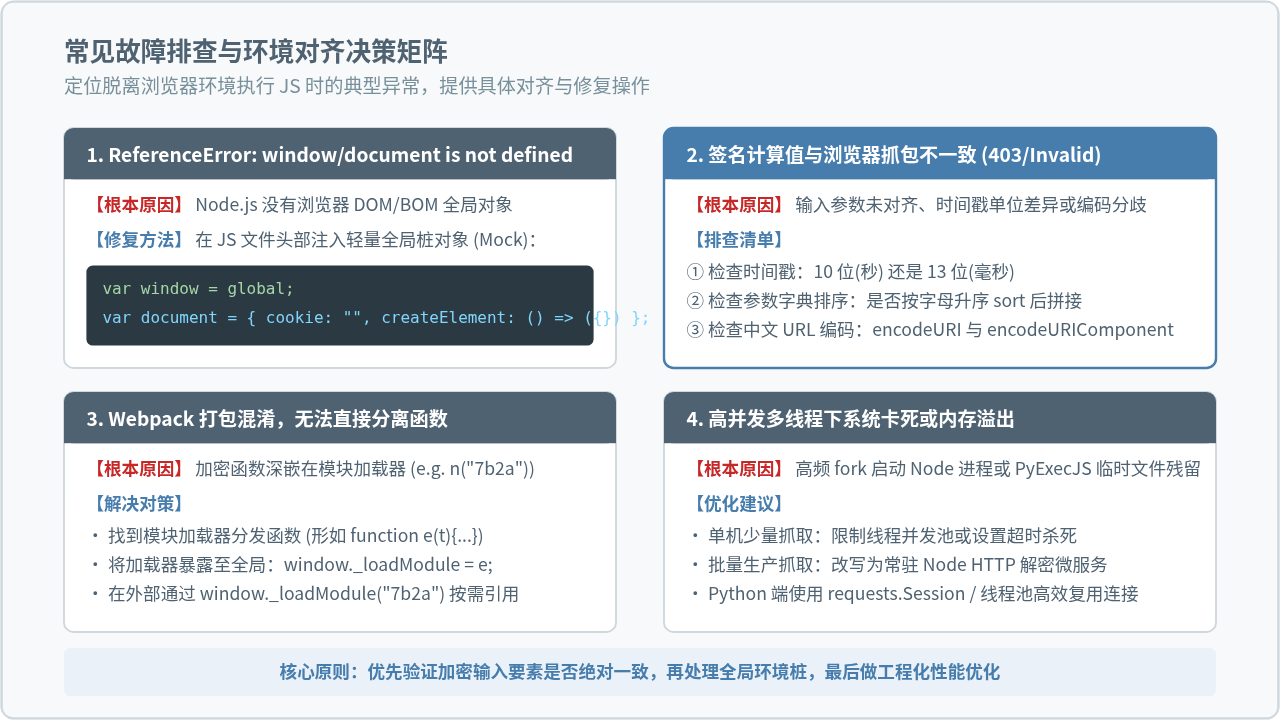
常见问题与排查清单
在还原与调用过程中,若遇到计算出的签名无效或运行报错,请按照以下要点逐项排查:
- 时间戳精度是否对齐:确认前端使用的是秒(10 位,例如
Math.floor(Date.now() / 1000))还是毫秒(13 位,Date.now())。时间戳不一致会导致服务端认为请求过期或签名校验失败。 - 参数排序规则:前端代码在拼接签名字符串前,是否对字典进行了
Object.keys(p).sort()字母排序?如果排序逻辑遗漏,参数拼接顺序不同会导致哈希完全不同。 - URL 编码差异:如果请求参数中包含中文或特殊字符,需确认前端在加密前是否执行了
encodeURIComponent。Python 的urllib.parse.quote在处理部分字符(如~、!、*)时的转义规则可能与 JavaScript 存在细微差别。 - 全局变量污染与内存管理:在多线程批量采集场景下,避免频繁重复调用
execjs.compile()。应将编译后的ctx作为单例常驻,或直接使用 Node.js 启动一个轻量 HTTP 本地服务(如基于 Express),通过网络端口向 Python 提供签名运算接口,以获得极致的吞吐性能。
JS切换图片时怎么避免闪烁和加载延迟
2026-11-17 19:11:30
JS鼠标跟随性能优化:使用requestAnimationFrame与transform
2026-11-17 18:50:42
JS 前端导出万级数据 Excel 的性能优化策略
2026-11-17 09:51:54
location.reload(true)已弃用?JS强制刷新页面的替代方案
2026-11-16 15:05:10
纯前端js导出word大文件性能优化:分片处理与内存管理
2026-11-16 13:42:41