

JS嵌套对象数组怎么递归遍历并实现数据扁平化
深入讲解JavaScript中嵌套对象数组的递归遍历与数据扁平化实现,涵盖经典闭包收集、函数式reduce、保留父级关联及迭代防爆栈等实用方案与踩坑指南。
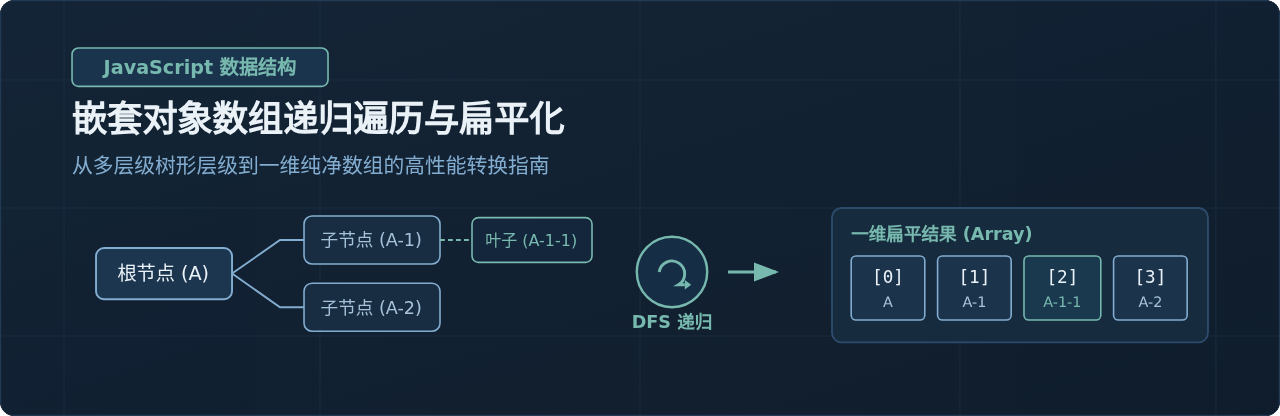
在 JavaScript 开发中,处理树形嵌套对象数组(如部门组织架构、多级菜单分类、文件目录结构)并将其转换为扁平的一维数组,核心思路是通过深度优先递归遍历(DFS):使用一个结果容器,在遍历到当前节点时提取该节点数据(并解除原 children 引用),随后判断若存在非空的子节点数组,则将子节点传入自身递归执行,最终将整棵树的所有节点按序收集为一维数组。
一、为什么需要将嵌套对象数组扁平化
假设前端从后端接口获取了一组带有层级关系的部门数据,根节点内部包含 children 属性,children 数组内部又嵌套着子部门对象。这种树形结构适合以折叠树或级联选择器(Cascader)的形式展示,但在以下场景中直接处理树形数据往往非常困难:
- 常规表格展示:大部分前端 UI 库的数据表格(Table)要求传入单层数组格式,每一行对应一个独立对象。
- 全量数据检索与过滤:若要根据关键词模糊匹配某一节点,在扁平化一维数组中只需一次
Array.prototype.filter即可搞定,而无需反复编写深度递归搜索。 - ID 索引与映射表建立:需要将列表快速转换为基于
id的 Map 或字典对象,以实现O(1)复杂度的快速查找。
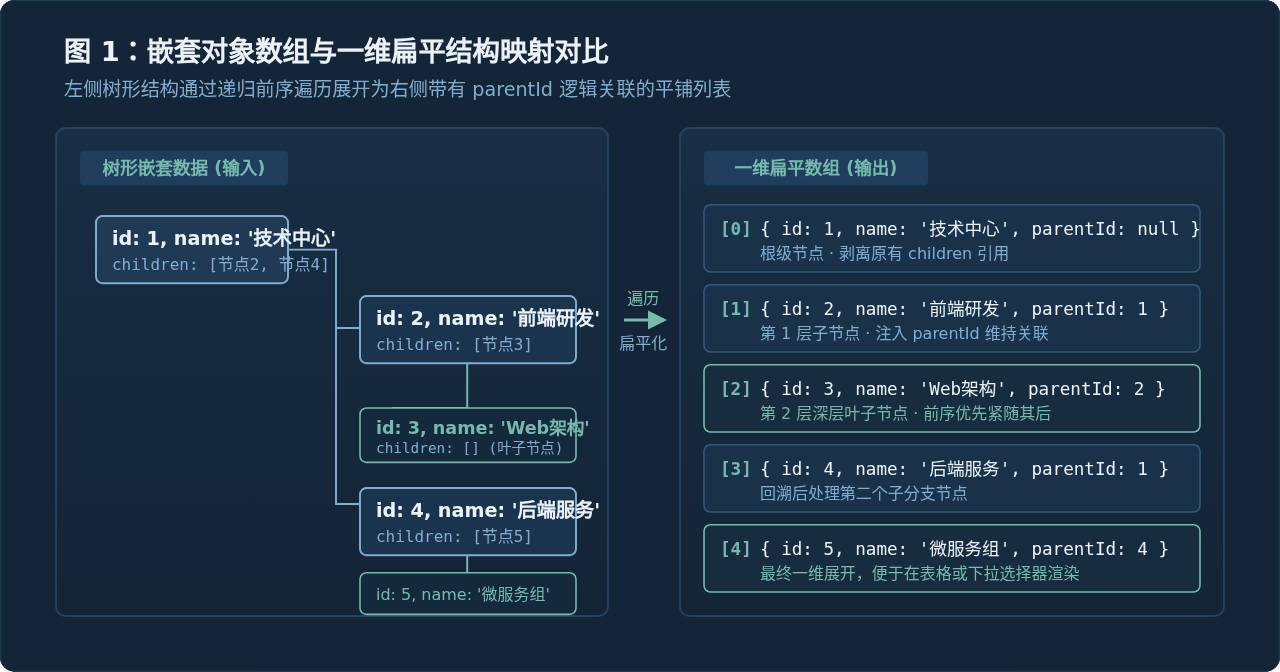
数据扁平化的核心目标,是在不丢失节点本身属性的前提下,将深层嵌套的拓扑结构“拉平”为连续的线性数组。为了更直观地理解结构的变化,我们可以观察树形分支展开前后的内存映射差异:
二、典型数据源结构定义
在正式编写递归函数前,我们先定义一个标准且具有代表性的多层嵌套对象数组。下面的示例包含了根级节点、多层级子节点以及空子节点的边界情况:
const departmentTree = [
  {
    id: 1,
    name: '技术中心',
    children: [
      {
        id: 2,
        name: '前端研发组',
        children: [
          { id: 3, name: 'Web架构小组', children: [] },
          { id: 4, name: '移动端小组' }
        ]
      },
      {
        id: 5,
        name: '后端研发组',
        children: [
          { id: 6, name: '微服务核心组' }
        ]
      }
    ]
  },
  {
    id: 7,
    name: '运营中心',
    children: [
      { id: 8, name: '用户运营组' }
    ]
  }
];
三、递归扁平化的四步标准流程
编写健壮的递归函数,必须具备清晰的拆解逻辑:从顶层入口向下拆解,逐项处理并安全回溯。整个过程可以精确归纳为以下四个步骤:
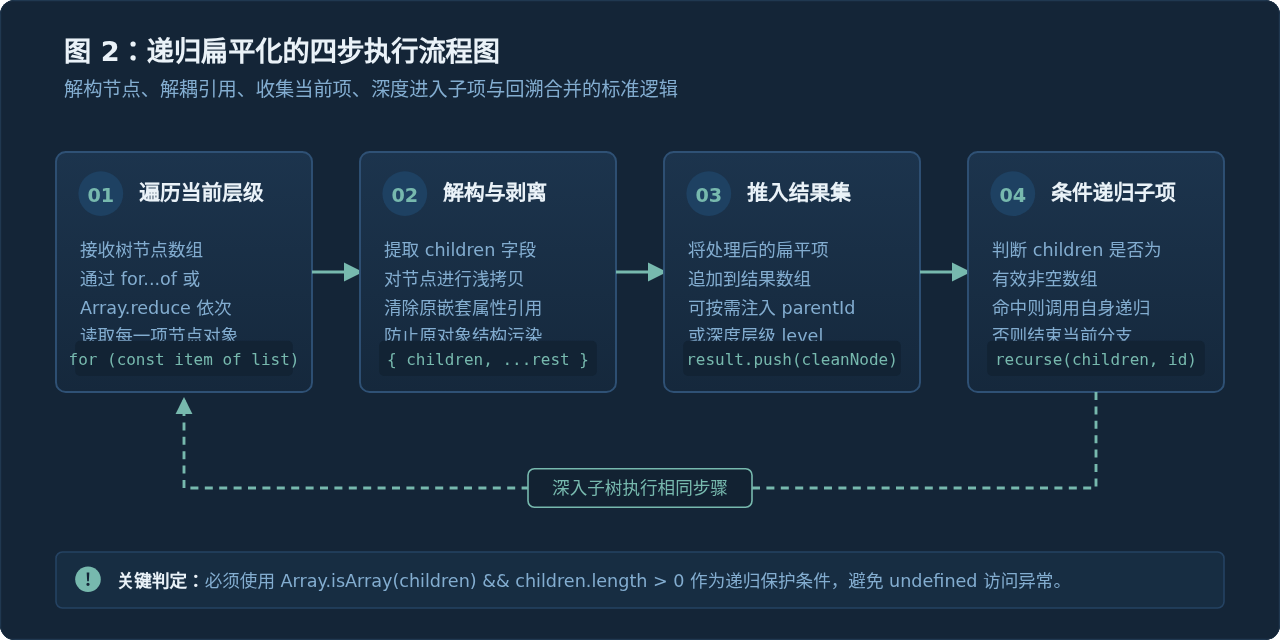
- 步骤一(遍历当前层):接收数组入参,使用循环(如
for...of)遍历当前层级的每一个节点对象。 - 步骤二(对象解构与去重引用):通过对象浅拷贝(如 ES6 解构赋值
const { children, ...rest } = node)将children属性与原节点信息分离。这样处理可以确保扁平化后的对象不再携带巨大的嵌套引用,避免数据冗余。 - 步骤三(收集节点至结果集):将解构得到的纯净节点放入收集器数组中。如果需要,也可以在此步追加
parentId或当前层级深度level。 - 步骤四(判定并递归深入):通过
Array.isArray(children) && children.length > 0判定是否存在子项。如果存在,将children作为参数传给递归函数继续处理;若不存在则自然结束当前分支,回溯处理兄弟节点。
四、主流实现方案与完整代码示例
方案 1:经典递归 + 闭包外部容器(推荐,直观易维护)
这是在实际业务开发中最常用且执行性能最好的实现方式。在最外层创建一个结果数组 result,内部定义辅助递归函数,直接向 result 推入节点:
/**
 * 经典深度优先递归扁平化
 * @param {Array} tree 嵌套对象数组
 * @returns {Array} 扁平化后的一维数组
 */
function flattenTree(tree) {
  const result = [];

  function traverse(nodes) {
    if (!Array.isArray(nodes)) return;

    for (const node of nodes) {
      // 1. 解构出 children 与节点其余属性,阻断嵌套引用
      const { children, ...nodeData } = node;

      // 2. 将纯净节点推入外部结果集
      result.push(nodeData);

      // 3. 如果子节点数组有效且非空,递归继续处理
      if (Array.isArray(children) && children.length > 0) {
        traverse(children);
      }
    }
  }

  traverse(tree);
  return result;
}

// 执行验证
const flatList = flattenTree(departmentTree);
console.log(flatList);
方案 2:函数式编程 reduce 纯函数递归
如果你偏好无外部闭包变量的纯函数风格,可以使用 Array.prototype.reduce 配合扩展运算符或 concat。每次遍历把当前节点及其子递归结果合并返回:
function flattenByReduce(nodes) {
  if (!Array.isArray(nodes)) return [];

  return nodes.reduce((acc, node) => {
    const { children, ...item } = node;
    // 将当前项合并进累加器,若存在子项则递归合并
    return acc.concat(
      item,
      Array.isArray(children) && children.length > 0
        ? flattenByReduce(children)
        : []
    );
  }, []);
}
Array.prototype.concat 或扩展运算符 [...acc, ...child] 会在每一步创建新的临时数组对象。当树节点总数达到数万级别时,频繁的对象分配会导致垃圾回收(GC)开销上升。因此,常规业务场景更推荐方案 1 的单数组 push 方式。
方案 3:业务增强 —— 自动注入 parentId 与 level 层级
在后台管理系统的实际开发中,数据被扁平化后,往往仍需要知道某个节点的直接父级是谁、该节点处于第几层深度。我们只需在递归函数中携带上下文参数:
function flattenWithMeta(tree, parentId = null, level = 1) {
  const result = [];

  function dfs(list, pId, currentLevel) {
    if (!Array.isArray(list)) return;

    for (const item of list) {
      const { children, ...baseInfo } = item;

      // 构造带元数据的新对象
      const flatNode = {
        ...baseInfo,
        parentId: pId,
        level: currentLevel
      };
      result.push(flatNode);

      if (Array.isArray(children) && children.length > 0) {
        // 传入当前节点的 id 作为子节点的 parentId,层级递增 1
        dfs(children, item.id, currentLevel + 1);
      }
    }
  }

  dfs(tree, parentId, level);
  return result;
}
五、递归调用栈与数据收集机制深度解析
为什么经过上述几行代码,树状数据就能精确地保持“前序深度优先”展开?关键在于 JavaScript 引擎内部的执行调用栈(Call Stack)机制。
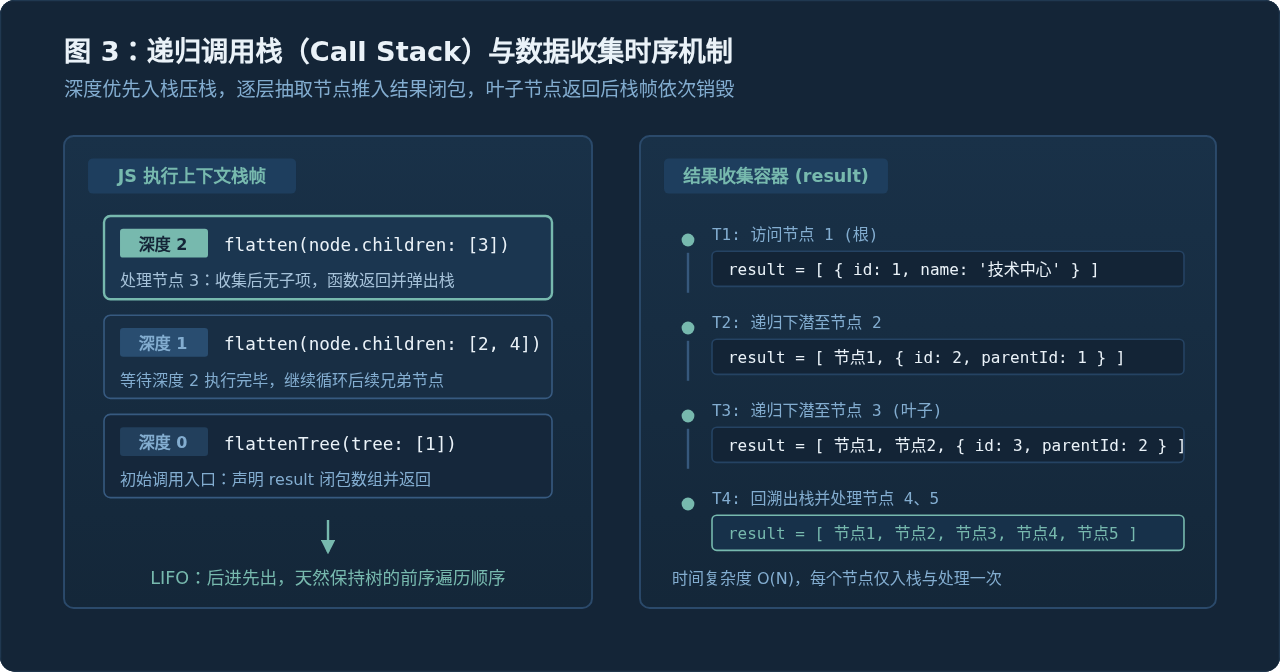
当执行 dfs(tree) 时,根节点被立刻压入结果集;随后遇到包含子节点的项,JavaScript 会将当前函数的执行上下文保存在调用栈中,并进入新的子级函数执行;直到触碰到最底部的叶子节点(即递归基 Base Case),子函数执行完毕并弹栈,控制权回到上一级函数继续遍历下一个兄弟节点。
整个算法的时间复杂度为标准的 O(N)(每个节点被访问一次),空间复杂度在最坏情况下为 O(H)(其中 H 为树的最大深度,对应调用栈的最大深度开销)。
六、方案对比与选型决策指南
针对不同的业务体量与运行环境,可结合下表及决策图选择最适配的扁平化方案:
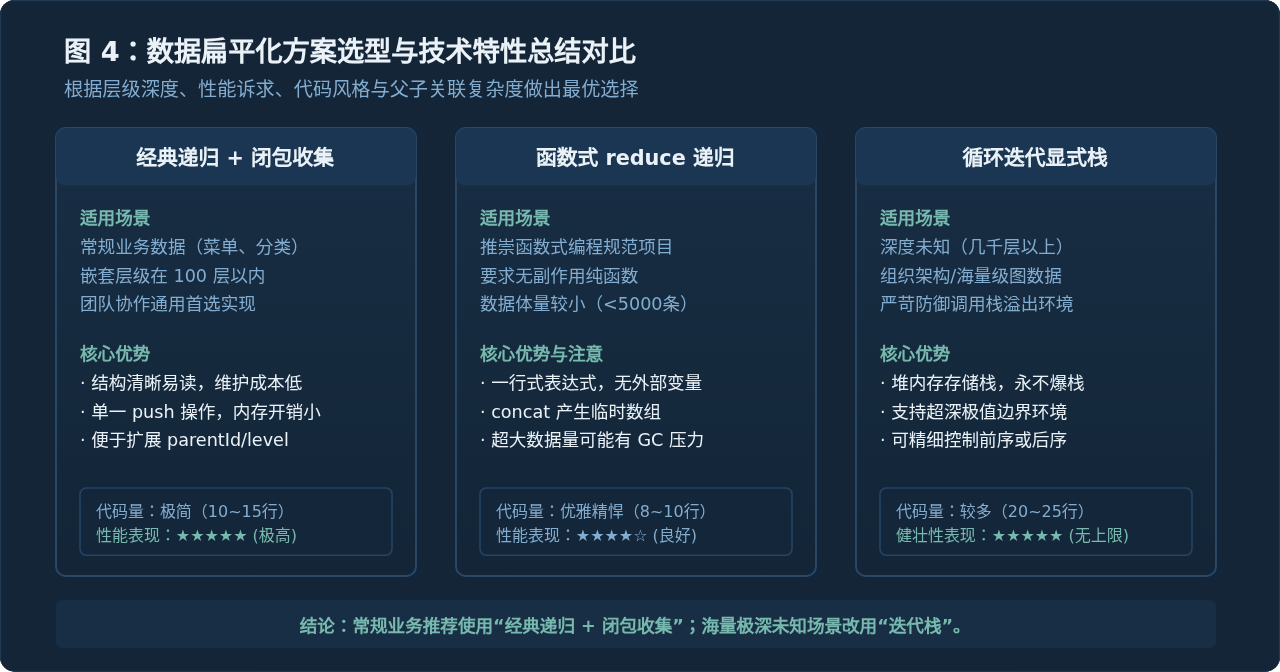
| 实现方案 | 时间复杂度 | 空间复杂度 | 适用树深度 | 优势与劣势 |
|---|---|---|---|---|
| 经典递归 + 闭包 | O(N) | O(N) + O(H) | 小于 1,000 层 | 逻辑直观、执行效率最高、改造成本低 |
| 函数式 reduce 递归 | O(N) | O(N²) (临时数组) | 小于 500 层 | 代码短小精致,但在大数据量下有 GC 压力 |
| 显式栈迭代 (非递归) | O(N) | O(N) (堆内存) | 不受调用栈限制 | 彻底杜绝栈溢出,但代码量稍大且需注意出栈顺序 |
七、关键注意事项与边界防御
1. 务必断开原对象的 children 引用
很多初学者在扁平化时直接执行 result.push(node)。这样做会导致扁平化后的一维数组中,每个对象内部仍然挂载着庞大的子树结构,造成内存翻倍占用;更严重的是,若后续对扁平数组进行了字段修改,会直接同步影响原始树对象。使用 const { children, ...cleanNode } = node 进行浅拷贝拆分是必不可少的关键步骤。
2. 防御极深层级导致的调用栈溢出(Stack Overflow)
V8 引擎等现代 JS 运行时的调用栈深度通常限制在约 10,000 层以内。如果你的业务场景涉及极端庞大的层级或不可预期的外部数据,可以通过显式数组模拟调用栈(即迭代循环 DFS)来替代递归:
/**
 * 使用堆内存显式栈模拟 DFS 扁平化(无爆栈风险)
 */
function flattenByStack(tree) {
  if (!Array.isArray(tree)) return [];
  const result = [];
  // 将初始节点逆序推入栈中,保证出栈时保持原有顺序
  const stack = [...tree].reverse();

  while (stack.length > 0) {
    const curr = stack.pop();
    const { children, ...item } = curr;
    result.push(item);

    if (Array.isArray(children) && children.length > 0) {
      // 同样逆序压入栈
      for (let i = children.length - 1; i >= 0; i--) {
        stack.push(children[i]);
      }
    }
  }
  return result;
}
3. 防范环形引用死循环
若数据在构建过程中意外产生了循环引用(例如子节点的 children 指向了父节点),递归会陷入无限死循环并触发崩溃。在通用工具库中,可使用 WeakSet 记录已经访问过的节点引用,在下潜前先进行存在性校验。
八、常见相关问题解答(FAQ)
Q1: 子节点属性名不叫 children,叫 subItems 或 list 怎么办?
可以将子节点属性名作为配置参数提取出来,例如 childrenKey = 'children',在读取时使用动态属性访问 const children = node[childrenKey],这样封装的扁平化工具函数能无缝适应不同后端接口的字段规范。
Q2: 扁平化后如何把一维数组再次还原成树结构?
还原树形结构的核心方法是使用 Map 建立 ID 映射表。先遍历一次扁平数组,以 id 为 key 存入 Map 并初始化空 children 数组;第二次遍历通过 item.parentId 在 Map 中直接找到父级对象并执行 parent.children.push(item),即可在 O(N) 时间复杂度内完成逆向重组。
递归遍历并扁平化嵌套对象数组在 JavaScript 中并无高深门槛。掌握“遍历当前层级 → 浅拷贝解构去引用 → 推入结果集 → 条件递归子项”这四步核心主线,并根据业务需求灵活追加 parentId 保持关联,即可稳健应对日常开发中绝大部分树形数据处理场景。
JS Date对象常见坑点解析:为什么月份从0开始及Invalid Date处理
2026-11-17 19:11:28
JavaScript对象封装基础:从字面量到构造函数
2026-11-17 18:07:19
为什么if(obj)无法判断JS空对象
2026-11-17 16:14:05
JavaScript怎么使用class关键字定义类
2026-11-17 15:57:28
JS防水砂浆是什么?成分解析与适用场景
2026-11-17 14:18:55







