JS表格排序怎么处理中文拼音及日期格式
深入讲解JavaScript表格排序中中文拼音与多样化日期格式的正确处理方案。解析Unicode码位与拼音排序的差异,对比localeCompare与Intl.Collator的性能表现,提供多源日期格式归一化与非法值沉底策略及完整实战代码。
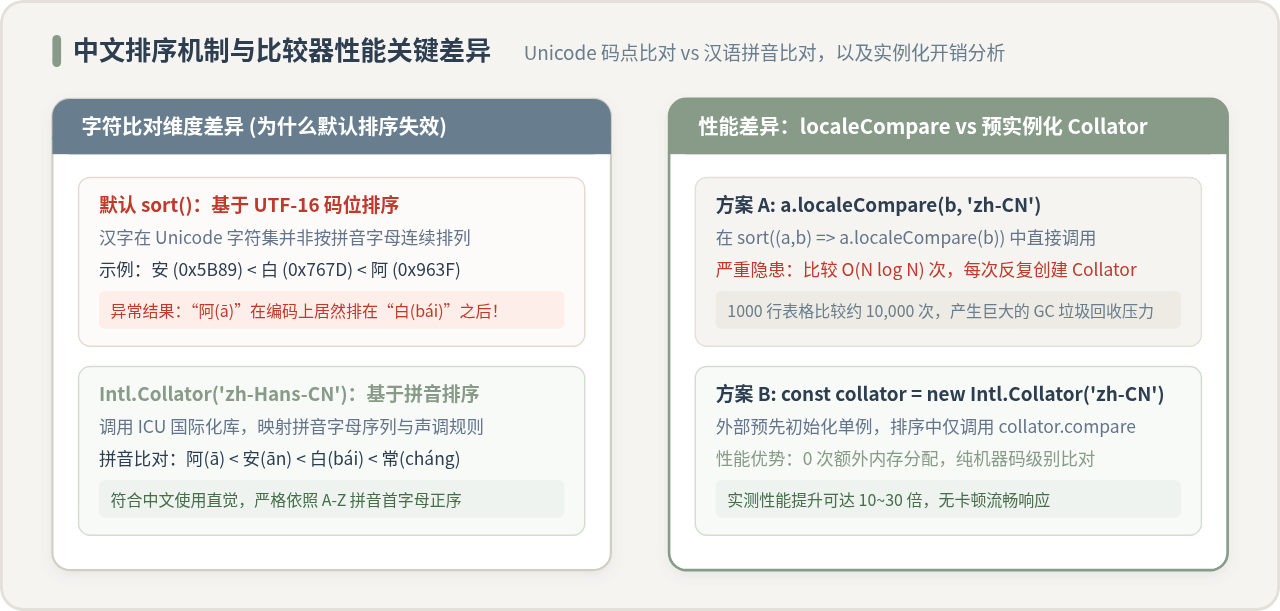
Array.prototype.sort() 默认将数组元素转换为字符串,并按照 UTF-16 码位(Unicode 编码顺序)进行字典排序。这种机制在面对汉字时无法匹配按拼音 A-Z 顺序排列的习惯,而在面对不同书写习惯的日期文本时也会出现“2023-10-1 排在 2023-9-1 之前”的字符串对齐偏差。解决这两个痛点的核心路径非常明确:针对中文列,利用现代 ECMAScript 国际化标准的 Intl.Collator('zh-Hans-CN') 进行预编译拼音比对;针对日期列,在排序前执行格式归一化并转为数值时间戳(毫秒数),结合空值沉底策略与施瓦茨变换,即可兼顾业务准确性与大数据量下的流畅渲染。
一、为什么原生排序会失效:编码与文本对齐的底层原因
很多开发者在初次实现表格排序时,会直接获取单元格的 textContent 并在比较函数中调用普通的 a > b ? 1 : -1。这种做法在处理英文单词时能够工作,但在处理中文和日期时必然产生错误排序,其背后的物理原因截然不同。
汉字在 Unicode 字符集中的位置并非按照现代汉语拼音字母的顺序分布,而是按照康熙字典部首、笔画以及各个汉字字符集的收录历史分块编排的。例如汉字“阿”的 Unicode 编码为 U+963F(十进制 38463),而汉字“白”的编码为 U+767D(十进制 30333),“安”的编码为 U+5B89(十进制 23433)。如果采用默认的码位比较,“安”排在最前,“白”次之,而本应排在最前列的“阿”反而会被排在最后。
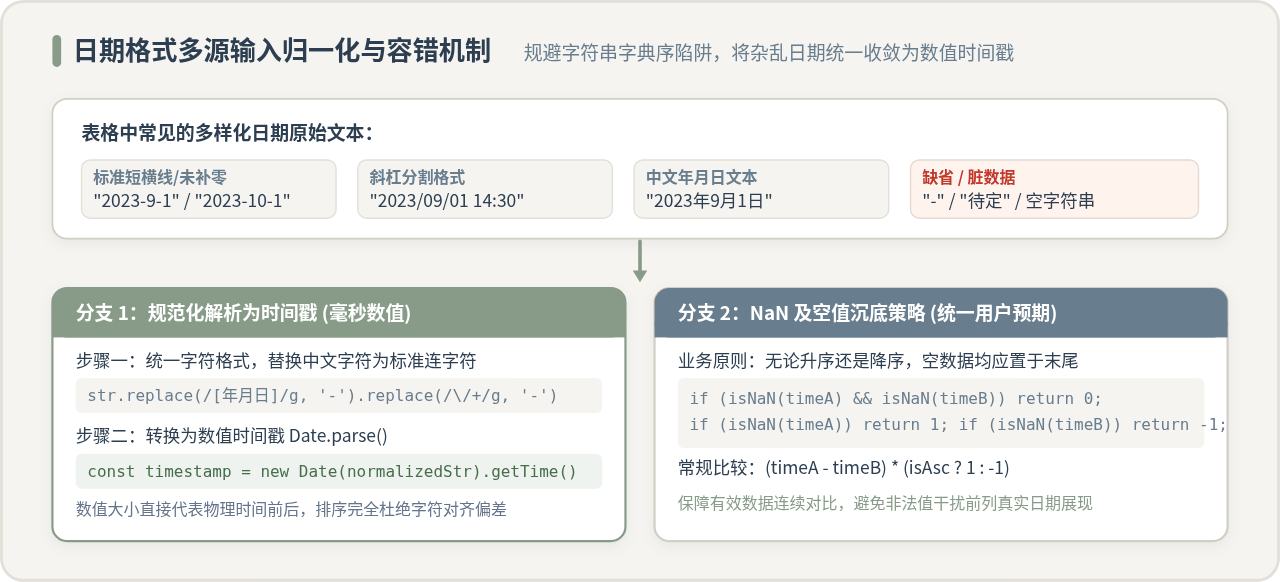
对于日期字段,表格中呈现的内容往往是由后端或用户录入的字符串,形态包括“2023-09-05”、“2023-9-5”、“2023/9/5”或“2023年9月5日”。字符串是逐字符自左向右比对编码的。当出现没有前导零填充的情况时,字符串 "2023-10-01" 的第 6 个字符是 '1',而 "2023-9-01" 的第 6 个字符是 '9'。因为字符 '1' 的 ASCII 码小于 '9',字符串比较会判定 10 月早于 9 月,完全违背了时间的连续性。
二、中文拼音排序:localeCompare 与 Intl.Collator 的关键差异
处理中文拼音排序时,现代浏览器提供了两套 API:String.prototype.localeCompare 和 Intl.Collator。尽管二者底层都依赖相同的国际化排版引擎,但在排序场景下的性能表现存在本质差异。
localeCompare 适合单次或低频比较。如果直接在数组的 sort() 回调函数中使用 (a, b) => a.localeCompare(b, 'zh-Hans-CN'),排序算法在内部执行 $O(N \log N)$ 次两两比较时,每次调用 localeCompare 都会在内部解析语言标签、验证区域选项并构建比较器上下文。对于一个拥有 1000 行数据的表格,排序过程会触发上万次内部比较,频繁创建和销毁本地化对象会导致严重的 CPU 占用与垃圾回收(GC)停顿。
相反,使用 Intl.Collator 则可以把实例化的开销移出循环。在排序开始前,先初始化一个预编译的 Collator 单例,随后直接将该实例的 compare 方法传递给排序器:
// 预编译中文拼音比较器(循环外初始化)
const chineseCollator = new Intl.Collator('zh-Hans-CN', {
  numeric: true,      // 智能识别字符串中的数字,如 "张3" 排在 "张10" 之前
  sensitivity: 'base' // 忽略音调差异,根据字形与拼音基础音排序
});

// 排序调用:直接复用单例实例的 compare 函数
rowList.sort((rowA, rowB) => {
  return chineseCollator.compare(rowA.text, rowB.text);
});
Intl.Collator 相比在 sort() 内部重复执行 localeCompare,能将整体排序耗时缩减 10 至 30 倍。对于超过数百行的表格组件,预实例化是确保界面平滑不卡顿的核心手段。
三、日期格式排序:多格式统一归一化与空值容错
表格中的日期排序绝不能直接比较文本,必须将不同表现形态的日期收敛为具有绝对时间先后意义的纯数值——毫秒时间戳(Timestamp)。
实际项目中,日期可能混合出现标准 ISO 格式(2024-03-08)、斜杠格式(2024/3/8)以及中文格式(2024年3月8日)。要实现稳健解析,可以通过轻量级的字符规整函数统一替换符号,然后交由 Date.parse() 或 new Date() 解析:
/**
 * 将任意常见日期字符串安全解析为毫秒时间戳
 * @param {string} val - 单元格文本
 * @returns {number} 毫秒时间戳,解析失败返回 NaN
 */
function parseDateToTimestamp(val) {
  if (!val || typeof val !== 'string') return NaN;
  const cleaned = val.trim();
  if (cleaned === '' || cleaned === '-' || cleaned === '待定') return NaN;

  // 将常见中文字符及斜杠统一替换为短横线
  // 如 "2024年03月08日" -> "2024-03-08"
  const normalized = cleaned
    .replace(/[年月]/g, '-')
    .replace(/日/g, '')
    .replace(/\/+/g, '-');

  const time = Date.parse(normalized);
  return isNaN(time) ? NaN : time;
}
处理空数据与非法日期的沉底策略
在真实业务表格中,单元格可能为空、显示为横杠 "-" 或暂无数据的文案。如果直接使用 timeA - timeB,遇到 NaN 时减法运算会得到 NaN。在 JavaScript 的比较规则中,NaN < 0、NaN > 0 和 NaN === 0 均为 false,这会直接破坏排序算法的传递性与一致性,导致整个表格的排列顺序发生混乱。
通用的体验法则是:无论当前是升序还是降序,空值与无效值一律排在表格的最底部。只有在两行数据都有效时,才按照正负方向比对;若两者皆为无效值,则保持其原本相对位置不变。
四、避免 DOM 频繁重排:施瓦茨变换与批量挂载
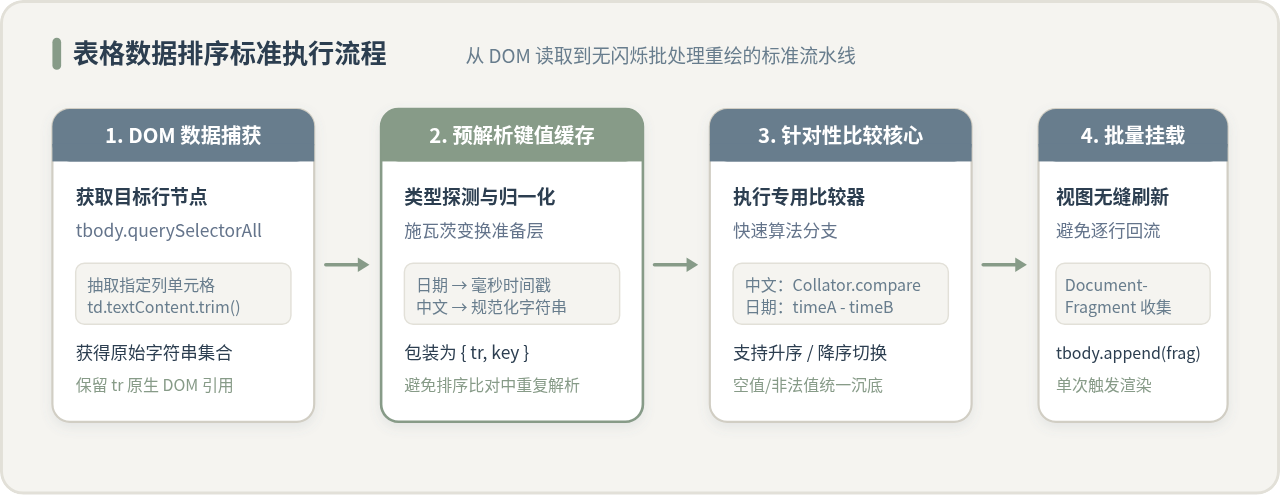
许多初学者直接在 sort() 函数的每次回调中读取 DOM 节点的 textContent 并执行字符串清洗。如果表格有 500 行,执行了约 4000 次元素比对,就意味着浏览器需要查询 8000 次 DOM 节点文本,并反复执行 8000 次正则替换与日期转换。这种重复计算不仅浪费资源,还会触发不必要的重排检查。
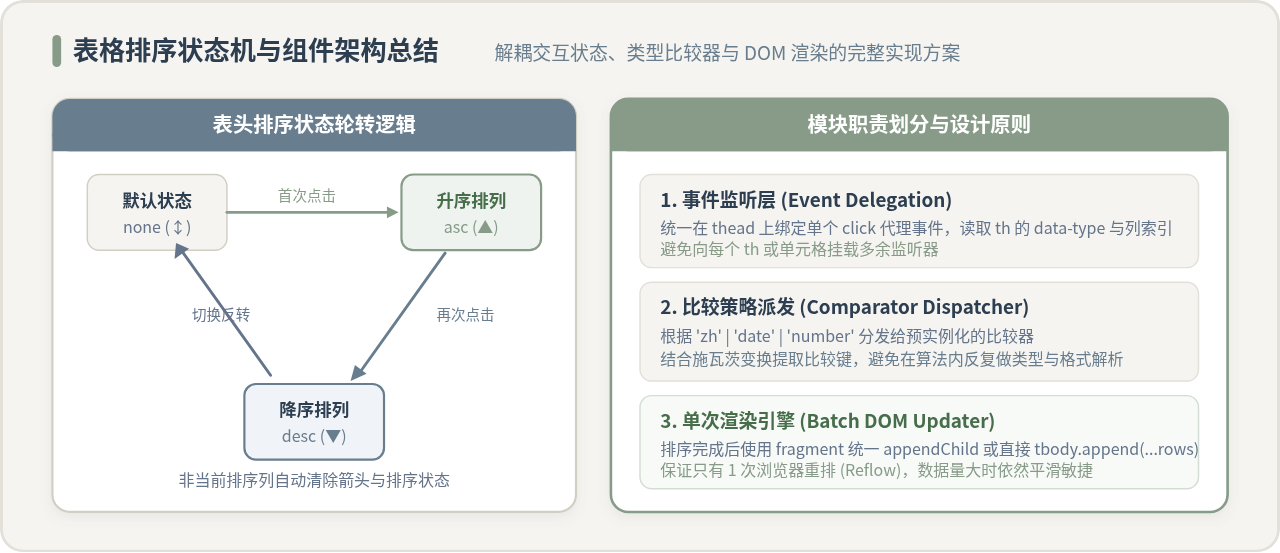
推荐的做法是采用施瓦茨变换(Schwartzian Transform,即 Decorate-Sort-Undecorate 模式):
- 包装(Decorate):在排序前遍历一次表格行,将行 DOM 节点
tr与预解析好的比较键(归一化后的拼音字符串或时间戳)打包为一个轻量中间对象{ row, key }。 - 排序(Sort):对中间数组执行排序,比较函数内部只做纯数值减法或 Collator 比对,耗时极短。
- 解包与渲染(Undecorate & Render):遍历排好序的数组提取原始
tr引用。使用DocumentFragment或原生tbody.append(...sortedRows)一次性把所有节点更新回文档树中,浏览器仅发生一次重排与绘制。
五、可直接运行的完整实现代码
下面是一个具备中文拼音支持、多格式日期解析、空值自动沉底以及状态切换箭头的完整表格排序器示例。读者可以直接在本地 HTML 文件中运行验证。
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <style>
    table.sortable-table {
      width: 100%;
      border-collapse: collapse;
      font-family: sans-serif;
    }
    table.sortable-table th, table.sortable-table td {
      padding: 10px 14px;
      border: 1px solid #E2E0D8;
      text-align: left;
    }
    table.sortable-table th {
      background: #F5F4F0;
      cursor: pointer;
      user-select: none;
    }
    table.sortable-table th:hover {
      background: #EAE8E2;
    }
    th .sort-indicator {
      display: inline-block;
      margin-left: 6px;
      color: #879B88;
      font-size: 0.85em;
    }
  </style>
</head>
<body>

  <table id="employeeTable" class="sortable-table">
    <thead>
      <tr>
        <th data-col="0" data-type="text">工号<span class="sort-indicator">↕</span></th>
        <th data-col="1" data-type="zh">姓名(中文拼音)<span class="sort-indicator">↕</span></th>
        <th data-col="2" data-type="date">入职日期<span class="sort-indicator">↕</span></th>
        <th data-col="3" data-type="number">绩效评分<span class="sort-indicator">↕</span></th>
      </tr>
    </thead>
    <tbody>
      <tr><td>E102</td><td>白敬亭</td><td>2023-10-01</td><td>92</td></tr>
      <tr><td>E105</td><td>阿木</td><td>2023-9-1</td><td>88</td></tr>
      <tr><td>E101</td><td>常乐</td><td>2024年1月15日</td><td>95</td></tr>
      <tr><td>E108</td><td>安宁</td><td>2022/12/30</td><td>89</td></tr>
      <tr><td>E109</td><td>张一山</td><td>-</td><td>85</td></tr>
      <tr><td>E103</td><td>鲍蕾</td><td>2023-05-18</td><td>90</td></tr>
    </tbody>
  </table>

  <script>
    (function initTableSorter() {
      const table = document.getElementById('employeeTable');
      const thead = table.querySelector('thead');
      const tbody = table.querySelector('tbody');

      // 预编译中文拼音比较器单例
      const zhCollator = new Intl.Collator('zh-Hans-CN', {
        numeric: true,
        sensitivity: 'base'
      });

      // 记录各列当前排序状态:null | 'asc' | 'desc'
      const sortStates = {};

      // 日期解析工具
      function parseDateValue(text) {
        if (!text) return NaN;
        const s = text.trim();
        if (s === '' || s === '-' || s === '待定') return NaN;
        const normalized = s.replace(/[年月]/g, '-').replace(/日/g, '').replace(/\/+/g, '-');
        const ts = Date.parse(normalized);
        return isNaN(ts) ? NaN : ts;
      }

      // 事件委托处理表头点击
      thead.addEventListener('click', function(e) {
        const th = e.target.closest('th');
        if (!th) return;

        const colIndex = parseInt(th.dataset.col, 10);
        const colType = th.dataset.type || 'text';

        // 切换排序状态:默认 -> asc -> desc -> asc
        const currentOrder = sortStates[colIndex] === 'asc' ? 'desc' : 'asc';
        sortStates[colIndex] = currentOrder;

        // 更新表头指示图标
        thead.querySelectorAll('th').forEach(header => {
          const indicator = header.querySelector('.sort-indicator');
          if (header === th) {
            indicator.textContent = currentOrder === 'asc' ? ' ▲' : ' ▼';
          } else {
            indicator.textContent = ' ↕';
            delete sortStates[header.dataset.col];
          }
        });

        // 步骤 1:施瓦茨变换预包装
        const rows = Array.from(tbody.querySelectorAll('tr'));
        const decorated = rows.map(tr => {
          const cellText = tr.children[colIndex].textContent.trim();
          let key;

          if (colType === 'date') {
            key = parseDateValue(cellText);
          } else if (colType === 'number') {
            const num = parseFloat(cellText);
            key = isNaN(num) ? NaN : num;
          } else {
            key = cellText;
          }

          return { tr, key };
        });

        // 步骤 2:执行专用排序
        const isAsc = currentOrder === 'asc';
        decorated.sort((itemA, itemB) => {
          const a = itemA.key;
          const b = itemB.key;

          // 空值/无效值统一沉底逻辑
          const isAInvalid = a === '' || (typeof a === 'number' && isNaN(a));
          const isBInvalid = b === '' || (typeof b === 'number' && isNaN(b));

          if (isAInvalid && isBInvalid) return 0;
          if (isAInvalid) return 1;  // A 为空,下移
          if (isBInvalid) return -1; // B 为空,上移

          // 根据字段类型进行比较
          let result = 0;
          if (colType === 'zh') {
            result = zhCollator.compare(a, b);
          } else if (colType === 'date' || colType === 'number') {
            result = a - b;
          } else {
            result = a > b ? 1 : (a < b ? -1 : 0);
          }

          return isAsc ? result : -result;
        });

        // 步骤 3:单次重绘回写 DOM
        const fragment = document.createDocumentFragment();
        decorated.forEach(item => fragment.appendChild(item.tr));
        tbody.appendChild(fragment);
      });
    })();
  </script>
</body>
</html>
六、实践中的注意事项与边界处理
在实际企业级系统或复杂数据交互中,还有几个细节需要格外留意:
- 混合包含数字的汉字排序:如果表格中存在诸如“第2车间”、“第10车间”这类包含连续数字的中文,请务必在
Intl.Collator选项中显式设置numeric: true。开启后,比较器会将数字当作数值大小比对,确保“第2车间”排在“第10车间”前面,而不是根据字符 '2' 与 '1' 的 ASCII 码把第 10 错排在前面。 - 时区带来的毫秒偏移:当日期格式不带时区信息时,
Date.parse('2024-03-08')在不同浏览器中可能被解释为 UTC 零点或本地时间零点。如果仅用于排序比较,只要整列格式保持一致,统一使用时间戳差值不会影响日期的前后相对顺序;但若涉及跨格式、跨时区的数据,建议解析时统一使用明确的年月日数值构建。 - 大数据量虚拟滚动:如果单页表格数据超过数千行,无论如何优化排序算法,DOM 节点的重新挂载都会导致页面掉帧。此时排序算法应完全在内存数据层(Raw Data Array)中运行,完成排序后仅向视图提供当前可视区域窗口内的数据,从根源上解除渲染瓶颈。
七、总结
解决 JavaScript 表格排序中的中文与日期问题,本质上是“将人类习惯的可读字符,转换为计算机能够严谨判断先后顺序的标准数据结构”:
通过预实例化 Intl.Collator('zh-Hans-CN'),不仅让汉字按拼音首字母正确定位,还能消除在排序循环中反复构建本地化对象的性能开销;通过字符串清理与时间戳转换,杜绝了无补零日期带来的字符字典序错位;再辅以空值沉底规则与施瓦茨变换缓存,就能在任何前端表格中实现高效、平滑、符合中文用户习惯的交互体验。
JS怎么从数组中随机选取一个或多个不重复元素
2026-11-17 15:48:43
怎么用正则判断JS字符串是否为科学计数法
2026-11-17 15:17:10
JS模板字符串怎么实现多行文本与换行(替代+号拼接)
2026-11-17 08:38:39
基于JavaScript大小写敏感的命名规范:camelCase与PascalCase最佳实践
2026-11-16 18:13:19
怎么判断JavaScript对象是否继承了某个原型
2026-11-16 18:13:16