JS怎么从数组中随机选取一个或多个不重复元素
深入解析在JavaScript中从数组中随机选取一个或多个不重复元素的工程级解决方案,涵盖单元素O(1)定位、sort伪随机陷阱剖析、Partial Fisher-Yates部分洗牌算法实现与边界防范。
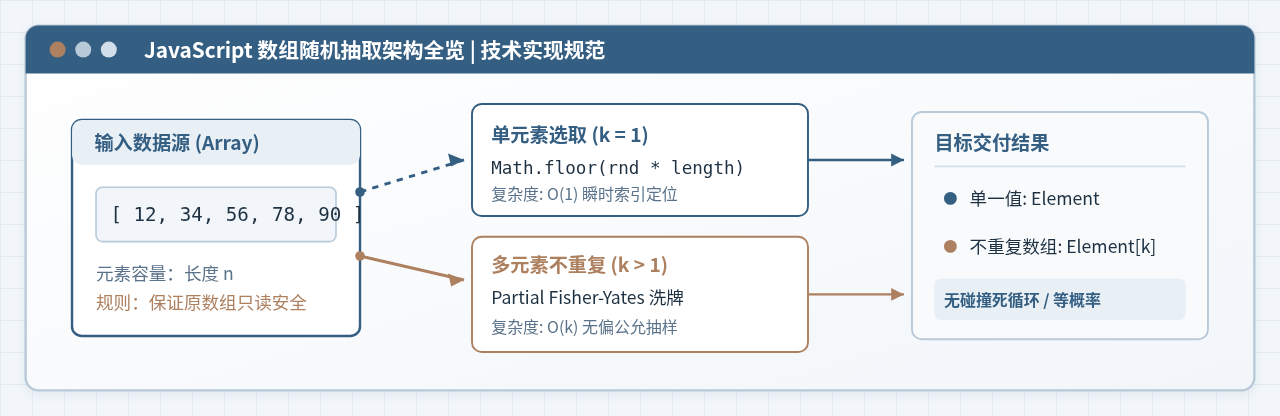
Math.floor(Math.random() * arr.length) 计算离散下标,耗时仅需 O(1);如果需要选取多个不重复元素,应基于浅拷贝副本执行 Partial Fisher-Yates(局部洗牌)算法,不仅能严格保证每个元素抽取的概率均等,还能将时间复杂度压缩到 O(k),同时彻底杜绝原地篡改原数组和死循环碰撞的风险。
一、随机选取单个元素:数学原理与安全实现
从已有数组中随机抽取一个元素,是前端与后端业务中最为高频的操作之一。在底层逻辑上,数组是由从 0 到 arr.length - 1 的连续连续离散整数下标构成的。因此,选取单元素的本质就是生成一个在该闭区间内均匀分布的随机整数。
1. 核心公式与执行步骤
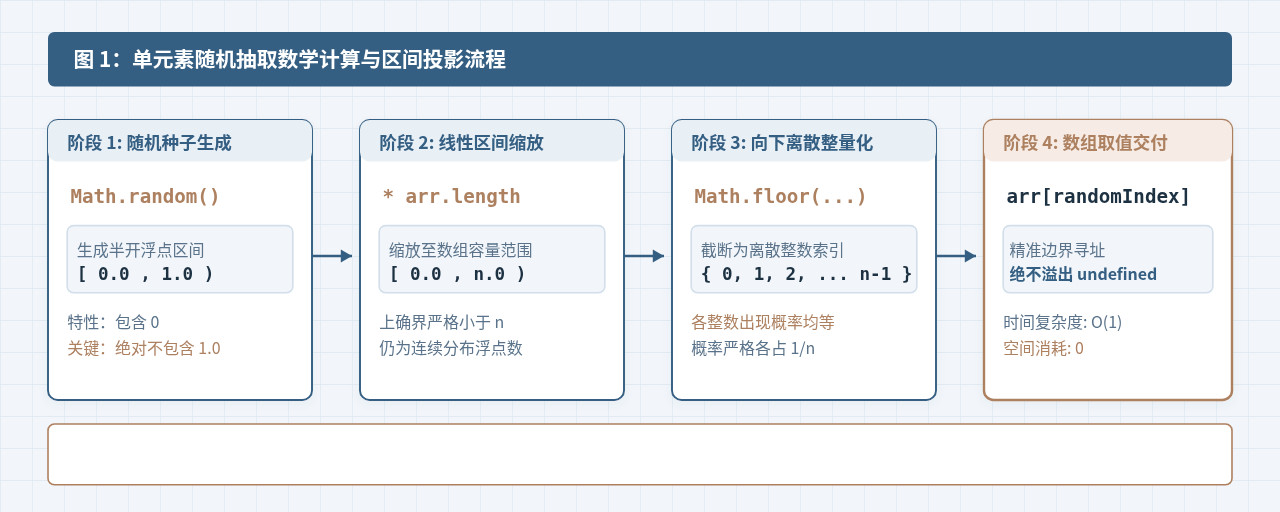
JavaScript 提供了内置的 Math.random() 方法,该方法返回一个在半开区间 [0, 1) 内的伪随机浮点数(即包含 0,但严格小于 1)。完整计算链路如下:
- 区间缩放:将
Math.random()的返回值乘以数组长度arr.length(记为 n),将值域线性放大为[0, n)的浮点数。 - 向下截断:通过
Math.floor()执行向下取整,浮点数被离散化映射为集合{0, 1, 2, ..., n-1}中的整数。由于每个整数区间的长度恰好均为 1,因此每个下标命中的概率均为严格的1/n。 - 下标访问:以计算出的整数作为索引从数组中读取元素。
// 基础用法示例
const fruits = ['苹果', '香蕉', '橙子', '西瓜', '葡萄'];

const randomIndex = Math.floor(Math.random() * fruits.length);
const selectedFruit = fruits[randomIndex];

console.log('随机选中的水果:', selectedFruit);
// 示例输出: 随机选中的水果: 西瓜初学者容易错误地使用 Math.round(Math.random() * (arr.length - 1))。四舍五入会导致端点值 0 与 n-1 的采样概率仅为中间值的一半(因为 0 仅在 [0, 0.5) 产生,而 1 在 [0.5, 1.5) 产生,覆盖区间为端点的 2 倍)。若直接使用 Math.floor 配合 * arr.length,每个槽位的取值区间均为标准单位 1,分布绝对均匀。
2. 生产级单选函数封装与边界防御
在实际工程代码中,必须对空数组、非数组入参进行严格校验,避免因访问越界产生未捕获的逻辑异常:
/**
 * 从数组中随机获取单个元素
 * @template T
 * @param {T[]} arr - 目标数组
 * @returns {T | undefined} 返回抽取的元素,若数组为空则返回 undefined
 */
function getRandomElement(arr) {
  if (!Array.isArray(arr) || arr.length === 0) {
    return undefined;
  }
  const index = Math.floor(Math.random() * arr.length);
  return arr[index];
}

// 验证用例
console.log(getRandomElement(['A', 'B', 'C'])); // 示例输出: 'B'
console.log(getRandomElement([]));               // 示例输出: undefined
console.log(getRandomElement(null));             // 示例输出: undefined
二、随机选取多个不重复元素:两个常见代码陷阱
当需求升级为“从长度为 n 的数组中随机抽取 k 个互不相同的元素”时,很多开发者会尝试使用更短或直觉化的写法,但这些写法往往潜藏严重的算法缺陷和稳定性风险。
陷阱一:使用 arr.sort(() => Math.random() - 0.5)
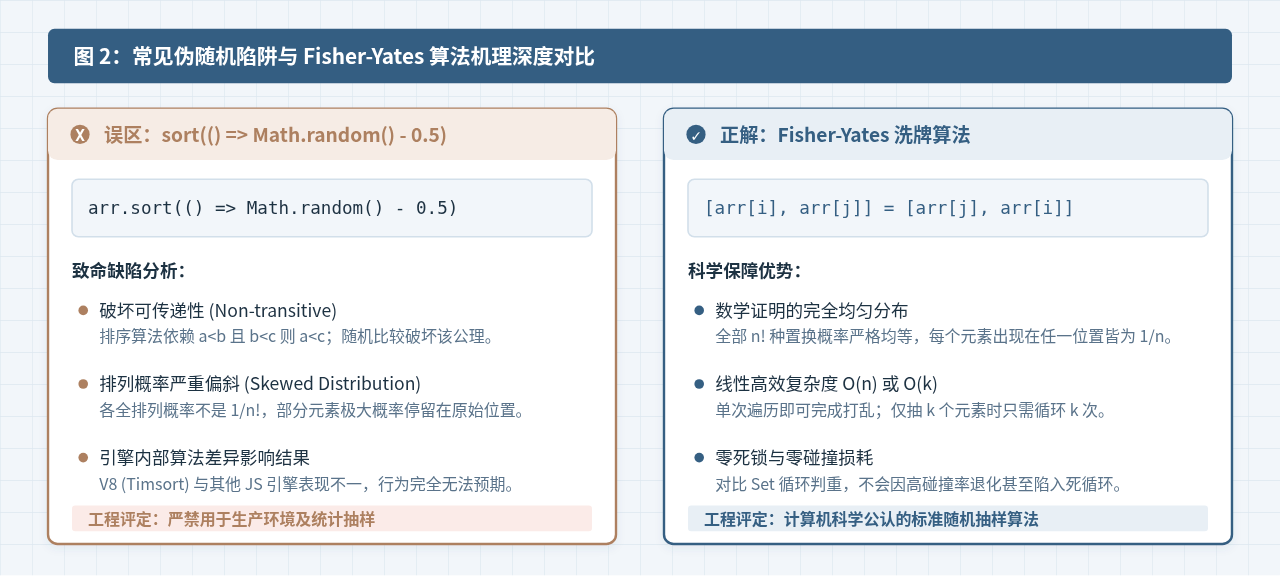
这是在网络博客中流传最广但也是危害最大的写法。其逻辑是试图给排序比较器注入随机的正负值,随后通过 slice(0, k) 截取前 k 项:
// 错误示范:切勿在生产环境中使用!
function badRandomSample(arr, k) {
  return [...arr].sort(() => Math.random() - 0.5).slice(0, k);
}该写法的本质缺陷在于:现代 JavaScript 引擎(如 V8 的 Timsort 算法)的排序机制严格依赖于比较函数的“传递性”(Transitivity)。即若 A > B 且 B > C,则必然推导出 A > C。传入非确定性的随机比较函数会直接破坏排序算法的内部状态机,造成比较次数不足、元素跳过比较等问题。统计学测试证明,该方式生成的排列概率分布极度不均,原本在靠前位置的元素有极大概率依然留在前面,无法做到真正的随机抽样。
陷阱二:基于 Set 或 while 循环碰撞判重
另一种直觉写法是:每次生成一个随机下标,若已在集合中则继续循环重试,直至收集齐 k 个不同的元素:
// 低效示范:当 k 接近数组长度时性能急剧恶化
function collisionRandomSample(arr, k) {
  const result = new Set();
  while (result.size < k) {
    const item = arr[Math.floor(Math.random() * arr.length)];
    result.add(item);
  }
  return Array.from(result);
}
这种方法在 k 极小(例如从 10000 个元素中选 2 个)时表现尚可。但随着已选数量增加,随机数发生碰撞的概率呈指数级上升。当 k 接近数组总长时(如从 100 个元素中选 99 个),最后几个元素需要经历数十乃至上百次无谓的重复计算;一旦调用方传入了包含重复值的数组或传入了 k > arr.length,代码将直接陷入不可逆的死循环,导致整个主线程崩溃卡死。
三、公允高效的标准解法:Fisher-Yates(洗牌)算法
解决多个不重复抽样问题的计算机科学金标准,是 Fisher-Yates 洗牌算法(在现代计算机实现中通常指由 Richard Durstenfeld 和 Donald Knuth 改良的版本)。
1. 算法核心原理
该算法通过在数组末端建立“已抽取区”和前端的“未抽取区”:
- 从数组的最后一个下标
i = arr.length - 1开始倒序遍历。 - 在未处理区间
[0, i]内随机挑选一个下标j。 - 将下标
i和j处的两个元素进行值互换。 - 下标
i递减,原本的末尾项进入“已抽取确认区”,不再参与后续选拔。
数学归纳法已严格证明:对于包含 n 个元素的数组,该算法生成的全部 n! 种全排列方案出现的概率严格等于 1 / n!,具有绝对的统计学公允性。
2. 原数组免疫原则与全量打乱实现
在函数式编程与现代前端规范中,工具函数不应产生外部副作用(Side-effects)。执行置换前,必须先利用 ES6 扩展运算符 [...arr] 或 arr.slice() 生成浅拷贝副本:
/**
 * 对数组进行全量无偏洗牌(不修改原数组)
 * @template T
 * @param {T[]} arr
 * @returns {T[]} 返回全新打乱顺序的数组
 */
function shuffle(arr) {
  if (!Array.isArray(arr)) return [];
  const copy = [...arr];

  for (let i = copy.length - 1; i > 0; i--) {
    // 在 [0, i] 闭区间内选取随机索引
    const j = Math.floor(Math.random() * (i + 1));
    // ES6 解构赋值实现高效元素互换
    [copy[i], copy[j]] = [copy[j], copy[i]];
  }

  return copy;
}
四、进阶优化:Partial Fisher-Yates(部分洗牌法)
如果数组总长度 n 非常大(例如 100,000 条数据),但我们仅仅需要从中不重复抽取 k 个元素(例如 5 个),将整个数组完全打乱显然存在大量的 CPU 算力浪费。
由于 Fisher-Yates 算法每完成一次循环,就能在数组末尾确立一个绝对公正的独立随机项,因此我们根本不需要遍历整个数组,只需要精确迭代 k 次即可提前终止。这就是局部洗牌法(Partial Shuffle)。
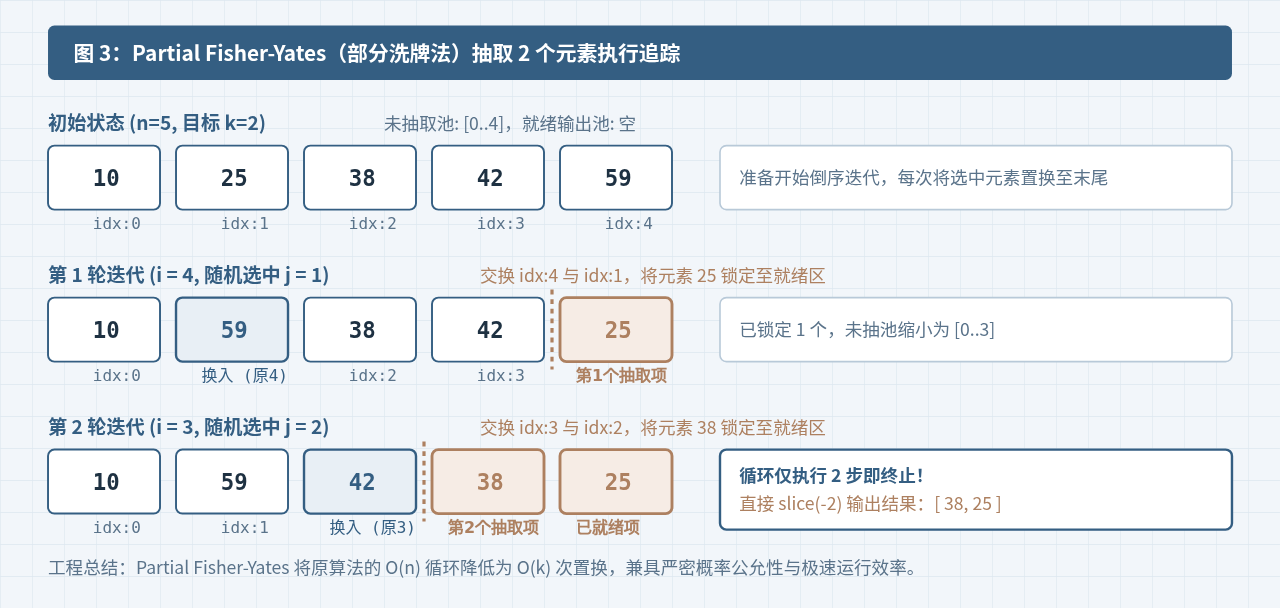
1. 通用工业级抽取函数实现
结合完整的参数校验、边界处理(如 k 大于数组长度时截断)以及性能优化,最终实现如下:
/**
 * 从数组中随机选取指定数量的不重复元素(保持原数组纯净)
 * @template T
 * @param {T[]} arr - 目标数据源
 * @param {number} count - 需抽取的不重复元素数量
 * @returns {T[]} 返回包含抽取结果的新数组
 */
function getRandomElements(arr, count) {
  // 1. 基础防御性校验
  if (!Array.isArray(arr) || arr.length === 0 || typeof count !== 'number' || count <= 0) {
    return [];
  }

  // 2. 浅拷贝数组,隔绝外部副作用
  const pool = [...arr];
  const total = pool.length;

  // 3. 边界规整:抽取数量不得超过源数据总量
  const k = Math.min(Math.floor(count), total);

  // 4. 部分洗牌:仅执行 k 次末尾交换
  for (let i = total - 1; i >= total - k; i--) {
    const j = Math.floor(Math.random() * (i + 1));
    [pool[i], pool[j]] = [pool[j], pool[i]];
  }

  // 5. 截取最后 k 个已确定无偏就绪的元素
  return pool.slice(total - k);
}
2. 代码执行效果与使用示例
// 基础抽样演示
const candidates = ['研发部-张三', '运营部-李四', '产品部-王五', '市场部-赵六', '测试部-钱七'];

console.log('抽选 2 人中奖:', getRandomElements(candidates, 2));
// 示例输出: 抽选 2 人中奖: [ '测试部-钱七', '研发部-张三' ]

console.log('原数组未受污染:', candidates);
// 示例输出: [ '研发部-张三', '运营部-李四', '产品部-王五', '市场部-赵六', '测试部-钱七' ]

// 边界容错测试
console.log('负数抽取:', getRandomElements(candidates, -1)); // 示例输出: []
console.log('超量抽取:', getRandomElements(candidates, 10)); // 示例输出: 5个元素的全排列随机数组
五、算法选型决策与关键技术指标对比
在面对不同的业务场景与数据规模时,应遵循规范的工程选型决策路径,避免盲目使用复杂度过高或存在隐患的实现手段。
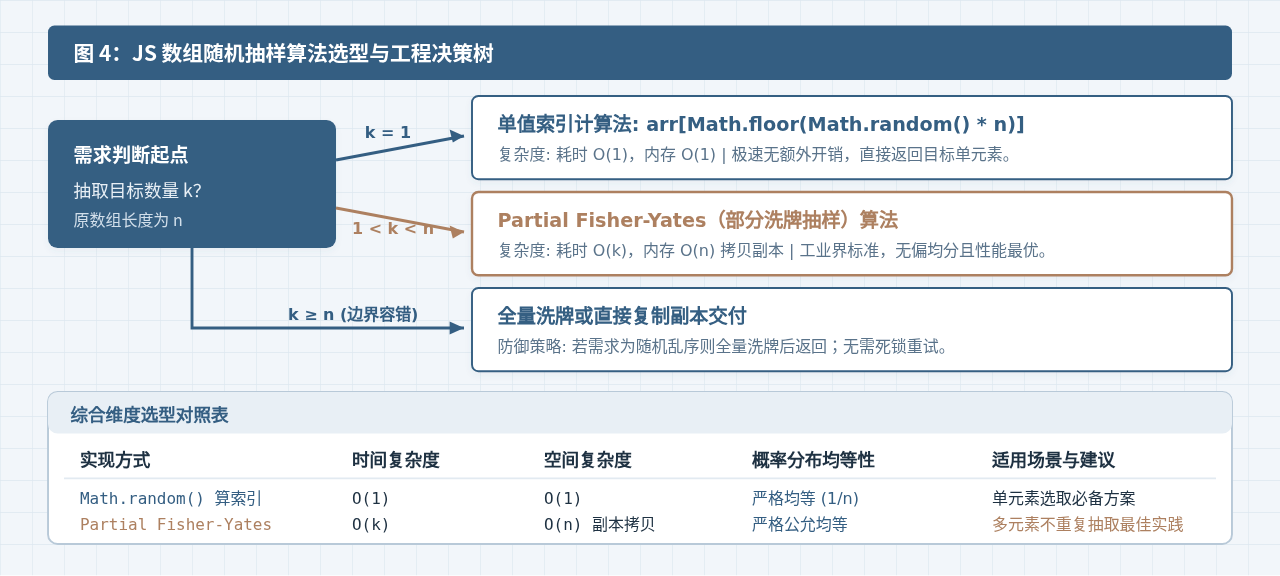
| 技术方案 | 时间复杂度 | 额外空间 | 概率公平性 | 典型适用场景与评价 |
|---|---|---|---|---|
| Math.floor 索引法 | O(1) |
O(1) |
严格均匀 | 单个随机元素抽取;无任何多余开销,效率极高。 |
| Partial Fisher-Yates | O(k) |
O(n) (副本) |
严格均匀 | 推荐首选。抽取 k 个不重复元素,兼顾严密公允性与极限执行效率。 |
| Full Fisher-Yates | O(n) |
O(n) |
严格均匀 | 需要将整个数组完全打乱(如卡牌发牌、洗牌播放列表)。 |
| Set 循环判重法 | 不稳定 (高碰撞) | O(k) |
均匀 (有死锁风险) | 仅在 k ≪ n 且数组元素均为原始唯一标量时勉强可用;不推荐。 |
| sort() 随机比较法 | O(n log n) |
O(n) |
严重偏斜 | 严禁使用。底层违背比较函数传递性公理,排列严重失真。 |
总结与工程落地清单
- 抽 1 个:牢记公式
arr[Math.floor(Math.random() * arr.length)],杜绝使用Math.round。 - 抽多个不重复:优先选用 Partial Fisher-Yates,循环 k 次即止,时间复杂度直接降至
O(k)。 - 数据纯净保障:永远优先在
[...arr]浅拷贝副本上进行交换与抽取,严禁原地篡改外部入参数组。 - 参数边界处理:严密处理
count <= 0、空数组、非数组及count > arr.length等极端输入,确保函数健壮可靠。
怎么用正则判断JS字符串是否为科学计数法
2026-11-17 15:17:10
JS模板字符串怎么实现多行文本与换行(替代+号拼接)
2026-11-17 08:38:39
基于JavaScript大小写敏感的命名规范:camelCase与PascalCase最佳实践
2026-11-16 18:13:19
怎么判断JavaScript对象是否继承了某个原型
2026-11-16 18:13:16
JS日期相减结果为NaN的原因及解决方法
2026-11-16 18:13:08