

JS中atob/btoa与TextEncoder处理二进制的区别是什么
深入解析JavaScript中atob/btoa与TextEncoder在处理二进制数据时的本质区别。分析数据形态、Unicode支持、内存模型与适用场景,并提供安全转换与避坑实践指南。
在 JavaScript 开发中,atob / btoa 与 TextEncoder / TextDecoder 经常出现在处理网络请求、文件传输与加密算法的代码中。许多开发者容易将它们混同为“字符串转二进制”的并列工具,但它们在底层数据形态、字符集规范、内存表示以及设计目标上存在根本差异。本文将拆解两者的工作原理与边界,帮助你在开发中准确选型并避免常见的异常与乱码陷阱。
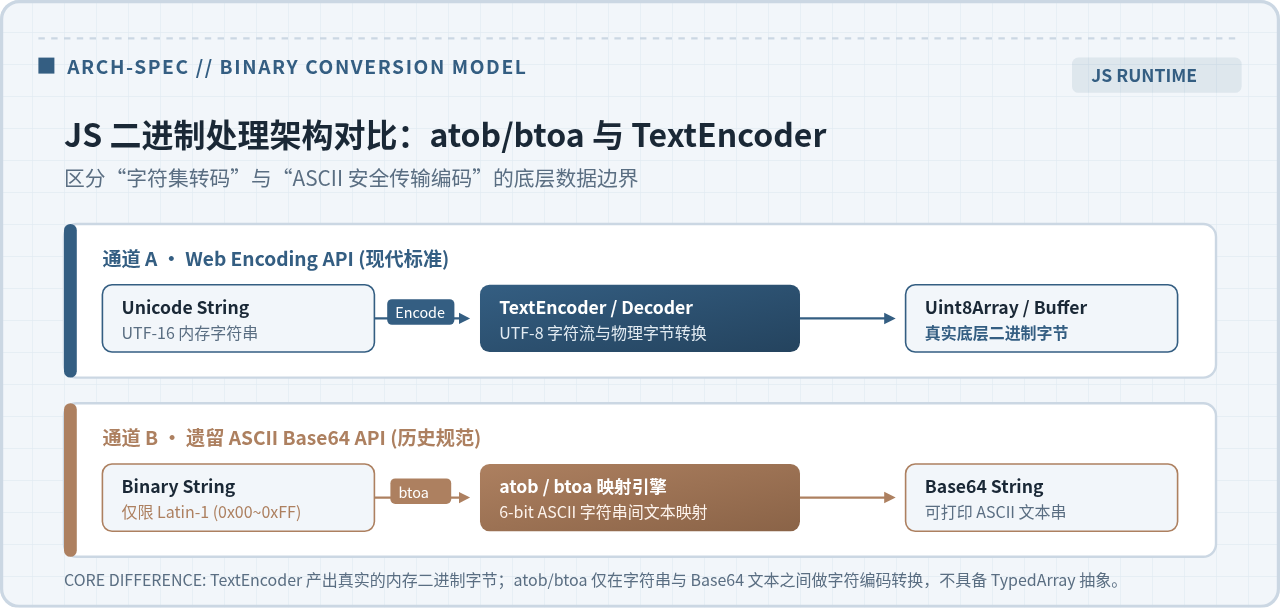
一、核心结论:一分钟看清本质差异
用一句话概括核心区别:TextEncoder 是真正处理物理内存二进制字节的字符集编码器,而 atob / btoa 只是在普通字符串与 Base64 编码字符串之间做映射的 ASCII 传输工具,其本身从未直接产出或消费真实的二进制缓冲区(TypedArray)。
具体体现在以下三个根本差异点:
- 数据类型不同:
TextEncoder.encode()的输出是原生Uint8Array(物理内存上的真实字节数组);而btoa()的输入和输出始终是 JavaScriptString(字符串对象)。 - 字符范围与编码规则不同:
TextEncoder遵循标准的 UTF-8 编码算法,能够编码全量 Unicode 字符(包括中文字符与 Emoji);而btoa()仅支持 8 位 Latin-1 范围字符(即字符码点位于0x00 ~ 0xFF),一旦传入中文字符就会直接抛出InvalidCharacterError异常。 - 历史时代与接口定位不同:
atob/btoa是早年浏览器 DOM 规范留下的遗留 API,用于将 8 位的二进制模拟字符串序列化为网络传输安全的 Base64 ASCII 文本;而TextEncoder是现代通用的 Web Encoding API 标准,为 TypedArray、WebAssembly、WebCrypto 等底层二进制生态提供支撑。
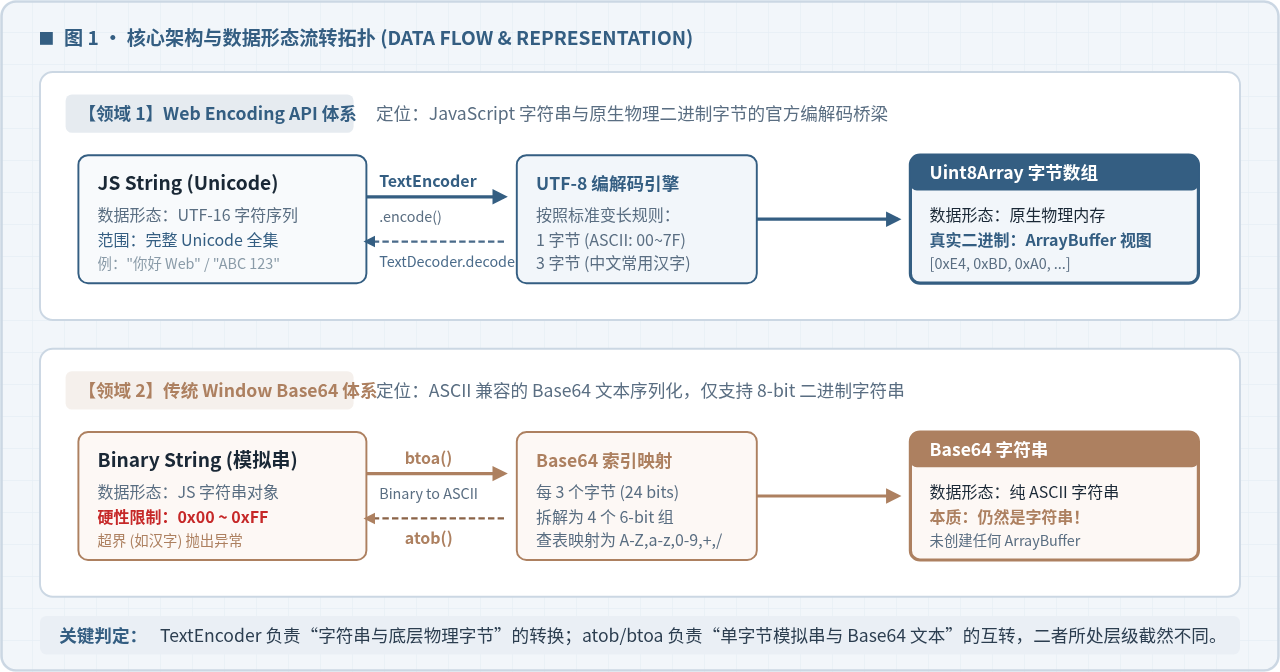
二、深入 atob 与 btoa:为何它不是真正的二进制 API
函数名称 btoa 代表 “binary to ASCII”,atob 代表 “ASCII to binary”。从命名上看容易让人误以为它能直接操纵二进制,但这里的“binary”是历史沿用的称谓,指的是“单字节二进制模拟字符串”(Binary String)。
1. btoa 的运行规则与 Latin-1 约束
在早期 JavaScript 尚未引入 ArrayBuffer 和 TypedArray 时,开发者通常使用普通字符串模拟二进制数据:将每个字符的 16 位 Unicode 码元强制限制在低 8 位(即每个字符只代表 1 个字节,取值范围 0 ~ 255)。
btoa(stringToEncode) 接受这样一个字符串,读取其中每个字符的低 8 位,将其重组为 6 位的 Base64 字符流。如果字符串中存在任何大于 255 的字符,btoa 无法将其视为 1 个字节,便会立刻中断并报错:
// 示例 1:纯 ASCII 字符串可以正常转换
const asciiStr = "Hello World";
const base64Str = window.btoa(asciiStr);
console.log(base64Str); // 输出: "SGVsbG8gV29ybGQ="

// 示例 2:中文字符直接调用 btoa 抛出异常
try {
  window.btoa("你好");
} catch (err) {
  console.error(err.name); // 输出: "InvalidCharacterError"
  console.error(err.message);
  // 输出: "Failed to execute 'btoa' on 'Window': The string to be encoded contains characters outside of the Latin1 range."
}
由于 btoa 的参数声明为字符串类型,如果传入 Uint8Array,JavaScript 运行时会隐式调用其 .toString() 方法,实际转换的是 "[object Uint8Array]" 这个字符串,导致计算出的 Base64 结果完全错误且无法恢复!
const bytes = new Uint8Array([72, 101, 108, 108, 111]); // "Hello"
console.log(window.btoa(bytes));
// 错误结果: "W29iamVjdCBVaW50OEFycmF5XQ==" (这是 "[object Uint8Array]" 的 Base64)
2. atob 的真实返回值
执行 atob(base64String) 同样只返回一个普通字符串。如果要恢复成物理二进制数据供后续处理,开发者必须手动遍历该字符串,逐个提取字符码点并写入 Uint8Array。
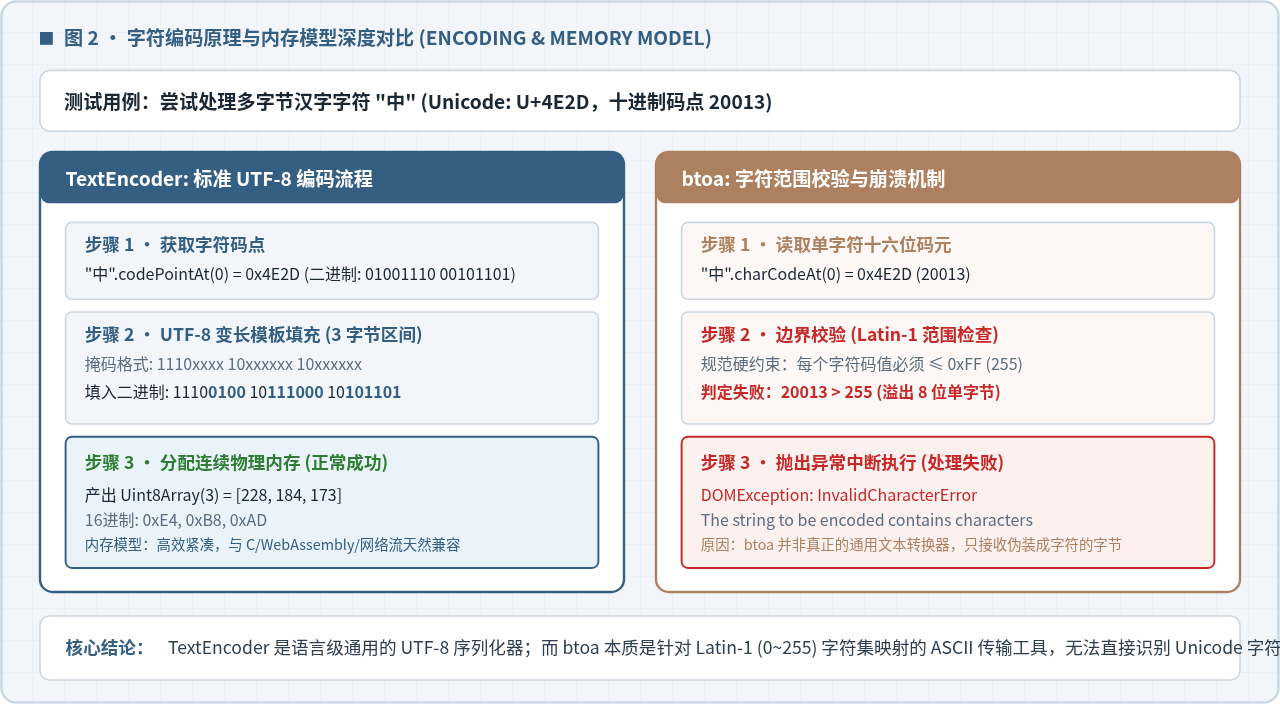
三、深入 TextEncoder 与 TextDecoder:现代二进制的标准通道
为了统一浏览器与服务端中字符与真实字节的转换,WHATWG 推出了 Web Encoding API,其核心就是 TextEncoder 与 TextDecoder。
1. TextEncoder 负责“字符串 → UTF-8 真实字节”
根据规范,TextEncoder 专用于将 JavaScript 内存中的 Unicode 字符串(UTF-16 形式存储)编码为标准的 UTF-8 字节流,直接产出 Uint8Array 对象:
const encoder = new TextEncoder();
const text = "你好 Web";
const uint8 = encoder.encode(text);

console.log(uint8);
// 输出示例: Uint8Array(10) [228, 189, 160, 229, 165, 189, 32, 87, 101, 98]
// 其中每个汉字占用 3 字节,空格与英文字符占用 1 字节
TextEncoder 的特点包括:
- 规范强制 UTF-8:根据当前标准,
TextEncoder仅支持 UTF-8 编码,不再支持其他老旧字符集(如 GBK),保证了跨平台通信的一致性。 - 高性能就地写入:提供
encodeInto(string, destinationUint8Array)方法,允许将转换结果直接写入已分配好的内存块,避免多次垃圾回收。 - 底层无缝集成:输出的
Uint8Array可直接提交给fetch()body、WebSocket.send()、crypto.subtle或是 WebWorker。
2. TextDecoder 负责“字节流 → 指定字符集字符串”
与编码器对应,TextDecoder 接收 ArrayBuffer 或其视图(如 Uint8Array),将其重构为 JavaScript 字符串。TextDecoder 支持传入字符集参数(如 gbk、utf-8、windows-1252 等):
const decoder = new TextDecoder("utf-8");
const restoredText = decoder.decode(uint8);
console.log(restoredText); // 准确还原: "你好 Web"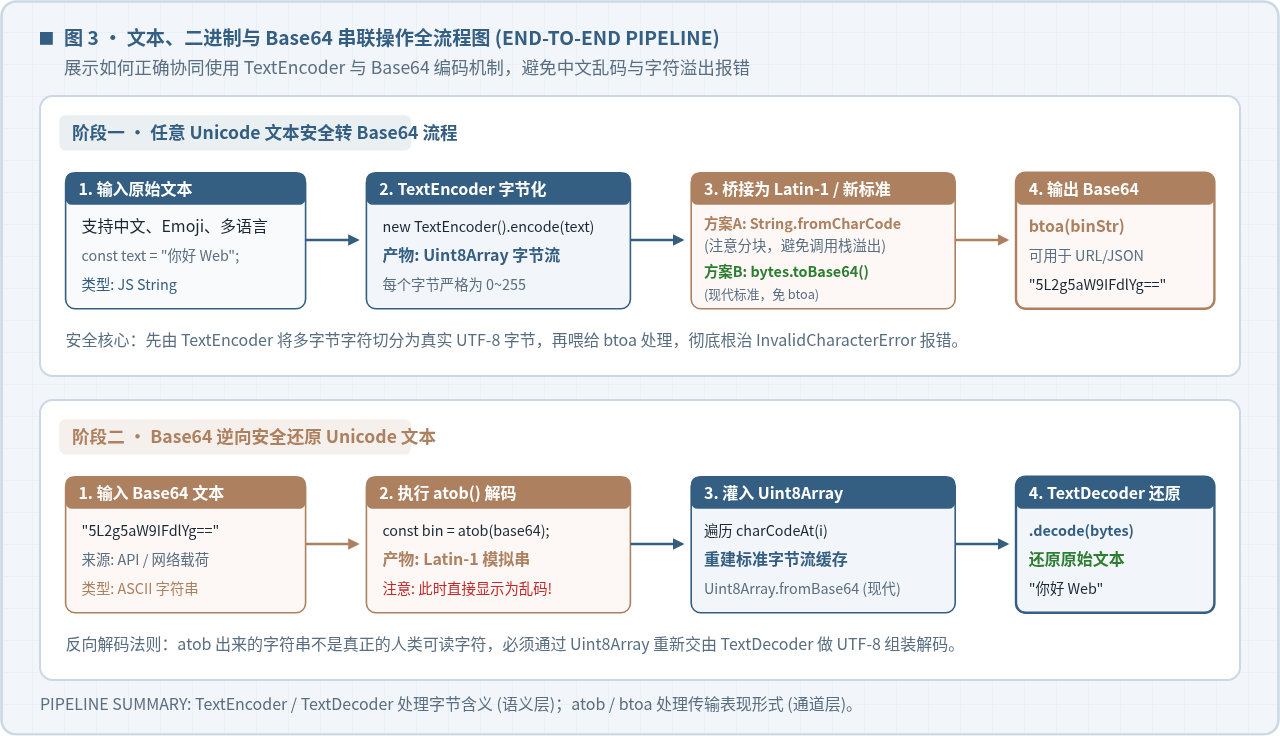
四、关键实操:如何正确串联两者处理复杂数据
在实际项目(例如将含有中文的多语言 JSON 压缩或转为 Base64 传递给 API)中,我们通常需要两者协同配合:用 TextEncoder 解决多语言字符转字节问题,再用 Base64 算法解决网络传输的 ASCII 安全性。
1. 正确将任意 Unicode 字符串转换为 Base64
不要再使用早年已废弃的 unescape(encodeURIComponent(str)) 黑魔法。规范可靠的做法是先转为 Uint8Array,再桥接为 Base64:
// 方式 A:通用兼容方案(兼容所有现代浏览器及旧环境)
function unicodeToBase64(str) {
  const bytes = new TextEncoder().encode(str);
  let binStr = "";
  // 采用分块或常规循环,避免超长数组 apply 导致栈溢出
  const chunkSize = 8192;
  for (let i = 0; i < bytes.length; i += chunkSize) {
    const chunk = bytes.subarray(i, i + chunkSize);
    binStr += String.fromCharCode.apply(null, chunk);
  }
  return window.btoa(binStr);
}

// 验证
const b64 = unicodeToBase64("你好,世界!🚀");
console.log(b64); // 输出标准 Base64 字符串
ECMAScript 新增了 Uint8Array.prototype.toBase64() 与 Uint8Array.fromBase64() 原生方法。在支持该特性的现代运行时中,无需任何 btoa 桥接:
// 现代原生写法(无需 btoa / atob)
const bytes = new TextEncoder().encode("你好,世界!");
const modernBase64 = bytes.toBase64(); // 直接输出 Base64
2. 从 Base64 还原任意 Unicode 文本
逆向操作同样分为两步:用 atob 获取模拟单字节串,装载入 Uint8Array,最后由 TextDecoder 统一做 UTF-8 组装还原:
function base64ToUnicode(base64Str) {
  // 现代环境优先使用 Uint8Array.fromBase64
  if (typeof Uint8Array.fromBase64 === "function") {
    const bytes = Uint8Array.fromBase64(base64Str);
    return new TextDecoder().decode(bytes);
  }

  // 通用兼容方案
  const binStr = window.atob(base64Str);
  const bytes = new Uint8Array(binStr.length);
  for (let i = 0; i < binStr.length; i++) {
    bytes[i] = binStr.charCodeAt(i);
  }
  return new TextDecoder().decode(bytes);
}

// 验证
console.log(base64ToUnicode(b64)); // 输出: "你好,世界!🚀"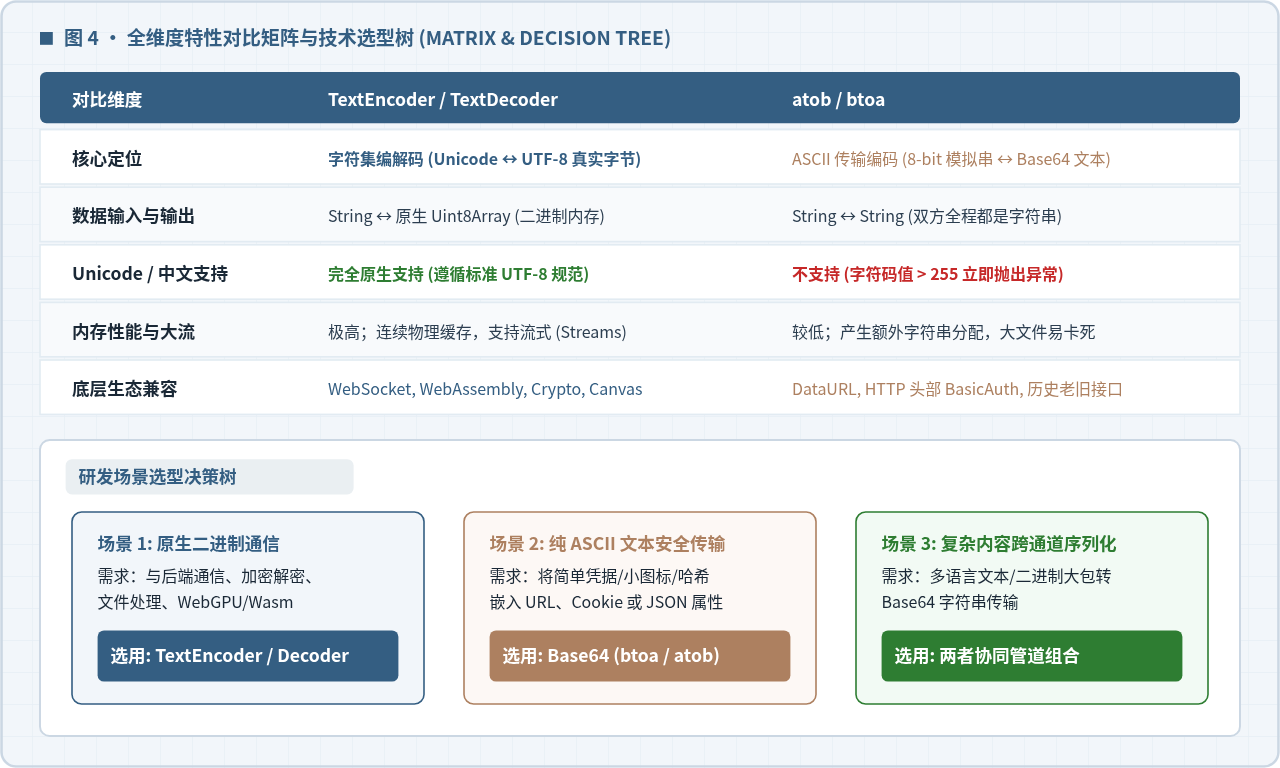
五、全维度对比速查表
| 特性指标 | TextEncoder / TextDecoder | atob / btoa |
|---|---|---|
| 所属规范 | WHATWG Web Encoding API (现代标准) | HTML / Window 规范 (历史遗留) |
| 数据输入/输出 | String ↔ Uint8Array (物理内存字节) |
String ↔ String (始终为字符串) |
| 中文与 Emoji 支持 | 原生完整支持 (标准变长 UTF-8) | 不支持 (码点 > 255 即抛出异常) |
| 核心应用目标 | 文本语义到物理内存字节流的转换 | 8 位二进制数据转为 7 位 ASCII 文本传输 |
| 生态集成能力 | CryptoKey, WebAssembly, WebSocket, Fetch | Data URL (图片内嵌), HTTP Basic Auth |
| 流式处理支持 | 支持(配合 TransformStream 实现分段解码) |
不支持(必须完整字符串一次性载入) |
六、日常开发避坑指南
- 绝不拿 btoa 直接编码用户输入的文本:如果未预先判定或转换为 UTF-8 字节流,一旦用户输入汉字、特殊符号或 Emoji,程序必定崩溃。
- 避免使用大数组解构导致栈溢出:在将
Uint8Array桥接给String.fromCharCode.apply(null, uint8Array)时,若字节数组超过数十万个元素,会触发 JS 引擎的Maximum call stack size exceeded。务必像上文示例一样按 8KB 块大小分批读取。 - Node.js 环境差异:在较新的 Node.js(v16+)中,全局已同时提供
TextEncoder、TextDecoder、atob和btoa。但在 Node.js 体系下,处理二进制的首选始终是内置的Buffer(如Buffer.from(str, 'utf-8').toString('base64'))或Uint8Array,避免混用全局atob产生隐式开销。
利用JavaScript闭包实现防抖与节流函数
2026-11-17 15:24:41
JavaScript邮箱验证正则表达式:常用写法与RFC标准对比
2026-11-17 14:21:33
JavaScript ES6+新特性使用规范与兼容性注意事项
2026-11-16 18:13:46
JS中使用Class类封装实现类似C语言的结构体
2026-11-16 18:13:25
兼容IE浏览器:JS对象转数组的传统for...in实现方案
2026-11-16 15:05:02







