JavaScript构造API请求所需的JSON对象数组示例
详细讲解在JavaScript中构造API请求所需的JSON对象数组的实用方法。包含原始数据规整、契约映射、JSON序列化与Fetch发送的完整代码示例,深入对比声明式map与命令式循环的关键差异及常见陷阱。
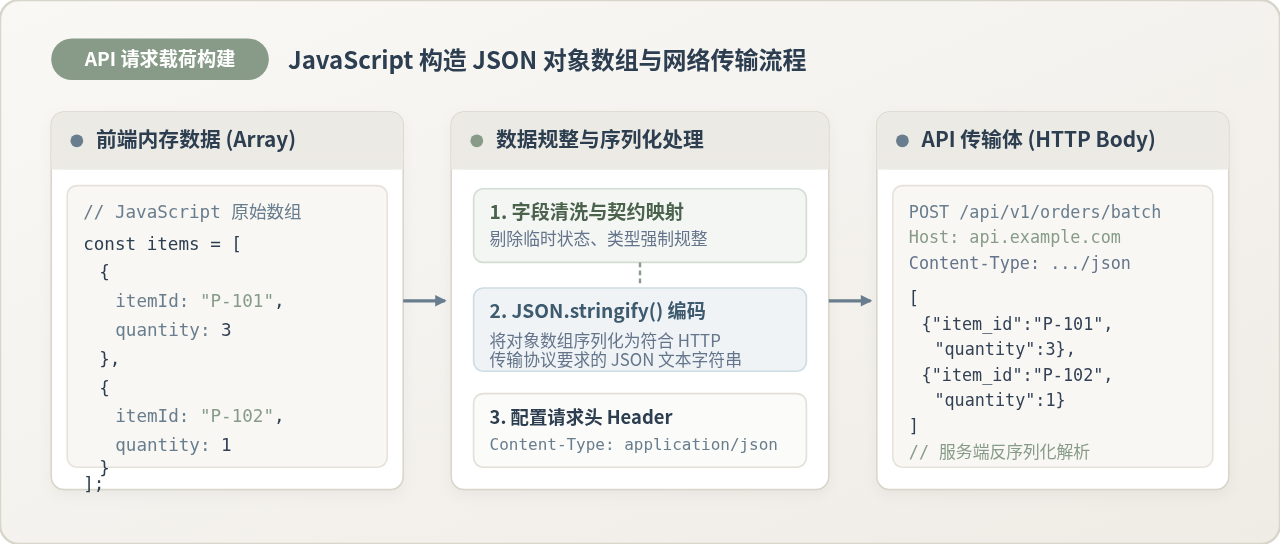
在前端与服务端交互的过程中,构造 API 请求所需的 JSON 对象数组,本质上是将散落于视图层的数据源(例如表格的多选行、动态表单列表、购物车项或批量操作面板)提取出来,转换为契合后端接口契约规范的 JavaScript 对象数组,再通过 JSON.stringify() 序列化为符合 HTTP 传输规范的 JSON 文本字符串。本文将以具体的批量操作业务场景为例,分步演示从原始数据清洗、字段映射、数据过滤到网络发送的完整实现过程,并对比两种主流构造模式的核心差异与排错细节。
一、核心概念:理解 API 请求所需的两种数组载荷形态
在设计批量接口(例如批量添加订单明细、批量更新用户状态、批量同步商品库存)时,后端接口对请求体(Request Body)的格式要求通常存在两种设计形态。在编写构造代码前,明确后端接口定义的根节点类型是决定组装方式的前提:
- 顶层纯数组载荷(Top-level Array Payload): HTTP 请求体根节点直接由中括号
[...]构成的数组包裹。每个元素对应一条业务实体记录。这种形态结构最精简,没有多余的包裹层级,广泛用于纯粹的独立资源批处理接口。 - 对象包裹数组载荷(Enclosing Object Payload): 请求体根节点是一个大括号
{...}组成的对象,数组作为该对象的某个键(如items、data或records)传入,同时同级挂载批次标识、操作人信息、时间戳或全局配置等元数据。
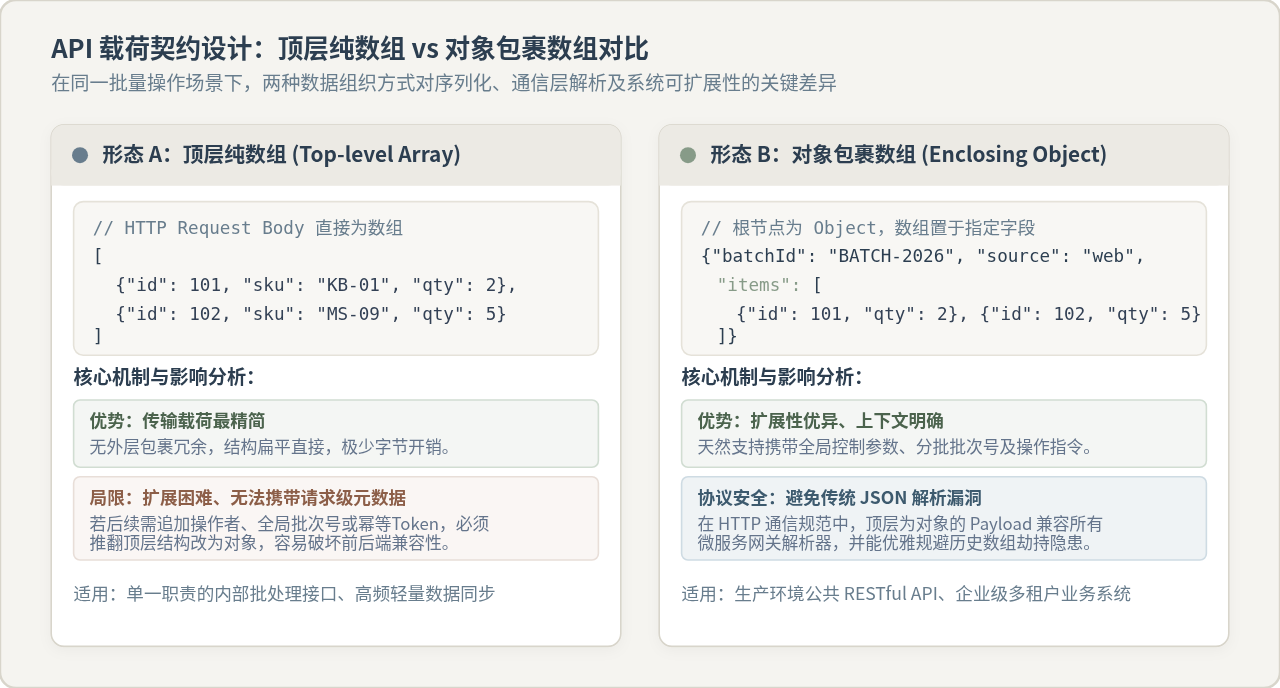
两种形态在相同业务条件下的关键差异在于演进扩展能力与上下文携带能力。顶层纯数组在数据量小且操作独立时极为直观,但一旦业务变更需要追加全局参数(例如整批操作的“审批流水号”或“忽略警告直接保存”开关),顶层数组结构便无法向前兼容,必须推翻数据契约。而对象包裹数组天然具有属性扩展槽位,前后端协同更加稳定可靠。在实际项目中,应严格以接口文档定义的 JSON Schema 为准进行构造。
二、构造与发送 JSON 对象数组的标准 5 步流程与完整示例
构造 API 请求所需的 JSON 对象数组不是简单地把变量拼在一起,而是一个包含数据采集、清洗映射、有效性校验、序列化以及请求分发的连续链条。下面通过一个电商系统“批量采购下单”的完整场景进行代码拆解。
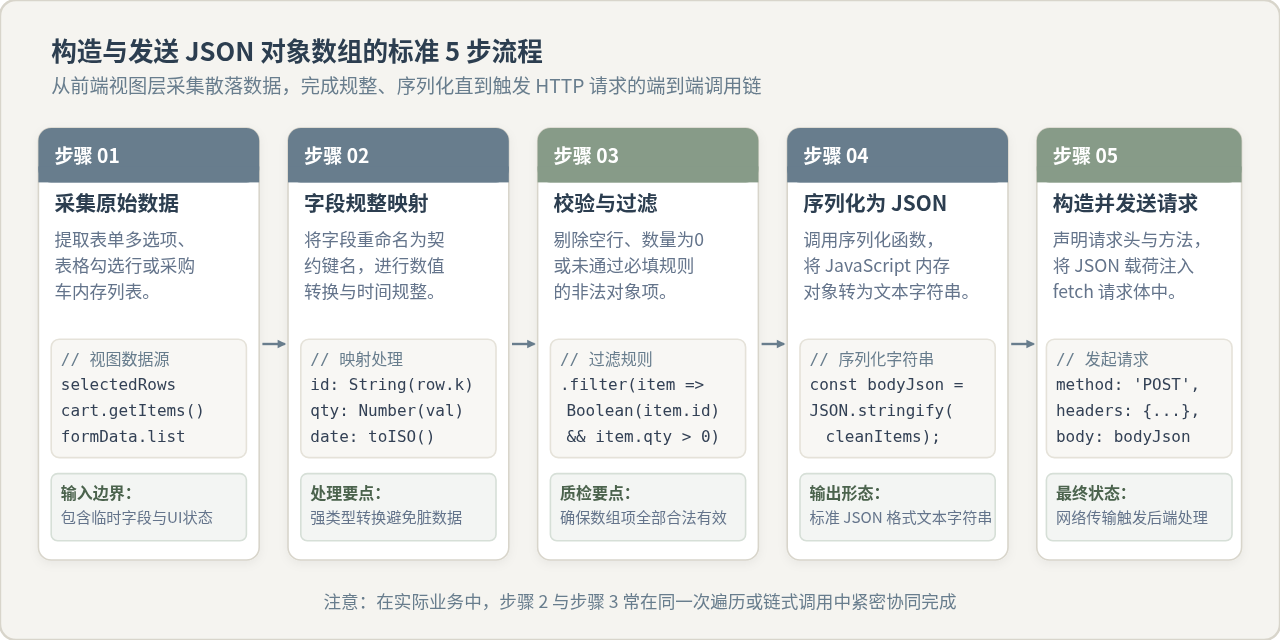
场景输入与完整可运行代码
假设用户在界面表格中勾选了若干商品,前端状态中保存着一份包含临时 UI 属性的原始列表。我们需要将其清洗为符合后端下单接口规范的对象数组并完成提交:
// 1. 模拟前端视图层采集到的原始数据源(包含字符串格式数字、UI复选状态及临时备注)
const rawTableSelection = [
  { rawId: "SKU-1001", title: "人体工学键盘", buyCount: "2", unitPrice: "299.00", isSelected: true, tempNote: "需要发票" },
  { rawId: "SKU-1002", title: "无线静音鼠标", buyCount: "0", unitPrice: "89.50", isSelected: true, tempNote: "" }, // 数量为0,属于无效项
  { rawId: "SKU-1003", title: "4K超清显示器", buyCount: "1", unitPrice: "1899.00", isSelected: true, tempNote: "加急配送" }
];

// 2. 构造并发送 API 请求的异步执行函数
async function submitBatchOrder(rawList) {
  // 步骤 A:映射契约字段并进行强类型转换
  const transformedItems = rawList.map(row => {
    const count = parseInt(row.buyCount, 10);
    const price = parseFloat(row.unitPrice);

    return {
      sku_code: String(row.rawId),
      quantity: isNaN(count) ? 0 : count,
      price_cents: isNaN(price) ? 0 : Math.round(price * 100), // 转换为整型分
      user_remark: row.tempNote.trim() || null // 空字符串规整为 null
    };
  });

  // 步骤 B:过滤剔除不合规的无效数据项(例如数量小于等于 0)
  const validItems = transformedItems.filter(item => item.quantity > 0);

  // 前置拦截:若过滤后数组为空,终止请求以节省网络资源
  if (validItems.length === 0) {
    console.warn("未包含有效采购条目,终止请求");
    return { success: false, message: "采购项不可为空" };
  }

  // 步骤 C:组装最终请求载荷对象并执行 JSON 序列化
  const requestPayload = {
    batch_no: "BATCH-" + Date.now(),
    created_at: new Date().toISOString(),
    total_count: validItems.length,
    items: validItems
  };

  const jsonBody = JSON.stringify(requestPayload);

  // 步骤 D:配置 HTTP 请求头并分发 Fetch POST 请求
  try {
    const response = await fetch("/api/v1/orders/batch-create", {
      method: "POST",
      headers: {
        "Content-Type": "application/json",
        "Accept": "application/json"
      },
      body: jsonBody
    });

    if (!response.ok) {
      throw new Error(`服务端响应异常,状态码: ${response.status}`);
    }

    const result = await response.json();
    console.log("批量订单创建成功:", result);
    return { success: true, data: result };
  } catch (error) {
    console.error("API 请求失败:", error);
    throw error;
  }
}执行 submitBatchOrder(rawTableSelection) 时,网络请求体中发送的实际字符串为:
{"batch_no":"BATCH-1731412850000","created_at":"2026-11-12T12:00:50.000Z","total_count":2,"items":[{"sku_code":"SKU-1001","quantity":2,"price_cents":29900,"user_remark":"需要发票"},{"sku_code":"SKU-1003","quantity":1,"price_cents":189900,"user_remark":"加急配送"}]}三、两种构造模式对比:声明式 Array.map() 与命令式 for...of 循环
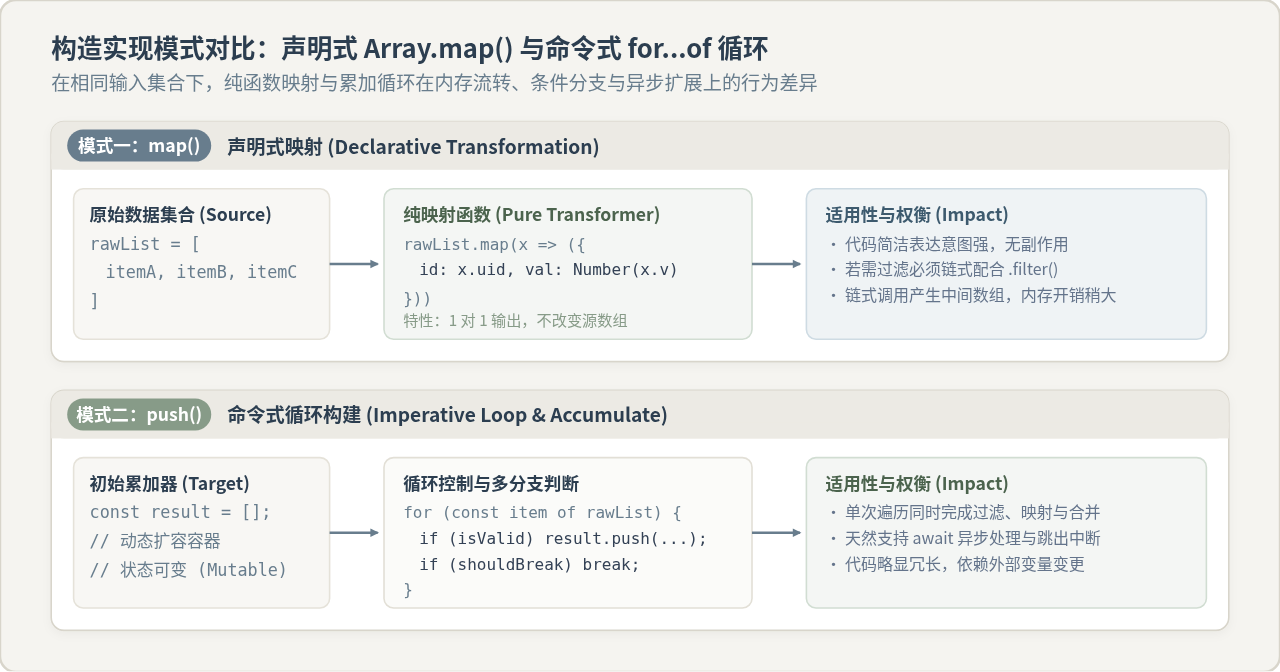
在 JavaScript 中构造对象数组,主要存在两种技术实现模式:以 Array.prototype.map() 为代表的函数式声明转换,以及以 for...of 搭配 Array.prototype.push() 为代表的命令式累加构建。在一致的数据输入条件下,理解两者的机制差异对编写高内聚、易维护的代码至关重要。
| 对比维度 | 声明式 Array.prototype.map() |
命令式 for...of + push() |
|---|---|---|
| 数据流与不可变性 | 纯函数风格,返回新数组,绝不直接修改原始输入数据源,数据流追踪清晰。 | 依赖外部可变累加器变量(const list = []),通过显式调用 push() 改变数组状态。 |
| 条件过滤与跳过 | 无法在中途跳过元素(严格 1:1 输出);若要过滤必须链式组合 .filter().map(),导致多次遍历。 |
单个循环内可通过 if...continue 直接跳过无效项,或通过 break 提前阻断。 |
| 异步处理支持 | 与 async/await 结合会返回 Promise 数组,必须外层包一层 Promise.all()。 |
天然支持在循环体内顺序 await 执行异步校验或补充数据,代码符合直觉。 |
| 内存与执行效率 | 链式操作会产生中间数组,在数万条以上的海量数据集下存在微小的垃圾回收开销。 | 单次遍历完成过滤、转换与规整,无冗余中间数组,在超大数据集下内存表现更好。 |
| 最佳适用场景 | 字段转换规则确定、无需复杂分支跳转的常规数据清洗场景(开发首选)。 | 复杂条件判断、包含动态拆解/聚合、或者需要内联异步数据补全的复杂批量任务。 |
差异为什么重要:选择哪种模式不应取决于个人偏好,而取决于业务逻辑的复杂度。如果数据项之间完全独立且转换确定,使用 map() 可以大幅减少样板代码;但如果构造每个对象前都需要根据多层条件决定是否丢弃,甚至需要拆分出多个子对象,强行使用 map() 容易导致嵌套三元表达式或产生充满 undefined 的稀疏数组,此时切换为 for...of 更加稳健。
四、字段规整与契约映射的关键细节
前端界面绑定的数据模型与后端数据库持久化模型往往存在命名习惯和类型约束上的不对齐。构造请求对象数组时,必须通过中间转换层将它们一一校准。
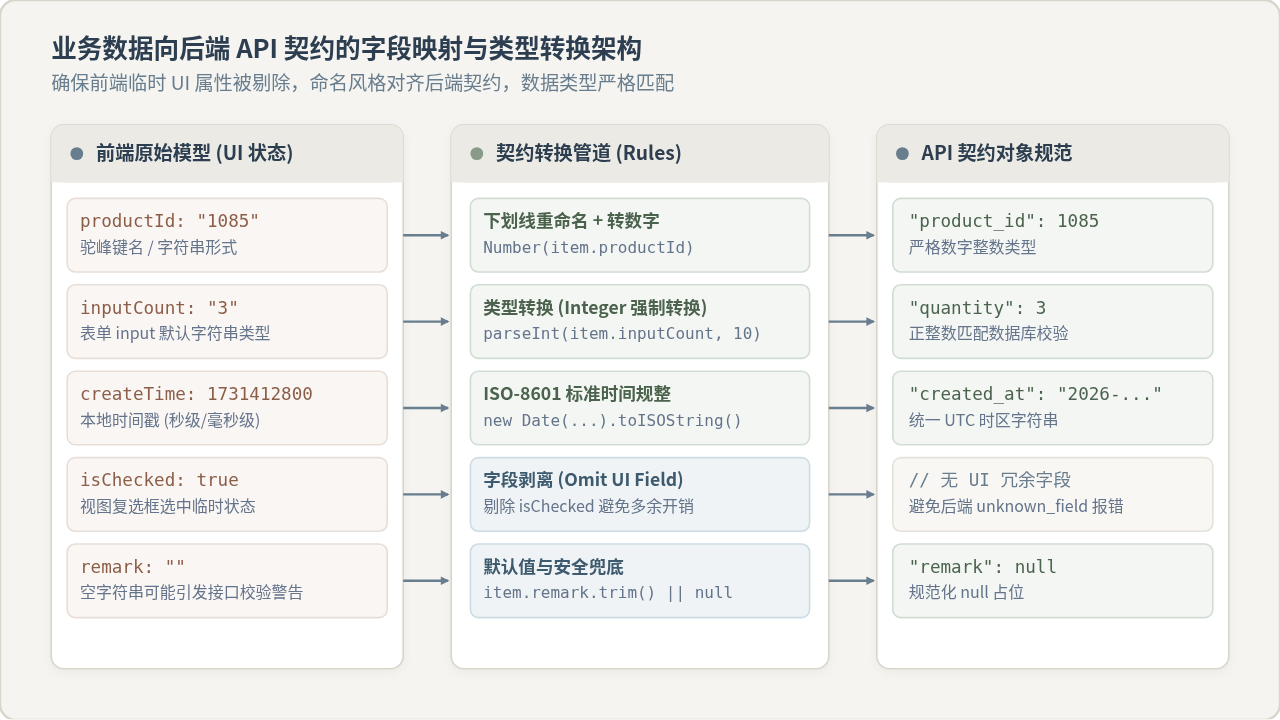
1. 命名风格校准(驼峰 camelCase 到蛇形 snake_case)
JavaScript 前端习惯使用小驼峰(如 productId、userStatus),而后端规范(如 Python/Go 常用接口)大多采用下划线分隔(如 product_id、user_status)。构造对象时应显式重构键名,避免直接将未处理的前端对象整体丢入请求体。
2. 数据类型严格校准
HTML 表单中的 <input type="number"> 在 DOM 事件中读取到的 e.target.value 往往仍是字符串类型 "12"。如果直接发往强类型后端(如 Java、Go、Rust),会导致字段类型校验报错(如 Cannot deserialize value of type int from String)。必须显式使用 Number() 或 parseInt() 进行类型转换。
3. 剔除前端视图专用的冗余字段
为了控制 UI 交互,前端对象中往往附带 isHovered、isExpanded、editingRowKey 等临时状态。如果这些字段未经剥离直接提交给后端,不仅会浪费网络带宽,在开启了严格 Schema 校验(如 JSON Schema additionalProperties: false)的接口中会直接导致 400 Bad Request 错误。
五、构造过程中容易踩中的四大陷阱
在循环或 Array.fill() 批量构造默认对象时,如果直接复用同一个对象变量:
// 错误示范:所有元素指向同一个堆内存引用
const defaultItem = { status: 1, remark: "" };
const list = new Array(3).fill(defaultItem);
list[0].remark = "改动第一项"; // 此时所有 3 项的 remark 全变成了"改动第一项"!

// 正确做法:每次迭代生成全新独立字面量或执行深拷贝
const list = Array.from({ length: 3 }, () => ({ status: 1, remark: "" }));在 JavaScript 中,如果对象的某个键值为 undefined,在执行 JSON.stringify() 序列化时,该键会被完全忽略抹除,而不是转为 null:
const item = { id: 101, description: undefined };
console.log(JSON.stringify(item));
// 输出: "{"id":101}" —— description 键丢失了!
如果后端要求必须显式传递该键(即使为空),必须在构造时赋予 null(description: val ?? null),确保生成的 JSON 保留键名 {"id":101,"description":null}。
使用 fetch() 发送请求体时,即便 body 传入的是标准 JSON 字符串,如果不手动添加 headers: { 'Content-Type': 'application/json' },浏览器默认会将其标记为 text/plain。大部分后端解析中间件(如 Express 的 express.json()、Spring Boot 的 @RequestBody)会因为无法匹配 Content-Type 而拒绝解析,使得后端接收到的请求体为 null 或空对象。
当对象数组条目超过数千条时,序列化后的 JSON 字符串可能达到数兆字节(MB),极易触发 Nginx 或 API 网关的默认载荷大小限制(如 client_max_body_size)。在前端应实现分片批处理(Chunking)机制,例如将 5000 条数据按 500 条一组切片分次提交,或采用分批并发队列控制。
六、全流程规范与避坑检查总结
构造 API 请求所需的 JSON 对象数组是前后端数据交换中最基础也最关键的一环。在完成代码编写并正式发送请求前,可依据以下四大维度的检查清单确认完整性:
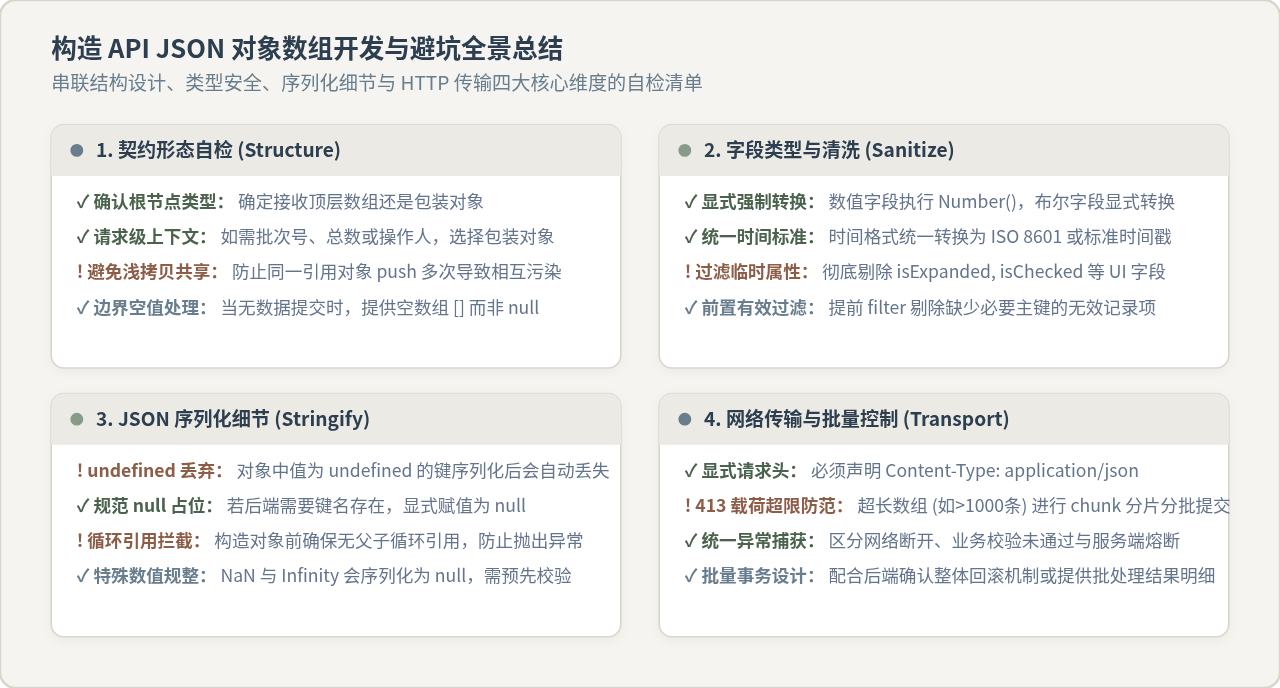
- 契约对齐:确认根节点结构(顶层数组还是包装对象),确保属性命名风格与后端文档规范一致。
- 数据清洗:剔除 UI 交互临时状态,利用
.filter()拦截空行或主键缺失项。 - 类型安全:对数值、布尔值和时间字段执行显式转换,防止表单字符串引起服务端类型解析崩溃。
- 序列化保障:用
null替代undefined避免键被抹除,检查无循环引用,并显式设置Content-Type: application/json请求头。
怎么准确判断JS异步代码的输出顺序?经典事件循环面试题解析
2026-11-16 15:05:34
JS防水砂浆施工注意事项:基面处理与养护技巧
2026-11-16 15:05:21
怎么理解邵山欢JavaScript笔记中的闭包与作用域链
2026-11-16 15:04:57
JS遍历字符串的5种常用方法:从for循环到for...of
2026-11-16 14:27:18
使用matchAll提取JavaScript中所有正则匹配项
2026-11-16 14:26:56