JS数字字符串怎么按数值大小而非字典序排序?
深入解析 JavaScript 中数字字符串数组按数值大小排序的标准做法。详解默认字典序产生的原因、常用实现方法、边界陷阱(大数溢出、NaN干扰)及防御性最佳实践。
arr.sort() 对纯数字组成的字符串数组进行排序,数组元素会被当作普通文本,按照 UTF-16 字符码元的字典序逐位对比,导致形如 "10" 错误地排在 "2" 前面。要让数字字符串严格按实际数值大小排序,核心做法是向 sort() 传入一个自定义比较函数:最简洁的写法是 arr.sort((a, b) => a - b)(利用减法触发数值类型转换),或者使用语义更严谨的 arr.sort((a, b) => Number(a) - Number(b))。
一、为什么默认 sort 会按字典序排序?
许多开发者在初次遇到该问题时往往感到困惑:数组里的每一项明明全都是数字字符,为什么 JavaScript 不会自动比对它们的大小?
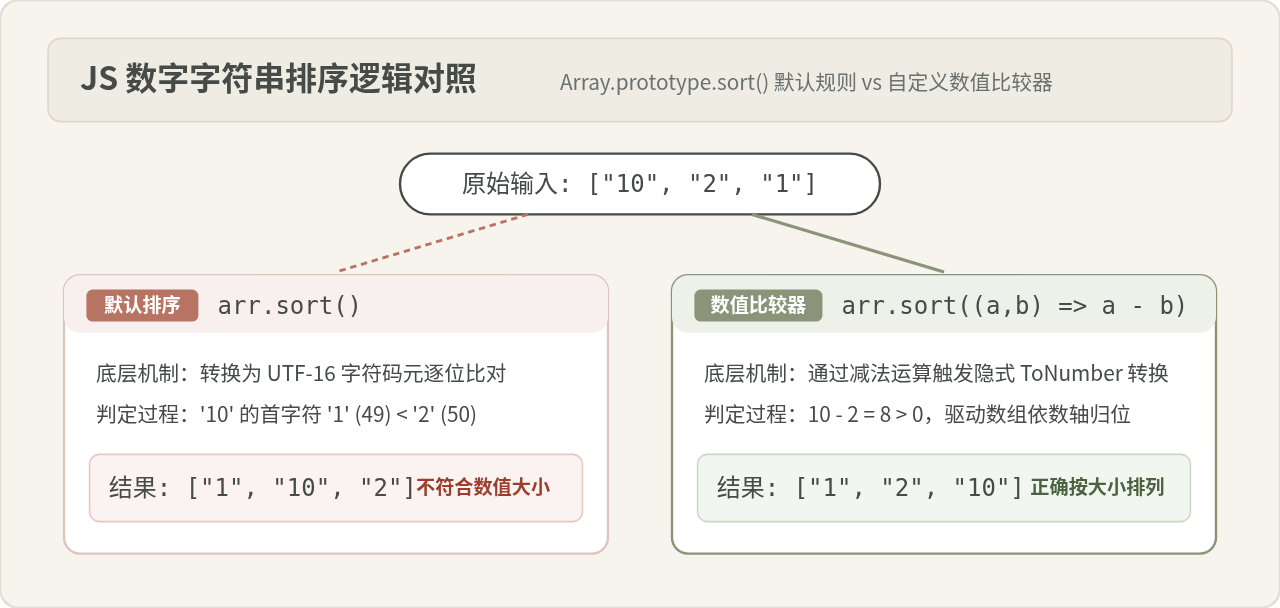
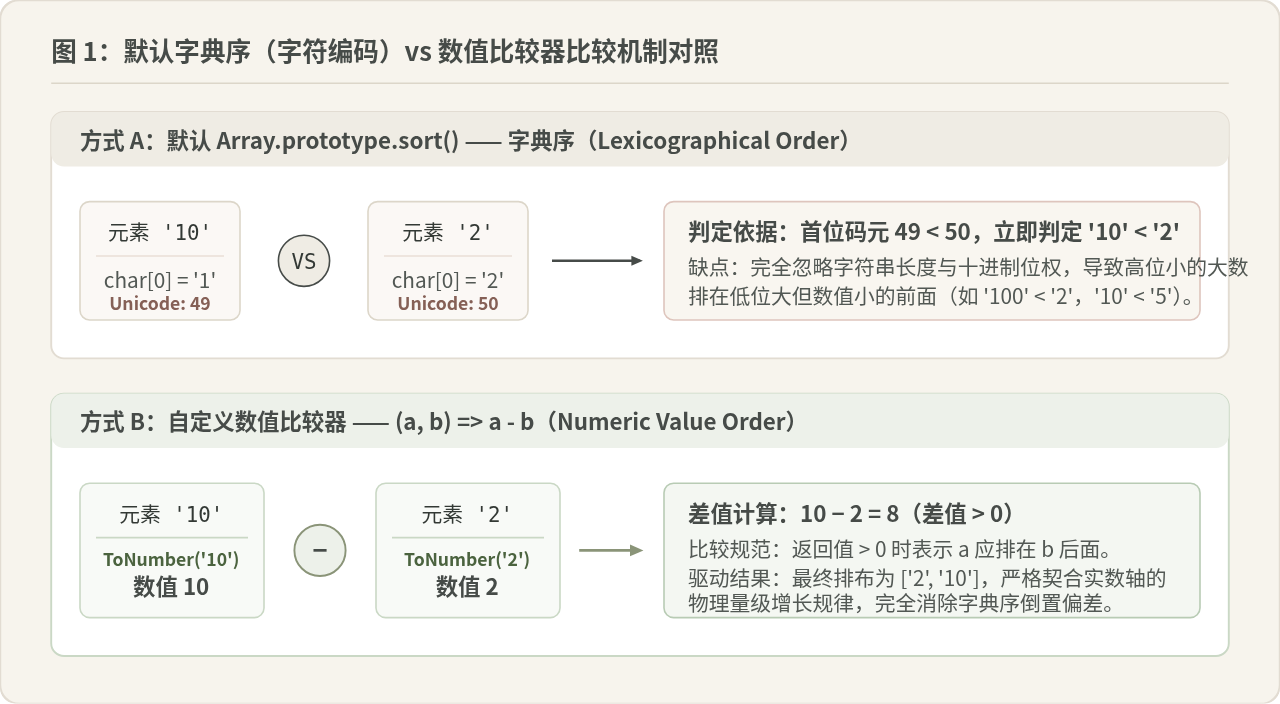
根据 ECMAScript 规范定义,Array.prototype.sort() 在未显式传入比较函数(compareFn)时,会遍历数组将所有非 undefined 的元素统一调用内部抽象操作 ToString() 转换为字符串,随后基于 UTF-16 码元顺序(Code Unit Order)进行逐字符对比。
以数组 ["10", "2", "1"] 为例:
- 比较
"10"与"2"时,排序引擎先取出各自下标为 0 的第一个字符:'1'和'2'。 - 在字符编码表中,字符
'1'的 Unicode 码点是49(0x0031),而'2'的码点是50(0x0032)。 - 因为
49 < 50,引擎直接得出"10" < "2"的结论,判定"10"应该排在"2"的左边,根本不会去检查第二个字符'0',更不会考虑字符串所代表的整体十进制物理位权。
这与在英文字典中查单词时,长单词 "apple" 必然排在单字母 "b" 前面的规则完全一致。因此,默认的 sort() 产出的结果是 ["1", "10", "2"]。
二、核心实现:按数值排序的三种常用方案
方案 1:减法隐式转换 (a, b) => a - b(最简常用)
在 JavaScript 中,减法运算符(-)仅针对数值类型有定义。当对两个字符串执行减法运算时,JS 引擎会自动调用 ToNumber() 抽象操作,将两端的操作数强制转换为数值类型,再进行减法求差。
// 示例代码:常规数字字符串升序排序
const list = ["10", "2", "1", "100", "25"];

// 使用减法比较器(升序)
const resultAsc = [...list].sort((a, b) => a - b);
console.log(resultAsc);
// 示例输出:["1", "2", "10", "25", "100"]

// 降序排序只需颠倒操作数(b - a)
const resultDesc = [...list].sort((a, b) => b - a);
console.log(resultDesc);
// 示例输出:["100", "25", "10", "2", "1"]
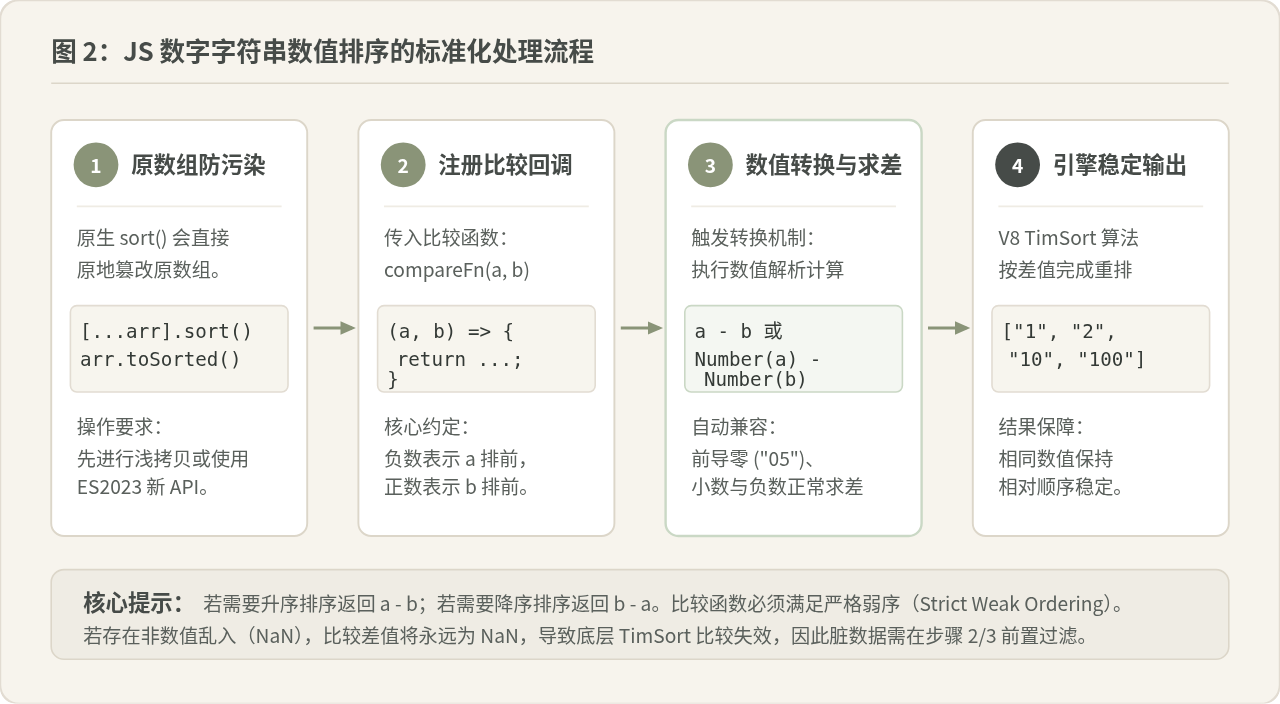
运作原理:根据 sort() 的协议,当比较函数返回值小于 0 时,a 会被排在 b 之前;返回值大于 0 时,b 会被排在 a 之前;返回 0 则保持二者相对顺序不变。当计算 "10" - "2" 时,实际执行的是 10 - 2 = 8 > 0,引擎由此准确将 "10" 置于 "2" 的后侧。
方案 2:显式数值转换 Number(a) - Number(b)(语义严谨)
虽然 a - b 简短直观,但在大型工程或配合 TypeScript 进行静态类型检查时,一些代码审查规则(Linter)可能不鼓励利用运算符的隐式类型转换行为。显式调用 Number() 可以让类型转换的意图更加直观清晰:
const list = ["05", "12", "2.5", "-3", "008"];

const sorted = [...list].sort((a, b) => Number(a) - Number(b));
console.log(sorted);
// 示例输出:["-3", "2.5", "05", "008", "12"]
与 parseInt 的差异提醒:尽量避免使用 parseInt(a, 10) - parseInt(b, 10),因为 parseInt 会无条件丢弃小数部分,导致 "2.1" 与 "2.9" 被判定为完全相等;此外,parseInt("10px") 会解析出数字 10,而 Number("10px") 会返回 NaN,后者在排查异常数据时更具确定性。
方案 3:自然排序法 localeCompare 配合 { numeric: true }
如果数组中除了纯数字字符串,还夹杂着带文本前缀的自然编号(例如 ["item2", "item10", "item1"] 或文件分卷名),无论是减法还是 Number() 都会解析失败返回 NaN。
此时,可以使用现代 JavaScript 提供的 String.prototype.localeCompare() 方法,并启用 numeric: true 配置参数:
const fileList = ["file10.txt", "file2.txt", "file1.txt", "file20.txt"];

fileList.sort((a, b) => a.localeCompare(b, undefined, { numeric: true }));
console.log(fileList);
// 示例输出:["file1.txt", "file2.txt", "file10.txt", "file20.txt"]
该方法内部采用国际化比对规范(Intl.Collator),能够自动检测字符串内部连续的数字片段,并把这些数字片段按数学量级进行自然排序(Natural Sort),非常适合目录、章节和混合列表。
三、边界场景与易混淆辨析
1. a - b 真的永远可靠吗?警惕 NaN 与脏数据
在真实业务场景中,后台接口返回的数据往往并非纯净无瑕。如果待排序数组中混入了空字符串 "" 或非法字符 "N/A",隐式转换就会产生严重副作用:
- 空字符串陷阱:
Number("")会被转为0。如果数组本就包含"0",空串可能混淆在零值附近。 - NaN 传染破坏算法稳定性:若元素包含
"abc","abc" - 10的结果是NaN。根据规范,NaN > 0、NaN < 0和NaN === 0的判断结果全为false。在 V8 引擎底层的 TimSort 排序算法中,这直接打破了数学上的“严格弱序”假设,导致比较函数失去传递性,不仅非法元素无法正确定位,连原本正确的纯数字元素位置也会发生不可预测的错乱。
// 将非数字项统一置于数组末尾
arr.sort((a, b) => {
  const numA = Number(a);
  const numB = Number(b);
  const invalidA = Number.isNaN(numA);
  const invalidB = Number.isNaN(numB);

  if (invalidA && invalidB) return 0;
  if (invalidA) return 1;  // a 无效,排在后面
  if (invalidB) return -1; // b 无效,排在后面
  return numA - numB;
});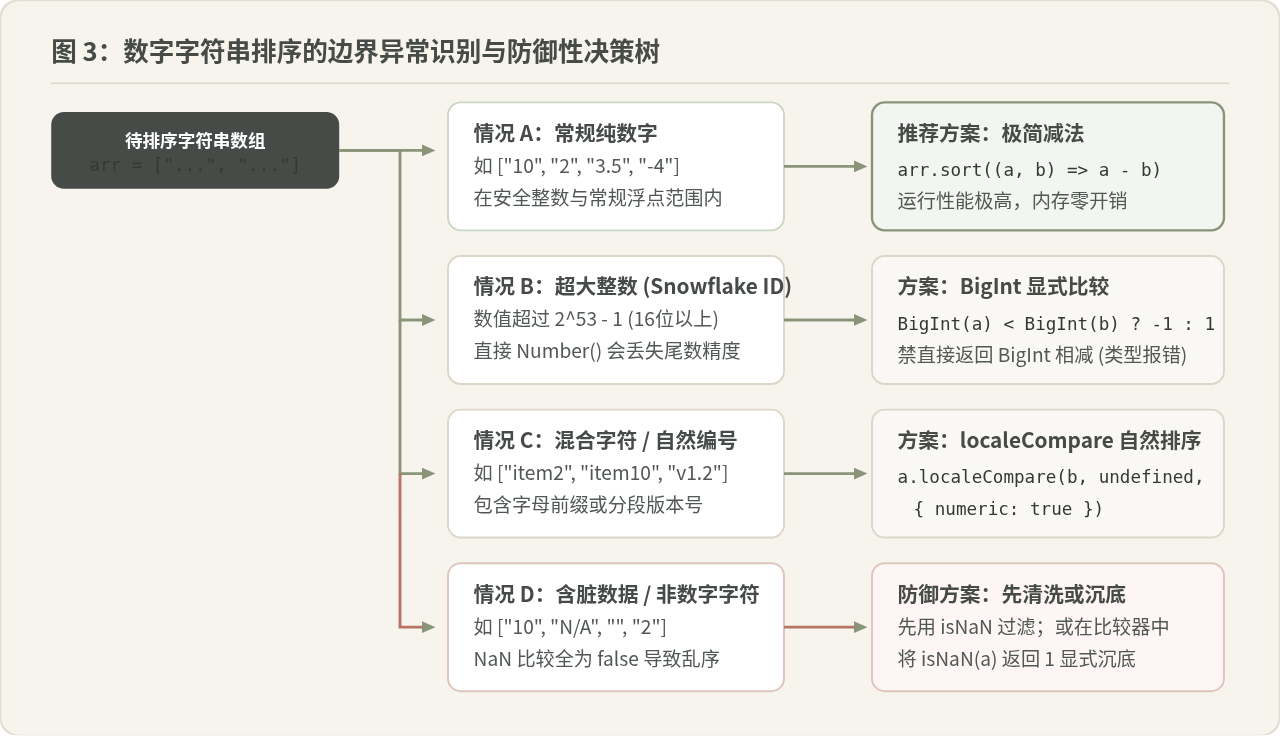
2. 超大整数(雪花 ID / 64位整型)的精度丢失陷阱
JavaScript 的 Number 类型遵循 IEEE 754 双精度浮点数标准,能够精确表示的最大安全整数是 Number.MAX_SAFE_INTEGER,即 9007199254740991(16 位十进制数)。
很多分布式后台系统生成的雪花算法 ID(Snowflake ID)或 64 位数据库主键通常长达 18~19 位,例如:
const ids = [
  "1712034981293847553",
  "1712034981293847552",
  "1712034981293847554"
];
如果直接使用 (a, b) => a - b,转换后超出安全上限,后几位精度会丢失为相同近似值,导致 1712034981293847553 - 1712034981293847552 === 0!
正确处理超大整数:必须使用 BigInt。但需要特别注意,BigInt 相减的结果依然是 bigint 类型,而原生 sort() 回调函数必须返回标准 Number(由于 JS 引擎禁止将 BigInt 隐式转换为 Number,直接 return BigInt(a) - BigInt(b) 会直接抛出运行时错误 TypeError: Cannot convert a BigInt value to a number)。必须通过三元运算符显式返回 -1、1 或 0:
// 正确的大数安全排序写法
ids.sort((a, b) => {
  const diff = BigInt(a) - BigInt(b);
  return diff < 0n ? -1 : (diff > 0n ? 1 : 0);
});
// 准确按大数大小严格排列,精度零损失
3. 原地修改(In-Place)的副作用防护
初学者容易忽视的另一个细节是:sort() 是破坏性方法(Mutating Method),它会直接在原数组内存地址上重新洗牌。
在 Vue 3、React 等依赖状态不可变性(Immutability)进行数据变更侦听的前端框架中,直接原地修改 Props 或 State 数组会导致依赖收集失效或无法触发 UI 视图重新渲染。
因此,推荐养成以下保护原数组的书写习惯:
// 方式 A:ES6 扩展运算符浅拷贝
const sortedList = [...rawList].sort((a, b) => a - b);

// 方式 B:ES2023 全新非破坏性 API(推荐在现代环境使用)
const cleanSorted = rawList.toSorted((a, b) => a - b);
四、方案综合选型与总结对比
针对不同业务形态与数据规模,以下是四种排序方案的多维评估:
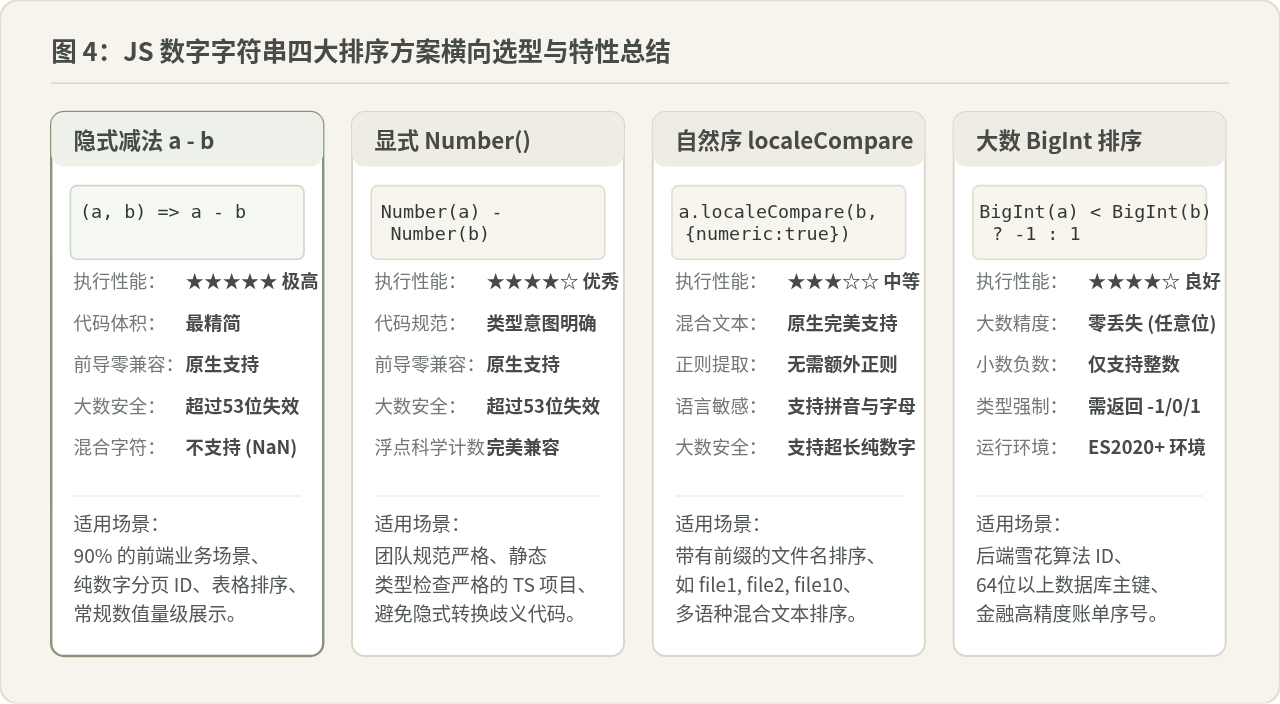
| 排序方案 | 核心代码写法 | 执行性能 | 最佳适用场景 | 注意事项与边界 |
|---|---|---|---|---|
| 隐式减法 | (a, b) => a - b |
★★★★★(极高) | 常规业务、表格序号、分页 ID | 超过 16 位大数精度丢失;遇 NaN 乱序 |
| 显式转换 | (a, b) => Number(a) - Number(b) |
★★★★☆(优秀) | TypeScript 项目、规范要求严格的代码库 | 浮点与科学计数兼容良好;大数仍需警惕 |
| 自然排序 | a.localeCompare(b, undefined, {numeric: true}) |
★★★☆☆(中等) | 混合字符串、文件列表(file1, file10) | 底层涉及国际化解析,大规模数据时耗时稍长 |
| BigInt 比较 | BigInt(a) < BigInt(b) ? -1 : 1 |
★★★★☆(良好) | 数据库 64 位整型、雪花算法 ID | 不支持带小数点的数字串;禁止直接返回减法值 |
[...arr].sort((a, b) => a - b);含前缀混合字符选用 localeCompare(..., {numeric: true});超长整型 ID 务必使用 BigInt 三元比较;排查数据异常优先防范 NaN 乱序。
JS函数声明与函数表达式在变量提升中的执行顺序区别
2026-11-16 15:05:16
JavaScript数组常用方法清单与语法详解
2026-11-16 15:05:14
JavaScript代码注释最佳实践:何时写注释而非重构代码
2026-11-16 14:27:23
JS倒计时结束后自动执行回调函数
2026-11-16 13:42:07
JavaScript怎么获取字符的ASCII码值
2026-11-16 13:24:14