

JavaScript怎么获取字符的ASCII码值
在JavaScript中获取字符的ASCII码值主要使用字符串原生方法charCodeAt()或ES6新增的codePointAt()。本文系统讲解具体使用步骤、代码示例、方法差异对比、边界校验与逆向还原技巧。
在 JavaScript 中获取字符的 ASCII 码值,最直接且通用的方法是使用字符串实例的 charCodeAt() 方法,例如 'A'.charCodeAt(0) 返回 65;在 ES6 及更高版本中,也可以使用 codePointAt() 方法。对于标准 ASCII 编码范围(0 到 127)的字符,这两个方法的返回值完全一致。本文将完整介绍获取 ASCII 码的具体代码、从字符串中提取与校验的规范流程、多字符批量处理与逆向还原,以及容易踩坑的边界注意事项。
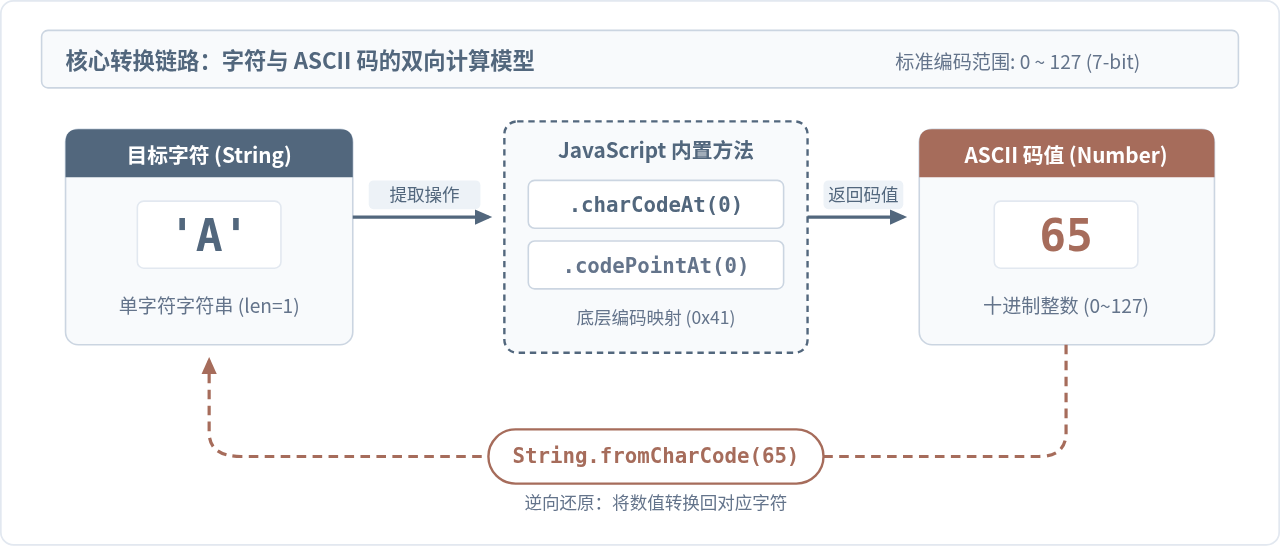
一、核心方法:使用 charCodeAt() 获取 ASCII 码
在 ECMAScript 规范中,字符串是由 UTF-16 码元组成的序列。针对任意字符串对象,JavaScript 提供了原生方法 str.charCodeAt(index),用于返回指定索引位置处的 16 位整数(范围为 0 到 65535)。
由于标准的 ASCII 码表只定义了 0 到 127 号字符(包括控制字符、常用标点、英文字母和阿拉伯数字),这一范围在 UTF-16 与 Unicode 编码中完全保留且数值对应不变。因此,读取字符在索引位置为 0 处的 UTF-16 码元,即可直接作为该字符的 ASCII 码值。
1. 单个字符的基础代码示例
以下是在日常开发中最常见的单字符提取示例:
// 1. 获取大写字母 'A' 的 ASCII 码
const charA = 'A';
const codeA = charA.charCodeAt(0);
console.log(codeA);

// 2. 获取小写字母 'a' 的 ASCII 码
const charSmallA = 'a';
const codeSmallA = charSmallA.charCodeAt(0);
console.log(codeSmallA);

// 3. 获取数字字符 '0' 与 '9' 的 ASCII 码
console.log('0'.charCodeAt(0));
console.log('9'.charCodeAt(0));

// 4. 获取英文标点符号与空格的 ASCII 码
console.log(' '.charCodeAt(0));
console.log('!'.charCodeAt(0));97
48
57
32
33
2. 从多字符字符串中指定位置读取
charCodeAt() 接收一个非负整数作为索引参数(默认值为 0)。如果目标字符串包含多个字符,我们只需传入对应的字符索引位置即可,无需先用 charAt() 或 slice() 截取单个字符:
const message = "JavaScript";

// 获取索引为 0 的字符 'J' 的 ASCII 码
console.log(message.charCodeAt(0)); // 74

// 获取索引为 4 的字符 'S' 的 ASCII 码
console.log(message.charCodeAt(4)); // 83

// 获取最后一个字符 't' 的 ASCII 码
console.log(message.charCodeAt(message.length - 1)); // 116str.charCodeAt() 时未显式传入参数,JavaScript 引擎会将其隐式转换为 0。但为了代码的可读性与工程规范,建议始终明确书写 str.charCodeAt(0) 或目标索引。
二、规范步骤:提取、边界判断与 ASCII 范围验证
在实际业务代码中,输入的数据往往来自于用户表单、网络请求或文件读取,存在空值、非字符串或越界的可能。单纯调用 charCodeAt() 容易在异常情况下引发意料之外的逻辑错误。遵循规范的操作步骤有助于构建健壮的逻辑。
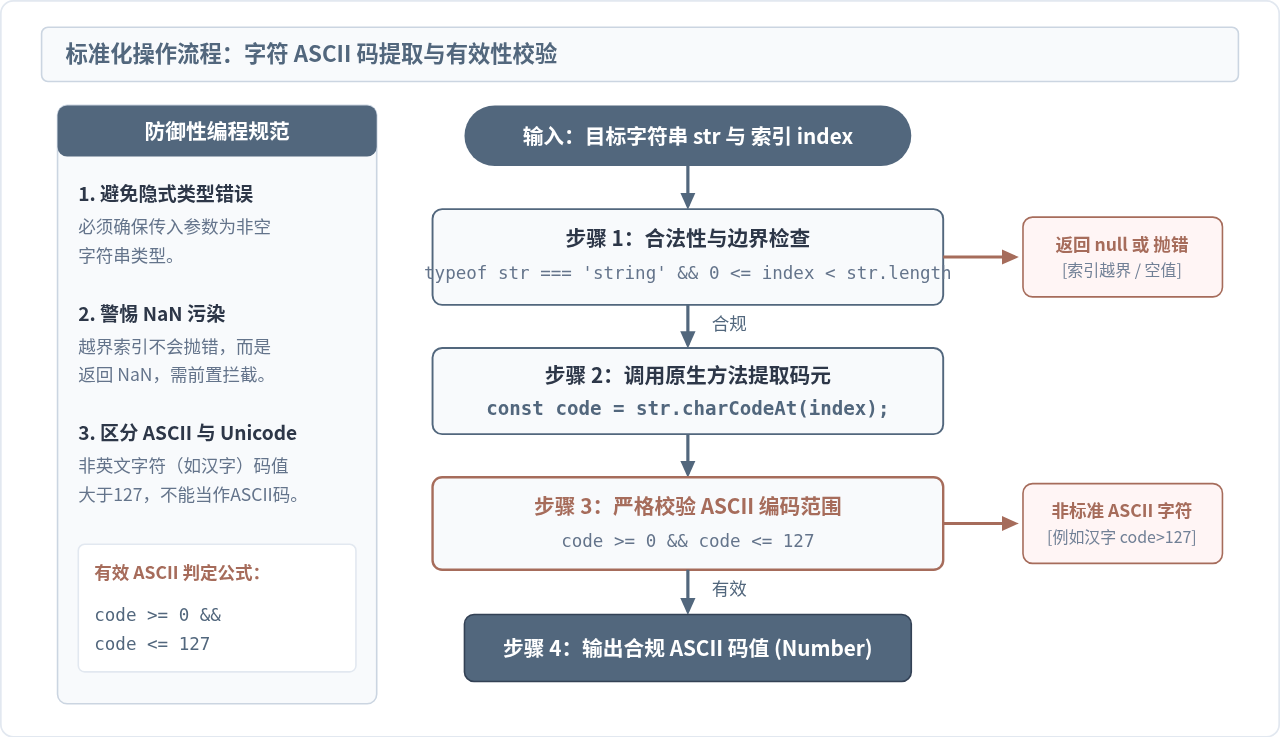
根据上述流程,可封装一个通用且安全的高可用提取函数:
/**
 * 安全获取指定字符的 ASCII 码值
 * @param {string} str - 待解析的字符串
 * @param {number} [index=0] - 目标字符索引,默认为 0
 * @returns {number|null} 返回 0~127 之间的有效 ASCII 码;非 ASCII 或异常返回 null
 */
function getAsciiCode(str, index = 0) {
  // 步骤 1:入参有效性与索引边界检查
  if (typeof str !== 'string' || str.length === 0) {
    return null;
  }
  if (index < 0 || index >= str.length) {
    return null;
  }

  // 步骤 2:调用 charCodeAt 获取码值
  const code = str.charCodeAt(index);

  // 步骤 3:验证是否在严格的 ASCII 字符集区间 (0 ~ 127)
  if (code >= 0 && code <= 127) {
    return code;
  }

  // 步骤 4:非 ASCII 字符处理(例如中文、扩展符号等)
  return null;
}

// 运行测试
console.log(getAsciiCode("Hello", 1));  // 101 (对应字符 'e')
console.log(getAsciiCode("Hello", 10)); // null (超出索引范围)
console.log(getAsciiCode("中文测试", 0)); // null (中文字符码值为 20013,非 ASCII)
console.log(getAsciiCode(12345, 0));    // null (入参非字符串)
三、方法对比:charCodeAt() 与 codePointAt() 的区别与选用
自 ECMAScript 2015 (ES6) 起,JavaScript 新增了 codePointAt() 方法。许多开发者会有疑问:为什么有了 charCodeAt() 还要引入 codePointAt()?在获取 ASCII 码时应该如何选用?
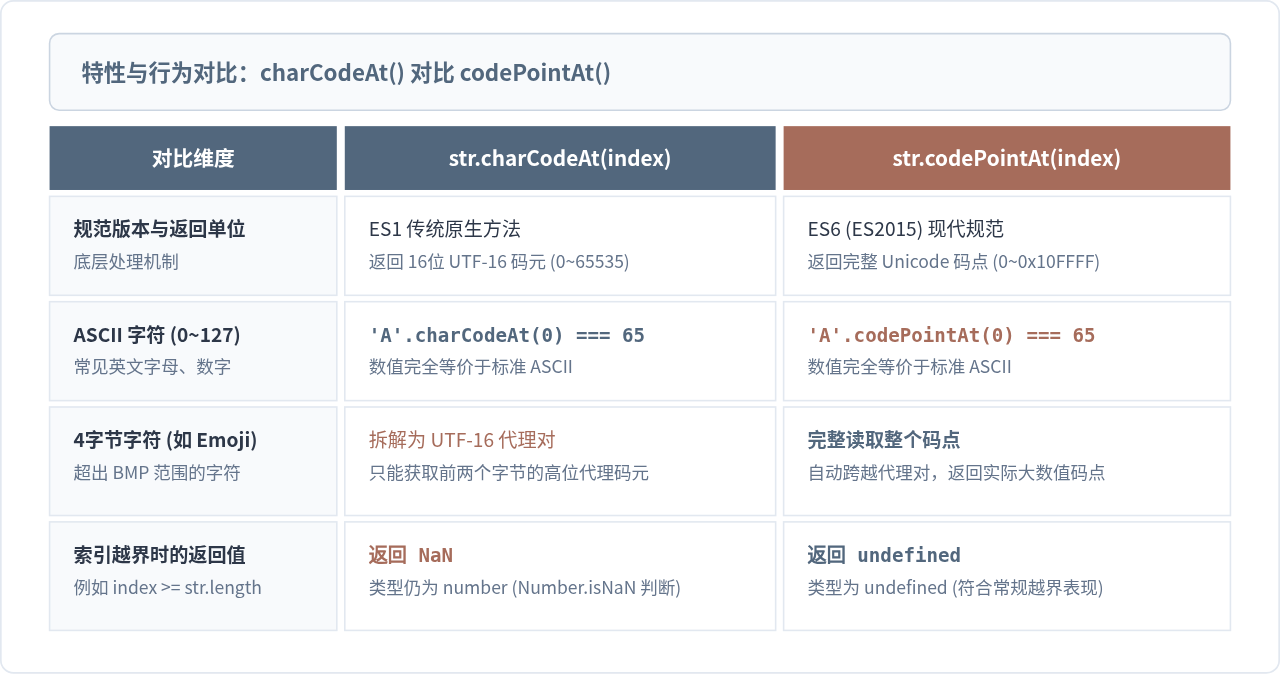
核心差异与选用结论:
- 针对 ASCII 码场景:如果你的业务需求仅仅是获取 ASCII 码(0~127),
charCodeAt()是运行性能极高、兼容所有 JavaScript 运行环境(包含远古版本浏览器和轻量嵌入式 JS 引擎)的首选。 - 越界错误判断的区别:当指定索引超过字符串长度时,
charCodeAt()返回NaN,而codePointAt()返回undefined。如果你的判断逻辑使用的是if (code === undefined),在采用charCodeAt()时就会失效,必须使用Number.isNaN(code)。 - 对现代 Unicode 字符串的兼容:若字符串中可能混合了四字节的 Emoji 表情符号(如
'😀')或生僻汉字,且需要获取正确的整体字符编码,则应使用codePointAt()。
四、实用扩展:批量获取、逆向还原与算法应用
在加密解密、文本解析、输入法映射或协议通信等场景下,我们常常需要批量提取字符串中所有字符的 ASCII 码,或者将 ASCII 码数值反向构造成字符。
1. 批量获取字符串中所有字符的 ASCII 码数组
可以通过 Array.from() 结合 map(),或者经典的 for 循环来实现批量提取:
const keyword = "HTTP/1.1";

// 方法一:现代简洁写法 (Array.from + map)
const asciiCodes = Array.from(keyword).map(char => char.charCodeAt(0));
console.log(asciiCodes);

// 方法二:高性能传统循环 (适用于长文本或微基准敏感场景)
const len = keyword.length;
const buffer = new Uint8Array(len);
for (let i = 0; i < len; i++) {
  buffer[i] = keyword.charCodeAt(i);
}
console.log(Array.from(buffer));[72, 84, 84, 80, 47, 49, 46, 49]
2. 逆向还原:通过 ASCII 码值生成字符
获取到 ASCII 码值后,如果需要还原为可显示的字符,可以使用 String.fromCharCode():
// 单个码值还原
console.log(String.fromCharCode(65)); // "A"
console.log(String.fromCharCode(97)); // "a"

// 接收多个参数,一次性拼装字符串
console.log(String.fromCharCode(74, 97, 118, 97)); // "Java"

// 通过扩展运算符还原整个 ASCII 数组
const codes = [83, 86, 71];
const word = String.fromCharCode(...codes);
console.log(word); // "SVG"
3. ASCII 码的位运算规律与大小写转换
标准 ASCII 码表的设计具有非常巧妙的二进制对齐规律:大写字母 'A'(65,二进制 01000001)与对应的小写字母 'a'(97,二进制 01100001)的 ASCII 码相差恒定为 32,恰好是第 5 位二进制位(从 0 计数)。
在底层算法实现中,开发者常利用这一数学特性进行不依赖字符串内置方法的高性能判定与转换:
// 1. 判断是否为大写英文字母 ('A' ~ 'Z' 对应 65 ~ 90)
function isUpperCase(char) {
  const code = char.charCodeAt(0);
  return code >= 65 && code <= 90;
}

// 2. 判断是否为阿拉伯数字字符 ('0' ~ '9' 对应 48 ~ 57)
function isDigit(char) {
  const code = char.charCodeAt(0);
  return code >= 48 && code <= 57;
}

// 3. 将数字字符转换为真实数字 (避免调用 parseInt)
function charToDigit(char) {
  return char.charCodeAt(0) - 48; // '5'.charCodeAt(0) 为 53, 53 - 48 = 5
}

console.log(isUpperCase('M')); // true
console.log(isDigit('8'));     // true
console.log(charToDigit('7')); // 7 (数值类型)
五、知识总结与 ASCII 常用码段速查
为了便于日常开发中快速定位字符编码,下面将 JavaScript 中处理 ASCII 码的核心 API 与 ASCII 常用区间进行了系统化梳理。
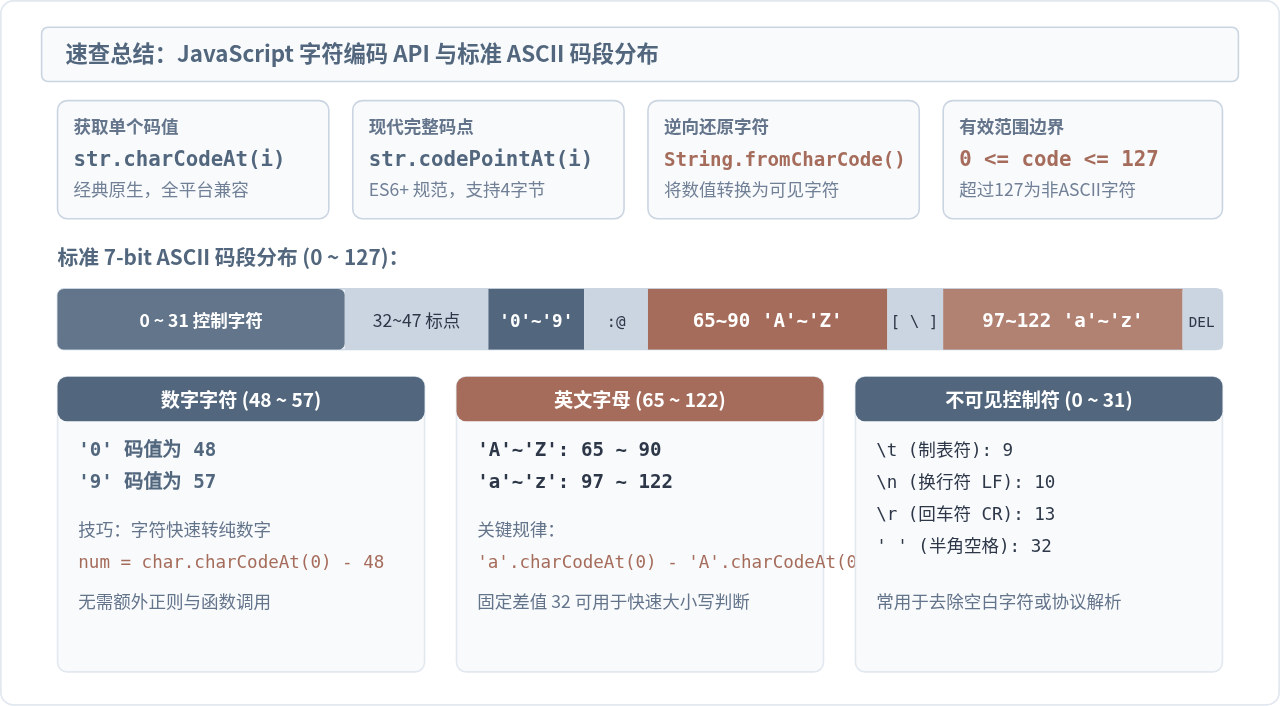
常用 ASCII 字符与码值速查表
| 分类 | 字符示例 | 十进制 ASCII 码 | 十六进制码 | 常用获取写法 |
|---|---|---|---|---|
| 换行符 |
|
10 | 0x0A | '
'.charCodeAt(0) |
| 回车符 | |
13 | 0x0D | '
'.charCodeAt(0) |
| 空格 | ' ' |
32 | 0x20 | ' '.charCodeAt(0) |
| 数字零 | '0' |
48 | 0x30 | '0'.charCodeAt(0) |
| 数字九 | '9' |
57 | 0x39 | '9'.charCodeAt(0) |
| 大写 A | 'A' |
65 | 0x41 | 'A'.charCodeAt(0) |
| 大写 Z | 'Z' |
90 | 0x5A | 'Z'.charCodeAt(0) |
| 小写 a | 'a' |
97 | 0x61 | 'a'.charCodeAt(0) |
| 小写 z | 'z' |
122 | 0x7A | 'z'.charCodeAt(0) |
总结来说,在 JavaScript 中获取字符的 ASCII 码值仅需一行核心代码:str.charCodeAt(index)。在需要高可靠性的业务场景中,配合字符串非空检查以及 0 <= code && code <= 127 范围校验,即可确保字符编码处理的安全与严谨。
JS倒计时结束后自动执行回调函数
2026-11-16 13:42:07
JavaScript对象数组引用陷阱:避免修改时相互影响
2026-11-16 13:24:10
前端项目中封装通用的JavaScript彩虹颜色工具函数
2026-11-16 13:24:05
JS获取URL参数并解决中文乱码问题
2026-11-16 13:23:40
JavaScript获取本机时间戳:Date.now()与getTime()区别
2026-11-14 17:31:37







