

Node.js与浏览器端JS字符串编码API的差异与兼容写法
深入对比Node.js与浏览器端在字符串编码、解码、Base64及十六进制转换上的原生API差异与历史根源,并提供生产级跨平台同构兼容解决方案与完整代码实现。
Buffer 模块,而浏览器端则依赖受限于单字节范围的 btoa/atob 与 URL 编码 Hack。尽管 WHATWG TextEncoder/TextDecoder 标准已在现代全平台普及并实现了 UTF-8 的统一,但在 Base64、Hex 以及多字符集支持上两端仍存在显著 API 断层。本文将具体剖析两端 API 的底层模型差异,并给出开箱即用的跨平台同构兼容解决方案。
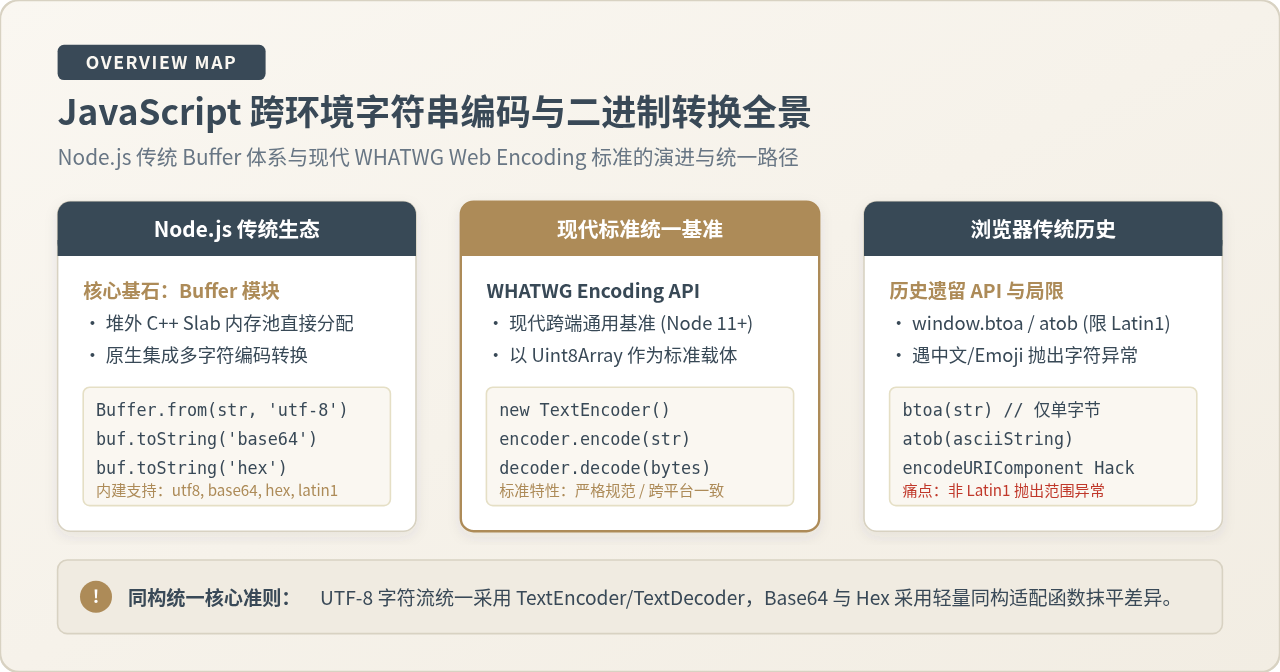
一、JavaScript 字符串的底层表示与编码断层
ECMAScript 规范明确规定,JavaScript 运行时的所有 String 对象在内存中均以 UTF-16 编码单元序列(16-bit code units)形式存在。对于处于 Unicode 基本多语言平面(BMP,码点在 U+0000 到 U+FFFF)内的字符(例如绝大多数常用汉字),一个字符对应一个 16 位单元;而对于增补平面字符(如 Emoji、部分历史汉字),则由一对代理对(Surrogate Pair,两个 16 位单元)组合表示。
然而在操作系统底层、网络 I/O、磁盘存储以及现代传输协议(如 HTTP、WebSocket、Protobuf)中,标准的数据载体是连续的 8 位字节序列(Uint8Array / 字节流),并且通用编码几乎皆为变长的 UTF-8。这就产生了一项高频且基础的工程需求:在 UTF-16 字符串对象 与 8-bit 字节序列 之间进行双向编解码。
两端环境在实现该需求时走过了完全不同的演化路线:
- Node.js 体系:自诞生起就定位为高性能网络服务端,为了高效处理 TCP 流和文件读写,绕过 V8 垃圾回收机制直接引入了基于 C++ 堆外内存分配的
Buffer对象,将多种编码(utf8, base64, hex, latin1)的编解码职责高度聚合在单一对象中。 - 浏览器端体系:早期受限于无原生直接读写内存的能力,仅提供了面向字符串转换的
window.btoa()和window.atob(),以及针对 URI 转义的encodeURIComponent()。直到 2010 年后 typed array 规范确立,以及随后的 WHATWG 推出TextEncoder和TextDecoder,浏览器才拥有了标准的二进制编码接口。
二、两端原生编码 API 体系与能力差异深度拆解
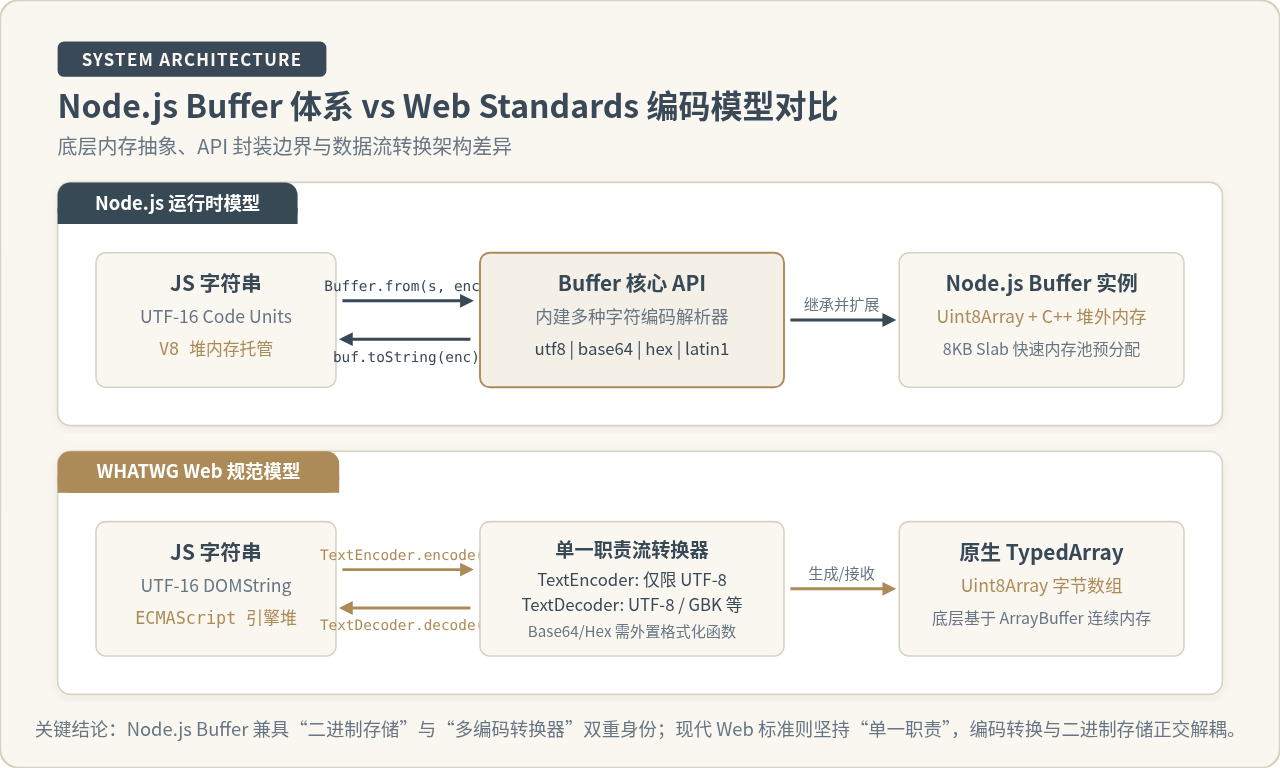
理解两端 API 的差异不仅有助于写出兼容代码,更能在排查乱码和运行时异常时快速定位根因。两端在 API 设计哲学、支持的字符集以及异常机制上存在本质区别。
1. Node.js 体系:功能高度内聚的 Buffer 模块
在 Node.js 中,全局对象 Buffer 是处理所有二进制数据与编码转换的核心。Buffer 是 JavaScript 原生 Uint8Array 的子类,但它深度扩充了原型方法,并由 Node.js 底层的 C++ 绑定提供强力性能支撑。
// 示例:Node.js 下字符串与多种编码的互相转换
const text = "技术解析";

// 1. 转换为 UTF-8 字节缓冲区
const bufUtf8 = Buffer.from(text, 'utf8'); // 默认即 utf8
console.log(bufUtf8); // <Buffer e6 8a 80 e6 9c af e8 a7 a3 e6 9e 90>

// 2. 将字节转换为 Base64 字符串
const b64 = bufUtf8.toString('base64');
console.log(b64); // "5oqA5pyv6Kej5p6Q"

// 3. 将 Base64 解码回字节与原始字符串
const decodedBuf = Buffer.from(b64, 'base64');
const originalText = decodedBuf.toString('utf8');

// 4. 十六进制(Hex)互转
const hexString = bufUtf8.toString('hex');
const fromHexBuf = Buffer.from(hexString, 'hex');
核心优势:API 简洁统一,无需额外格式化代码,天然支持 utf8、base64、hex、latin1、ascii 等主流编码;
关键限制:它是 Node.js 独有运行环境的产物,浏览器原生环境并不存在 Buffer 全局对象。如果直接在前端代码中使用 Buffer,必须通过打包工具(如 Webpack、Vite)注入庞大的 Polyfill 垫片,增加打包体积。
2. 浏览器传统 API:btoa、atob 与历史 Hack
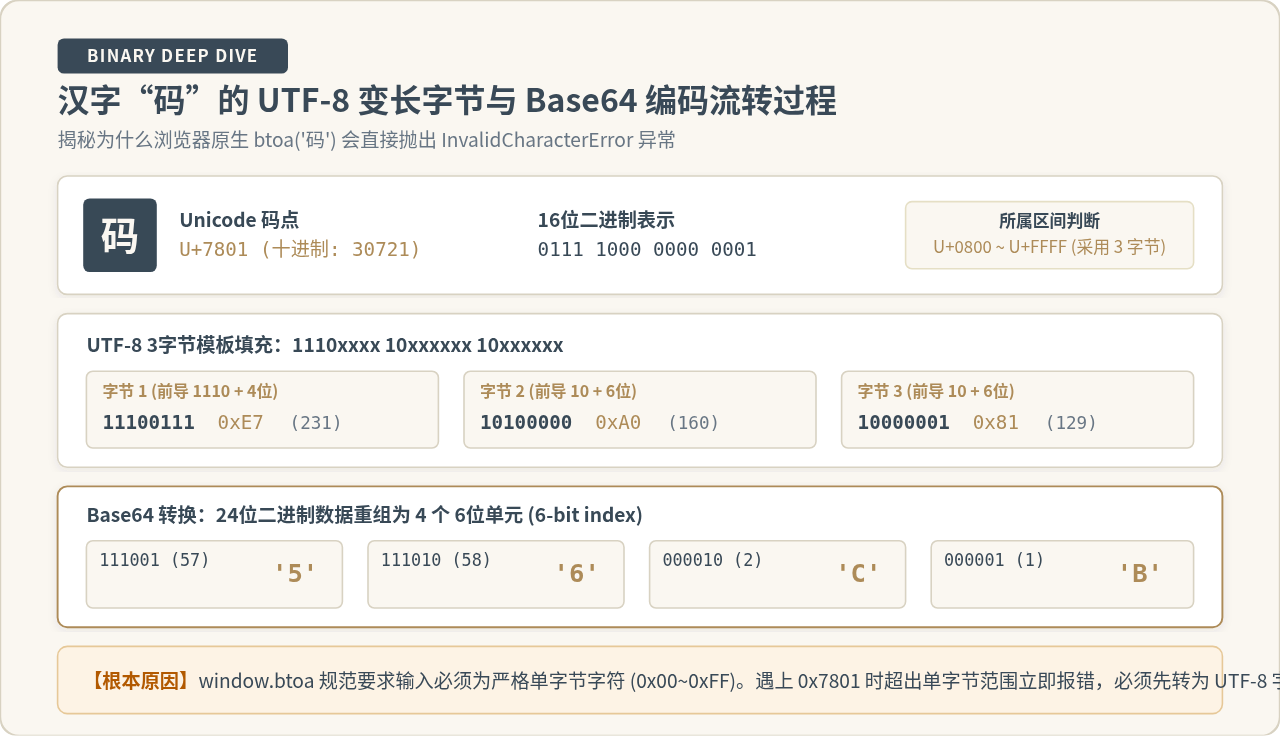
在浏览器环境中,处理 Base64 的经典原生 API 是 window.btoa()(Binary to ASCII)与 window.atob()(ASCII to Binary)。然而,这两个函数在诞生时只考虑了单字节 ASCII / Latin1 范围的字符(即码点 0x00 ~ 0xFF)。
// 正常运行:仅包含 ASCII 字符
const asciiBase64 = window.btoa("Hello World"); // "SGVsbG8gV29ybGQ="

// 异常发生:输入中文字符直接抛出运行时错误!
try {
  window.btoa("中文");
} catch (err) {
  console.error(err); // DOMException: Failed to execute 'btoa' on 'Window': The string to be encoded contains characters outside of the Latin1 range.
}
在过去缺乏标准 API 的年代,前端社区广泛使用 encodeURIComponent 对非 Latin1 字符进行转义,再将百分号(%XX)转为单字节字符交给 btoa 处理:
// 历史经典 Hack 写法(性能较差且产生大量中间字符串)
function legacyBtoa(str) {
  return btoa(encodeURIComponent(str).replace(/%([0-9A-F]{2})/g, (match, p1) => {
    return String.fromCharCode('0x' + p1);
  }));
}
这种写法通过正则匹配和多次字符串重建,在面对大型文本或高频调用时存在严重的性能瓶颈与临时内存分配开销。
3. 现代统一标准:WHATWG TextEncoder 与 TextDecoder
为了从根本上解决跨平台编码混乱的问题,WHATWG 制定了 Encoding API 规范,核心定义了两个接口:
TextEncoder:接受 JavaScript 字符串,将其编码为 UTF-8 格式的Uint8Array字节数组。根据规范设计,TextEncoder 仅支持 UTF-8,不支持指定其他编码。TextDecoder:接受二进制字节(Uint8Array或ArrayBuffer),按照指定字符集(默认 UTF-8,部分环境支持 gbk、gb18030、big5、shift_jis 等)解码为 JavaScript 字符串。
自 Node.js v8.3.0 引入(在 util 模块下),到 v11.0.0 正式挂载到全局作用域(globalThis.TextEncoder),现代所有主流环境(Chrome 38+、Firefox 19+、Safari 10.1+、Node.js 11+、Deno、Bun、Cloudflare Workers)均已完全实现该标准。
// 现代跨端标准原生写法
const encoder = new TextEncoder();
const utf8Bytes = encoder.encode("深入编码"); // 返回原生 Uint8Array
console.log(utf8Bytes); // Uint8Array(12) [230, 183, 177, 229, 133, 165, 231, 188, 150, 231, 160, 129]

const decoder = new TextDecoder('utf-8');
const textResult = decoder.decode(utf8Bytes);
console.log(textResult); // "深入编码"| 对比维度 | Node.js (传统 Buffer) | 浏览器 (历史 API) | WHATWG 标准 (现代规范) |
|---|---|---|---|
| 全局可用性 | 全局原生具备 (Buffer) |
全局挂载 (btoa, atob) |
全局原生具备 (现代 Node 与现代浏览器) |
| 支持编码格式 | utf8, base64, hex, latin1, ascii | 严格单字节 (0x00 ~ 0xFF) | 编码仅 UTF-8;解码支持多字符集 |
| 非 ASCII 表现 | 原生自动按对应编码格式转换 | 直接抛出 InvalidCharacterError |
按 UTF-8 变长规范安全转码 |
| 底层二进制容器 | Buffer (扩展自 Uint8Array) |
无 (依赖二进制格式字符串) | 标准 Uint8Array |
三、核心场景编码差异与同构兼容写法
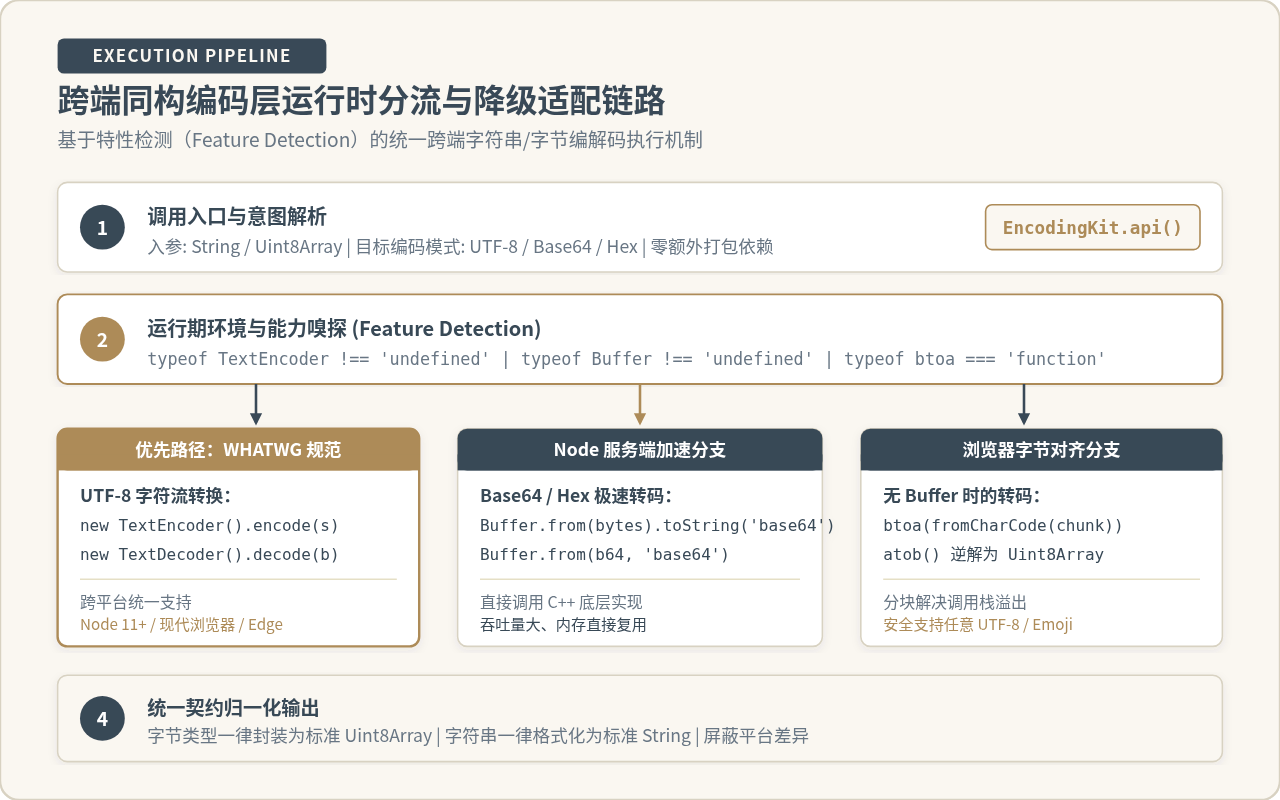
在构建既能在 Node.js 服务端(如 SSR 渲染、中间件)运行,又能在浏览器端直接执行的同构 JavaScript 库时,我们必须针对不同需求采用兼具性能与兼容性的实现策略。
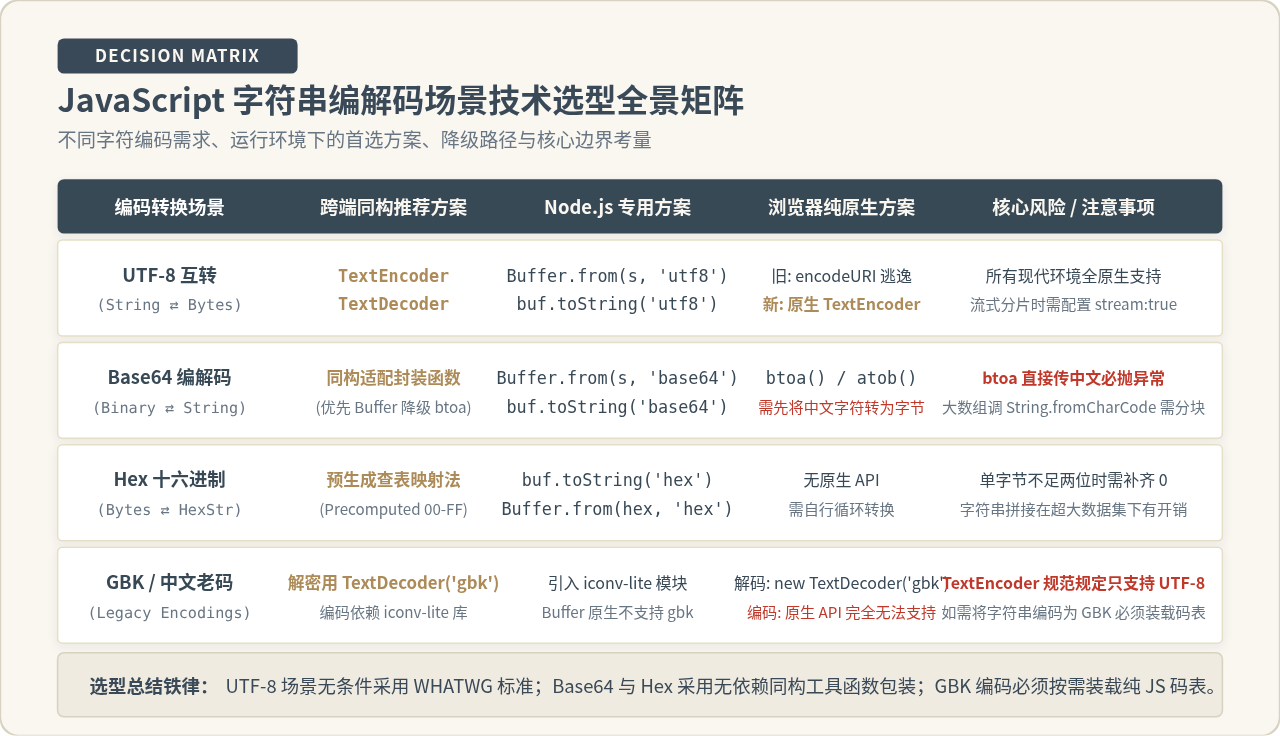
场景 1:UTF-8 字符串与 Uint8Array 字节数组互转
对于纯 UTF-8 互转,现代标准已经高度统一。同构的最佳实践是直接使用全局 TextEncoder 和 TextDecoder,仅在极端老旧环境中通过 Node.js Buffer 或 URL 逃逸进行兜底。
/**
 * 字符串转 UTF-8 Uint8Array
 */
export function stringToBytes(str) {
  if (typeof TextEncoder !== 'undefined') {
    return new TextEncoder().encode(str);
  }
  if (typeof Buffer !== 'undefined') {
    const buf = Buffer.from(str, 'utf8');
    return new Uint8Array(buf.buffer, buf.byteOffset, buf.byteLength);
  }
  // 极端旧环境降级:URL 逃逸法
  const encoded = encodeURIComponent(str);
  const bytes = [];
  for (let i = 0; i < encoded.length; i++) {
    if (encoded[i] === '%') {
      bytes.push(parseInt(encoded.substr(i + 1, 2), 16));
      i += 2;
    } else {
      bytes.push(encoded.charCodeAt(i));
    }
  }
  return new Uint8Array(bytes);
}

/**
 * UTF-8 Uint8Array 字节数组转字符串
 */
export function bytesToString(bytes) {
  if (typeof TextDecoder !== 'undefined') {
    return new TextDecoder('utf-8').decode(bytes);
  }
  if (typeof Buffer !== 'undefined') {
    return Buffer.from(bytes.buffer, bytes.byteOffset, bytes.byteLength).toString('utf8');
  }
  // 降级方案
  let encoded = '';
  for (let i = 0; i < bytes.length; i++) {
    encoded += '%' + bytes[i].toString(16).padStart(2, '0');
  }
  return decodeURIComponent(encoded);
}
场景 2:安全跨环境 Base64 编解码
Base64 转换是同构代码中最容易暴雷的场景。浏览器原生 btoa 无法接收 Unicode 字符串,且 String.fromCharCode.apply(null, bytes) 在面对超过 65536 字节的大数组时会触发 RangeError: Maximum call stack size exceeded 调用栈溢出。
严谨的跨端兼容逻辑应包含两层防护:
- 环境分流:Node.js 环境下优先调用底层的
Buffer.from().toString('base64'),获得极高的 C++ 级转换吞吐。 - 浏览器环境下:先利用
TextEncoder将任意 Unicode 文本规整为Uint8Array,再通过定长分块(Chunking)机制转换为单字节字符串,最后安全传入btoa。
const CHUNK_SIZE = 0x8000; // 32768 字节分块,避免调用栈溢出

/**
 * 将字符串或 Uint8Array 安全转为 Base64
 */
export function toBase64(input) {
  // 1. 如果已在 Node.js 环境,直接利用 Buffer 极速转换
  if (typeof Buffer !== 'undefined') {
    if (typeof input === 'string') {
      return Buffer.from(input, 'utf8').toString('base64');
    }
    return Buffer.from(input.buffer, input.byteOffset, input.byteLength).toString('base64');
  }

  // 2. 浏览器环境:规范化为 Uint8Array
  const bytes = typeof input === 'string' ? new TextEncoder().encode(input) : input;

  // 3. 安全分块构建单字节字符序列
  let binaryStr = '';
  const len = bytes.length;
  for (let i = 0; i < len; i += CHUNK_SIZE) {
    const chunk = bytes.subarray(i, Math.min(i + CHUNK_SIZE, len));
    binaryStr += String.fromCharCode.apply(null, chunk);
  }

  return window.btoa(binaryStr);
}

/**
 * 将 Base64 字符串安全解码为 Uint8Array
 */
export function fromBase64ToBytes(base64Str) {
  if (typeof Buffer !== 'undefined') {
    const buf = Buffer.from(base64Str, 'base64');
    return new Uint8Array(buf.buffer, buf.byteOffset, buf.byteLength);
  }

  const binaryStr = window.atob(base64Str);
  const len = binaryStr.length;
  const bytes = new Uint8Array(len);
  for (let i = 0; i < len; i++) {
    bytes[i] = binaryStr.charCodeAt(i);
  }
  return bytes;
}

/**
 * 将 Base64 字符串直接还原为 UTF-8 原始文本
 */
export function fromBase64ToString(base64Str) {
  const bytes = fromBase64ToBytes(base64Str);
  return bytesToString(bytes);
}
场景 3:十六进制(Hex)编解码
十六进制转换常用于加密哈希结果展示(如 MD5, SHA-256)与色彩值编码。Node.js 提供了 buf.toString('hex') 与 Buffer.from(hex, 'hex');而现代浏览器缺少对应内置方法。
为了保证在浏览器端拥有极致的转换效率,避免每次循环都调用 byte.toString(16).padStart(2, '0') 带来的重复求值与字符串开销,推荐采用预生成 256 位查找表(Lookup Table)的高性能兼容方案:
// 预生成 0x00 ~ 0xFF 对应的十六进制字符查找表
const HEX_TABLE = new Array(256);
for (let i = 0; i < 256; i++) {
  HEX_TABLE[i] = i.toString(16).padStart(2, '0');
}

/**
 * Uint8Array 转十六进制字符串
 */
export function bytesToHex(bytes) {
  if (typeof Buffer !== 'undefined') {
    return Buffer.from(bytes.buffer, bytes.byteOffset, bytes.byteLength).toString('hex');
  }
  const len = bytes.length;
  const hexParts = new Array(len);
  for (let i = 0; i < len; i++) {
    hexParts[i] = HEX_TABLE[bytes[i]];
  }
  return hexParts.join('');
}

/**
 * 十六进制字符串转 Uint8Array
 */
export function hexToBytes(hexString) {
  const cleanHex = hexString.startsWith('0x') ? hexString.slice(2) : hexString;
  if (cleanHex.length % 2 !== 0) {
    throw new TypeError("十六进制字符串长度必须为偶数");
  }
  if (typeof Buffer !== 'undefined') {
    const buf = Buffer.from(cleanHex, 'hex');
    return new Uint8Array(buf.buffer, buf.byteOffset, buf.byteLength);
  }
  const byteLen = cleanHex.length / 2;
  const bytes = new Uint8Array(byteLen);
  for (let i = 0; i < byteLen; i++) {
    bytes[i] = parseInt(cleanHex.substr(i * 2, 2), 16);
  }
  return bytes;
}
四、开箱即用的跨平台同构编码工具包(EncodingKit)
基于上述工程策略,我们可以将所有方案凝练为一个完全独立、无外部依赖的通用同构编码单文件模块。该模块自动嗅探当前宿主环境,在 Node.js 中走高速原生路径,在浏览器中走标准零损耗路径:
/**
 * EncodingKit - 跨端同构通用字符串与二进制编解码套件
 * 兼容环境:Node.js 11+ / Browser / Electron / Cloudflare Workers
 */
export const EncodingKit = (() => {
  const isNode = typeof Buffer !== 'undefined';
  const hasTextAPI = typeof TextEncoder !== 'undefined' && typeof TextDecoder !== 'undefined';
  const CHUNK_LIMIT = 0x8000;

  // 预生成十六进制快速查找表
  const BYTE_TO_HEX = new Array(256);
  for (let i = 0; i < 256; i++) {
    BYTE_TO_HEX[i] = i.toString(16).padStart(2, '0');
  }

  // 惰性单例编码解码器
  let cachedEncoder = null;
  let cachedDecoder = null;
  const getEncoder = () => (cachedEncoder || (cachedEncoder = new TextEncoder()));
  const getDecoder = () => (cachedDecoder || (cachedDecoder = new TextDecoder('utf-8')));

  return {
    /**
     * 将字符串编码为 UTF-8 Uint8Array
     */
    encodeUtf8(str) {
      if (typeof str !== 'string') throw new TypeError('入参必须为字符串类型');
      if (hasTextAPI) return getEncoder().encode(str);
      if (isNode) {
        const b = Buffer.from(str, 'utf8');
        return new Uint8Array(b.buffer, b.byteOffset, b.byteLength);
      }
      // 兼容回退
      const uri = encodeURIComponent(str);
      const out = [];
      for (let i = 0; i < uri.length; i++) {
        if (uri[i] === '%') {
          out.push(parseInt(uri.slice(i + 1, i + 3), 16));
          i += 2;
        } else {
          out.push(uri.charCodeAt(i));
        }
      }
      return new Uint8Array(out);
    },

    /**
     * 将二进制字节解码为 UTF-8 字符串
     */
    decodeUtf8(bytes) {
      if (!(bytes instanceof Uint8Array)) {
        if (ArrayBuffer.isView(bytes)) {
          bytes = new Uint8Array(bytes.buffer, bytes.byteOffset, bytes.byteLength);
        } else {
          throw new TypeError('入参必须为 Uint8Array 或 ArrayBufferView');
        }
      }
      if (hasTextAPI) return getDecoder().decode(bytes);
      if (isNode) {
        return Buffer.from(bytes.buffer, bytes.byteOffset, bytes.byteLength).toString('utf8');
      }
      let escaped = '';
      for (let i = 0; i < bytes.length; i++) {
        escaped += '%' + BYTE_TO_HEX[bytes[i]];
      }
      return decodeURIComponent(escaped);
    },

    /**
     * 转为 Base64 格式
     */
    toBase64(input) {
      if (isNode) {
        if (typeof input === 'string') return Buffer.from(input, 'utf8').toString('base64');
        return Buffer.from(input.buffer, input.byteOffset, input.byteLength).toString('base64');
      }
      const bytes = typeof input === 'string' ? this.encodeUtf8(input) : input;
      let binStr = '';
      for (let i = 0; i < bytes.length; i += CHUNK_LIMIT) {
        const slice = bytes.subarray(i, Math.min(i + CHUNK_LIMIT, bytes.length));
        binStr += String.fromCharCode.apply(null, slice);
      }
      return btoa(binStr);
    },

    /**
     * 从 Base64 还原为 Uint8Array 字节
     */
    fromBase64(base64Str) {
      if (typeof base64Str !== 'string') throw new TypeError('入参必须为字符串类型');
      if (isNode) {
        const b = Buffer.from(base64Str, 'base64');
        return new Uint8Array(b.buffer, b.byteOffset, b.byteLength);
      }
      const binStr = atob(base64Str);
      const len = binStr.length;
      const bytes = new Uint8Array(len);
      for (let i = 0; i < len; i++) {
        bytes[i] = binStr.charCodeAt(i);
      }
      return bytes;
    },

    /**
     * 二进制字节转十六进制小写字符串
     */
    toHex(bytes) {
      if (isNode) {
        return Buffer.from(bytes.buffer, bytes.byteOffset, bytes.byteLength).toString('hex');
      }
      const len = bytes.length;
      const parts = new Array(len);
      for (let i = 0; i < len; i++) parts[i] = BYTE_TO_HEX[bytes[i]];
      return parts.join('');
    },

    /**
     * 十六进制字符串转 Uint8Array
     */
    fromHex(hexStr) {
      const clean = hexStr.startsWith('0x') ? hexStr.slice(2) : hexStr;
      if (clean.length % 2 !== 0) throw new TypeError('十六进制字符长度必须为偶数');
      if (isNode) {
        const b = Buffer.from(clean, 'hex');
        return new Uint8Array(b.buffer, b.byteOffset, b.byteLength);
      }
      const count = clean.length / 2;
      const out = new Uint8Array(count);
      for (let i = 0; i < count; i++) {
        out[i] = parseInt(clean.substr(i * 2, 2), 16);
      }
      return out;
    }
  };
})();
五、生产环境避坑指南与工程建议
在实际工程项目中,除了掌握基本的 API 转换之外,还需要警惕以下高发踩坑点:
在 Node.js 中,将 Uint8Array 包装为 Buffer 时,常见的错误写法是 Buffer.from(uint8.buffer)。
注意:Uint8Array 可能是从某个大的 ArrayBuffer 中切片(subarray)出来的视图,其 byteOffset 不一定为 0,byteLength 也不一定等于 buffer.byteLength!
如果直接传入 .buffer,会导致读取到该内存块其他区域的脏数据。
正确姿势:永远显式传递偏移与长度:
Buffer.from(uint8.buffer, uint8.byteOffset, uint8.byteLength)。
在处理大型网络流或大文件分块读取时,一个 UTF-8 汉字(3 个字节)可能正好被切分在两个连续的传输 Chunk 边界上(例如 Chunk 1 包含前 2 个字节,Chunk 2 包含第 3 个字节)。
如果直接对每个 Chunk 单独调用 new TextDecoder().decode(chunk),解码器会认为该多字节序列已残缺,从而将首个分片替换为乱码替代符 �(即显示为未知字符“”)。
正确姿势:复用同一个 TextDecoder 实例,并开启流式选项:
decoder.decode(chunk, { stream: true }),在最后一个分块到来时调用 decoder.decode(lastChunk, { stream: false }) 冲刷残余字节。
Webpack 4 时代曾默认注入 node-libs-browser,许多前端代码随意引用 Buffer 导致打包结果默默塞入数十 KB 的垫片。在 Vite、Webpack 5 与 Rollup 时代,默认不再提供 Node 原生模块垫片,直接使用 Buffer 会抛出 Uncaught ReferenceError: Buffer is not defined。
同构库作者应当优先面向 WHATWG 标准 API 编码,尽量避免在无必要的情况下迫使下游项目安装并配置 vite-plugin-node-polyfills 等重量级打包插件。
结语
JavaScript 字符串编码的跨端差异实质上反映了宿主环境从各自发展到走向现代 Web 规范统一的历史进程。在现代工程实践中,推荐原则可以总结为:“UTF-8 字符流坚定采用 WHATWG TextEncoder / TextDecoder,Base64 与 Hex 采用纯轻量同构包装抹平环境断层,坚决避免在前端引入沉重的 Buffer 运行时垫片”。通过规范化的特征检测与类型约束,即可构建出性能优异、体积小巧且具备工业级健壮性的全环境同构代码。
Visual Studio 2022 17.14.45的Node.js残留和SDK修复适用于哪些情况
2026-11-16 10:38:43
Transformers 5.23.0统一导出接口为什么不等于各后端性能相同?
2026-11-14 18:02:20
Node.js是什么:基于Chrome V8的JavaScript运行时环境
2026-11-13 15:56:45
Node.js官网安装包下载指南:怎么获取最新LTS稳定版
2026-11-12 22:30:11
怎么在npm scripts中跨平台设置Node.js环境变量
2026-11-12 14:05:18







