JS生成不含重复字符的随机字母串
在 JavaScript 中生成不含重复字符的随机字母串,核心在于理解字符集上限与无放回随机抽样。本文详细对比 Set 循环重试与 Fisher-Yates 部分洗牌算法,给出确定性 O(k) 复杂度的高性能实现方案与生产级参数校验。
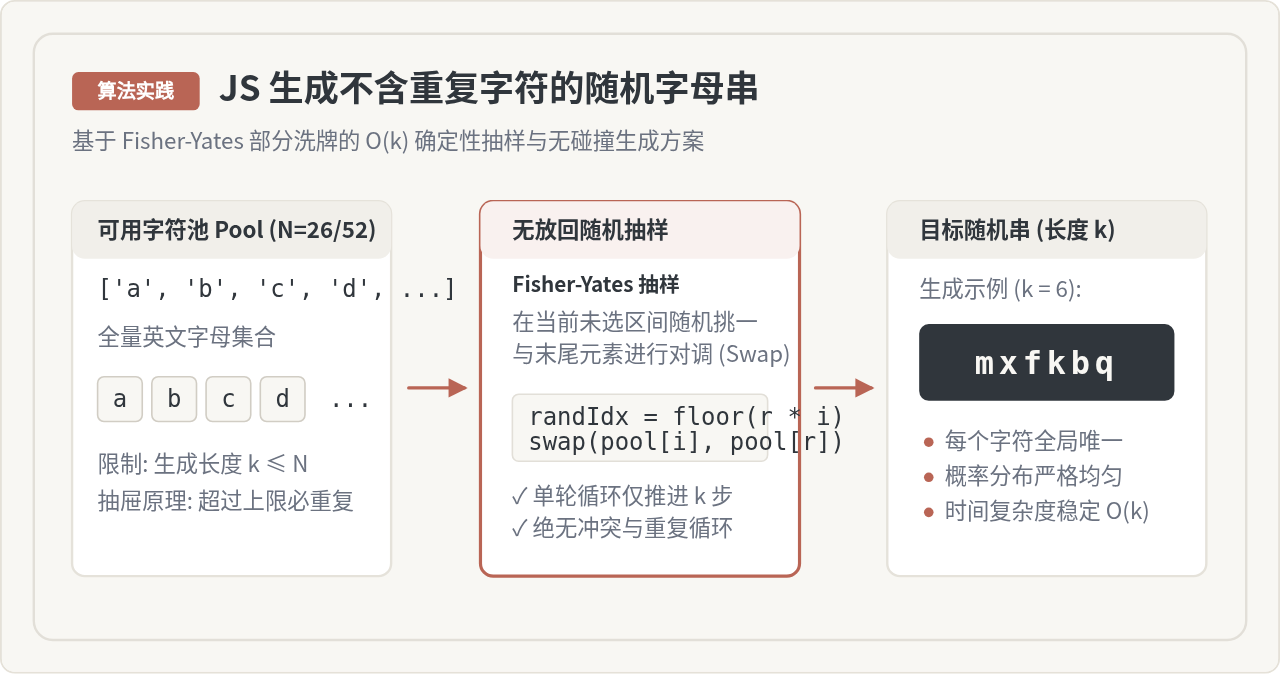
在 JavaScript 中生成指定长度且字符互不相同的随机字母串,最常见也最稳妥的方案是基于 Fisher-Yates 部分洗牌算法(Durstenfeld 变体)进行无放回抽样。它直接在预设的字母数组中,通过每次将随机选取的元素与待抽样区间末尾元素对调,在严格 O(k) 的步数内获得结果。这种做法不仅数学上概率完全均匀,而且完全规避了传统循环去重在长度逼近上限时的碰撞死循环风险。
一、核心限制条件与抽屉原理
在编写任何生成逻辑之前,必须明确“字符不重复”所带来的刚性数学边界。不同于普通的有放回随机串(如任意长度的纯数字验证码),不重复字符串的长度受制于基础字符集(Alphabet Pool)的容量。
现代拉丁字母表中,常用的字符集容量定义如下:
- 纯小写字母集 (
a-z):共 26 个候选字符; - 纯大写字母集 (
A-Z):共 26 个候选字符; - 大小写混合字母集 (
a-zA-Z):共 52 个候选字符。
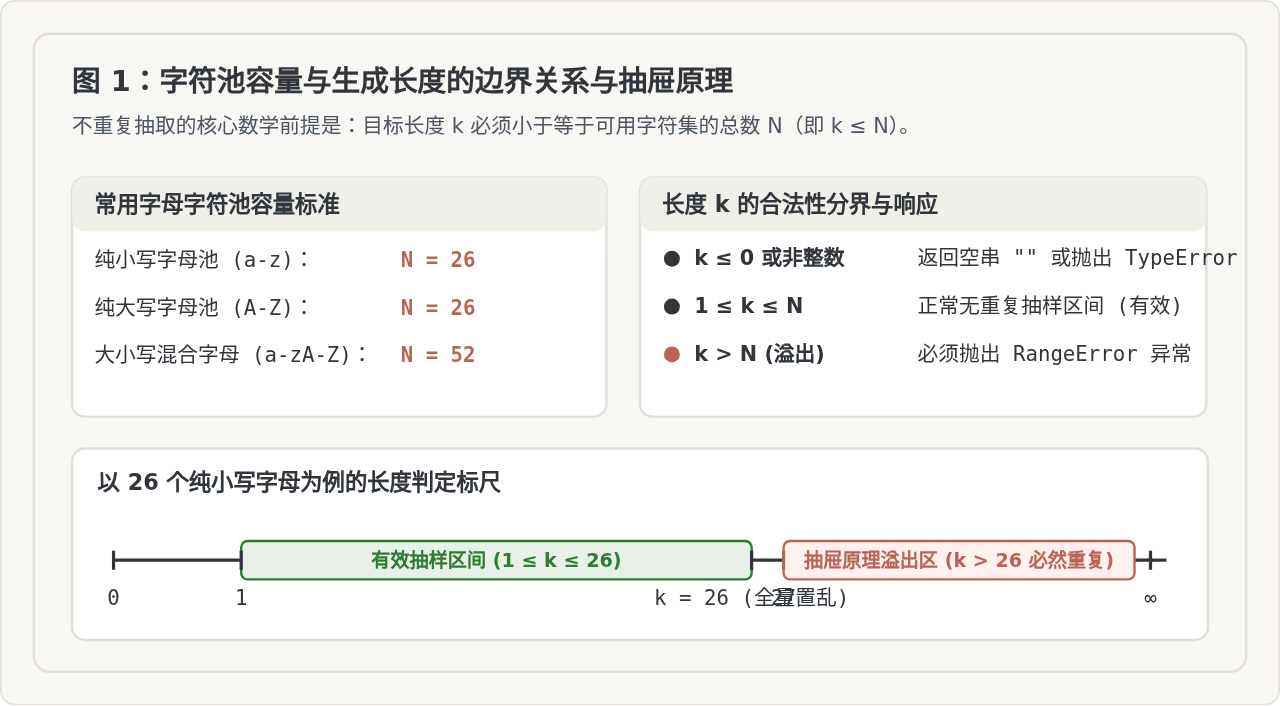
根据离散数学中的抽屉原理(Pigeonhole Principle):如果可用字符池共有 N 个字符,而要求生成的字符串长度 k 满足 k > N,则无论采取何种算法,生成的字符串中必定至少存在一个重复字符。因此,任何符合工程规范的实现函数,都必须首先对入参 k 进行防御性边界判定:
k <= 0 时,应直接返回空字符串 "";而当 k > pool.length 时,由于数学上不可行,程序必须显式抛出 RangeError,绝不能陷入无休止的重试循环或静默产出错误长度的串。
二、常见实现方案对比与性能缺陷剖析
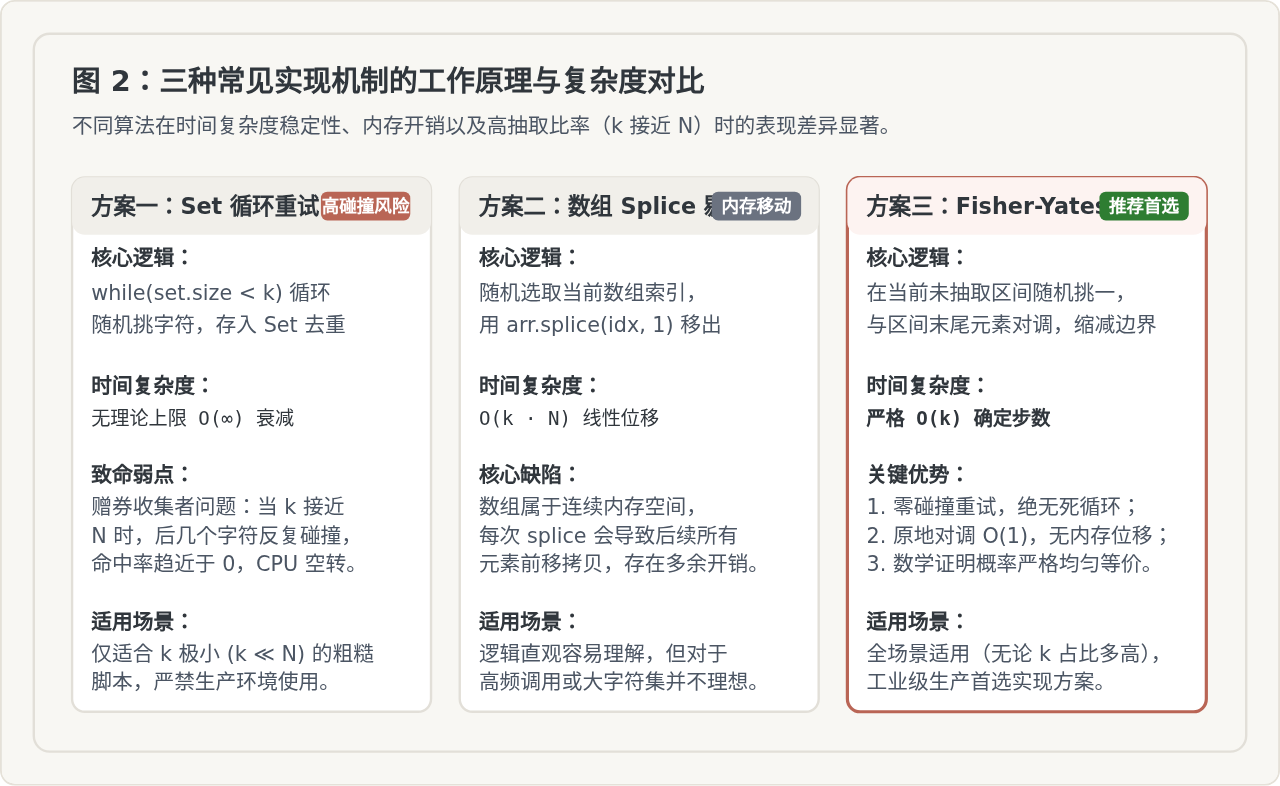
开发者在初次实现该需求时,通常容易想到以下三种思路。了解它们的机制与代价,有助于我们在实际开发中做出更合理的权衡。
1. 为什么不推荐 Set 循环重试法?
不少初学者喜欢利用 while (set.size < k) 搭配 Math.random() 不断向 Set 中添加随机选取的字母。表面上看这种写法只有四五行代码,但在算法理论上它属于典型的赠券收集者问题(Coupon Collector's Problem)。
当 k 较小(例如在 52 个字母中取 4 个)时,碰撞概率极低,执行速度很快。但当 k 接近 N 时(例如在 26 个小写字母中抽取 25 个),剩下最后 1 个未选字符的抽取概率仅有 1 / 26 ≈ 3.8%。此时,程序平均需要进行 26 次随机尝试才能命中,期间会引发数十次无效碰撞;一旦需求是抽取 26 个,循环尝试的次数期望值会陡增至 26 × (1 + 1/2 + 1/3 + ... + 1/26) ≈ 100 次。在极端恶劣情况下,这种非确定性算法还会带来不可预测的 CPU 占用抖动。
2. 为什么数组 splice 剔除法不是最优解?
另一种直观思路是:将字符放入数组,每次生成一个介于 [0, arr.length - 1] 之间的随机索引,取出该字符后使用 arr.splice(index, 1) 将其剔除。虽然这种方法不会发生冲突,但 JavaScript 引擎中的 Array 底层是连续内存存储的,每次 splice 剔除中间元素都会强制把后续所有元素前移一位,造成额外的内存复制开销,其整体时间复杂度为 O(k · N)。
| 算法方案 | 时间复杂度 | 空间开销 | 碰撞概率 | 工程建议 |
|---|---|---|---|---|
| Set 循环探测去重 | 最好 O(k) / 最坏 O(∞) | O(k) | 随 k 增长呈指数级恶化 | 不推荐,严禁生产环境使用 |
| 数组 splice 剔除 | O(k · N) | O(N) | 0 (无碰撞) | 可用但存在无谓的数组位移拷贝 |
| Fisher-Yates 部分洗牌 | 严格确定 O(k) | O(N) 副本 | 0 (无碰撞) | 生产环境标准首选 |
三、标准实现:Fisher-Yates 部分洗牌算法
针对“从 N 个元素中随机选取 k 个不重复元素”的问题,计算机科学中最经典的解法是 Fisher-Yates 洗牌算法(Durstenfeld 原地交换版本)。更进一步,如果只需要 k 个字符,我们根本不需要将整个数组完全洗牌(洗牌需要 N-1 步),而只需进行 k 轮原地对调,即可在 O(k) 时间内获得完全等概率分布的结果。
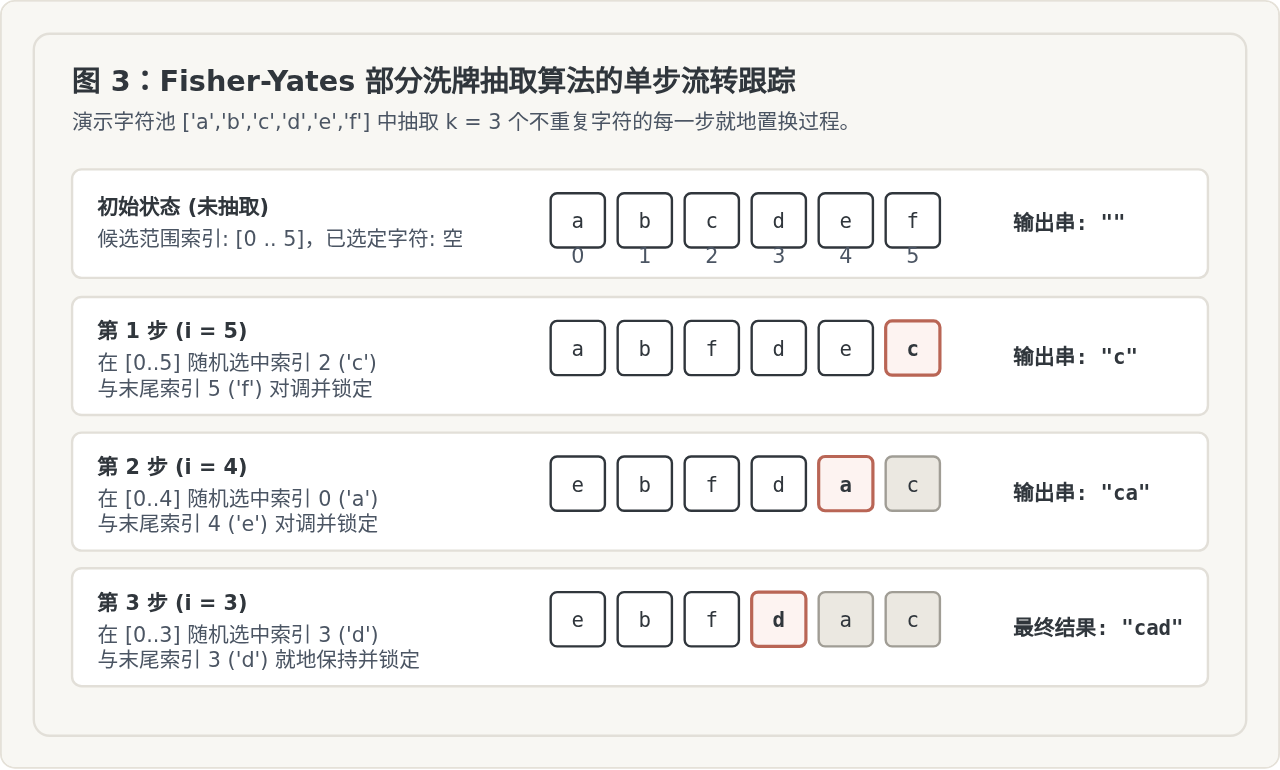
1. 原理拆解
- 准备一个包含候选字符的数组副本(例如长度为
N)。 - 维护一个当前候选区间的右边界指针
i(初始为N - 1)。 - 在闭区间
[0, i]内随机选取一个整数索引j。 - 将索引
j处的字符与索引i处的字符进行交换。此时,索引i处的字符已被确定为抽中的字符,其被选中的概率为严格的1 / (i + 1)。 - 将
i自减 1,缩小未选区间,重复上述步骤,直到完成了k次交换。 - 直接截取数组末尾(或头部)的
k个元素拼接成字符串输出。
2. 生产级完整代码示例
下面给出具备完善边界保护、支持大小写自定义选择以及保证确定性性能的标准 JavaScript 函数实现:
/**
 * 生成不含重复字符的随机字母串
 *
 * @param {number} length - 期望生成的字符串长度 (k)
 * @param {Object} [options] - 可选配置项
 * @param {boolean} [options.uppercase=false] - 是否包含大写字母 (默认 false,仅小写)
 * @param {boolean} [options.lowercase=true] - 是否包含小写字母 (默认 true)
 * @returns {string} 生成的不含重复字符的随机串
 * @throws {TypeError} 当 length 不是有效整数时抛出
 * @throws {RangeError} 当 length 超出可用字符集容量时抛出
 */
function generateUniqueRandomLetters(length, options = {}) {
  // 1. 参数防御校验:确保 length 为合法非负整数
  if (!Number.isInteger(length)) {
    throw new TypeError("参数 length 必须为有效整数");
  }
  if (length <= 0) {
    return "";
  }

  // 2. 解析字符集配置
  const useLower = options.lowercase !== false;
  const useUpper = Boolean(options.uppercase);

  if (!useLower && !useUpper) {
    throw new Error("至少必须启用大写或小写字母中的一种字符池");
  }

  // 3. 构建字符候选池 (必须使用副本,严禁直接原地修改常量池)
  let charset = "";
  if (useLower) charset += "abcdefghijklmnopqrstuvwxyz";
  if (useUpper) charset += "ABCDEFGHIJKLMNOPQRSTUVWXYZ";

  const pool = charset.split("");
  const n = pool.length;

  // 4. 抽屉原理边界断言:抽取长度不可超过字符集总数
  if (length > n) {
    throw new RangeError(
      `请求长度 (${length}) 超出字符池容量 (${n}),数学上无法满足字符互不重复`
    );
  }

  // 5. Fisher-Yates 部分洗牌抽样:循环只执行 length 步
  for (let i = n - 1; i >= n - length; i--) {
    // 在 [0, i] 区间内生成均匀随机整数
    const randIndex = Math.floor(Math.random() * (i + 1));

    // 原地交换当前未抽取尾部元素与随机命中元素
    const temp = pool[i];
    pool[i] = pool[randIndex];
    pool[randIndex] = temp;
  }

  // 6. 截取最后 length 个已被确定置乱的字符并拼接返回
  return pool.slice(n - length).join("");
}
3. 示例调用与输出验证
// 示例 1: 从 26 个小写字母中随机抽取 8 个不重复字符
const str1 = generateUniqueRandomLetters(8);
console.log(str1); // 示例输出: "qtxpmvak"

// 示例 2: 从 52 个大小写字母中抽取 16 个不重复字符
const str2 = generateUniqueRandomLetters(16, { uppercase: true });
console.log(str2); // 示例输出: "LkMwRzPnXvGbTsYq"

// 示例 3: 边界测试 - 抽取正好 26 个小写字母(全量小写字符乱序排列)
const str3 = generateUniqueRandomLetters(26);
console.log(str3); // 示例输出: "fkbqmxzpawlhgvdcoeyrnstjui"

// 示例 4: 异常触发测试 - 请求 30 个纯小写字母,触发抽屉原理断言
try {
  generateUniqueRandomLetters(30, { uppercase: false });
} catch (err) {
  console.error(err.message);
  // 示例输出: "请求长度 (30) 超出字符池容量 (26),数学上无法满足字符互不重复"
}
四、安全性升级:引入密码学安全伪随机数 (CSPRNG)
在开发用户 Token、重置验证码、临时口令等安全敏感业务时,标准的 Math.random() 并不具备密码学安全性(由于 V8 等引擎使用的是 xorshift128+ 算法,其内部状态可能被攻击者收集一定样本后预测逆向)。
在现代浏览器与 Node.js 15+ 环境中,我们可以将 Math.random() 无缝平替为原生的 crypto.getRandomValues(),以确保字符抽样完全不可预测:
/**
 * 生成介于 [0, max] 之间的密码学安全均匀随机整数
 * @param {number} max - 最大上限 (包含)
 * @returns {number} 随机整数
 */
function getSecureRandomInt(max) {
  const range = max + 1;
  const maxRange = 0x100000000; // 2^32
  const limit = maxRange - (maxRange % range);
  const buffer = new Uint32Array(1);

  // 拒绝采样 (Rejection Sampling),彻底消除模运算偏差 (Modulo Bias)
  do {
    crypto.getRandomValues(buffer);
  } while (buffer[0] >= limit);

  return buffer[0] % range;
}
将上述安全整数生成函数直接替换掉前面洗牌步骤中的 Math.floor(Math.random() * (i + 1)),即可零成本升级为高安全等级的无重复随机串生成工具。
五、综合选型与技术总结
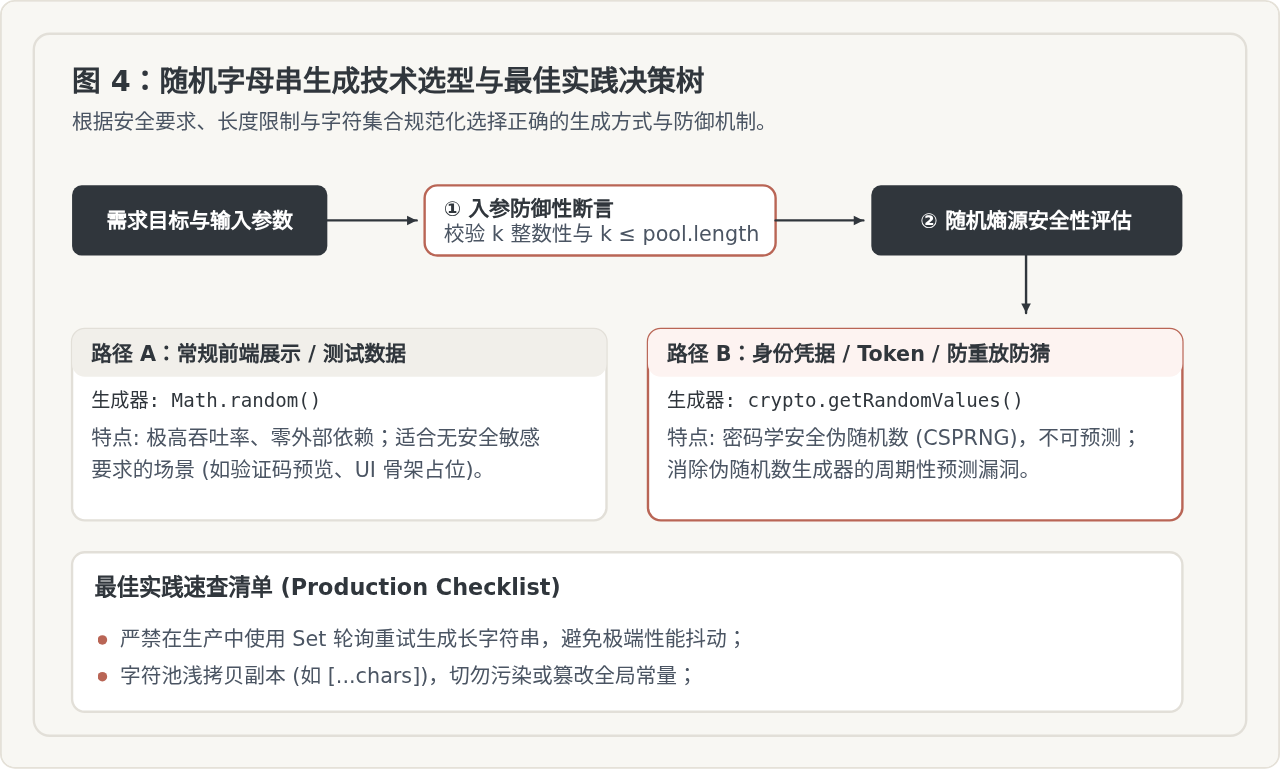
生成不含重复字符的随机字母串看似简单,但要在各类边界和高并发场景下保持稳健,需要遵循以下三条工程准则:
- 算法确定性优先:避免使用
Set或包含indexOf的重试循环。始终优先采用 Fisher-Yates 部分洗牌抽样,将循环步数严格锁定在k步,消除高抽取率场景下的性能骤降风险。 - 严守抽屉原理底线:在函数执行入口强制核对
length <= pool.length。对于超出容量的需求,果断抛出异常,防止无效代码无休止运行。 - 字符池副本隔离:洗牌交换会直接修改数组元素的相对位置。因此,每次调用时务必操作字符串拆分得到的临时副本或浅拷贝,切勿直接就地操作全局共享的字符集数组常量。
Lodash _.isEmpty与原生JS判空对象的区别
2026-11-16 13:19:37
JS数组按值删除元素:indexOf结合splice的正确用法
2026-11-16 13:18:59
怎么使用ES6 Class语法为JavaScript对象定义方法
2026-11-14 12:33:59
Dreamweaver中编写JavaScript alert警告框的代码示例
2026-11-13 23:05:15
js字符串转数组split中文乱码解决
2026-11-13 22:26:25