js字符串转数组split中文乱码解决
深入解析在 JavaScript 中使用 split('') 将包含中文的字符串转为数组时出现乱码的原因,提供基于 Array.from、扩展运算符及 Intl.Segmenter 的完整解决方案与生产环境最佳实践。
str.split('') 将字符串逐字拆分成数组时,若文本中包含生僻汉字(如“𠮷”、“𪚥”)、古籍文献拓展区字符或表情符号,拆分结果会出现字符被截断并渲染为黑色菱形问号 � 的乱码现象。解决该问题的核心做法是改用支持 Unicode 码位感知的现代语法:直接使用 Array.from(str) 或扩展运算符 [...str];对于包含注音变音符的复合中文,推荐使用 Intl.Segmenter。
一、问题复现:为什么常用汉字正常,特定中文却出现乱码?
在平时的前端开发中,很多人习惯通过空字符串 split('') 来将字符串转换为逐字数组。对于常规的一二级常用汉字,这种方式往往不会报错:
// 示例 1:常用汉字拆分(表面看似正常)
const normalText = "你好中国";
const normalArr = normalText.split('');
console.log(normalArr);
// 输出示例:['你', '好', '中', '国']
console.log(normalArr.length); // 4
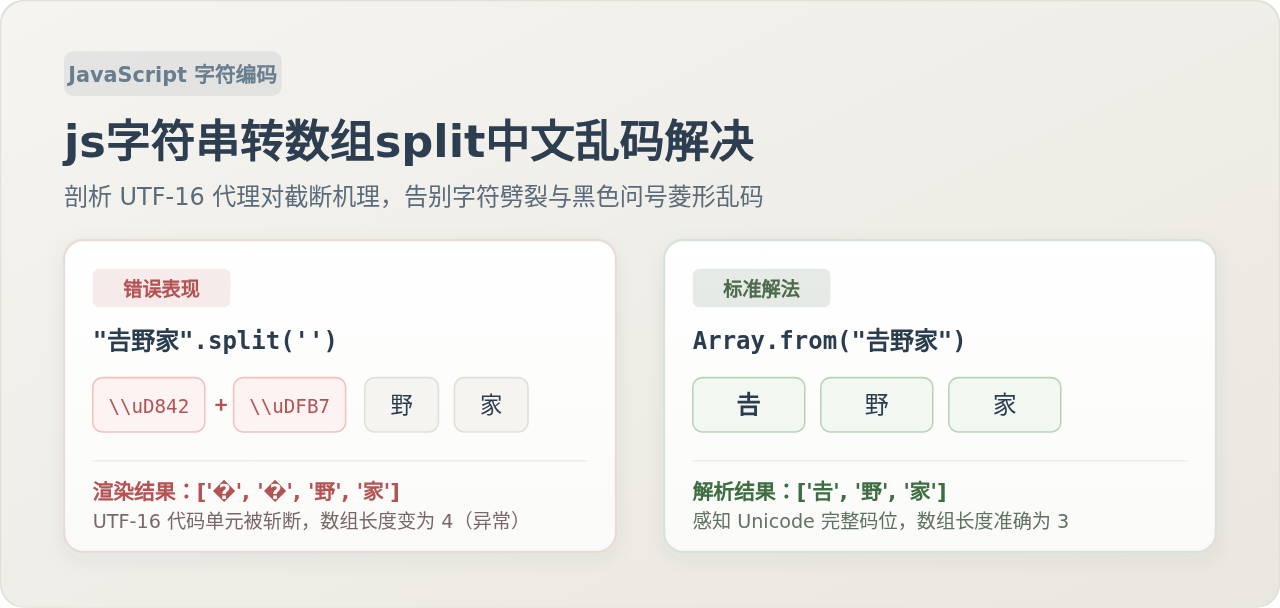
但一旦业务数据中出现人名生僻字、地名特殊汉字(例如“𠮷野家”中的“𠮷”,字码 U+20BB7;或者“𪚥”,字码 U+2A6A5)时,split('') 会瞬间失效:
// 示例 2:包含生僻汉字时的 split 异常表现
const rareText = "𠮷野家";
const brokenArr = rareText.split('');

console.log(brokenArr);
// 示例运行输出:['\\uD842', '\\uDFB7', '野', '家']
// 当将数组元素渲染到 HTML 或控制台时,将显示为:
// ['�', '�', '野', '家']

console.log(brokenArr.length);
// 实际只有 3 个文字,但数组长度却变成了 4!
在上述代码中,原本代表一个完整汉字的“𠮷”,被强行切成了两个毫无意义的孤立项。当浏览器或终端尝试解析单独的 \uD842 时,由于找不到合法的字形映射,只能退化为代表非法字符的“�”。
二、深层根因:UTF-16 代码单元与 Unicode 码位的脱离
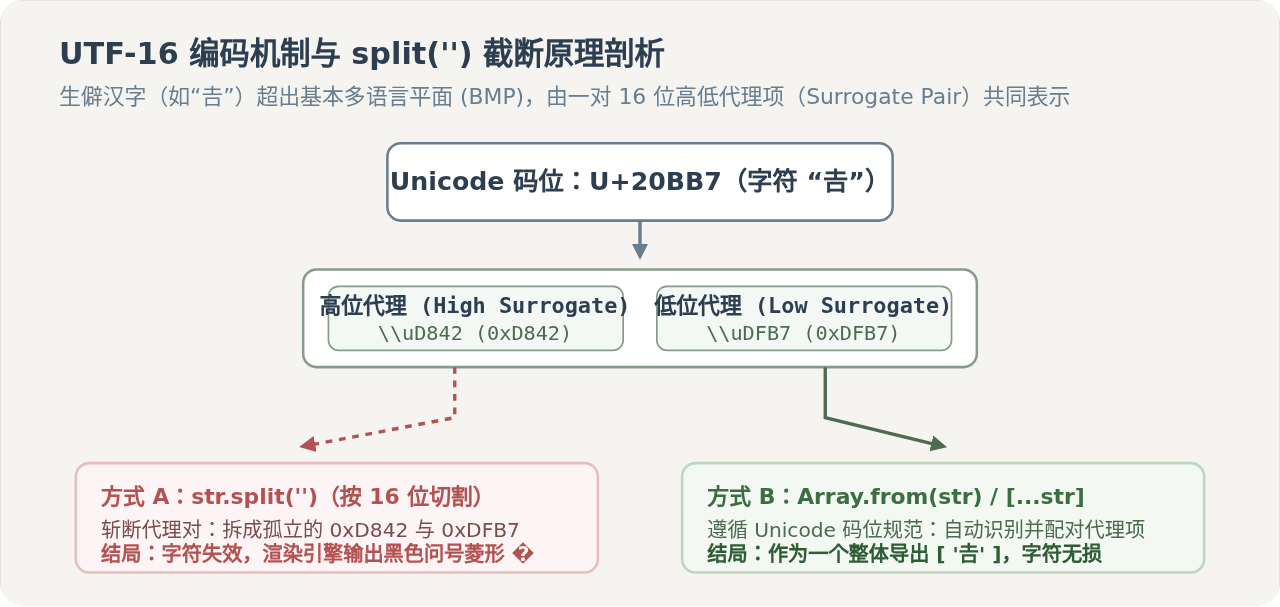
要彻底解决这个乱码问题,必须理解 JavaScript 内部的字符串表示机制。JavaScript 的字符串引擎诞生于上世纪 90 年代,采用了 UTF-16 编码规范:
- 代码单元(Code Unit):JavaScript 中字符串存储的最小物理单元为 16 位(2 字节)。基本的常用字(码位范围在 U+0000 至 U+FFFF 的“基本多语言平面” BMP)刚好占用 1 个代码单元。
- 代理对(Surrogate Pair):随着汉字字符集扩充(如 CJK 扩展区汉字),码位超过了 0xFFFF。为了兼容 16 位体系,Unicode 规定使用两个连续的 16 位单元组合成一个“代理对”——一个高位代理(0xD800–0xDBFF)和一个低位代理(0xDC00–0xDFFF)共同代表一个字。
String.prototype.split('') 的设计早于 ES6,它的底层逻辑是机械地按 16 位代码单元逐个切割。它并不知道两个单元其实绑定属于同一个汉字,就像把一把刀直接切在代理对中间,将其硬生生拆成两截。
三、两种处理方式的关键差异对比
为了更清楚地看清机制差异对实际程序逻辑的影响,我们在一致的环境条件下对两种拆分模式进行横向对比:
// 一致对比环境:Node.js 18+ 或现代浏览器控制台
const input = "汉字𠮷𪚥"; // 包含2个常用汉字与2个扩展示范汉字| 对比维度 | 做法 A:input.split('') |
做法 B:Array.from(input) |
|---|---|---|
| 底层切分粒度 | 16 位 UTF-16 代码单元(物理存储) | Unicode 码位(Code Point,语义字符) |
| 拆分结果数组 | ['汉', '字', '\\uD842', '\\uDFB7', '\\uD869', '\\uDEE5'] |
['汉', '字', '𠮷', '𪚥'] |
| 数组长度 | 6(错误,虚高) | 4(正确,与视觉感知一致) |
| 独立元素渲染 | 产生 � 乱码,页面显示破碎 |
完美正常显示,字形完整 |
| 业务影响 | 若用于截字、分页、计算字数,会导致接口校验失败或数据库乱码 | 保持数据语义纯洁,满足表单验证与数据落库要求 |
很多开发者误以为乱码仅仅是“界面好看不好看”的视觉问题。实际上,如果将截断后的孤立代理项
\uD842 通过 JSON 序列化并发送给后端(如 Java、Go、Python),后端在做 UTF-8 校验或数据库写入时会直接报 Invalid UTF-8 sequence 错误,甚至引发接口崩溃。因此,从源头上保证字符的码位完整性是极为严谨的工程要求。
四、排查与替换解决四步法
如果在现有项目或线上日志中发现了中文截断或乱码问题,可以按照以下规范步骤排查并彻底解决:
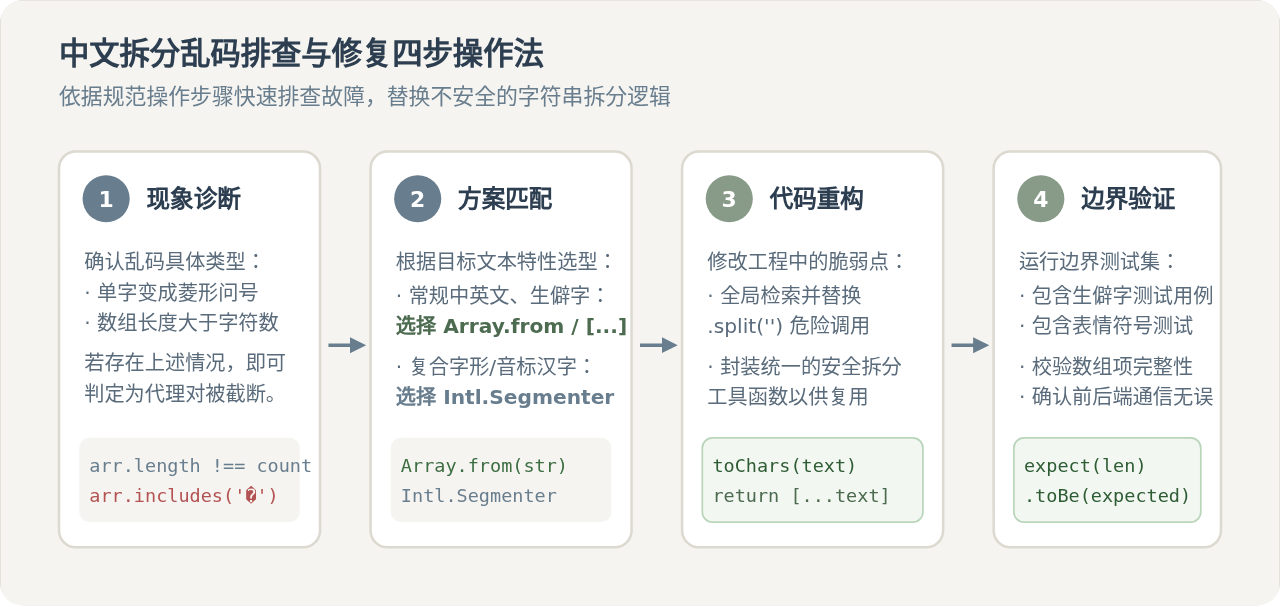
步骤一:现象定位与代理对检测
在接收到用户反馈或处理文本异常时,首先确认是否由于字符截断引起。可以通过检查字符串的 codePointAt() 与 charCodeAt() 是否一致来判断:
// 检查字符串中是否存在辅助平面字符(代理对)
function hasSurrogatePairs(str) {
  for (let i = 0; i < str.length; i++) {
    const code = str.charCodeAt(i);
    // 高位代理范围:0xD800 到 0xDBFF
    if (code >= 0xD800 && code <= 0xDBFF) {
      return true;
    }
  }
  return false;
}

console.log(hasSurrogatePairs("张三"));  // false (纯普通汉字)
console.log(hasSurrogatePairs("张𠮷"));  // true (存在代理对,禁止使用 split(''))
步骤二:使用标准码位语法重构(核心推荐)
在 ES6(ECMAScript 2015)及以上版本中,JavaScript 引入了对 Unicode 码位的原生迭代协议。以下两种写法均可在拆分时自动组合高低代理对,是替代 split('') 的最标准解法:
// 方案 2.1:使用 Array.from()
const text = "𠮷野家";
const arr1 = Array.from(text);
console.log(arr1); // 输出示例:['𠮷', '野', '家']

// 方案 2.2:使用 ES6 扩展运算符(Spread Operator)
const arr2 = [...text];
console.log(arr2); // 输出示例:['𠮷', '野', '家']
步骤三:针对复合字形使用 Intl.Segmenter(高级排版)
在某些特殊中文场景(如汉语拼音带有独立组合声调符、或者汉字与复合标号混合)中,即使是 Unicode 码位也可能会将“基础字母”与“附加声调”拆开。如果需要保证按人类视觉感知的“字形簇”(Grapheme Cluster)进行切分,应选用现代浏览器内置的 Intl.Segmenter:
// 方案 2.3:按人类感知的字形簇分割
const pinyinWithTone = "nǐ hǎo 𠮷"; // 包含变音符组合字符与生僻汉字

const segmenter = new Intl.Segmenter('zh-CN', { granularity: 'grapheme' });
const segments = Array.from(segmenter.segment(pinyinWithTone), s => s.segment);

console.log(segments);
// 输出示例:每个带有声调的字母和生僻字均作为独立完整字形保留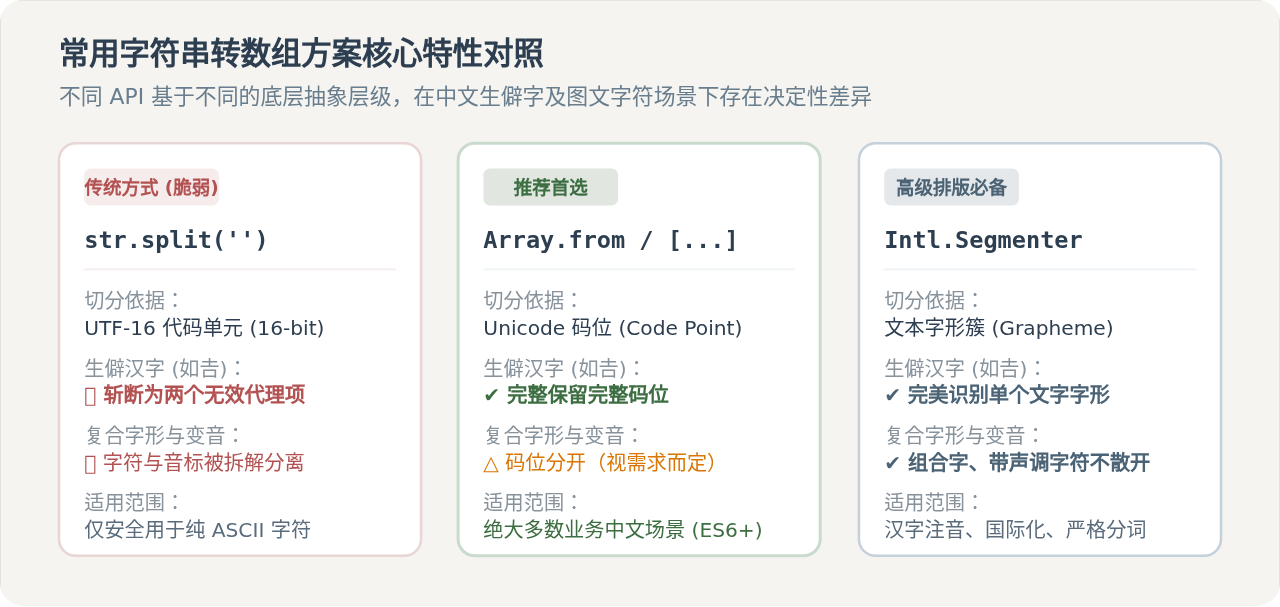
步骤四:边界测试与自动化验证
在完成代码替换后,建议在工程单元测试(如 Jest / Vitest)中添加包含生僻汉字与特殊符号的用例,确保后续维护人员不会误改回 split(''):
// 编写针对中文拆分的边界测试用例
function safeStringToArray(str) {
  if (typeof str !== 'string') return [];
  return [...str];
}

// 验证用例
console.assert(safeStringToArray("𠮷野家").length === 3, "生僻字长度验证失败");
console.assert(safeStringToArray("𠮷野家")[0] === "𠮷", "首字符提取失败");
console.assert(!safeStringToArray("𪚥").includes('\\uD869'), "存在未解析代理项");
console.log("全部边界测试通过!");
五、生产环境注意事项与常见混淆场景
本文所指的乱码问题专指无分隔符的逐字切割
split('')。如果你的字符串是用逗号、竖线等特定分隔符连接的,如 "张三,李四,𠮷野".split(','),这种情况下使用 split(',') 是完全安全的,因为分隔符本身是独立 ASCII 码,不会介入到汉字内部切断代理对。
若从网络分块(Chunk)或二进制数据流中读取中文内容,乱码可能发生在 UTF-8 字节被网络包截断的时候。此时即便用
Array.from() 也无济于事,必须在流接收层使用 new TextDecoder('utf-8', { stream: true }) 维持解码上下文,待拼装出完整字符串后,再进行数组转换。
六、总结与选型决策导图
解决 JavaScript 中字符串转数组中文乱码的关键,在于彻底摒弃基于 16 位代码单元的 split('')。现代 JavaScript 提供了完备的码位与字形级工具链:
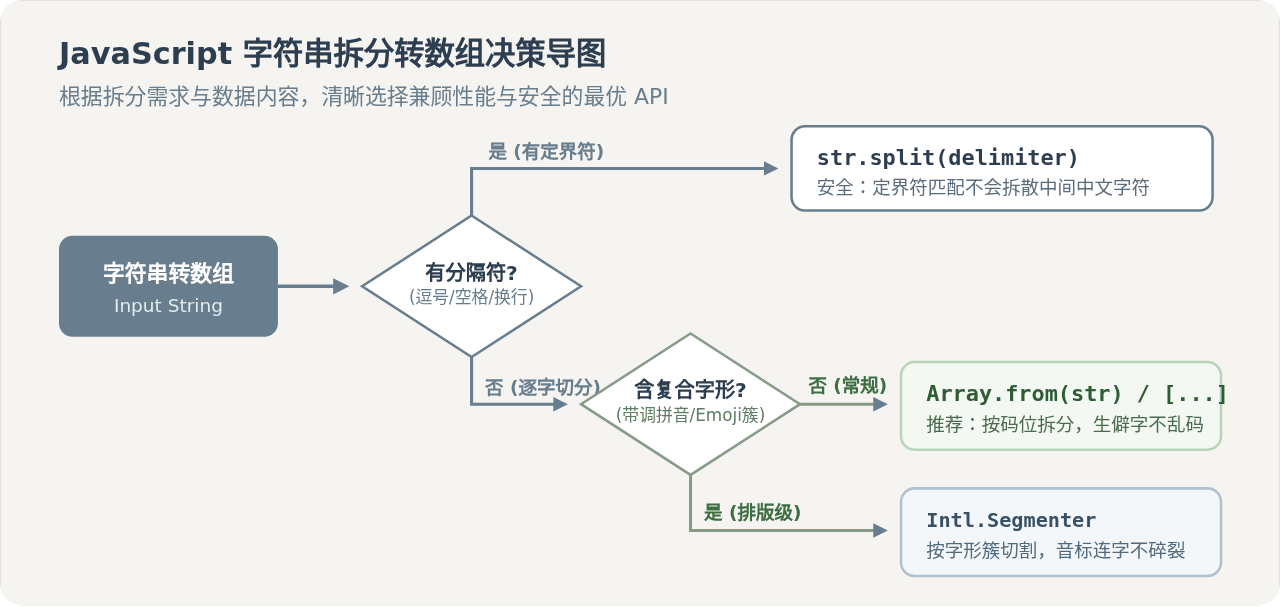
- 日常项目首选:遇到需要将中文逐字拆分成数组的场景,统一使用
[...str]或Array.from(str),兼顾语法简练与生僻字安全。 - 国际化与复合排版:如果业务涉及音标组合、古籍注音或复杂的符号拼接,优先引入
Intl.Segmenter。 - 工程规范:可以在 ESLint 中配置自定义规则,警惕或禁止对可能包含中文的动态变量使用无参数或空串参数的
split('')调用。
JS分页计算中怎么正确使用向下取整
2026-11-13 20:46:25
JS数组删除元素后length为什么不变?
2026-11-13 17:55:03
js字符串转数组过滤非数字NaN
2026-11-13 17:14:11
js字符串逗号分隔怎么转对象数组
2026-11-13 15:58:08
JavaScript怎么获取并显示当前本地时间
2026-11-13 13:27:22