js字符串转数组过滤非数字NaN
深入讲解JavaScript中如何将字符串转换为有效数字数组,避免空字符串转0、parseInt截断与全局isNaN隐式转换陷阱,提供高效健壮的过滤方案。
在 JavaScript 中将包含混合字符的字符串转换为纯数字数组,核心在于三个动作的紧密协同:基于预定分隔符切分字符串、严格剔除首尾空白及空字符串词元(防止空串被强制转换为数字 0),并通过 Number() 转换为数值后利用严格的 !Number.isNaN() 剔除无效的 NaN。常规实现可通过链式操作 split().map().filter().map().filter() 优雅完成;针对大数据量或高频处理场景,则可借助 flatMap 在单次遍历中兼顾转换与过滤。本文将深入剖析完整转换流水线、核心函数的边界行为、三大隐式转换陷阱与高性能工程选型。
一、标准处理流水线与分步实现
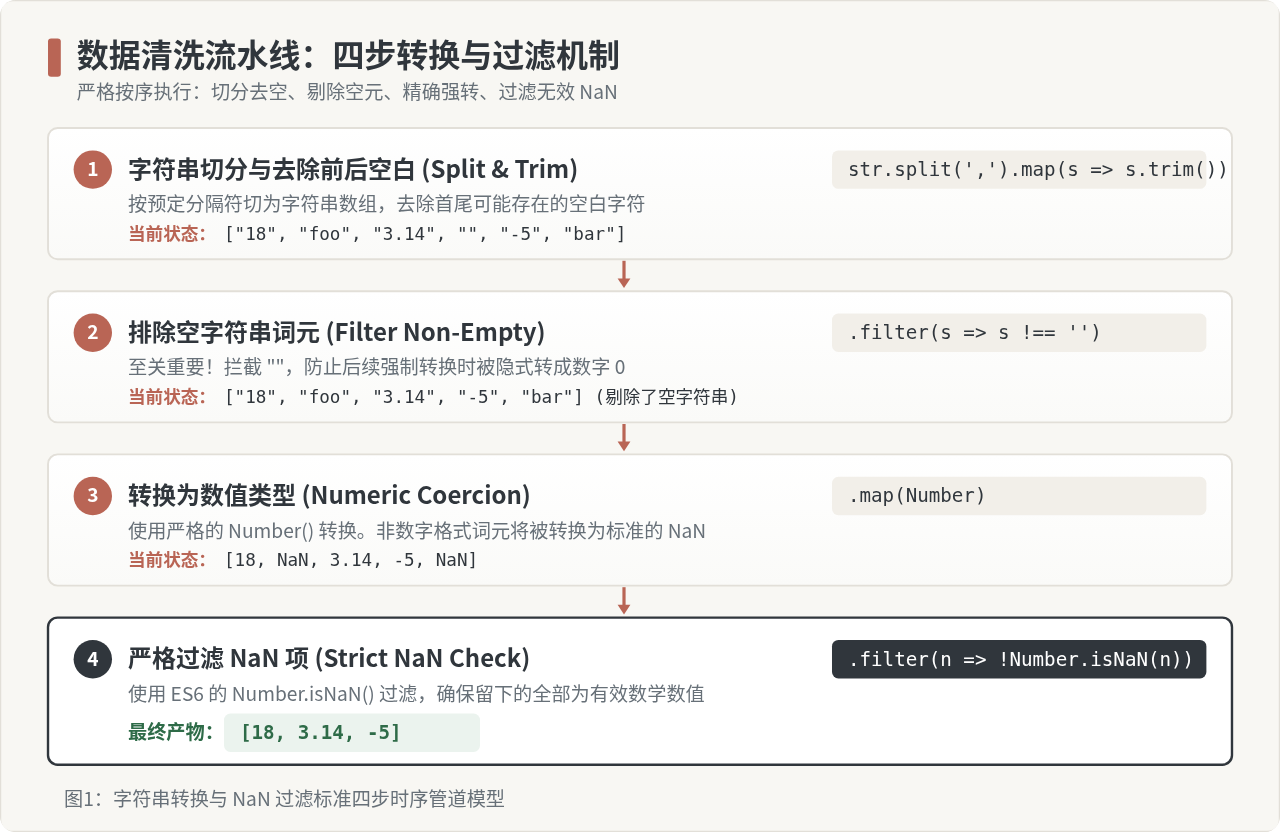
处理字符串输入时,最容易出现的问题是脏数据混杂,例如多余的空格、连续的分隔符、英文字母甚至空内容。一个健壮的清洗流程必须按部就班地完成数据形态的蜕变。
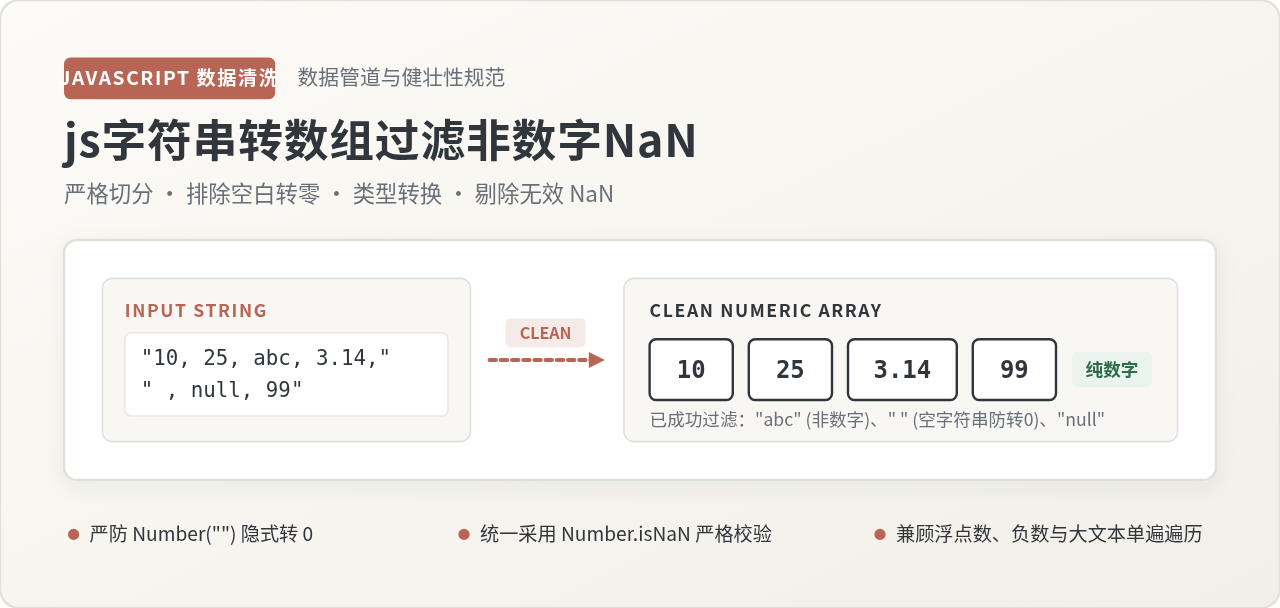
以下是经过生产环境检验的标准处理代码。假设我们接收到一个形如 " 10, 25, abc, 3.14, , -5, null, 99 " 的原始输入:
// 原始混合字符串
const rawInput = " 10, 25, abc, 3.14, , -5, null, 99 ";

// 标准五步链式过滤管道
const cleanNumbers = rawInput
  .split(',')                     // 1. 按逗号切分为字符串数组
  .map(item => item.trim())       // 2. 消除每个词元首尾多余的空格
  .filter(item => item !== '')    // 3. 严格排除空字符串词元(防转 0 关键)
  .map(Number)                    // 4. 强制转换为数值类型,非法项产生 NaN
  .filter(num => !Number.isNaN(num)); // 5. 严格过滤 NaN,保留有效纯数字

console.log(cleanNumbers);[10, 25, 3.14, -5, 99]
这一段代码表面上只是简单的函数组合,但其中每一个环节都具有明确的技术目的:
- 步骤 1:
split(',')—— 按照逗号将整个字符串切成由原始词元构成的数组。此时,连续逗号之间或末尾逗号会生成包含空字符串或空格的元素。 - 步骤 2:
map(item => item.trim())—— 统一清洗首尾的空格、换行符或制表符,把" 10 "规范化为"10",把纯空白" "还原为""。 - 步骤 3:
filter(item => item !== '')—— 这一步绝不能省略。JavaScript 的类型转换规范中,Number("")的结果是0。如果跳过此步,原始数据中缺失的位置就会被虚假地填充为数字0。 - 步骤 4:
map(Number)—— 将规范化的字符串转为数字。合法整数、负数、浮点数均能被正确转换;而"abc"、"null"等非纯数字字符会被转为标准的NaN。 - 步骤 5:
filter(num => !Number.isNaN(num))—— 调用 ES6 的Number.isNaN()剔除所有无效数值,确保数组中只留存合法的 JavaScript 浮点数与整数。
二、数值转换函数的选用与行为边界
JavaScript 提供了多个将字符串转为数值的内置函数,但在面对非数字字符和空输入时,它们的解析策略存在本质差异。选错转换方法是导致数据污染的最常见原因。
1. Number(value) 与一元加号 +value(整词严格校验)
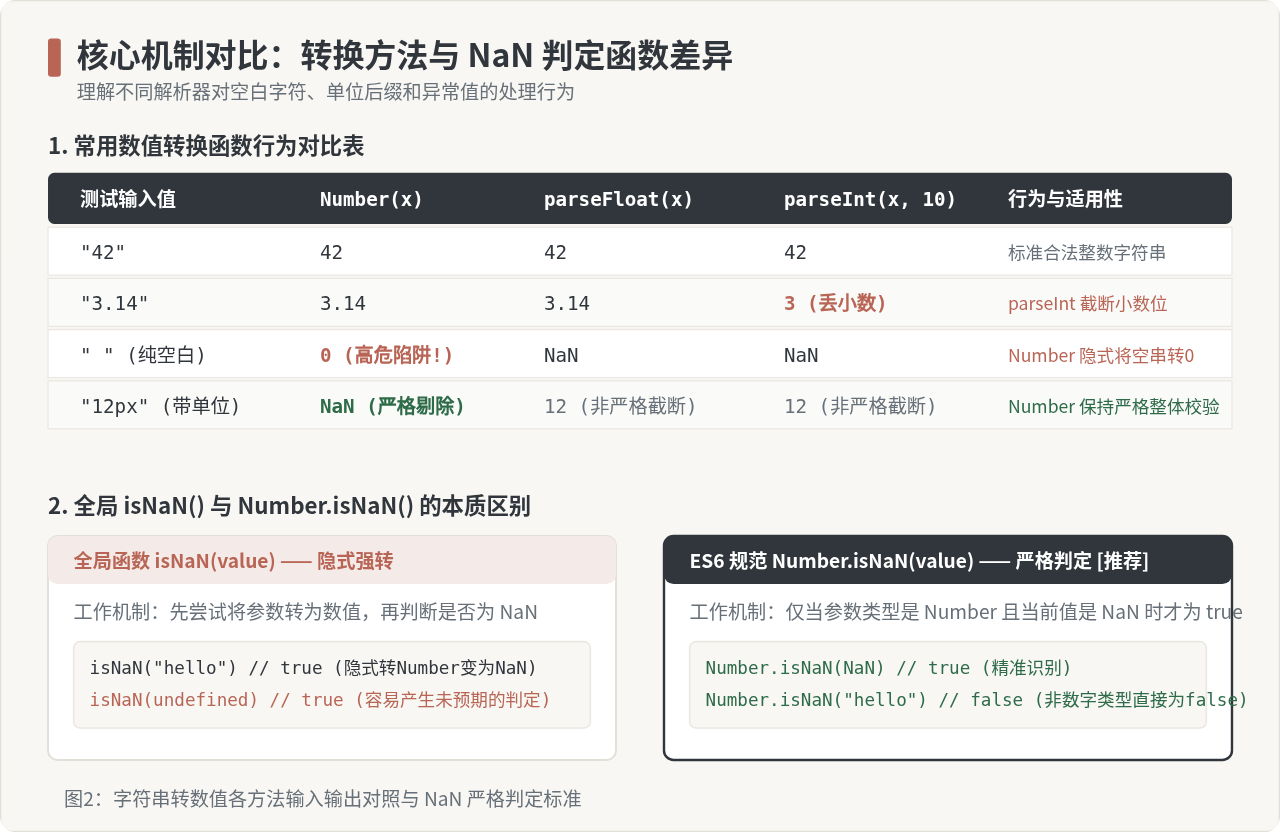
Number() 属于整词严格转换器。只有当整个字符串能够完整解释为一个合法的数字字面量时,它才会返回数值;只要字符串中存在任何非空白的非法字符(如 "10px"、"3a"),它都会立即返回 NaN。这种“非纯即弃”的特性,使其成为过滤非数字场景下的最佳搭档。但必须牢记:Number("") === 0、Number(null) === 0,因此它高度依赖前置的非空过滤。
2. parseFloat(value)(宽松前缀解析)
parseFloat() 采用从左到右的前缀扫描策略。一旦遇到无法识别的非数字字符,它不会报错也不会返回 NaN,而是截断并返回前面已经解析成功的部分。例如:
// parseFloat 的前缀截断特性
parseFloat("100px"); // 输出 100,单位被丢弃但未标记为无效
parseFloat("3.14.15"); // 输出 3.14,第二个小数点及其后续被丢弃
parseFloat(""); // 输出 NaN(这是它与 Number 的一个显著区别)在样式表解析等需要宽容剔除单位的场景中,parseFloat 很有用;但在严格的数据清洗任务中,"100px" 往往属于非法脏数据,若使用 parseFloat 就会让脏数据悄然变成合法数字 100 混入业务流程。
3. parseInt(value, 10)(整数截断解析)
parseInt() 不仅具备前缀截断行为,而且会直接丢弃小数部分(例如 parseInt("3.14", 10) === 3)。除非业务明确要求只提取整型并向下取整,否则绝不能在通用的数值清洗流程中使用 parseInt。
三、NaN 判定机制与三大隐式陷阱
在对数组执行过滤时,关于 NaN 的判断同样潜藏着严重的类型陷阱。如果不理解其底层判定机制,极易编写出看似通过测试却暗藏漏洞的代码。
1. 全局 isNaN() 与 Number.isNaN() 的区别
早期 JavaScript 提供的全局 isNaN(value) 函数,会在内部先执行强制类型转换 Number(value),然后再判断结果是否为 NaN。这意味着:
// 全局 isNaN 的隐式强转问题
isNaN("hello");      // true (因为 Number("hello") 是 NaN)
isNaN(undefined);    // true (因为 Number(undefined) 是 NaN)
isNaN({});           // true (因为 Number({}) 是 NaN)
isNaN("");           // false (因为 Number("") 是 0,0 不是 NaN!)
isNaN(null);         // false (因为 Number(null) 是 0,0 不是 NaN!)
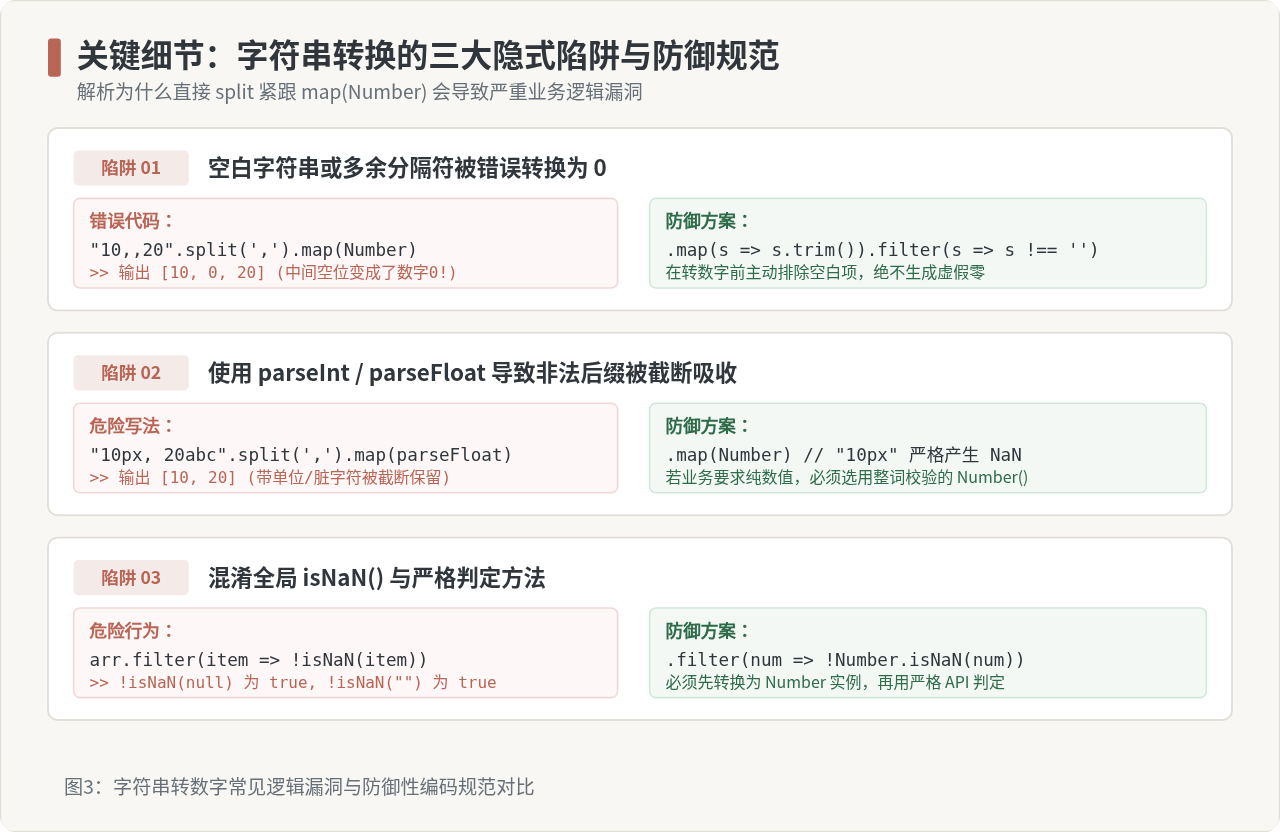
如果直接在未转换的原数据上使用 !isNaN(item),由于 !isNaN("") 和 !isNaN(null) 均为 true,空值将被作为合法数字保留。而 ES6 规范引入的 Number.isNaN(value) 是严格判定:只有当传入值的 typeof 恰好是 'number',且其值等同于 NaN 时,才会返回 true。因此,永远推荐在完成 Number() 转换后,使用 !Number.isNaN(num) 进行校验。
2. 三大典型隐式陷阱与防御方案
表现:"10,,20".split(',').map(Number) 产出的结果是 [10, 0, 20]。中间原本表示缺失的数据变成了数字 0。
防御:在调用 map(Number) 之前,必须执行 .map(s => s.trim()).filter(s => s !== '') 彻底清理空字符串。
表现:"12px, 34rem".split(',').map(parseFloat) 输出 [12, 34]。
防御:如果业务规定带字母的标记属于非法输入,必须统一使用 Number()。Number("12px") 将精确输出 NaN,从而被后续过滤器顺利拦截。
表现:先执行 filter(s => !Number.isNaN(s)) 再执行 map(Number)。由于原数组中的 s 是字符串类型,Number.isNaN("abc") 直接返回 false,取反后变为 true,导致 "abc" 毫发无损地通过了过滤,随后在 map(Number) 阶段才变成 NaN。
防御:牢记时序法则:必须先执行 map(Number) 将类型转为数字,再执行 filter(n => !Number.isNaN(n))。
四、进阶实现与高性能场景优化
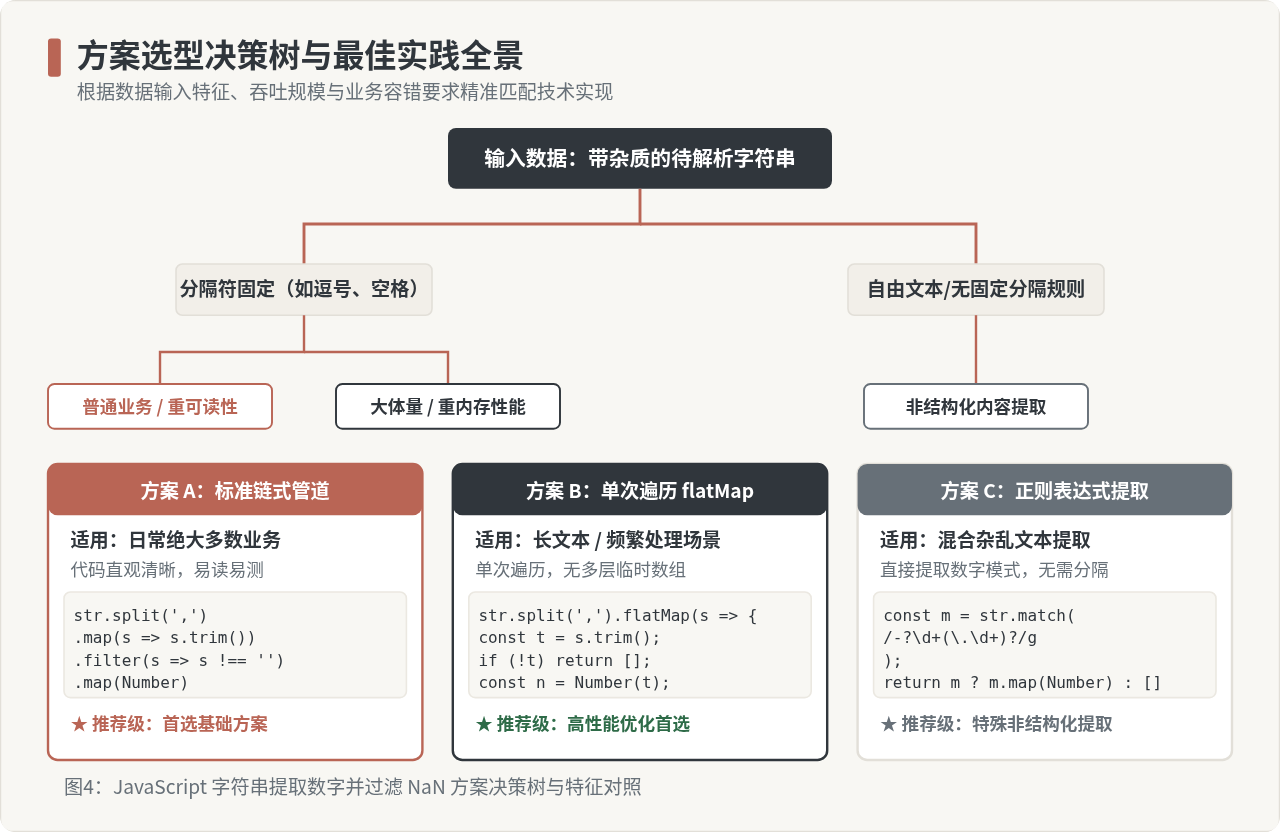
经典链式操作逻辑严密、可读性极佳,是日常业务开发的首选。但在面对大规模数据(如数万行日志字符串)或高频触发的清洗任务时,链式调用会创建多个中间数组,增加垃圾回收(GC)开销。针对不同业务诉求,我们可以采用以下进阶方案。
1. flatMap 单次遍历方案(内存与性能兼顾)
ES2019 引入的 Array.prototype.flatMap() 允许我们在单次迭代中同时完成映射与过滤:当遇到有效数字时返回 [num],遇到空串或 NaN 时返回空数组 []。空数组在扁平化时会被自动剔除,无需生成任何多余的中间过渡数组。
/**
 * 基于 flatMap 实现的单遍扫描转换与过滤
 * @param {string} str 待解析字符串
 * @param {string} delimiter 分隔符,默认为逗号
 * @returns {number[]} 纯有效数字数组
 */
function parseCleanNumbersFlatMap(str, delimiter = ',') {
  if (typeof str !== 'string' || !str.trim()) return [];

  return str.split(delimiter).flatMap(token => {
    const trimmed = token.trim();
    // 拦截空字符串
    if (trimmed === '') return [];

    const num = Number(trimmed);
    // 拦截非数字 NaN
    return Number.isNaN(num) ? [] : [num];
  });
}

const sampleText = "42, invalid, -15.8, , 0, abc99, 1024";
const cleanList = parseCleanNumbersFlatMap(sampleText);
console.log(cleanList);[42, -15.8, 0, 1024]
2. 正则表达式直接匹配(非结构化或杂乱文本)
如果输入的文本并没有规整的分隔符(例如既有中文逗号、英文逗号,又有空格或随意混杂的文字描述),按照固定符号切分就会极其脆弱。此时,直接利用正则表达式匹配所有符合数字特征的子串是更为直接的解法:
/**
 * 基于正则表达式从自由文本中提取有效数字
 * @param {string} text 包含数字与混杂字符的文本
 * @returns {number[]} 提取出的有效数字数组
 */
function extractNumbersByRegex(text) {
  if (typeof text !== 'string') return [];

  // 匹配可选负号、整数部分以及可选的小数部分
  const matches = text.match(/-?\d+(?:\.\d+)?/g);
  return matches ? matches.map(Number) : [];
}

const rawLog = "服务器监测:核心1负载 -2.5%,节点3异常重试 4 次,延迟 88.6ms,无响应 0。";
const metricNumbers = extractNumbersByRegex(rawLog);
console.log(metricNumbers);[-2.5, 3, 4, 88.6, 0]
注意边界:正则表达式提取适用于从非结构化文本中抽离纯数据;但如果输入的数字包含科学计数法(例如 1.5e3)或十六进制(如 0xFF),正则表达式需要相应扩充为 /-?\d+(?:\.\d+)?(?:[eE][+-]?\d+)?/g 才能完整识别。
五、方案选型与工程实践总结
在面对不同的输入规模和架构要求时,建议依据以下决策矩阵选择最合适的技术实现:
| 方案类型 | 核心代码形态 | 内存开销 | 可读性与维护性 | 典型适用场景 |
|---|---|---|---|---|
| 标准链式管道 | split().map(trim).filter.map(Number).filter |
中(生成中间数组) | 极高(语义清晰、逻辑直观) | 绝大多数常规业务需求、表单参数清洗 |
| 单遍 flatMap 方案 | split().flatMap(...) |
低(单次遍历,无多层数组) | 高(逻辑内聚于单处回调) | 大数据量切分、高频调用函数、注重内存开销 |
| 正则提取方案 | text.match(/-?\d+(\.\d+)?/g).map(Number) |
低(直接捕获目标) | 中(依赖正则的可维护性) | 无固定分隔符的自由文本、混合日志信息提取 |
归纳而言,要在 JavaScript 中稳健地将字符串转化为数字数组并排除 NaN,请在工程中牢记以下四项实践公理:
- 防御空串转零:绝不能直接对
split之后的结果执行Number(),必须先行清除首尾空格并剔除空字符串。 - 严格整词校验:对于严谨的纯数值业务,坚持使用
Number()替代parseFloat(),防范字母后缀被静默截断。 - 使用现代严格 API:永远使用
!Number.isNaN(val)作为最终过滤器,彻底规避全局isNaN()带来的隐式强制转换副作用。 - 按需升级性能:在常规场景下享受链式流水线的高可读性,在海量数据清洗时无缝平替为
flatMap单遍扫描。
js字符串逗号分隔怎么转对象数组
2026-11-13 15:58:08
JavaScript怎么获取并显示当前本地时间
2026-11-13 13:27:22
JS实现指定小数位精确四舍五入的通用函数
2026-11-13 12:28:30
JS对象数组按指定属性转为逗号分隔字符串
2026-11-13 11:15:00
JavaScript怎么封装支持自定义模板的当前时间格式化函数
2026-11-12 21:18:07