前端 JS 导出大量数据到 Excel 卡顿怎么办?性能优化策略
针对前端 JavaScript 导出大量数据到 Excel 时常见的页面卡顿、无响应和内存溢出问题,深入剖析核心瓶颈,提供从格式权衡、Web Worker 多线程计算、时间切片调度到流式保存与内存回收的全流程性能优化实战方案。
一、为什么前端导出会卡死?核心性能瓶颈剖析
很多开发者在实现导出功能时,最直接的做法是通过三方库(如 SheetJS 的 xlsx 库)直接读取内存中的全部对象数组,调用 XLSX.utils.json_to_sheet 生成工作表,再调用 XLSX.write 输出二进制文件。这种写法在处理几百或几千条数据时顺畅无阻,但当数据量达到三万、五万甚至十几万条时,瓶颈就会集中爆发:
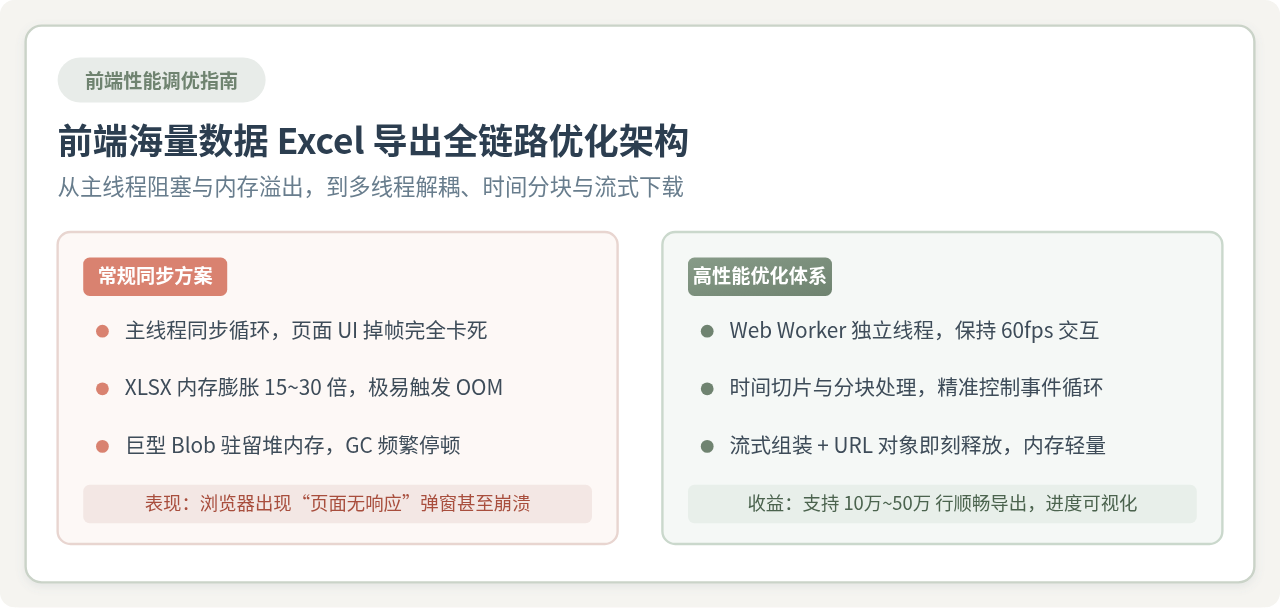
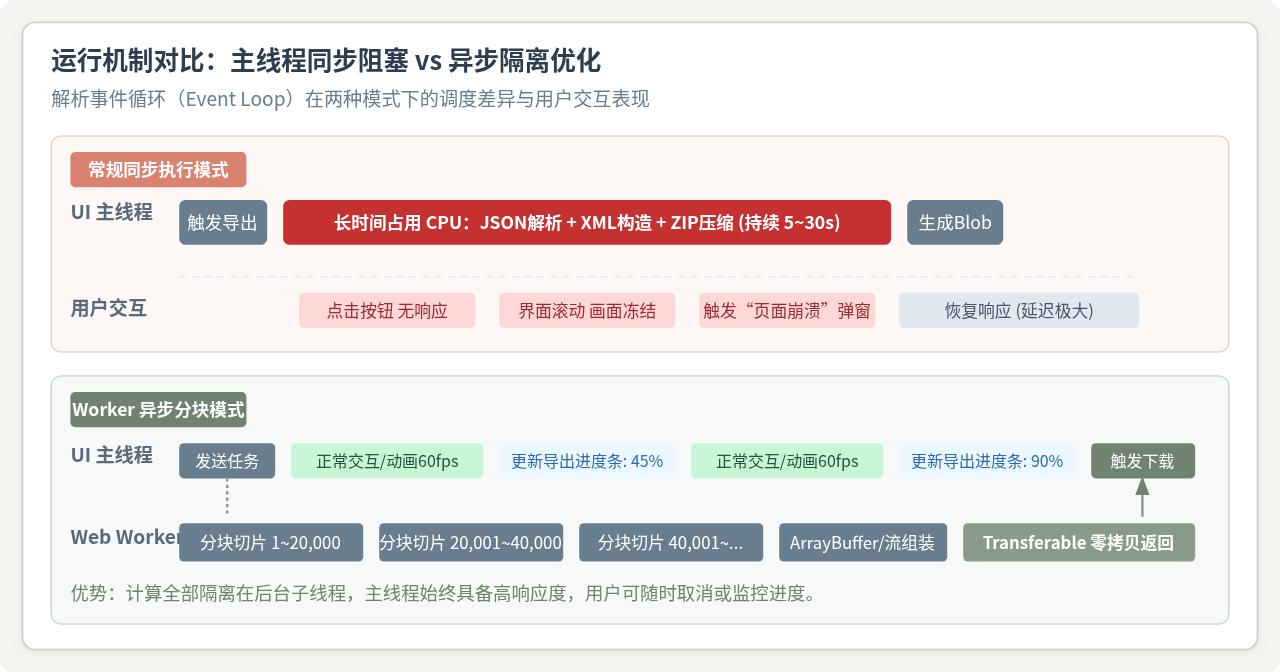
- 堆内存膨胀(Object Memory Bloat):原始的 JSON 数组每个对象可能只占几百字节,但解析为 XLSX 虚拟 DOM 树模型后,每一个单元格都会生成包含类型、样式、格式符、公式等多属性的 JS 对象。在 V8 引擎中,10 万行 20 列的表格可能瞬间产生 200 万个微型对象,内存占用由原本的数十兆飙升至 1GB 以上,极易触碰 32 位系统进程上限或触发 V8 的垃圾回收(GC)长暂停。
- 主线程 CPU 密集计算(Event Loop Block):Excel(.xlsx)本质上是一个按照 OpenXML 标准由多个 XML 文件打包而成的 ZIP 压缩包。拼接几十万个 XML 节点、计算压缩算法(DEFLATE/CRC32)需要消耗极其庞大的 CPU 算力。由于这些计算默认运行在 UI 主线程,导致事件循环无法响应用户的点击、滚动及动画渲染,浏览器因此判定该页面无响应。
- DOM 转换灾难:部分旧项目依赖隐藏的
<table>标签并通过table_to_book导出,在内存中动态插入数万个 DOM 节点会引发大规模的重排(Reflow)与重绘(Repaint),直接让页面卡死在 DOM 操作阶段。
二、关键权衡:CSV 与 XLSX 的格式选型对比
在面对大量数据导出时,很多开发者默认要求输出 .xlsx 格式。然而,选择何种文件载体是决定性能能否提升十倍甚至百倍的首要分水岭。我们必须在格式丰富度与处理能耗之间建立清晰的判断标准:
| 对比维度 | CSV 格式(逗号分隔值文本) | XLSX 格式(OpenXML 压缩包) |
|---|---|---|
| 底层原理 | 纯文本流,以逗号分隔列,换行符分隔行。不包含任何样式与压缩层。 | 基于 ZIP 打包的复合文件,内含多个 XML 工作表定义、共享字符池(sharedStrings.xml)。 |
| 前端计算开销 | 极小:仅需纯字符串拼接,无需复杂算法,CPU 耗时微秒级。 | 极大:需解析单元格模型、去重字符池、运行 DEFLATE 压缩算法,重度依赖 CPU。 |
| 内存占用 | 极低:支持按行、按块写入并直接转化为 UTF-8 TypedArray,内存可控。 | 高(15~30倍):每个单元格均需内存对象维护,极易导致堆溢出。 |
| 功能限制 | 不支持多 Sheet、单元格高亮、公式、合并单元格。大数字(如身份证)需额外转义。 | 完整支持多 Sheet、列宽、单元格背景色、公式、冻结窗格等。 |
| 适用数据量级 | 十万至百万级纯数据表格(推荐作为海量数据首选)。 | 三万行以内包含特定样式要求的数据导出。 |
为什么这个差异如此关键?因为无论 JS 引擎如何优化,XLSX 格式的构造复杂度是固有存在的。若业务场景仅需要导出报表供业务人员查看、筛选和统计,优先提供 .csv 格式(Excel 双击即可默认直接打开)可以直接从根源上规避 90% 的性能与内存问题。只有当业务硬性要求导出多张工作表(Worksheet)或带有固定配色表头时,我们才必须启用针对 XLSX 的深度优化方案。
三、核心性能优化策略与落地实现
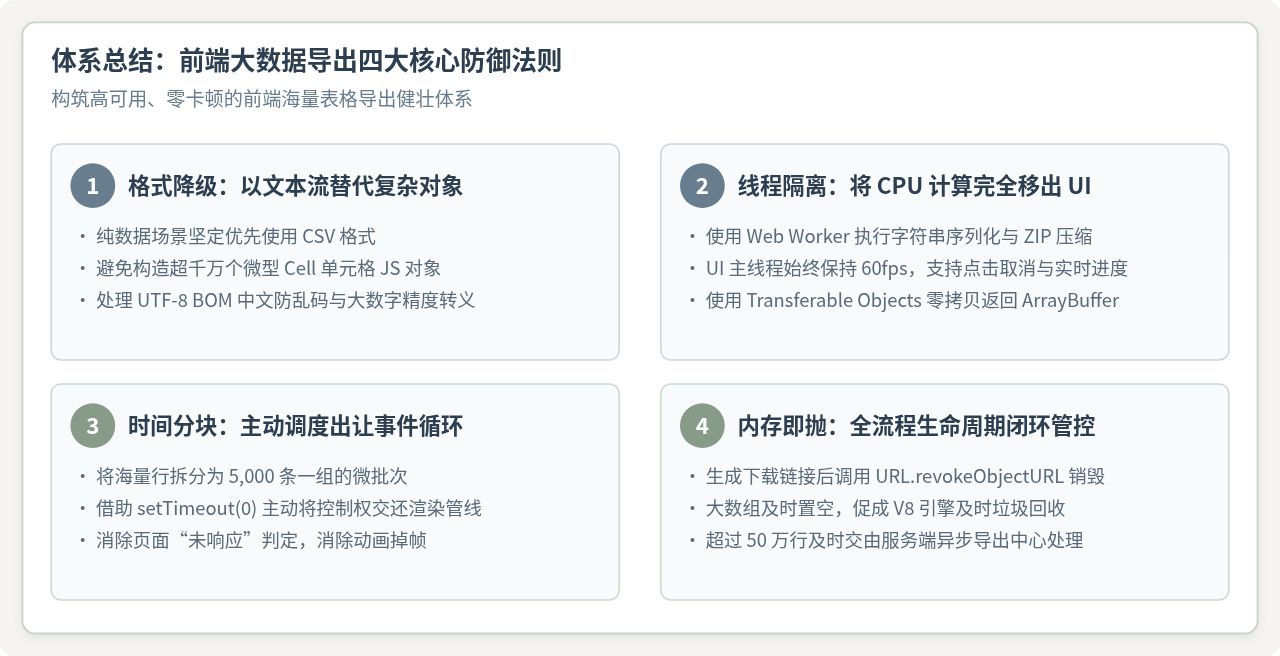
针对前端导出卡顿,业界验证有效的优化策略可以归纳为三步:计算线程隔离(Web Worker)、时间切片分块(Chunking Scheduling)以及流式组装与即刻内存释放。
策略一:使用 Web Worker 隔离序列化与压缩计算
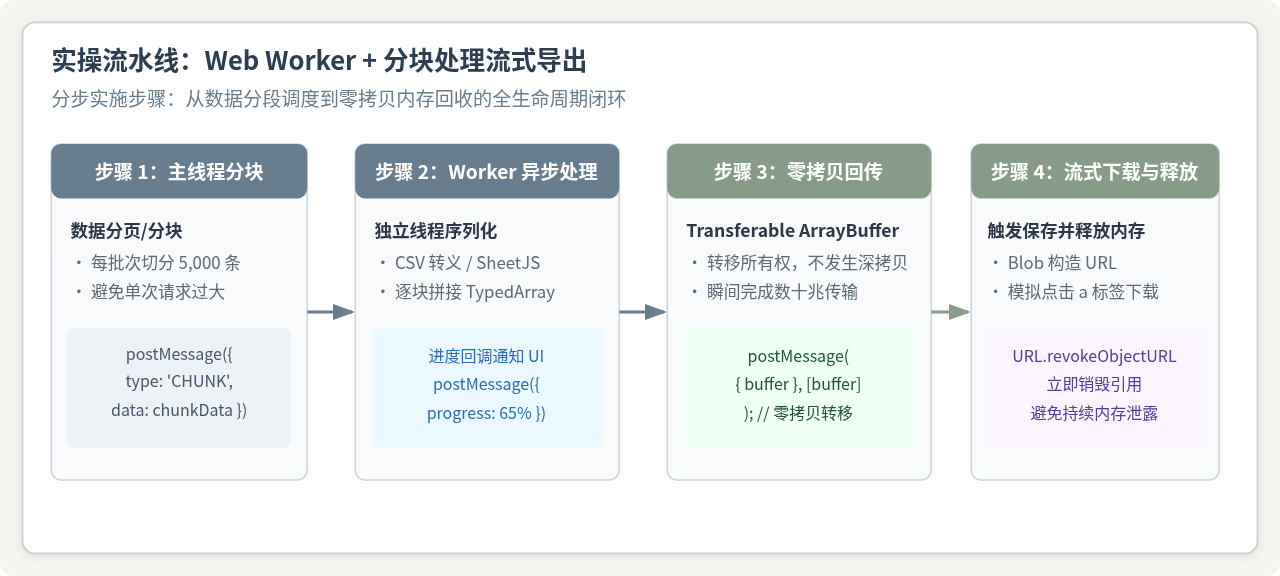
为了让主线程在导出过程中保持 60fps 的流畅度,最彻底的方法是把整个转换逻辑放入独立的 Web Worker 线程中。主线程只负责获取数据,将数据交给 Worker,Worker 完成字符串拼接或 Excel 压缩后,以 Transferable Objects(零拷贝)将二进制 ArrayBuffer 返回给主线程,主线程直接通过 URL.createObjectURL 触发浏览器的原生下载。
策略二:主线程时间切片(Chunking & requestAnimationFrame)
如果项目由于构建环境限制(例如无法方便地拆分单独的 worker.js 文件)必须在主线程中处理,绝不能直接写一个从 0 遍历到 100,000 的纯同步 for 循环。我们可以利用时间切片思想(Time Slicing),将 10 万行拆分成若干批次(例如每批 5,000 行),处理完一批后,通过 setTimeout(fn, 0) 或 requestAnimationFrame 将执行权主动交还给浏览器的渲染管道和事件循环,让页面能够顺畅重绘进度条,然后再执行下一批。
策略三:规避内存泄露与大对象常驻
在导出海量数据时,另一个容易忽视的内存陷阱是 Blob 对象的生命周期。当使用 URL.createObjectURL(blob) 生成下载链接时,浏览器会在内部保持对该 Blob 对象的强引用映射,哪怕变量已经置为 null,只要当前页面不关闭且未显式调用销毁方法,这段内存就不会被垃圾回收!
click() 事件后,务必通过 setTimeout(() => URL.revokeObjectURL(url), 1000) 或在下载完成后立即显式注销该 URL。对于 50MB 以上的大型导出文件,未注销的 Blob URL 会直接导致标签页内存一直居高不下。
四、实战方案:高性能 CSV 导出完整实现
以下给出一个生产环境经过充分验证的完整实现范例。该方案采用分块处理 + 中文防乱码 BOM 头 + 单元格安全转义(防止公式注入及长数字截断),在不引入重型第三方库的前提下,能够以极快的速度完成数十万行数据的流畅导出:
/**
 * 高性能分块 CSV 导出函数
 * @param {Array<Object>} columns 列配置 [{ header: '姓名', key: 'name' }]
 * @param {Array<Object>} dataSource 数据源
 * @param {string} fileName 导出文件名
 * @param {Function} onProgress 进度回调 (0-100)
 */
async function exportLargeCSV({ columns, dataSource, fileName = 'export.csv', onProgress }) {
  const CHUNK_SIZE = 5000; // 每批切片大小
  const totalRows = dataSource.length;
  const chunks = [];

  // 1. 添加 UTF-8 BOM 头,确保 Excel 打开中文不出现乱码
  chunks.push(new Uint8Array([0xEF, 0xBB, 0xBF]));

  // 2. 构建 CSV 表头行
  const headerLine = columns.map(col => formatCSVCell(col.header)).join(',') + '\r\n';
  chunks.push(new TextEncoder().encode(headerLine));

  // 3. 辅助函数:CSV 字段格式化与安全转义
  function formatCSVCell(val) {
    if (val === null || val === undefined) return '""';
    let str = String(val);

    // 针对身份证号、银行卡号等长数字,前置制表符以防 Excel 科学计数法精度丢失
    if (/^\d{12,}$/.test(str)) {
      str = '\t' + str;
    }

    // 处理包含逗号、双引号、换行符的字段,按 RFC4180 标准转义双引号
    if (str.includes('"') || str.includes(',') || str.includes('\n') || str.includes('\r')) {
      return '"' + str.replace(/"/g, '""') + '"';
    }
    return '"' + str + '"';
  }

  // 4. 分块迭代处理数据,释放主线程事件循环
  const encoder = new TextEncoder();
  let currentIndex = 0;

  while (currentIndex < totalRows) {
    const end = Math.min(currentIndex + CHUNK_SIZE, totalRows);
    let chunkString = '';

    for (let i = currentIndex; i < end; i++) {
      const row = dataSource[i];
      const rowString = columns.map(col => formatCSVCell(row[col.key])).join(',');
      chunkString += rowString + '\r\n';
    }

    // 转换为 Uint8Array 推入块列表
    chunks.push(encoder.encode(chunkString));
    currentIndex = end;

    // 触发进度回调并出让执行权给渲染线程
    if (onProgress) {
      onProgress(Math.round((currentIndex / totalRows) * 100));
    }

    // 关键点:交出事件循环控制权,允许浏览器重绘 UI 与响应用户操作
    await new Promise(resolve => setTimeout(resolve, 0));
  }

  // 5. 组合 Blob 并触发原生下载
  const blob = new Blob(chunks, { type: 'text/csv;charset=utf-8;' });
  const downloadUrl = URL.createObjectURL(blob);
  const anchor = document.createElement('a');
  anchor.href = downloadUrl;
  anchor.download = fileName;
  document.body.appendChild(anchor);
  anchor.click();
  document.body.removeChild(anchor);

  // 6. 立即释放 Blob URL 占用的堆内存
  setTimeout(() => {
    URL.revokeObjectURL(downloadUrl);
  }, 1000);
}
实操关键细节解析
- UTF-8 BOM 头(
0xEF, 0xBB, 0xBF):微软 Excel 默认使用系统编码(如 Windows 中文系统的 GBK)打开纯文本文件。如果不显式写入 BOM 字节序列,导出的中文文本在 Excel 中打开必定显示为乱码。 - 长数字科学计数法问题:身份证号、订单号(超过 11 位)直接导出到 Excel 会被自动识别为数值,导致最后几位变成
0000。在字段值前加上 - TextEncoder 逐块转二进制:将拼接好的大字符串按批次转为
Uint8Array,避免把全部数十万行数据长期保存在一个数百万长度的庞大单一 String 变量中,方便垃圾回收机制及时回收已处理完的切片。
五、多量级场景下的技术决策矩阵
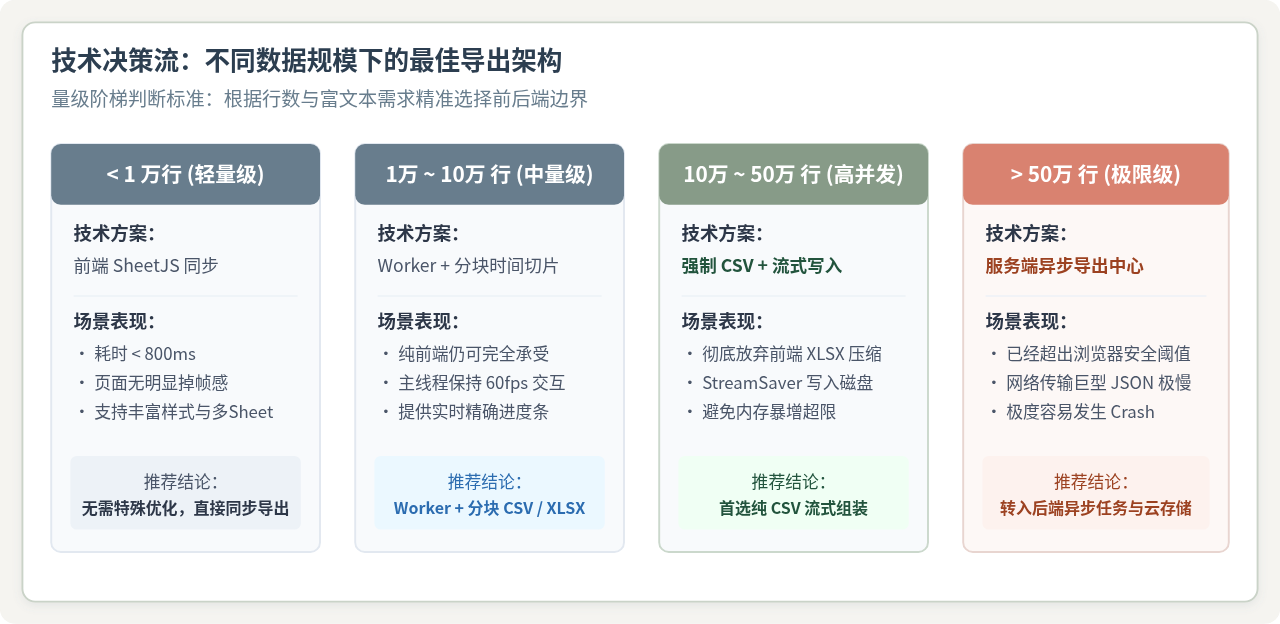
在实际企业级系统开发中,并没有放之四海皆准的“单点最优解”,而是需要根据数据量级和格式需求选择最合适的平衡点:
六、边界识别与何时坚决放弃前端导出
性能优化有其物理边界。虽然借助 Web Worker 和分块切片能够极大延缓页面假死,但如果遇到以下任一限制条件,应果断停止纯前端实现,重构为“服务端异步生成 + 对象存储(OSS/S3)下载”方案:
- 数据量突破 50 万~100 万行物理上限:即使前端能够完成转码,仅从接口拉取 50 万条原始 JSON 数据本身就需要耗费数百兆网络流量,弱网环境下用户通常要在界面等待数分钟,甚至接口直接发生超时断开。
- 内存上限限制:64 位 Chromium 浏览器每个标签页的默认最大堆内存限制在 2GB~4GB,且移动端 WebView 内存限制更为严苛(通常在几百兆以内)。多任务或低配设备极易在内存分配失败时直接触发白屏与闪退。
- 格式依赖高度复杂:如果导出的报表要求包含几十种不同的字体颜色、背景高亮、复杂嵌套公式以及交叉表头,此时必须依赖复杂 Office XML 结构,前端序列化开销过大,适合交由后端的 Java EasyExcel 或 Go excelize 等高性能流式库完成。
Gemini Robotics 2.5能力边界解析:动作模型、奔驰试点与物理安全验证
2026-11-16 11:23:07
JavaScript实时时间组件内存泄漏:怎么正确清除定时器
2026-11-13 21:01:41
js字符串转数组大字符串性能优化
2026-11-13 12:58:34
怎么解决JavaScript浮点数精度导致的取整错误
2026-11-13 11:52:54
Chrome 157安全更新修复9项漏洞,Google确认一项已被利用
2026-11-10 15:31:49