

JavaScript递归实现:查找树中从根节点到指定值的路径
详细讲解如何在JavaScript中使用递归深度优先遍历(DFS)与回溯算法,快速查找从树结构根节点到指定目标值的完整路径,包含算法原理、完整代码示例、调用栈推导及边界处理。
一、树结构定义与目标场景
在实际业务中,最常见的树结构是多叉树(N-ary Tree)。每个节点通常包含标识符(如 id 或 value)、展示名称以及子节点列表 children。当需要在树中定位子节点并生成面包屑导航(Breadcrumb)或默认展开列表时,我们需要返回一条有序的节点序列。
例如,给定如下嵌套的对象结构,如果我们要查找目标节点 id: 5(“权限设置”),期望返回的路径是由其祖先到自身的序列:[1, 2, 5] 或完整的节点引用数组。
// 典型的多叉树数据结构
const treeData = {
  id: 1,
  name: "系统根目录",
  children: [
    {
      id: 2,
      name: "系统设置",
      children: [
        { id: 4, name: "基础信息" },
        { id: 5, name: "权限设置" }
      ]
    },
    {
      id: 3,
      name: "操作日志"
    }
  ]
};
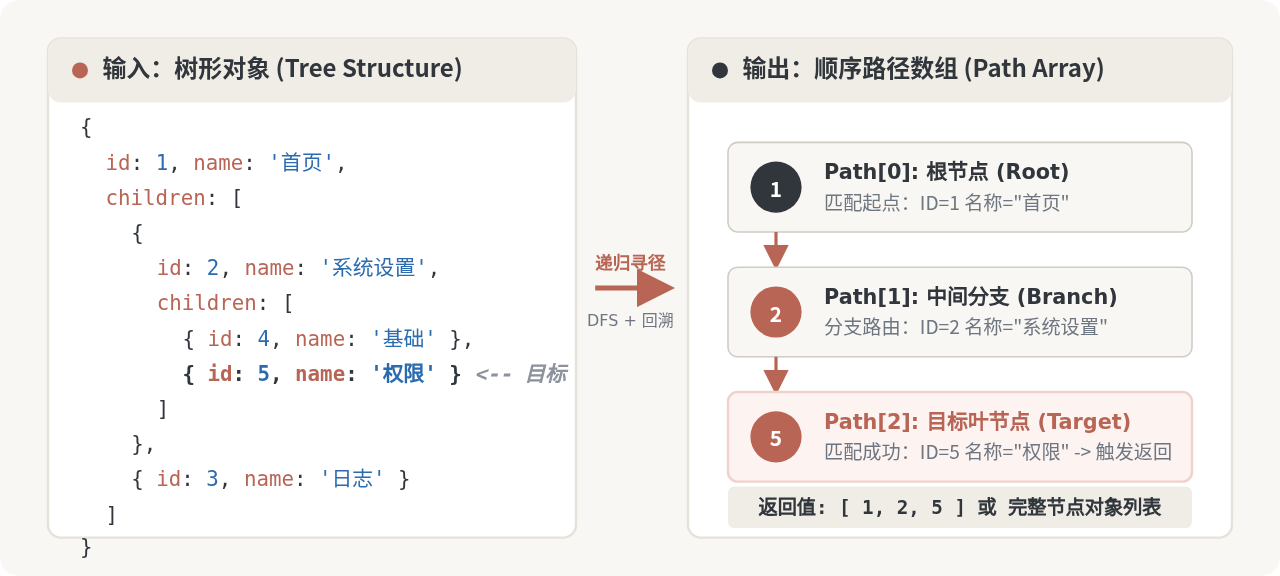
二、核心递归算法:DFS 与回溯机制
查找树路径的过程本质上是在树的分支中进行试探。因为目标节点可能分布在任意深度的分支中,递归算法必须清晰定义三个关键环节:
- 终止与命中条件:若当前节点为空,返回未找到(
null或false);若当前节点的属性值等于目标值,说明已抵达目标,直接记录并返回当前链路。 - 递归深入子节点:若当前节点非目标,且含有
children,则依次对其子节点发起递归调用。只要任意一个子节点的调用链返回了有效路径,便说明目标在下方,立即向上返回该结果,避免多余遍历。 - 状态撤销(回溯 Backtracking):如果某个节点的所有子树均未找到目标节点,说明当前分支是一条“死胡同”。此时必须将当前节点从候选路径中移除(
pop),以便回退到父节点去探索其他分支。
完整代码实现:就地回溯法
下面给出一个经过生产验证的通用实现。该函数支持传入整棵树的根节点和目标值,返回从根节点到目标节点的对象数组;如果未找到则返回 null。
/**
 * 递归查找多叉树中从根节点到目标值的完整节点路径
 * @param {Object} node - 当前遍历的树节点
 * @param {number|string} targetValue - 需要查找的目标节点值
 * @param {Array} path - 暂存当前路径的数组(内部递归使用)
 * @returns {Array|null} 成功时返回完整路径节点数组,失败返回 null
 */
function findPathToTarget(node, targetValue, path = []) {
  // 1. 边界安全检查:空节点直接返回 null
  if (!node) {
    return null;
  }

  // 2. 将当前节点加入候选路径
  path.push(node);

  // 3. 判断当前节点是否就是目标节点
  if (node.id === targetValue) {
    // 命中目标!返回当前路径的浅拷贝,防止后续回溯修改
    return [...path];
  }

  // 4. 若有子节点,深度优先递归遍历
  if (Array.isArray(node.children) && node.children.length > 0) {
    for (const child of node.children) {
      const result = findPathToTarget(child, targetValue, path);
      // 只要子树找到了有效路径,立刻返回,不再继续遍历兄弟分支
      if (result !== null) {
        return result;
      }
    }
  }

  // 5. 回溯清理:当前节点的子树全部遍历完毕仍未找到,将当前节点移出路径
  path.pop();

  // 6. 当前分支未找到目标
  return null;
}

// 运行测试示例
const resultPath = findPathToTarget(treeData, 5);
console.log(resultPath ? resultPath.map(item => item.id) : null);
// 示例输出: [ 1, 2, 5 ]
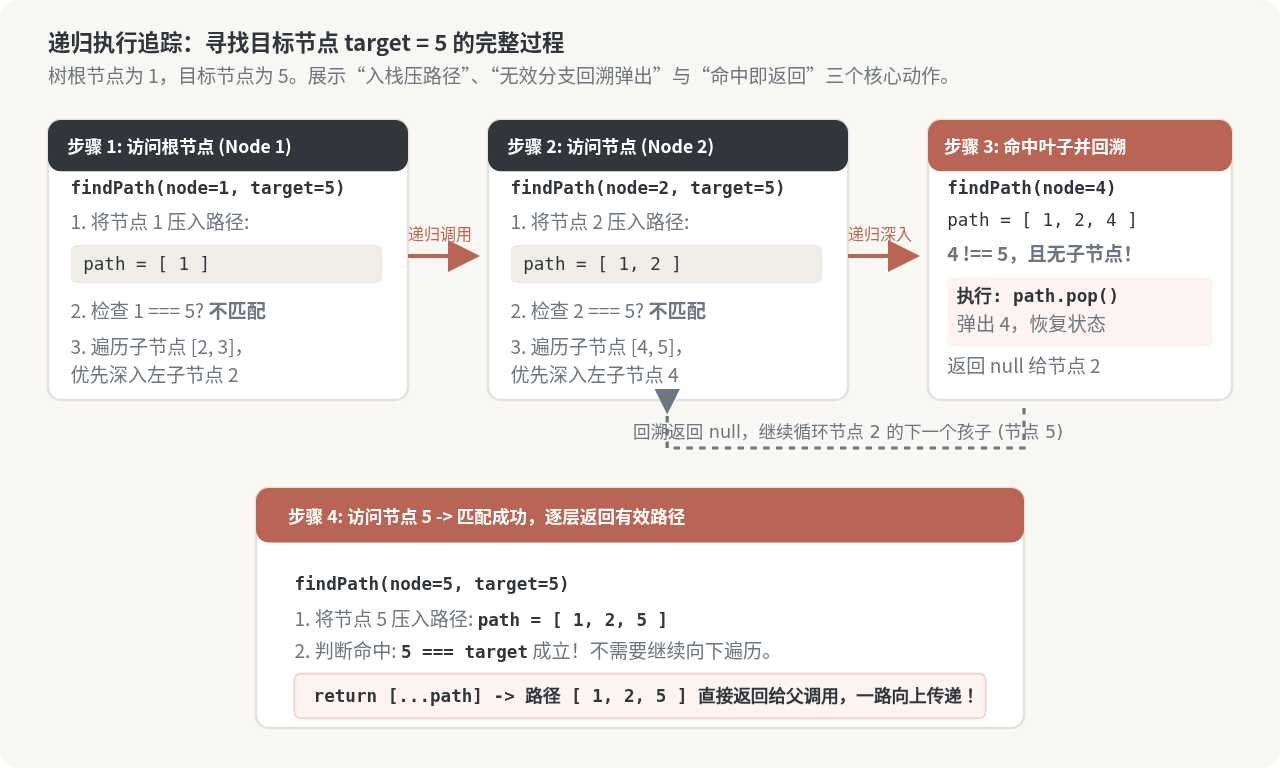
三、执行过程剖析:调用栈与路径推导
结合图 2,我们可以观察到算法在执行时的具体状态演变:
- 第 1 步:调用
findPathToTarget(node1, 5)。path变为[node1]。1 不等于 5,进入子节点循环,首先递归node2。 - 第 2 步:调用
findPathToTarget(node2, 5)。path变为[node1, node2]。2 不等于 5,继续进入子节点循环,优先递归node4。 - 第 3 步(关键回溯点):调用
findPathToTarget(node4, 5)。path变为[node1, node2, node4]。4 不等于 5,且node4无子节点。该分支搜索失败,执行path.pop(),将node4弹出。path恢复为[node1, node2],函数返回null。 - 第 4 步(命中):父层
node2收到null,继续循环下一个子节点node5。调用findPathToTarget(node5, 5)。path压入 5,变为[node1, node2, node5]。此时node5.id === 5成立!通过[...path]复制并返回该数组。后续各层递归接收到非null结果,直接一路返回至最外层。
四、两种递归实现模式的权衡对比
在实际编写代码时,开发者通常会在“就地回溯(共享单数组 + push/pop)”与“纯函数不可变传递(每次递归拼接新数组)”之间进行选择。
// 纯函数风格:每次递归传入拼接后的新数组
function findPathImmutable(node, targetValue, currentPath = []) {
  if (!node) return null;

  const nextPath = [...currentPath, node];
  if (node.id === targetValue) {
    return nextPath;
  }

  if (Array.isArray(node.children)) {
    for (const child of node.children) {
      const res = findPathImmutable(child, targetValue, nextPath);
      if (res) return res;
    }
  }

  return null;
}
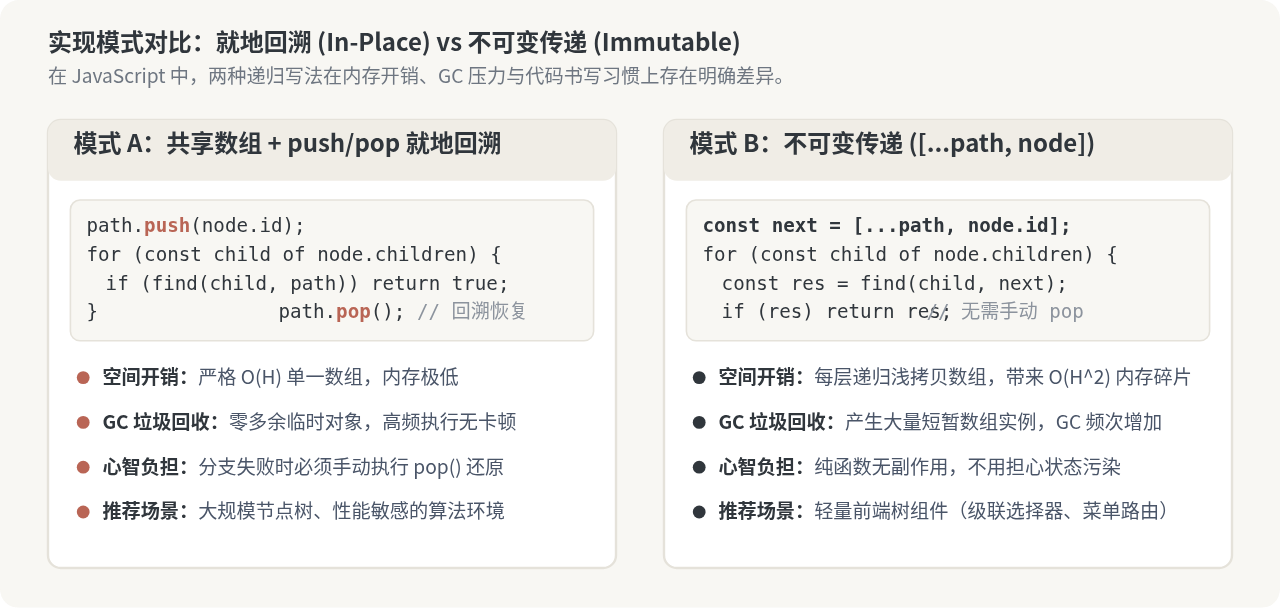
| 对比维度 | 就地回溯模式(推荐) | 不可变拼接模式 |
|---|---|---|
| 内存开销 | O(H)(H 为树深度),全局仅维护一个路径数组 | O(H²),每层递归浅拷贝产生新数组 |
| GC 垃圾回收 | 几乎无临时数组产生,GC 压力小 | 高频产生短期废弃数组,容易触发垃圾回收 |
| 实现复杂度 | 需在函数出口维护 path.pop() 回溯 |
无需手动回溯,代码更短更纯粹 |
| 适用场景 | 大型数据树、高频寻径计算、性能敏感模块 | 普通小型配置树、轻量级前端交互组件 |
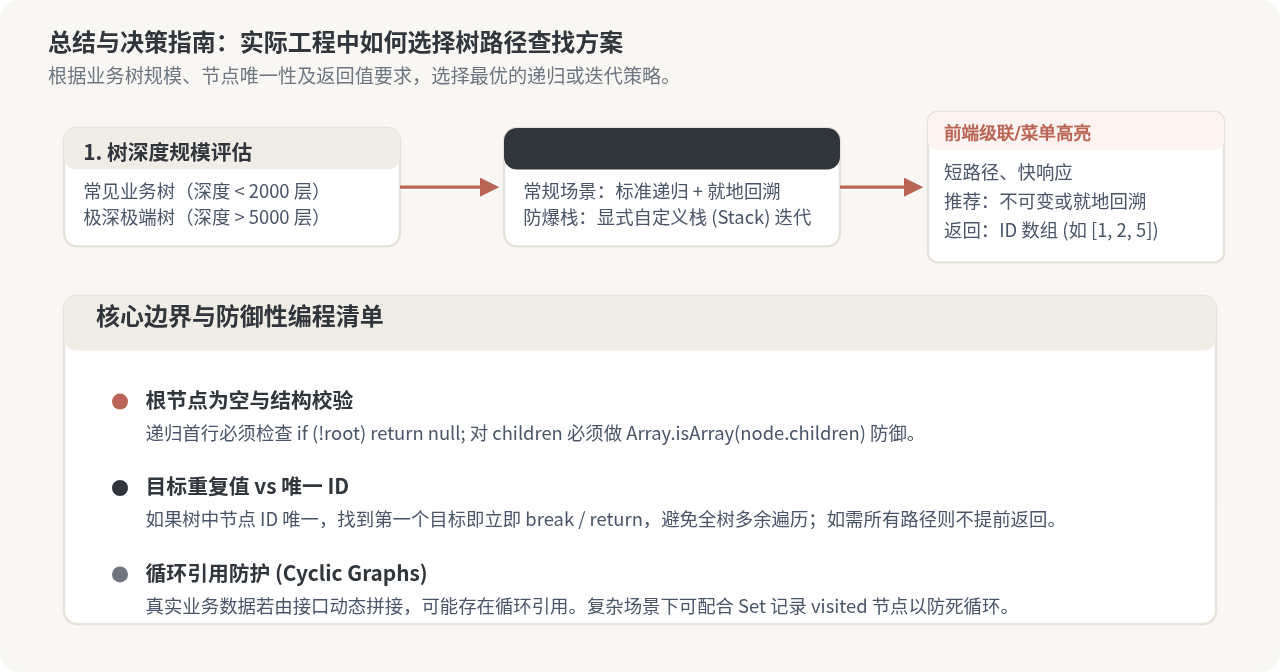
五、工程落地的边界条件与防御性设计
在真实项目中,后端接口返回的数据往往存在字段缺失、格式不统一或异常情况。在生产环境中运行此递归算法时,需特别注意以下几点:
1. 空节点与格式防御
树节点的 children 字段可能为 null、undefined 甚至空字符串。因此不能简单假定 node.children 必然可迭代。必须使用 Array.isArray(node.children) 进行防御性判断。
2. 目标节点唯一性与提前熔断
若业务保证 id 全局唯一,一旦找到目标必须立刻通过 return result 中断遍历,切忌让算法继续扫描剩余分支。如果业务需求是“查找树中所有包含指定标签的节点路径”(一对多),则不能提前退出,需收集所有命中的完整链路。
3. 递归深度与调用栈溢出(Stack Overflow)
JavaScript 引擎(如 V8)的调用栈深度通常在 10,000 层左右。对于前端 UI 层(如菜单、省市区联动),树的深度一般在 3 到 10 层之间,递归完全不会有栈溢出风险。但如果用于处理层级极深的拓扑结构或嵌套过万层的图,应改用显式模拟调用栈的迭代方式(While + 自建 Array 栈)。
六、总结
在 JavaScript 中使用递归查找树中根节点到指定值的路径,核心在于掌握深度优先遍历与回溯状态管理。通过在递归向下时入栈节点,在递归向上失败时出栈节点,并利用有效返回值的“短路特性”提前终止搜索,可以用简明而高效的代码实现 O(N) 时间复杂度的精准路径提取。
VB.NET怎么通过WebView2控件执行JavaScript并获取结果
2026-11-16 13:23:56
JavaScript计算剩余天时分秒的倒计时代码
2026-11-16 13:23:48
地下室墙面防水能用JS聚合物砂浆吗?施工规范详解
2026-11-16 13:19:14
js字符串转数组IteratorHelpers懒处理ES2025
2026-11-13 20:14:20
js字符串转数组map(Number)出现NaN原因
2026-11-13 19:21:57







