js字符串转数组IteratorHelpers懒处理ES2025
深入解析ES2025正式引入的Iterator Helpers特性在JavaScript字符串转数组场景中的懒处理实践。对比传统全量转换的内存开销,演示Iterator.from、filter、map、take及toArray的高效管道构建与短路机制。
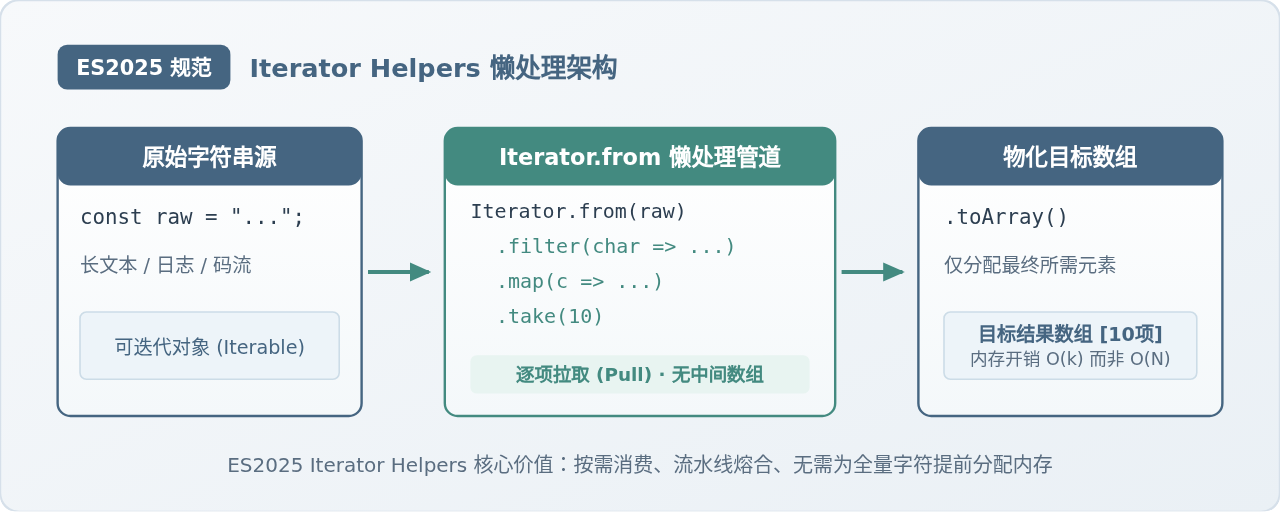
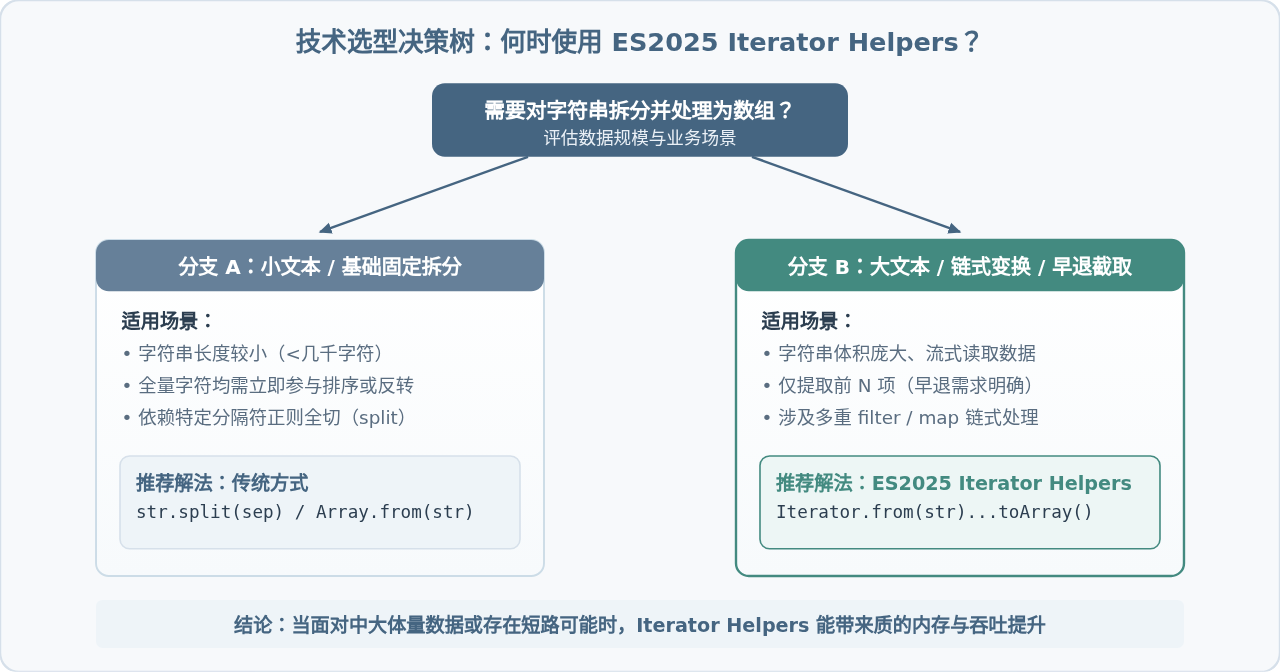
在 JavaScript 中将字符串转换为数组并执行过滤、映射或切片时,传统方式通常使用 split('') 或展开运算符 [...str]。这种贪婪(Eager)求值会在内存中立刻分配容纳所有字符的完整数组,并在后续链式调用中频繁产生中间临时数组。ECMAScript 2025 正式引入的 Iterator Helpers 规范,通过 Iterator.from() 与内置的懒处理迭代器辅助方法,让开发者能够以拉取驱动(Pull-based)的方式逐字处理字符串,支持随时早退短路,并在最终一步调用 .toArray() 物化结果,彻底避免无意义的内存占用与全量字符扫描开销。
一、传统字符串转数组的痛点与懒处理的价值
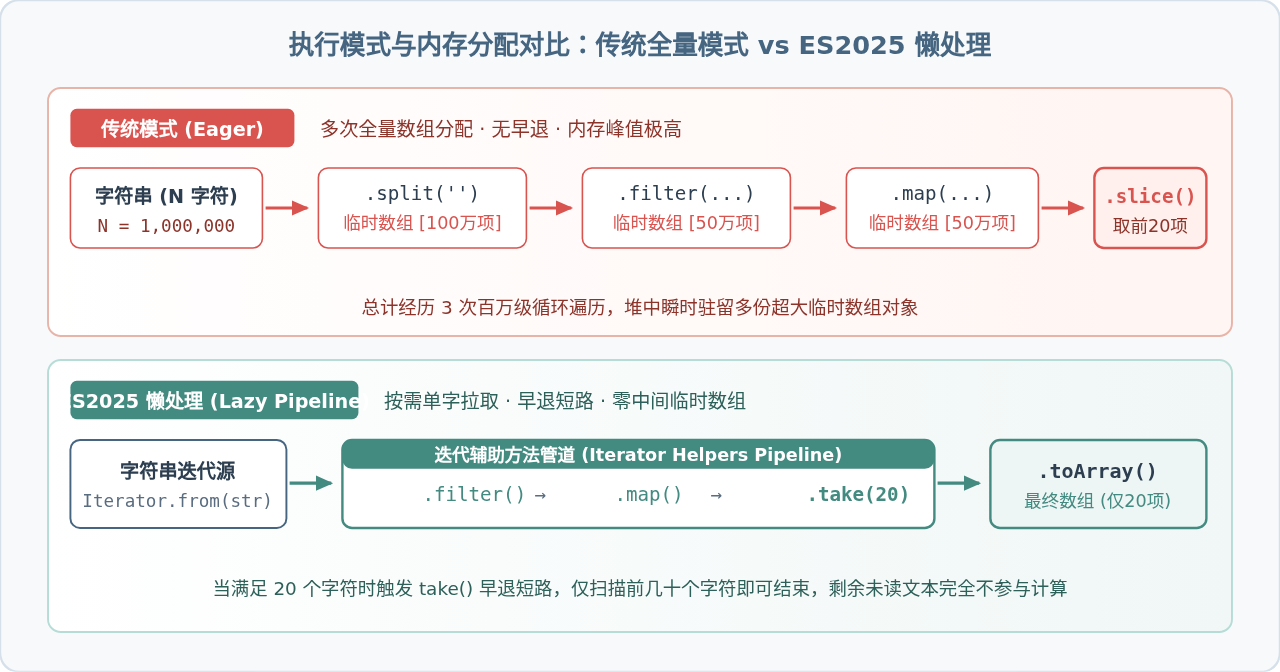
在日常开发中,处理由逗号分隔的数据串、长文本日志或复杂字符流时,我们常需要将字符串拆分为单个字符或子标记数组,并做进一步筛选和截取。例如:从一段包含百万字符的文本中提取前 20 个符合规范的十六进制字符。
传统做法通常如下:
// 传统贪婪求值 (Eager Execution) 方式
const hugeStr = "A1B2C3D4..."; // 假设长度为 1,000,000

const result = hugeStr
  .split("")                       // 步骤 1: 瞬间分配 1,000,000 长度的临时数组
  .filter(char => /[0-9A-F]/i.test(char)) // 步骤 2: 再次分配第二个大数组
  .map(char => char.toUpperCase())        // 步骤 3: 再次分配第三个大数组
  .slice(0, 20);                          // 步骤 4: 最终截取前 20 项
上述代码暴露了三个显著缺陷:
- 全量预分配开销大:
split('')在执行瞬间就必须扫描完整字符串并在堆内存中构建完整数组。面对大字符串时,极易造成瞬时内存抖动甚至触发 GC 阻塞。 - 链式调用的中间数组膨胀:数组原生的
.filter()和.map()均为贪婪计算,每一层方法链都会生成一个中间数组,造成多倍内存消耗。 - 缺乏早退机制:尽管最终只需要 20 个元素,但
split、filter和map依然对百万字符执行了全量循环,绝大部分算力被白白浪费。
而字符串在 JavaScript 中本身是原生可迭代对象(实现 [Symbol.iterator]())。ES2025 规范通过 Iterator Helpers 赋予了迭代器原生的流式转换能力,彻底改变了这一现状。
二、核心语法与操作步骤:从字符串到懒迭代器
要使用 ES2025 提供的懒处理特性,核心操作主要由三个阶段组成:包装为迭代器、配置流水线、物化输出。
步骤 1:将字符串包装为标准迭代器
在 ES2025 中,全局对象 Iterator 新增了静态方法 Iterator.from()。它接收任意可迭代对象(Iterable)或迭代器协议对象,并返回一个继承自 Iterator.prototype 的标准迭代器实例:
const str = "Hello, 世界 🚀!";

// 将字符串转化为增强型迭代器对象
const charIterator = Iterator.from(str);

console.log(charIterator instanceof Iterator); // true字符串默认的 Symbol.iterator 是按 Unicode 码点(Code Point)进行迭代的,这意味着类似 "🚀" 等由代理对(Surrogate Pairs)组成的 Emoji 字符会被视作一个独立的字符完整输出,不会像老旧的 str.split('') 那样将代理对拆碎为非法字符。
步骤 2:链式挂载懒处理辅助方法
包装后的迭代器实例可以直接调用 Iterator.prototype 上的流式方法。这些方法在调用时不会立即执行计算,而是返回一个新的包装迭代器:
.filter(predicate):按条件跳过不满足要求的字符;.map(mapper):将字符转换为目标形式(如大小写转换、查表替换);.take(limit):只取满足条件的前limit个元素,达到数量后立即终止;.drop(limit):跳过前limit个字符,从第limit + 1个开始处理;.flatMap(mapper):将单个字符展开映射为多项序列。
步骤 3:物化转换为目标数组
当定义好过滤与变换规则后,可以通过末端终结方法触发实际计算。最直接的转换方法就是 .toArray():
const text = "User_ID: #89201; Status: Active; Token: 0xFA3C;";

// 构建管道并在最后转为数组
const hexChars = Iterator.from(text)
  .filter(char => /[0-9A-Fa-f]/.test(char)) // 仅保留十六进制字符
  .map(char => char.toUpperCase())        // 转为大写
  .take(6)                                // 仅拉取前 6 项满足条件的字符
  .toArray();                             // 触发执行,生成标准 Array

console.log(hexChars);
// 输出: [ '8', '9', '2', '0', '1', 'A' ]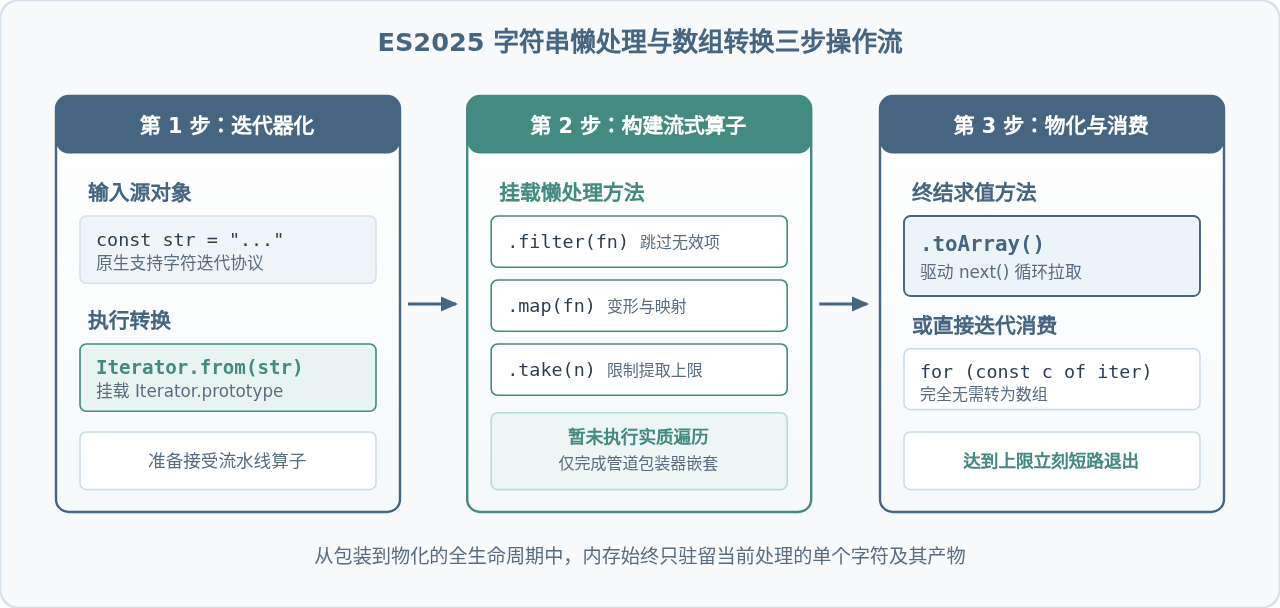
三、懒执行原理与短路机制(Pull-based 机制剖析)
为了理解为什么 Iterator Helpers 比数组方法更快、更省内存,需要探究其底层的拉取模型(Pull-based Model)与短路机制(Early Exit)。
1. 什么是拉取模型?
传统的数组 .filter() 和 .map() 是推送模型(Push-based):前一个方法将所有计算结果全部打包生成一个数组,一口气推给下一个方法。即便后方只需要前 5 个结果,前方也必须把所有 100 万项处理完毕。
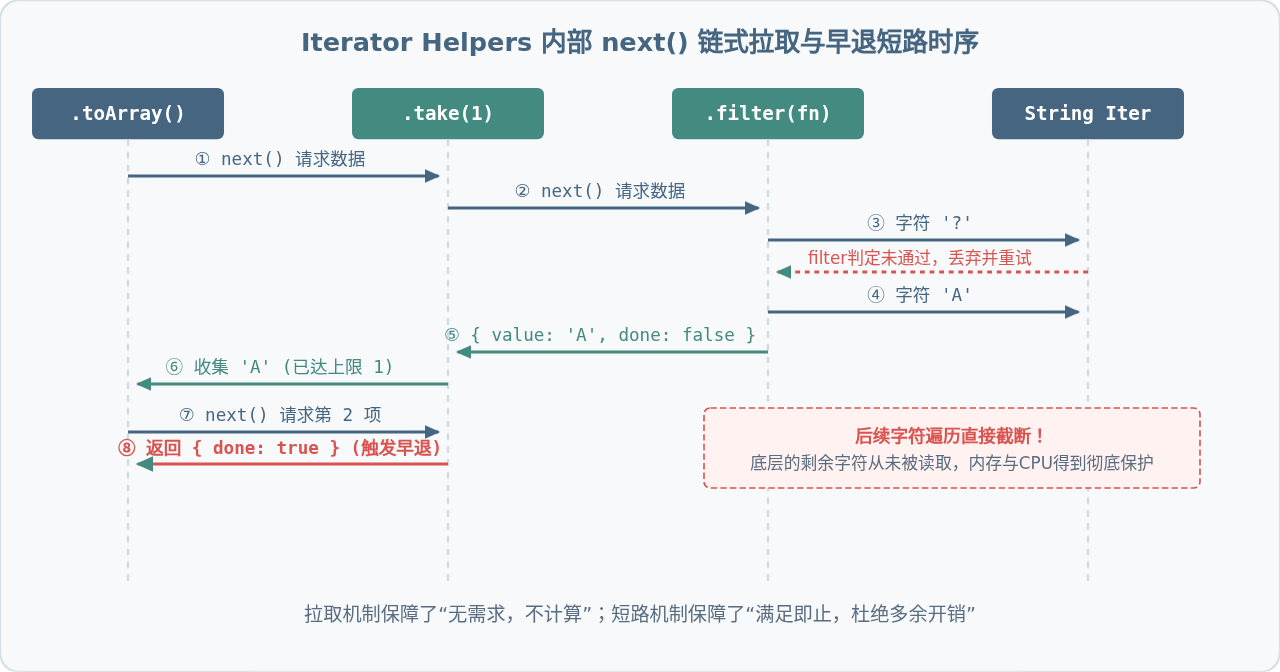
而 Iterator.from() 产生的是拉取模型。调用 .filter()、.map()、.take() 时,只是生成了一层层嵌套的包装对象,并在内部实现了标准 next() 逻辑:
- 终端调用
toArray(),向take迭代器请求 1 个值(发起take.next()); take迭代器向map迭代器请求 1 个值(发起map.next());map迭代器向filter迭代器请求 1 个值;filter迭代器循环从底层字符串拉取字符,直到匹配条件后返回给map;map转换后交给take,take计数加 1 并推入最终数组。
2. 短路退出的物理级节省
当 take(limit) 计数达到上限时,它在下一次调用 next() 时会直接返回 { value: undefined, done: true }。终结者 toArray() 收到 done: true 信号后立刻结束循环,管道彻底断开。此时底层的字符串游标停留在刚刚消费完的位置,剩余的数十万字符根本不会被迭代器访问,也不会进入任何正则判断或映射函数。
四、典型实践场景与代码示例
场景 1:大文本前缀提取与字符规范化
处理大型 JSON、CSV 或日志文件片段时,提取满足特定条件的字符样本:
// 提取前 5 个非空白字符并转为小写
const rawLog = "   \n\t  \r  [INFO] 2026-11-10 Error code 0x89...";

const sampleChars = Iterator.from(rawLog)
  .filter(ch => ch.trim() !== "") // 忽略任何空白换行符
  .map(ch => ch.toLowerCase())    // 转换为小写
  .take(5)                       // 只要前 5 个
  .toArray();

console.log(sampleChars);
// 输出: [ '[', 'i', 'n', 'f', 'o' ]
场景 2:跳过头部元数据并抽取特定位数的 Token
结合 .drop() 和 .take(),可以像操作数据库分页或数据切片一样操作字符流,完全不需要提前用 substring() 拷贝生成新字符串:
const packet = "HEADER_V2_DATA:9847120593481023948";

// 跳过前面的头部标记 "HEADER_V2_DATA:" (长度 15),随后提取 6 位校验数字
const tokenArray = Iterator.from(packet)
  .drop(15)
  .take(6)
  .map(ch => Number(ch))
  .toArray();

console.log(tokenArray);
// 输出: [ 9, 8, 4, 7, 1, 2 ]
场景 3:结合正则迭代器 matchAll 的进阶懒处理
除了单字符,在匹配子串或特定模式时,String.prototype.matchAll() 原生返回一个正则匹配迭代器。该迭代器可以直接接入 Iterator.from() 构筑完整的懒处理流:
const sourceCode = "const a = 1; let b = 2; const c = 3; var d = 4; const e = 5;";
const varRegex = /(?:const|let|var)\s+([a-zA-Z_]\w*)/g;

// 直接将正则匹配迭代器包装为标准 Iterator Helper
const firstTwoVars = Iterator.from(sourceCode.matchAll(varRegex))
  .map(match => match[1]) // 提取捕获组
  .take(2)               // 仅匹配前两个变量名即停止正则搜索
  .toArray();

console.log(firstTwoVars);
// 输出: [ 'a', 'b' ]
五、运行环境、兼容性与工程注意事项
1. 规范状态与环境支持
Iterator Helpers 提案由 TC39 推进,并在 ECMAScript 2025(ES2025 / 第 16 版规范)中正式成为语言标准。目前主流运行环境的支持情况如下:
| 运行环境 / 引擎 | 原生支持版本 | 备注 |
|---|---|---|
| V8 (Chrome / Edge / Chromium) | Chrome 122+ | 已完全原生默认启用 |
| Node.js | Node.js 22.0.0+ | LTS 生产环境已稳定支持 |
| JavaScriptCore (Safari) | Safari 17.0+ | macOS / iOS 全平台原生可用 |
| Gecko (Firefox) | Firefox 131+ | 支持完整迭代辅助方法 |
如果业务项目需要向下兼容旧版浏览器或老版本 Node.js,可使用标准 Polyfill 库 core-js:
// 引入标准 Iterator Helpers Polyfill
import "core-js/actual/iterator";
2. 核心注意事项
- 迭代器的一次性原则:迭代器是一次性消费的流。调用
.toArray()后,迭代器内部状态将置为done: true。如果后续再次调用.toArray(),只会得到空数组。如需多次使用,必须重新从源字符串执行Iterator.from(str)。 - 无随机访问能力:迭代器不提供数组式的下标随机访问(如
iter[3]不起作用)。所有项必须依次拉取。如果场景重度依赖索引回溯,物化为常规数组仍是合适选择。 - 与 Array.prototype 对应方法的语义差异:
iter.map()和iter.filter()的回调函数只接收两个参数(value, index),且不传递第三个参数(因为流式迭代器无法提供整体集合引用)。
总结
ES2025 的 Iterator Helpers 填补了 JavaScript 在原生惰性计算标准上的长期空白。在将字符串转换为数组的操作中,通过 Iterator.from(str) 将字符源接入拉取管道,结合 .filter()、.map()、.drop() 和 .take(),能够以零中间数组的内存开销实现高效流水线处理,并在达到阈值时即刻短路早退,最后通过 .toArray() 精确物化目标结果。这种模式兼具了声明式函数式代码的优雅可读性与近乎手写 for 循环早退的卓越性能,是大文本与流式数据处理中的标准解法。
js字符串转数组map(Number)出现NaN原因
2026-11-13 19:21:57
js字符串二进制"101"怎么转数字数组
2026-11-13 18:35:31
js字符串表格数据转二维数组split
2026-11-13 17:16:49
ts字符串转数组asstring[]类型转换
2026-11-13 16:05:43
js字符串转数组处理emoji字节数
2026-11-13 14:43:07