JS字符串转UTF-8字节数组:TextEncoder标准用法
详细讲解现代JavaScript中使用TextEncoder将字符串编码为UTF-8字节数组(Uint8Array)的标准用法,包含基础编码、内存复用encodeInto、原理图解及常见注意事项。
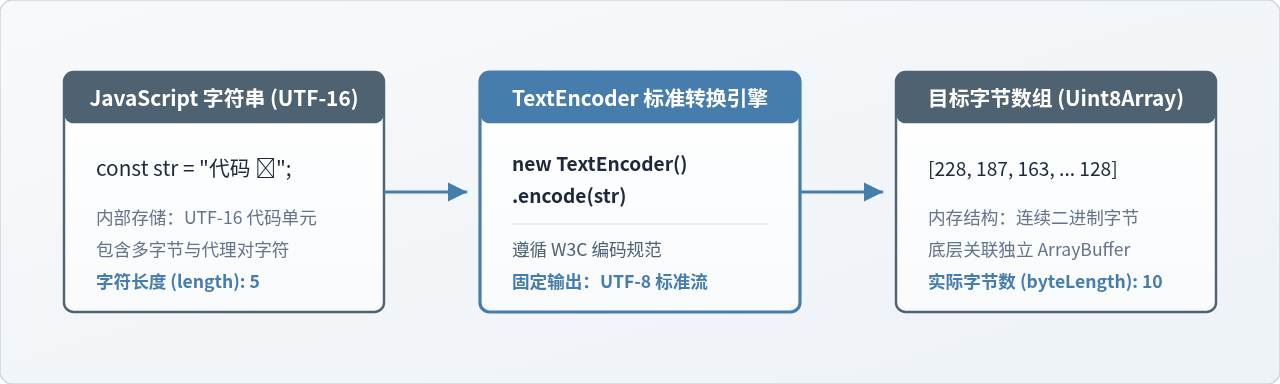
在现代 JavaScript 开发中,将字符串转换为 UTF-8 编码的字节数组(Uint8Array)的标准解决方案是使用内置的 TextEncoder API。无论是浏览器环境、Node.js(11 及更高版本)、Deno 还是 Bun,无需引入任何外部第三方库,即可通过两行核心代码完成从 JavaScript 原生 Unicode 字符串到连续二进制字节序列的高效转化。
一、编码原理:JavaScript 字符串与 UTF-8 字节数组的对应机制
JavaScript 内部使用 UTF-16 编码来存储和处理字符串,每个字符代码单元(Code Unit)占用 16 位(2 字节)。然而,在网络协议(如 HTTP、WebSocket)、加密算法(如 Web Crypto API)以及文件存储与 WebAssembly 交互中,通用的标准是 UTF-8 编码。
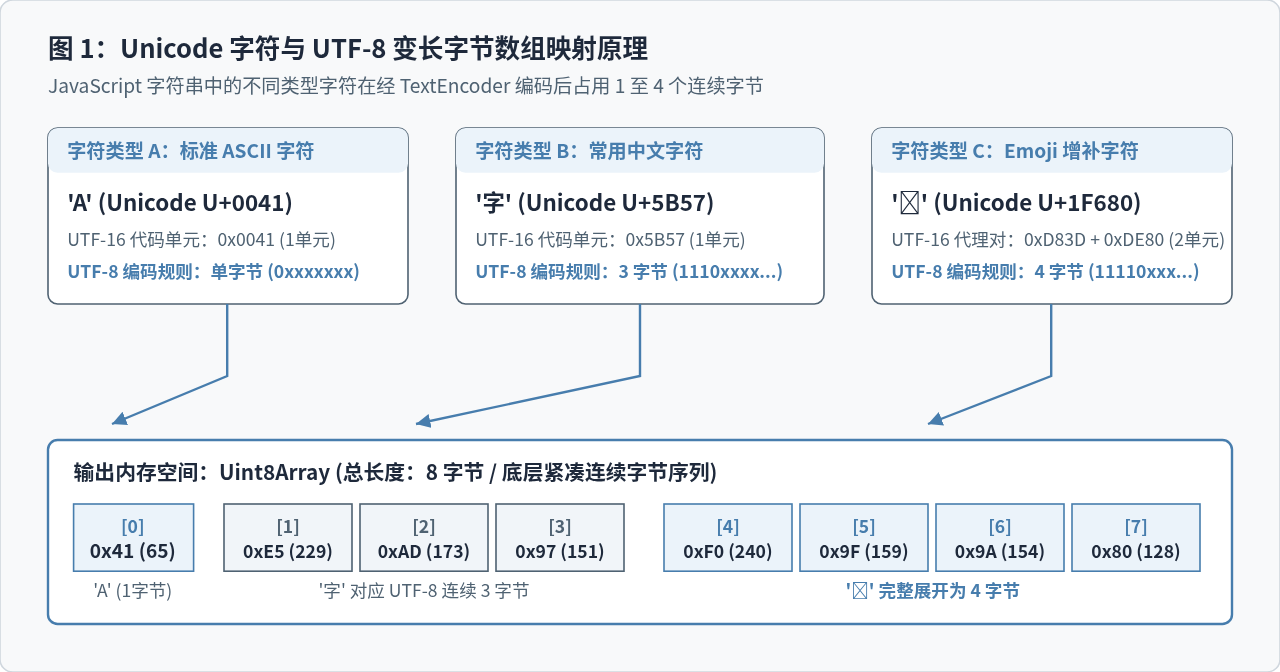
UTF-8 是一种针对 Unicode 的可变长度字符编码方式:
- 标准 ASCII 字符(0x00 至 0x7F):仅占用 1 个字节,与 ASCII 码完全兼容。
- 拉丁文扩展、希腊文等(0x080 至 0x07FF):占用 2 个字节。
- 绝大多数常用中文汉字及平假名等(0x0800 至 0xFFFF):占用 3 个字节。
- Emoji、古代符号等增补平面字符(0x10000 及以上):在 JS 内部表现为两个 UTF-16 代码单元(即代理对 Surrogate Pair),经 UTF-8 编码后占用 4 个字节。
按照 W3C 与 WHATWG 编码规范,TextEncoder 的编码格式被永久锁定为 UTF-8,不支持指定其他编码(如 GBK 或 UTF-16)。这种设计不仅杜绝了配置歧义,而且能让底层的 C++ 转换逻辑直接利用硬件向量指令进行极致优化。
二、标准调用:TextEncoder.prototype.encode() 的基本流程
将字符串转为 UTF-8 字节数组的标准操作由两步完成:先通过构造函数创建编码器实例,再调用其 encode() 方法。
1. 完整操作代码示例
// 步骤一:创建 TextEncoder 实例
const encoder = new TextEncoder();

// 待转换的目标字符串(包含英文、标点、中文和 Emoji 表情)
const text = "A字🚀";

// 步骤二:调用 encode 方法执行转换
const byteArray = encoder.encode(text);

// 步骤三:检查转换结果与数据属性
console.log("返回类型是否为 Uint8Array:", byteArray instanceof Uint8Array); // true
console.log("原始字符串字符数 (str.length):", text.length);                      // 4('🚀' 占 2 个 UTF-16 单元)
console.log("编码后字节总数 (byteArray.length):", byteArray.length);             // 8
console.log("十进制字节数组:", Array.from(byteArray));
// 示例输出: [65, 229, 173, 151, 240, 159, 154, 128]

// 输出对应的十六进制形式,便于排查网络封包与协议对接
const hexString = Array.from(byteArray)
  .map(b => b.toString(16).padStart(2, "0").toUpperCase())
  .join(" ");
console.log("十六进制输出:", hexString);
// 示例输出: 41 E5 AD 97 F0 9F 9A 80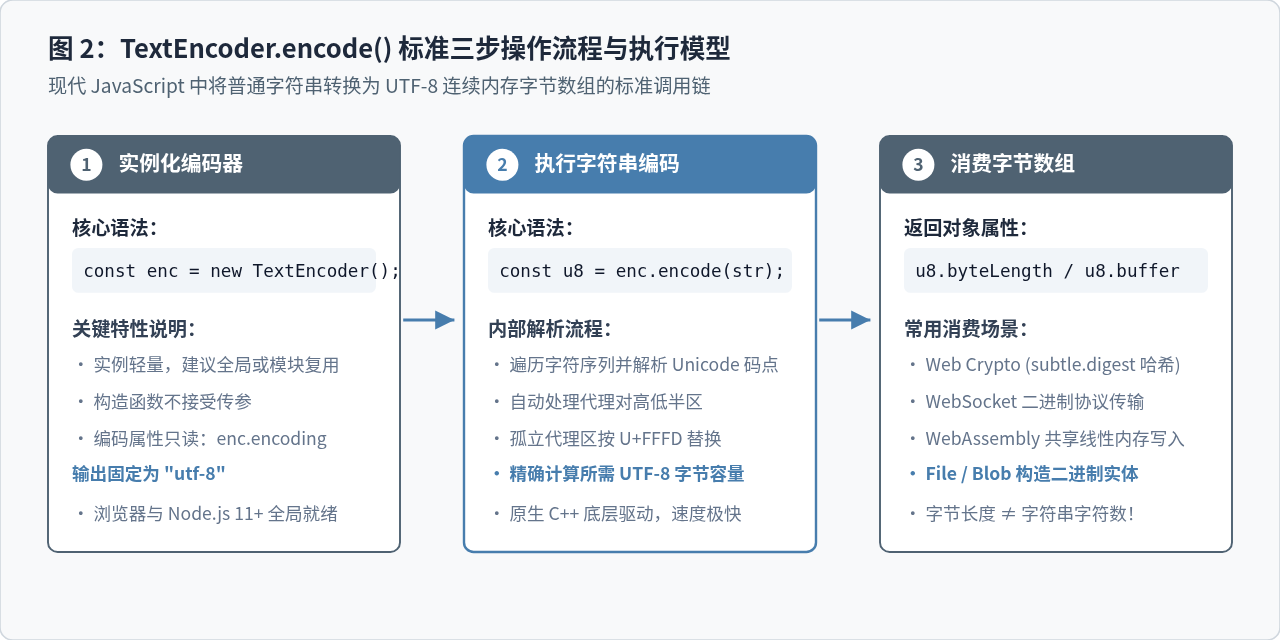
TextEncoder 实例完全是无状态(stateless)的。在单页面应用(SPA)或服务端程序中,无需在每个函数内部重复执行 new TextEncoder(),直接在模块作用域或类中维护一个公共单例即可。
三、高吞吐优化:使用 encodeInto() 实现零额外内存分配
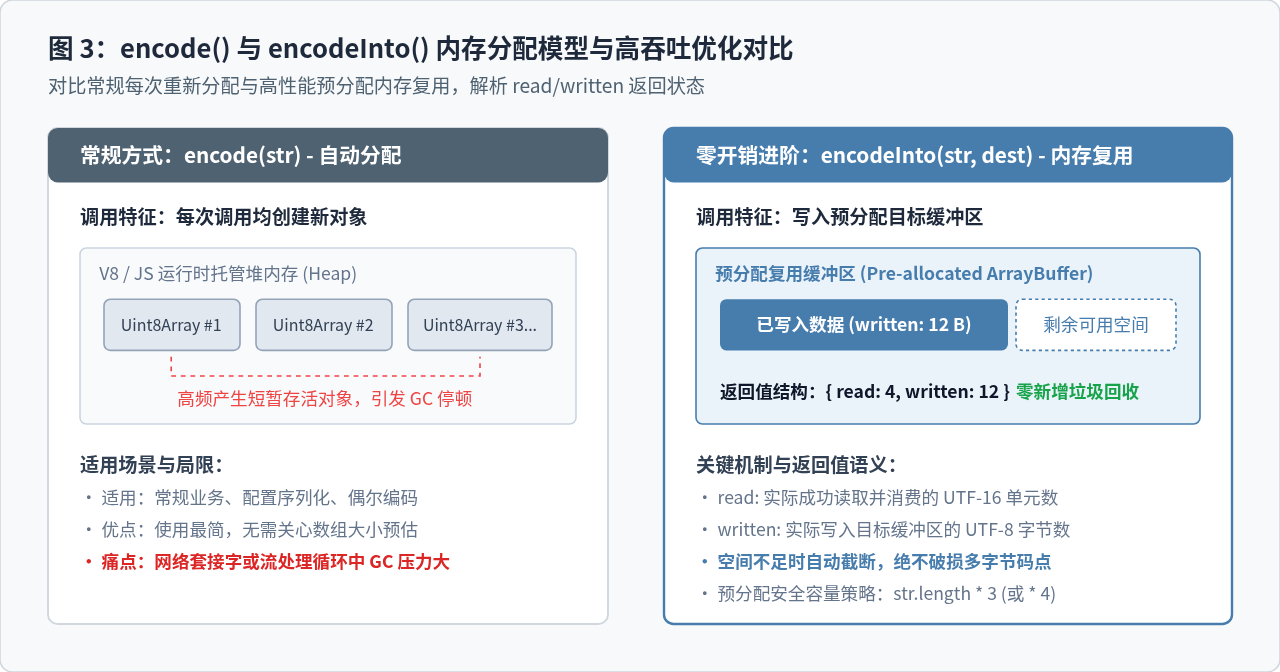
当处理 WebSocket 频繁推流、文件分块上报、高性能序列化或 WebAssembly 共享内存写入时,如果反复调用 encode(),每次都会向操作系统请求开辟全新的 ArrayBuffer 堆内存,导致高频触发垃圾回收(GC),引发执行卡顿。
为了解决这一问题,规范提供了 TextEncoder.prototype.encodeInto(sourceString, destinationUint8Array) 方法。该方法直接将编码后的字节写入预先分配好的目标 Uint8Array 内存中,避免了任何中间临时对象的创建。
1. encodeInto 的语法与返回值解析
encodeInto() 接受两个参数,并同步返回一个包含两个状态指标的对象:
read(数字):从源字符串中成功读取并解析的 UTF-16 代码单元(Code Units)数量。written(数字):实际向目标Uint8Array中写入的 UTF-8 字节数量。
2. 内存复用实战示例代码
const encoder = new TextEncoder();

// 预先分配一块固定的可复用连续缓冲区(例如 1024 字节)
const sharedBuffer = new Uint8Array(1024);

// 模拟循环接收到的动态字符串
const messages = ["第一条消息", "Status: OK", "数据上报 🚀"];

for (const msg of messages) {
  // 将字符串直接写入 sharedBuffer 的起始位置,无需创建新数组
  const { read, written } = encoder.encodeInto(msg, sharedBuffer);

  // 通过 subarray 切片获取当前消息的实际数据视图(零内存拷贝)
  const validPayload = sharedBuffer.subarray(0, written);

  console.log(`读取字符单元: ${read}, 写入字节数: ${written}, 数据大小: ${validPayload.byteLength}B`);
}
// 示例输出:
// 读取字符单元: 5, 写入字节数: 15, 数据大小: 15B
// 读取字符单元: 10, 写入字节数: 10, 数据大小: 10B
// 读取字符单元: 6, 写入字节数: 16, 数据大小: 16B
3. 目标缓冲区大小预分配策略
使用 encodeInto() 时,如果目标缓冲区容量小于字符串转换所需的字节数,编码器将只编码能够完整放入缓冲区的字符,并在边界处停止。为了确保目标缓冲区能够完整装下字符串,通常采用以下安全预分配估算规则:
- 纯文本场景(最多 3 字节/字符):由于基本多语言平面(BMP,覆盖绝大部分中英文)内每个 UTF-16 单元最多占用 3 个 UTF-8 字节,可预先分配
str.length * 3字节。 - 全字符安全场景(最多 4 字节/字符):若包含大量增补平面字符或未知输入,预分配
str.length * 4字节可保证绝对不会发生溢出截断。
四、常见方案对比与选型指南
在 JavaScript 的发展历程中,曾出现过多种将字符串转为字节序列的方式。将现代标准 TextEncoder 与历史方案及 Node.js 专用方式进行横向对比,能够帮助我们更准确地评估技术方案:
| 实现方案 | 跨平台通用性 | 运行性能 | 内存控制能力 | 标准状态 |
|---|---|---|---|---|
| TextEncoder.encode | 全平台支持(Web / Node 11+ / Deno / Bun) | 极高(原生底层实现) | 自动单次分配精准容量 | 现代 W3C / WHATWG 标准,首选推荐 |
| TextEncoder.encodeInto | 全平台支持(Web / Node 11+ / Deno / Bun) | 顶级(零 GC 开销) | 手动管理,完美支持 Buffer 复用 | 高吞吐、密集型 IO 首选 |
| Buffer.from(str, 'utf-8') | 仅 Node.js 支持(需 polyfill 方可进浏览器) | 高(基于 8KB 内部内存池) | Node.js 内部自动池化 | Node.js 历史遗留推荐,缺乏同构性 |
| unescape(encodeURI(str)) | 老旧浏览器可用 | 极低(多次字符串与数组中转) | 产生大量难以优化的中间对象 | 已废弃 Hack 方案,禁止在新项目中使用 |
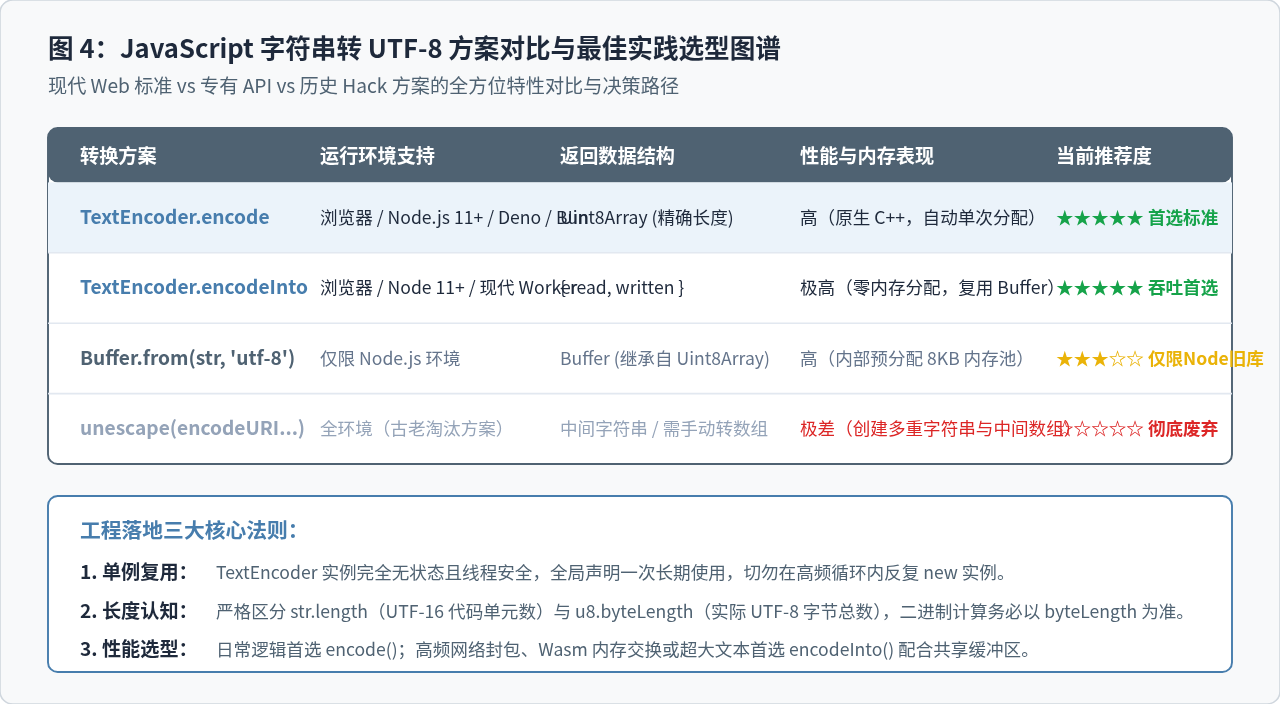
五、关键细节与边界防坑指南
在实际工程落地过程中,有以下几点需要特别注意:
- 字符长度与字节长度不可混淆:在计算 HTTP 请求头
Content-Length或计算存储配额时,切勿使用str.length。汉字或 Emoji 的str.length与最终 UTF-8 字节长度差异极大,必须以encoder.encode(str).byteLength为准。 - 代理对截断的原子性保护:当使用
encodeInto()时,如果目标缓冲区剩余空间不足以容纳 Emoji 的全部 4 个字节(例如只剩 2 个字节),encodeInto()不会只写入一半,而是会自动终止写入,保留完整字符状态,并让read保持在上一个完整字符位置。 - 孤立代理字符(Surrogate Code Points)的处理:如果传入的字符串包含非法的单独高半区或低半区代理代码点,
TextEncoder会根据 Unicode 标准规范自动将其替换为标准替换字符U+FFFD(其 UTF-8 编码为[0xEF, 0xBF, 0xBD]),而不会抛出异常。 - 流式编码支持:如果需要对数兆字节乃至千兆字节的超大文件或持续网络流进行边读边编,可以使用配套的
TextEncoderStreamAPI,通过readableStream.pipeThrough(new TextEncoderStream())实现内存开销恒定的管道化流式转换。
js字符串怎么转数组Object.keys方法
2026-11-13 21:17:14
js字符串怎么转Uint8Array字节数组
2026-11-13 21:08:13
JS数组sort()数字排序陷阱:为什么[10,5,40]会变成[10,40,5]
2026-11-13 20:10:31
JavaScript map结合filter实现数组元素所有索引查找
2026-11-13 19:42:18
JavaScript中定义函数的三种主要方式
2026-11-13 18:01:17