js字符串怎么转Uint8Array字节数组
详细讲解在JavaScript中将字符串转换为Uint8Array字节数组的标准方法、底层UTF-8编码原理、高性能复用技巧及常见陷阱与场景方案。
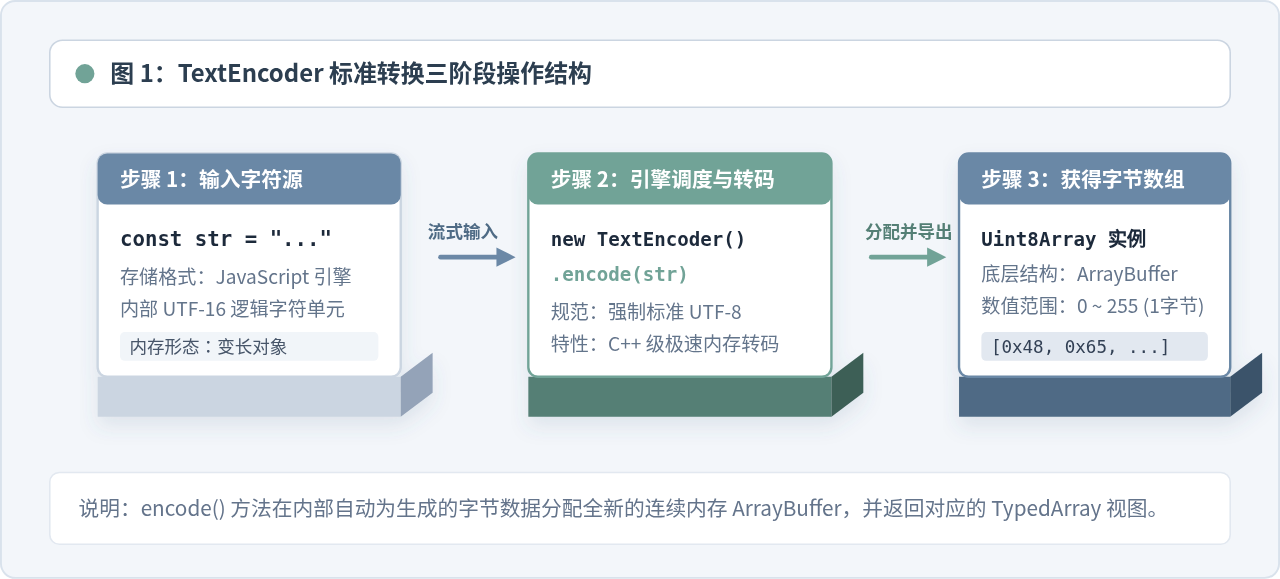
Uint8Array 字节数组的标准做法是使用全局内置的 TextEncoder API:直接调用 new TextEncoder().encode(str) 即可完成转换。该方法基于 UTF-8 规范将字符序列编码为对应的单字节连续内存缓冲区。
一、标准转换方式:TextEncoder
在网络请求(如 fetch 发送二进制体)、WebSocket 二进制通信、Web Crypto 加解密,以及文件拼装(Blob、ArrayBuffer)等场景中,经常需要把文本字符处理成无符号 8 位整数数组(Uint8Array)。
现代浏览器环境与 Node.js(从 Node.js 11 起原生支持)均提供了符合 Web 标准的全局 TextEncoder 接口。使用时不需要引入任何第三方库,两行代码即可完成。
基本代码示例
// 1. 准备待转换的 JavaScript 字符串
const message = "Hello, 世界!";

// 2. 实例化 TextEncoder 编码器(默认采用 UTF-8 编码规范)
const encoder = new TextEncoder();

// 3. 执行编码,得到 Uint8Array 实例
const uint8Array = encoder.encode(message);

console.log("字节数组内容:", uint8Array);
console.log("字节数组长度:", uint8Array.length);
console.log("原始字符串长度:", message.length);
// 字节数组内容: Uint8Array(14) [72, 101, 108, 108, 111, 44, 32, 228, 184, 150, 231, 149, 140, 33]
// 字节数组长度: 14
// 原始字符串长度: 10
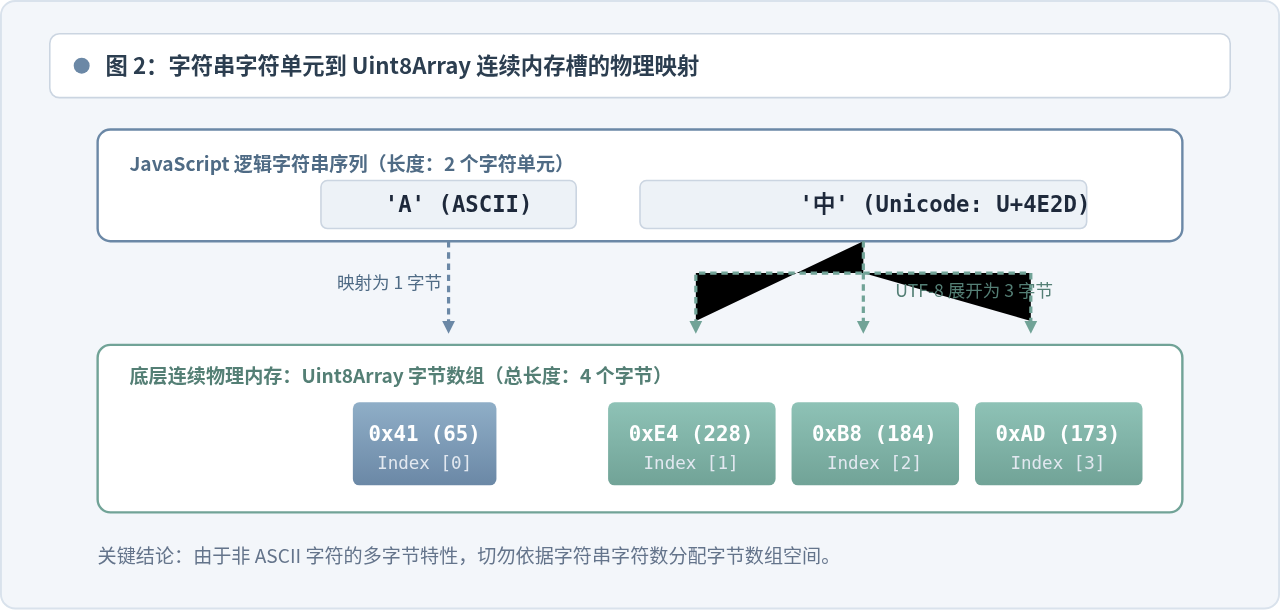
从上面的输出可以看到,原始字符串的 length 是 10,而得到的 Uint8Array 长度是 14。这是因为 TextEncoder 采用变长编码的 UTF-8 标准,英文字符与标点符号占用 1 个字节,而常用汉字(如“世”、“界”)各自占用 3 个字节。
二、编码机制与底层字节映射
理解转换过程中的字节差异,是正确使用 Uint8Array 的前提。JavaScript 的字符串在语言内部以 UTF-16 码元表示,而 TextEncoder 产生的是 UTF-8 编码字节流。
UTF-8 是一种变长字节编码规则:
- 单字节(ASCII 字符):ASCII 范围内的字符(如英文字母
A-Z、数字0-9、英文标点)占用 1 个字节(8 位)。例如'H'对应的十六进制是0x48。 - 多字节(中文汉字及复杂符号):常见汉字占用 3 个字节(如汉字
'中'编码为0xE4 0xB8 0xAD),少部分特殊符号与 Emoji 表情占用 4 个字节。
三、进阶性能方案:encodeInto 零拷贝写入已有内存
在密集调用、实时音视频包解析或网络帧组装场景中,频繁执行 encoder.encode(str) 会在堆内存中反复分配新的 Uint8Array 和底层 ArrayBuffer,这会加重浏览器的垃圾回收(GC)负担。
为了解决频繁分配问题,TextEncoder 原生提供了 encodeInto() 方法。它允许直接将字符串转码写入已经预先分配好的目标 Uint8Array 内存中,完全避免重复的堆内存申请。
encodeInto 使用示例
const encoder = new TextEncoder();
const message = "高性能转码测试";

// 预先分配一块足够容纳编码内容的内存缓冲区
// 提示:每个 UTF-8 字符最多可能占用 4 字节,安全上限通常取 message.length * 4
const buffer = new Uint8Array(64);

// 将编码结果直接写入已有 buffer,并返回处理统计信息
const result = encoder.encodeInto(message, buffer);

console.log("已读取的字符数 (read):", result.read);
console.log("实际写入的字节数 (written):", result.written);

// 获取有效内容对应的子视图(不产生内存复制)
const validData = buffer.subarray(0, result.written);
console.log("有效字节数组:", validData);
// 已读取的字符数 (read): 7
// 实际写入的字节数 (written): 21
// 有效字节数组: Uint8Array(21) [233, 171, 152, 230, 149, 136, 232, 131, 189, 232, 189, 172, 231, 160, 129, 230, 181, 139, 232, 175, 149]
如果传入 encodeInto 的目标 Uint8Array 容量不足以容纳全部内容,方法会尽量转码完整的字符单元,并在放不下下一个完整字符时安全截断。此时 result.read 将小于原字符串长度,需要通过该返回值校验是否转换完整。
四、特定场景下的转换方法与决策
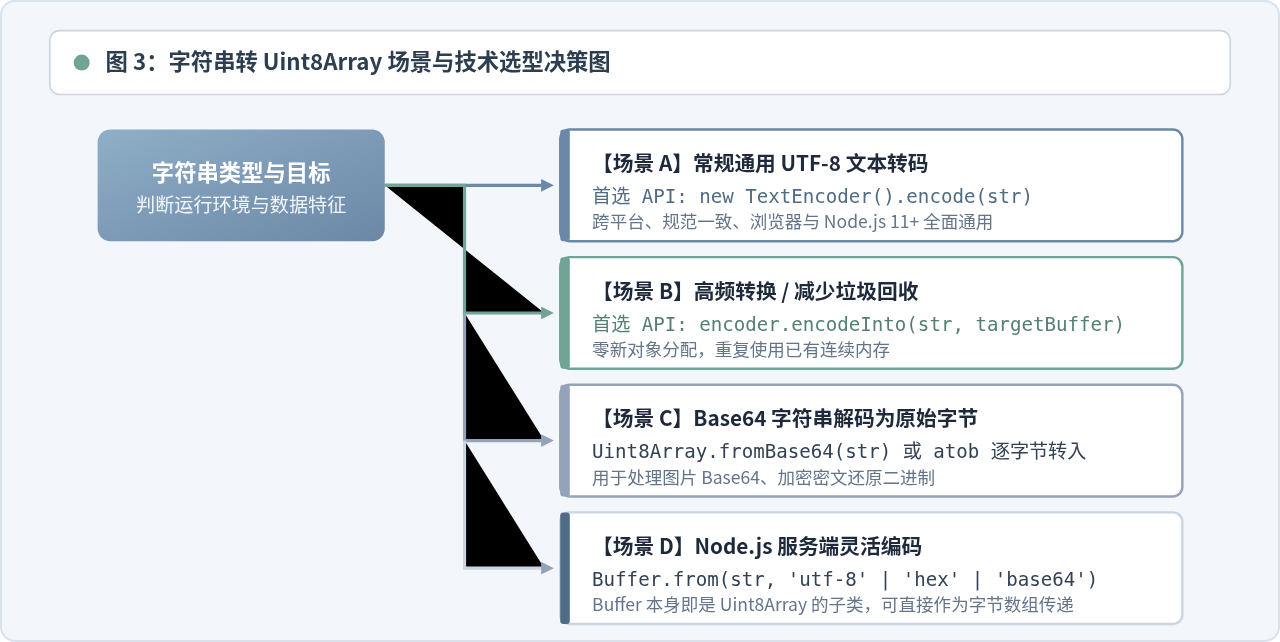
除了标准的 UTF-8 文本转换外,在实际工程中还会遇到不同运行环境或特殊编码形态(如 Base64 字符串、十六进制字符串、旧版单字节二进制串)。应根据场景选择合适的方案。
1. Node.js 环境特定做法
如果在 Node.js 服务端环境中,Node 提供的 Buffer 原型直接继承自 Uint8Array。因此通过 Buffer.from() 得到的对象本身就是 Uint8Array 实例:
// 仅限 Node.js 环境(支持指定不同编码)
const buf = Buffer.from("Node服务端文本", "utf-8");

console.log(buf instanceof Uint8Array); // 输出: true
console.log(buf);                       // 输出: <Buffer e4 bb a3 ...>
2. Base64 格式字符串还原为 Uint8Array
如果字符串本身不是普通明文,而是二进制经过 Base64 编码后的文本,使用 TextEncoder 会把 Base64 的字母本身转为 UTF-8 字节,这不符合“还原二进制”的需求。
在现代浏览器中,新标准已经逐步引入了 Uint8Array.fromBase64(base64Str)。在暂不支持该提案的环境中,可以通过 atob 函数解码为二进制字符串后填充进 Uint8Array:
function base64ToUint8Array(base64String) {
  // 解码 Base64 为 ASCII 二进制字符串
  const binaryString = atob(base64String);
  const len = binaryString.length;
  const bytes = new Uint8Array(len);

  for (let i = 0; i < len; i++) {
    bytes[i] = binaryString.charCodeAt(i);
  }
  return bytes;
}

// 示例:将 Base64 字符串转为 Uint8Array
const sampleBase64 = "SGVsbG8="; // 对应 "Hello"
const decodedBytes = base64ToUint8Array(sampleBase64);
console.log("Base64 转出字节:", decodedBytes);
// Base64 转出字节: Uint8Array(5) [72, 101, 108, 108, 111]
五、常见错误与注意事项
1. 误用 charCodeAt 直接截断非 ASCII 字符
部分旧代码会尝试通过循环调用 str.charCodeAt(i) 手动填充 Uint8Array。需要特别提醒的是:charCodeAt 返回的是 0 到 65535 的 16 位整数值。当直接赋值给 Uint8Array 成员时,系统只会保留低 8 位,高 8 位会被直接截断丢弃。
// ⚠️ 错误做法演示(会导致中文字符数据损坏):
const str = "中"; // Unicode 码点 0x4E2D (十进制 20013)
const badArray = new Uint8Array(1);
badArray[0] = str.charCodeAt(0);

console.log(badArray[0]); // 输出 45 (0x4E2D 截断高位后只剩 0x2D = 45),原数据彻底损毁!
因此,对于任何包含中文、特殊符号或非纯 ASCII 字符的常规文本,必须始终使用 TextEncoder 进行合规编码。
2. 字节数组逆转回字符串:TextDecoder
如果后续需要把生成的 Uint8Array 还原为可读的 JavaScript 字符串,成对的内置工具是 TextDecoder:
const encoder = new TextEncoder();
const decoder = new TextDecoder("utf-8");

const originalText = "数据传输闭环";
const encodedBytes = encoder.encode(originalText);

// 将 Uint8Array 重新解码还原为字符串
const restoredText = decoder.decode(encodedBytes);

console.log("还原后的文本:", restoredText); // 输出: 数据传输闭环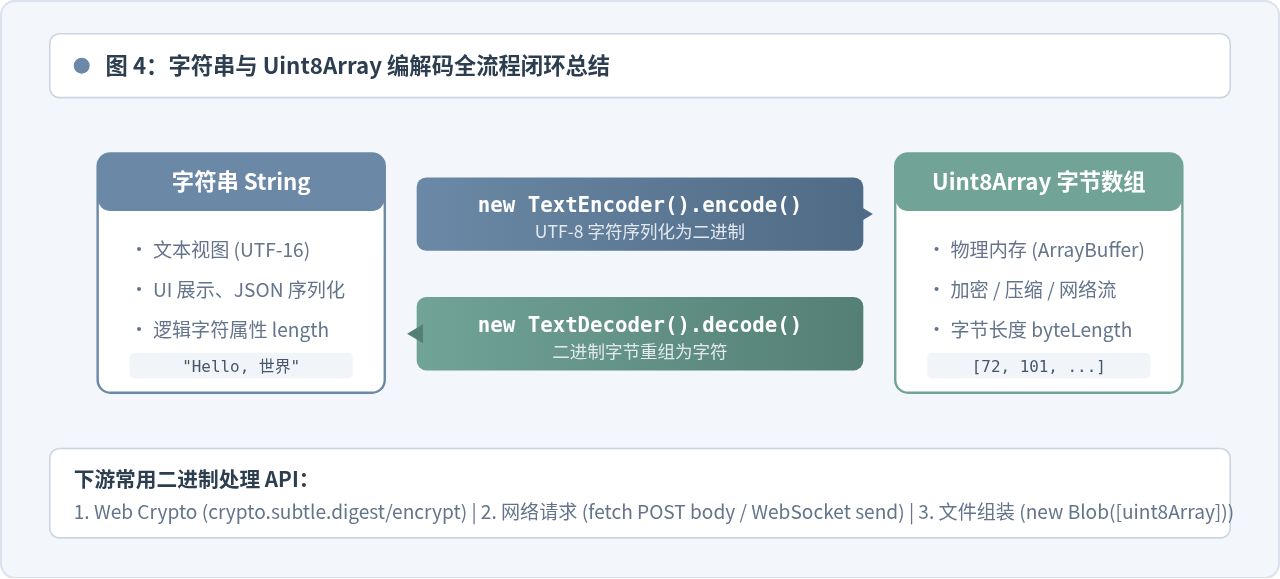
六、总结速查
| 目标需求 | 推荐方法 | 支持环境 |
|---|---|---|
| 标准 UTF-8 编码转换 | new TextEncoder().encode(str) |
现代浏览器、Node.js 11+ 全面原生支持 |
| 高频调用避免频繁 GC | encoder.encodeInto(str, buffer) |
现代浏览器、Node.js 11+ |
| Base64 字符串解码为字节 | Uint8Array.fromBase64() 或 atob |
现代浏览器标准支持 / 兼容环境 fallback |
| Node.js 服务端多格式转换 | Buffer.from(str, encoding) |
Node.js 全系列环境(自身即是 Uint8Array) |
| Uint8Array 字节数组还原为文本 | new TextDecoder().decode(bytes) |
现代浏览器、Node.js 11+ |
js字符串怎么转数组Object.keys方法
2026-11-13 21:17:14
JS数组sort()数字排序陷阱:为什么[10,5,40]会变成[10,40,5]
2026-11-13 20:10:31
JavaScript map结合filter实现数组元素所有索引查找
2026-11-13 19:42:18
JavaScript中定义函数的三种主要方式
2026-11-13 18:01:17
JS怎么实现先保留N位小数再四舍五入取整
2026-11-13 14:47:08