js字符串多行转数组每行解析JSON
全面讲解在JavaScript中将多行JSON字符串切分并逐行解析为对象数组的标准方案。深入分析跨平台换行符差异、空行过滤技巧、try-catch异常隔离机制及流式优化方案。
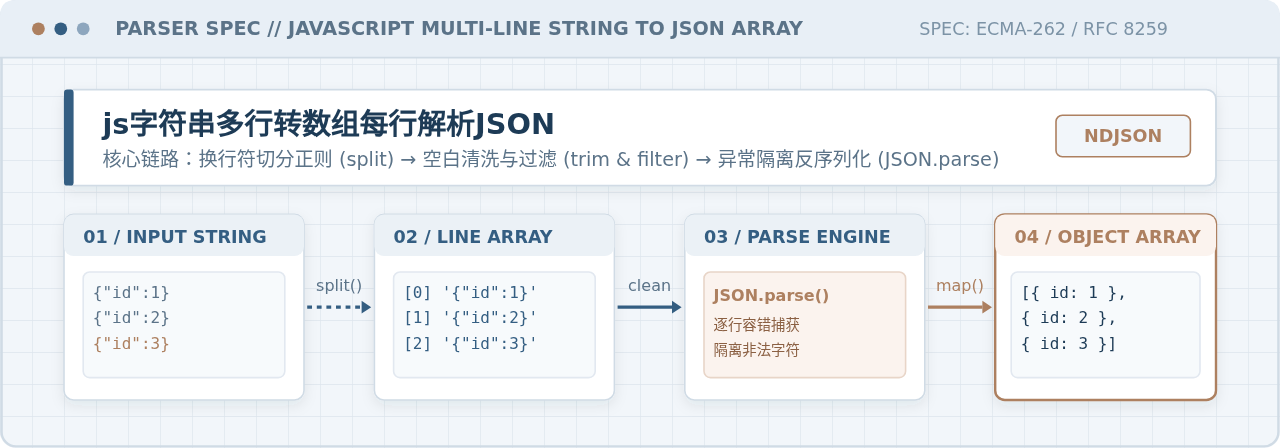
在日常开发中,多行 JSON 字符串是常见的数据传输与存储形式,常见于 NDJSON(Newline Delimited JSON / JSON Lines)、服务端分块流式日志、数据库批量导出文件以及前端文本框批量输入。将此类字符串解析为 JavaScript 对象数组的核心路径分为三步:根据系统兼容的换行符切分为行数组、清理多余首尾空白并剔除空行、使用 JSON.parse 对每行数据反序列化。根据不同可靠性要求,还需增加异常隔离防护以应对脏数据。
一、标准操作步骤与基础代码实现
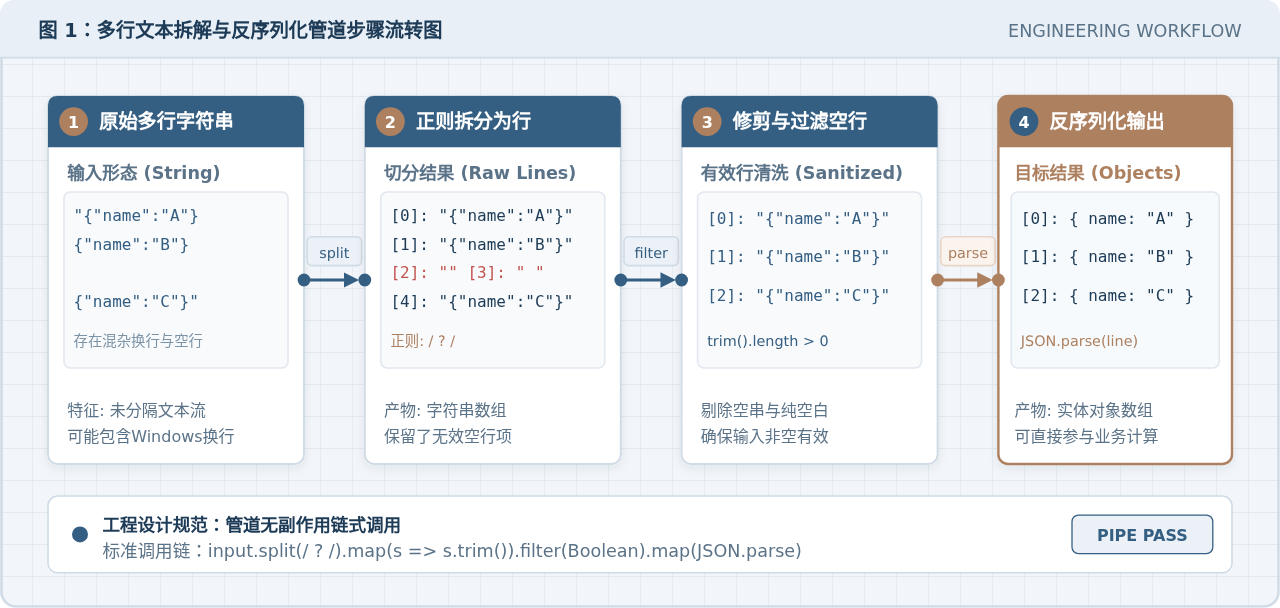
最直接的解决方式是利用 JavaScript 的数组链式方法完成从字符串到对象数组的转换。标准执行链路包含换行切分、空白修整、有效性过滤和反序列化四个环节。
1. 完整实现代码
下面是一个标准环境下的解析函数示例。该实现使用正则表达式 /
?
/ 兼容 Windows 与 Unix 换行,并通过 trim() 消除各行首尾空白。
/**
* 将多行 JSON 字符串转为对象数组
* @param {string} multilineStr 原始多行文本
* @returns {Array<object>} 解析后的对象数组
*/
function parseLinesToJSON(multilineStr) {
if (!multilineStr || typeof multilineStr !== 'string') {
return [];
}
return multilineStr
.split(/
?
/) // 步骤 1:兼容不同系统的换行切分
.map(line => line.trim()) // 步骤 2:去除每行首尾空白字符
.filter(line => line.length > 0) // 步骤 3:过滤空行及纯空白行
.map(line => JSON.parse(line)); // 步骤 4:对每一行执行反序列化
}
// 示例输入数据
const rawData = `
{"id": 101, "name": "Node-Alpha", "status": "active"}
{"id": 102, "name": "Node-Beta", "status": "idle"}
{"id": 103, "name": "Node-Gamma", "status": "active"}
`;
const result = parseLinesToJSON(rawData);
console.log(result);
2. 执行输出验证
执行上述代码后,各行文本被正确识别并转化为标准的 JavaScript 对象列表:
[
{ id: 101, name: 'Node-Alpha', status: 'active' },
{ id: 102, name: 'Node-Beta', status: 'idle' },
{ id: 103, name: 'Node-Gamma', status: 'active' }
]二、换行符差异与边界空行过滤
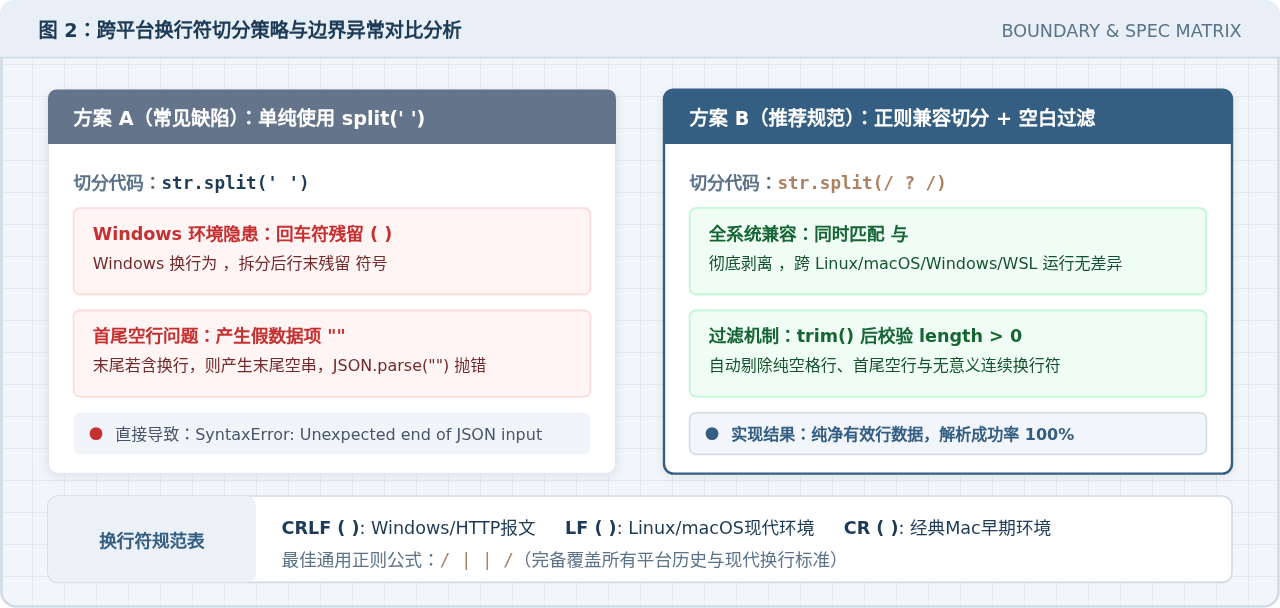
在跨平台场景或用户自行粘贴文本的输入框中,换行符的类型往往并不单一。如果不加以区分直接使用字符串字面量切分,极易在解析阶段诱发隐蔽的语法错误。
1. 跨平台换行符隐患分析
- Unix / Linux / macOS:采用
split(' ')切分能够正常分离。 - Windows / HTTP 协议头:采用
- 旧版 Mac 系统或特定日志工具:可能仅包含
split(' ')完全无法切开字符串,导致整篇多行文本被当作一行送入JSON.parse,直接抛出SyntaxError。
生产环境中建议统一采用 str.split(/
|
|
/) 或 str.split(/
?
/)。该正则能完备吸收并剔除各类换行符,避免回车符污染数据。
2. 边界空行与纯空格行
多行字符串在首尾经常带有由模板字符串缩进或文件末尾空行产生的多余字符。例如:
// 原始文本末尾常带有换行
const textWithTrailing = '{"a":1}
{"b":2}
';
// 错误示范:未经过滤直接解析
textWithTrailing.split('
').map(JSON.parse);
// 结果:第三项为 "",抛出 SyntaxError: Unexpected end of JSON input
因此,在执行 JSON.parse 之前,必须执行 .map(line => line.trim()).filter(line => line.length > 0),或者采用简写 .map(s => s.trim()).filter(Boolean),彻底剔除首尾空行、多余回车以及由连续换行符产生的假空项。
三、工业级容错解析与异常隔离
在真实业务环境中,外部输入或网络传输的日志数据并不总是 100% 结构合规的。如果其中某一行存在残缺、单引号使用不当、缺少闭合括号或包含非 JSON 格式的调试信息,默认的 JSON.parse 会立即中断执行并抛出异常,导致整批正常数据全部丢失。
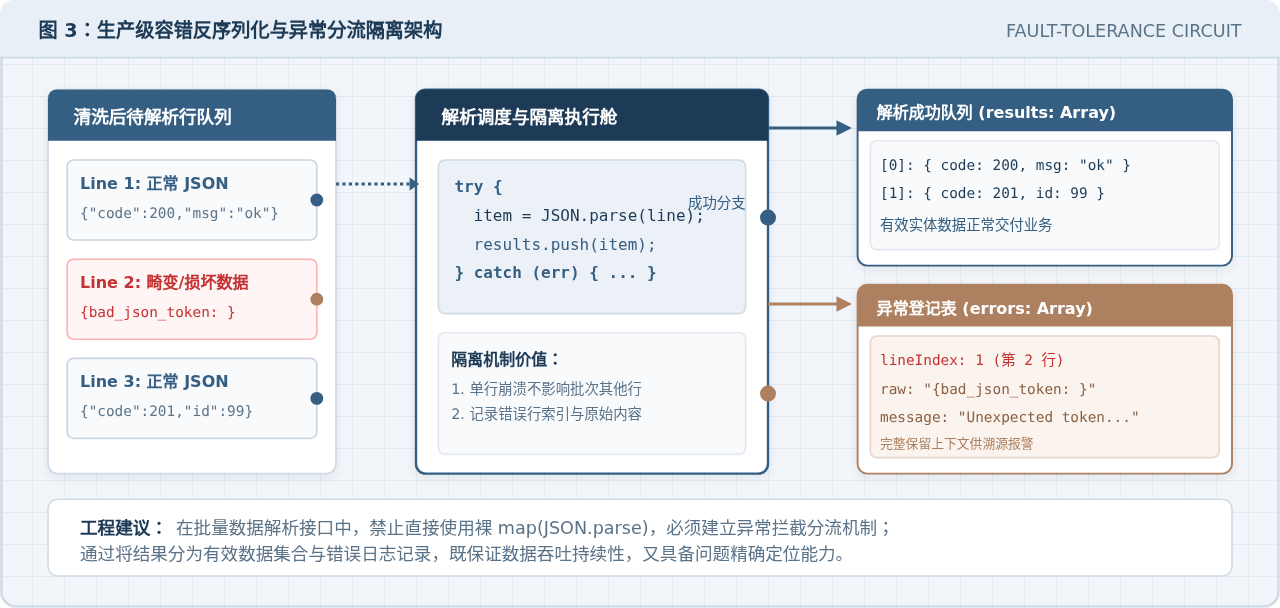
1. 异常分流实现机制
高可用设计的核心在于异常隔离:通过 try...catch 将单行的解析行为包裹起来。成功的结果进入交付队列,失败的行则提取行号、原始内容与错误信息存入异常登记表,从而兼顾数据吞吐与问题追踪。
/**
* 健壮的多行 JSON 解析函数(具备异常隔离与错误报告能力)
* @param {string} multilineStr 待解析的多行字符串
* @returns {{ results: Array<any>, errors: Array<{ lineIndex: number, raw: string, message: string }> }}
*/
function safeParseLines(multilineStr) {
const results = [];
const errors = [];
if (typeof multilineStr !== 'string') {
return { results, errors };
}
const lines = multilineStr.split(/
?
/);
lines.forEach((rawLine, index) => {
const line = rawLine.trim();
if (!line) return; // 跳过空行
try {
const parsed = JSON.parse(line);
results.push(parsed);
} catch (err) {
errors.push({
lineIndex: index + 1, // 记录实际人类可读的行号
raw: line,
message: err.message
});
}
});
return { results, errors };
}2. 容错测试用例
const dirtyBatch = `
{"event": "login", "uid": 1001}
INVALID_LINE_PAYLOAD_HERE
{'event': 'click', 'uid': 1002}
{"event": "logout", "uid": 1001}
`;
const parseOutcome = safeParseLines(dirtyBatch);
console.log("解析成功项数:", parseOutcome.results.length);
console.log("错误记录列表:", parseOutcome.errors);
执行输出展示了明确的分流效果:
解析成功项数: 2
错误记录列表: [
{
lineIndex: 3,
raw: 'INVALID_LINE_PAYLOAD_HERE',
message: 'Unexpected token I in JSON at position 0'
},
{
lineIndex: 4,
raw: "{'event': 'click', 'uid': 1002}",
message: "Unexpected token ' in JSON at position 1"
}
]测试结果表明,即使第 3 行存在无效语法、第 4 行使用了非法单引号,第 2 行和第 5 行的标准 JSON 仍被完整提取,同时开发者可精准定位出错位置。
四、大数据量场景下的内存优化(惰性流式迭代)
当面对几十兆甚至数百兆的多行文本(例如由 fetch 或本地上传的离线日志文件)时,直接调用 split() 会在内存中一次性分配庞大的行数组对象,造成瞬间内存峰值(Memory Spike),在前端容易引发页面卡顿,在 Node.js 中可能触及堆内存上限。
利用 ES6 生成器函数(Generator)配合正则表达式的 exec() 游标推进,可以在不分配全局行数组的前提下,实现边匹配、边解析、边消耗的常数级内存迭代。
/**
* 惰性生成器:逐行匹配并解析 JSON
* @param {string} text 庞大文本流
* @yields {any} 单个解析后的 JSON 对象
*/
function* iterateJSONLines(text) {
if (!text) return;
// 匹配非换行内容的单行正则
const lineRegex = /^[^
]+/gm;
let match;
while ((match = lineRegex.exec(text)) !== null) {
const line = match[0].trim();
if (!line) continue;
try {
yield JSON.parse(line);
} catch (err) {
console.warn("跳过无法解析的行:", line, err.message);
}
}
}
// 使用示例:按需消费,支持随时 break 退出
for (const item of iterateJSONLines(largeText)) {
if (item.id === targetId) {
console.log("找到目标对象,提前终止迭代:", item);
break; // 无需遍历后续行,极大节省计算资源
}
}五、方案选型与技术总结
在处理“js字符串多行转数组每行解析JSON”的任务时,需根据数据规模与可靠性要求进行合理的技术选型:
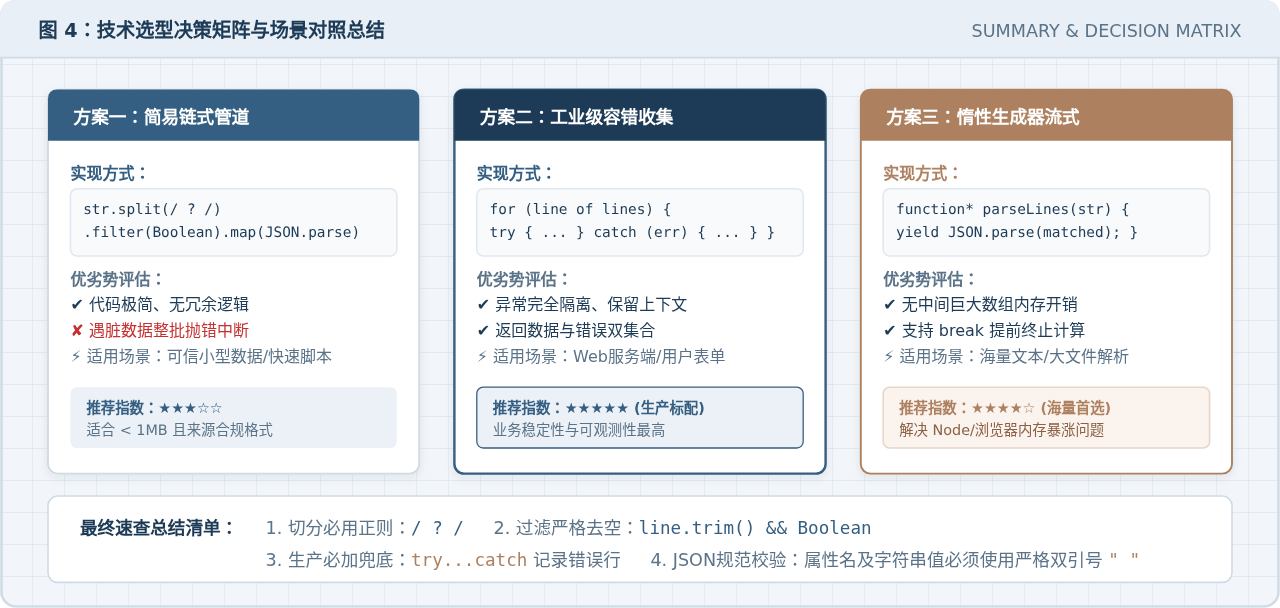
| 选型方案 | 实现手段 | 适用规模 | 容错性 | 推荐业务场景 |
|---|---|---|---|---|
| 链式极简方案 | split + filter + map |
小型文本 (< 1MB) | 无(遇错中断) | 单元测试、格式可信的本地配置文件、演示 Demo |
| 健壮容错方案 | for...of + try...catch |
中型文本 (1MB ~ 50MB) | 高(异常隔离记录) | 生产级 Web 接口、表单批量粘贴、日志查询控制台 |
| 惰性生成器方案 | Generator + RegExp.exec |
大型文本 (> 50MB) | 高(按需产出) | 大文件离线分析、长文本流式查找、内存敏感型服务 |
解析避坑核对清单
- 双引号硬性规范:标准 JSON 要求属性名与字符串值必须由英文双引号
"包裹,JavaScript 对象字面量常用的单引号'会直接导致JSON.parse报错。 - 换行符剥离干净:始终优先使用正则
/ ? /替代单一字符' ',防止 Windows 回车符 - 严格去除前后空格:在校验空行之前务必调用
trim(),避免包含单个空格的“假空行”漏网进入反序列化环节。
js字符串转数组哪种方法最推荐
2026-11-13 19:59:01
vue字符串怎么转数组v-for渲染
2026-11-13 19:25:47
useEffect依赖数组漏写会有什么后果?怎么用ESLint拦住?
2026-11-13 19:12:59
Gemini 4 Carbon如何用JavaScript进行长输出并读取完整文本
2026-11-13 19:01:34
js字符串转数组URL编码decodeURIComponent
2026-11-13 17:51:20