js字符串转数组split空分隔符和正则区别
深入解析 JavaScript 中 String.prototype.split('') 空字符串分隔符与正则表达式分割的本质区别。从 UTF-16 内存编码、代理对撕裂、正则捕获组注入机制到引擎执行性能与选型决策,全面掌握字符串转数组的核心技巧。
在 JavaScript 开发中,使用 split('') 将字符串逐字打碎成数组是极常见的写法。但很多人在接触到复杂字符、多模式切分或正则表达式进阶使用时,会发现空字符串分隔符 '' 与正则表达式之间不仅是“字符匹配与模式匹配”的区别,更涉及 UTF-16 代码单元与 Unicode 码点识别、正则捕获组(Capturing Groups)注入数组 以及 V8 引擎执行路径与边界匹配 等本质差异。本文将从底层机制、运行表现、边界细节到实际选型,全面拆解这两者的区别与工程实践。
一、核心机制:代码单元遍历 vs 状态机模式匹配
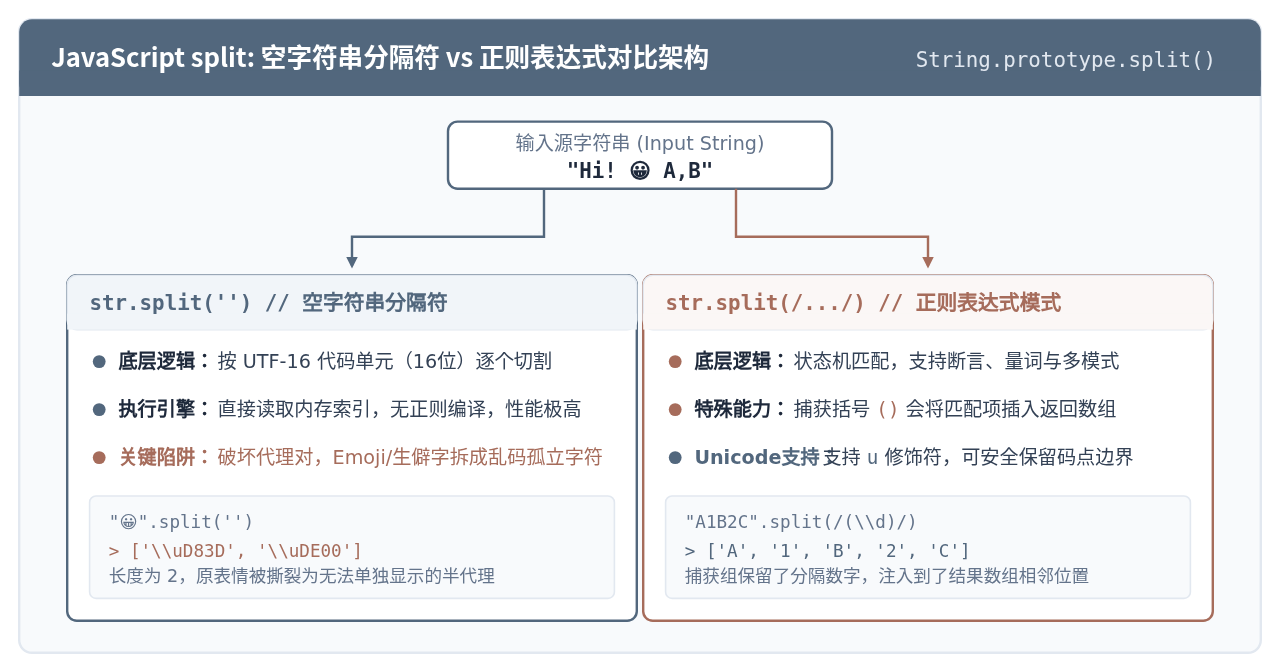
String.prototype.split(separator, limit) 的核心功能是按照传入的 separator 找到切分点,并截取子字符串填充为新数组。看似统一的 API,在传入空字符串 '' 与传入正则表达式时,底层走的是截然不同的解析路径:
-
空字符串分隔符
split(''): 底层是基于字符在内存中的原始 UTF-16 代码单元(Code Unit)。它在索引0到str.length之间按步长 1 机械切分,不经过任何模式语法编译,执行路径最直接,但也正因如此,它完全没有对复杂字符编码的语义感知能力。 -
正则表达式分隔符
split(/pattern/): 会调用 ECMAScript 规范规定的 RegExp 切分算法。引擎先将规则编译为有限状态机(DFA/NFA),在字符串中搜索符合断言、字符集或量词的边界。正则表达式还支持修饰符(如u、v、i)以及至关重要的捕获组特性。
二、致命缺陷:为什么 split('') 会拆碎 Emoji 与生僻字?
JavaScript 的字符串在底层使用 UTF-16 编码。常见的 ASCII 码和大部分常用汉字位于“基本多语言平面”(BMP),占用 16 位(1 个代码单元)。然而,现代互联网中随处可见的 Emoji 表情符号(如 🍎、😄、🎉)以及中文古籍生僻字(如“𠮷”),码点均超过了 0xFFFF,在 UTF-16 中必须由两个代码单元(高位代理 + 低位代理,Surrogate Pair)组合表示。
当执行 split('') 时,JavaScript 会粗暴地在这两个代理对中间切下一刀:
const emoji = '🍎';
console.log(emoji.length); // 2(占2个代码单元)

const badArray = emoji.split('');
console.log(badArray);
// 示例输出: ['\uD83C', '\uDF4E']
console.log(badArray.length); // 2
console.log(badArray[0]); // 乱码或无效方块:
原本是一个完整的苹果 Emoji,经 split('') 切分后变成了两个非法的单独半代理。如果对这个数组执行 .reverse() 翻转并 .join(''),字符数据将被不可逆地损坏。
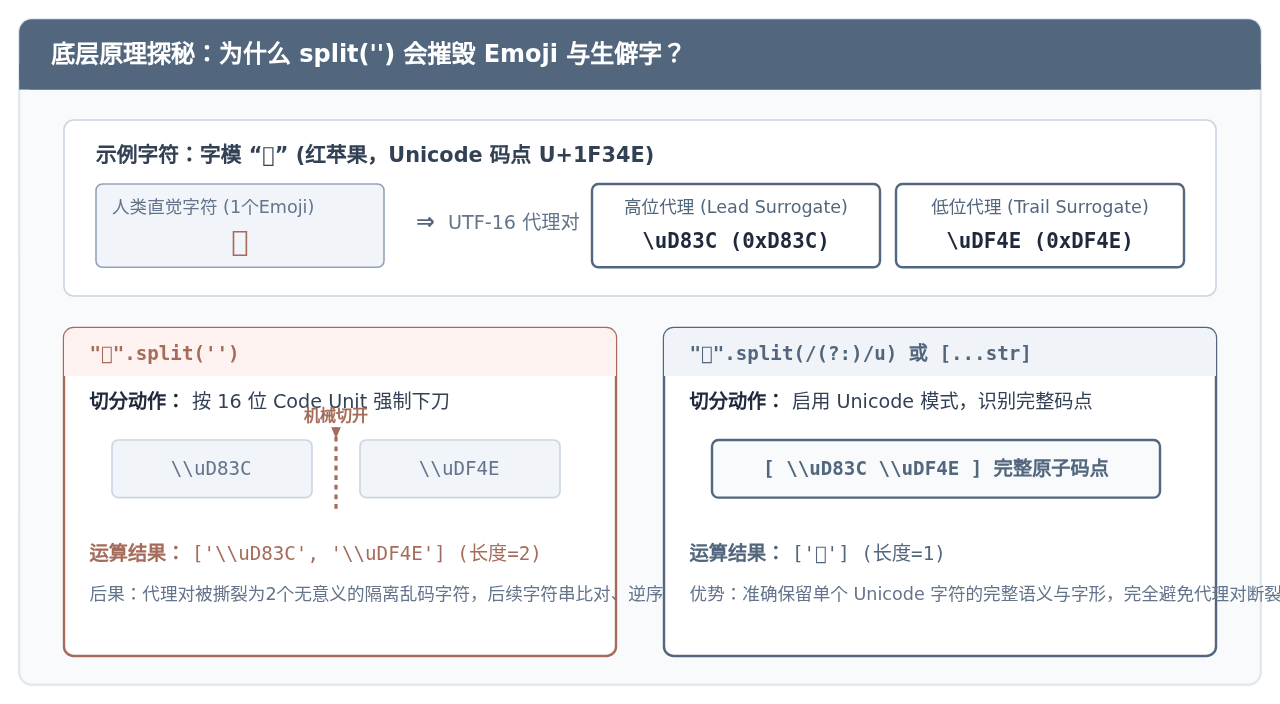
相比之下,若使用带有 Unicode 修饰符的正则表达式,或者现代 ES6 方案,就能准确识别合法的字符码点边界:
// 方案 A:使用带 Unicode 标志的空匹配正则
const safeReg = emoji.split(/(?:)/u);
console.log(safeReg); // ['🍎'](长度为 1,语义完整)

// 方案 B:使用展开运算符(现代 JavaScript 最佳实践)
const spreadArr = [...emoji];
console.log(spreadArr); // ['🍎']
三、正则独门绝技:捕获组注入与保留分隔符
字符串分隔符 split(',') 会彻底抹除切分标志。但在很多文本解析与词法分词场景中,我们既需要将文本切散,又需要保留分隔符本身(例如解析数学公式 1+2*3 或 Markdown 语法)。
这是正则表达式与字符串参数之间最具杀伤力的功能性区别:当正则表达式包含圆括号捕获组 () 时,被捕获的分隔内容会被直接拼接插入到返回的数组中!
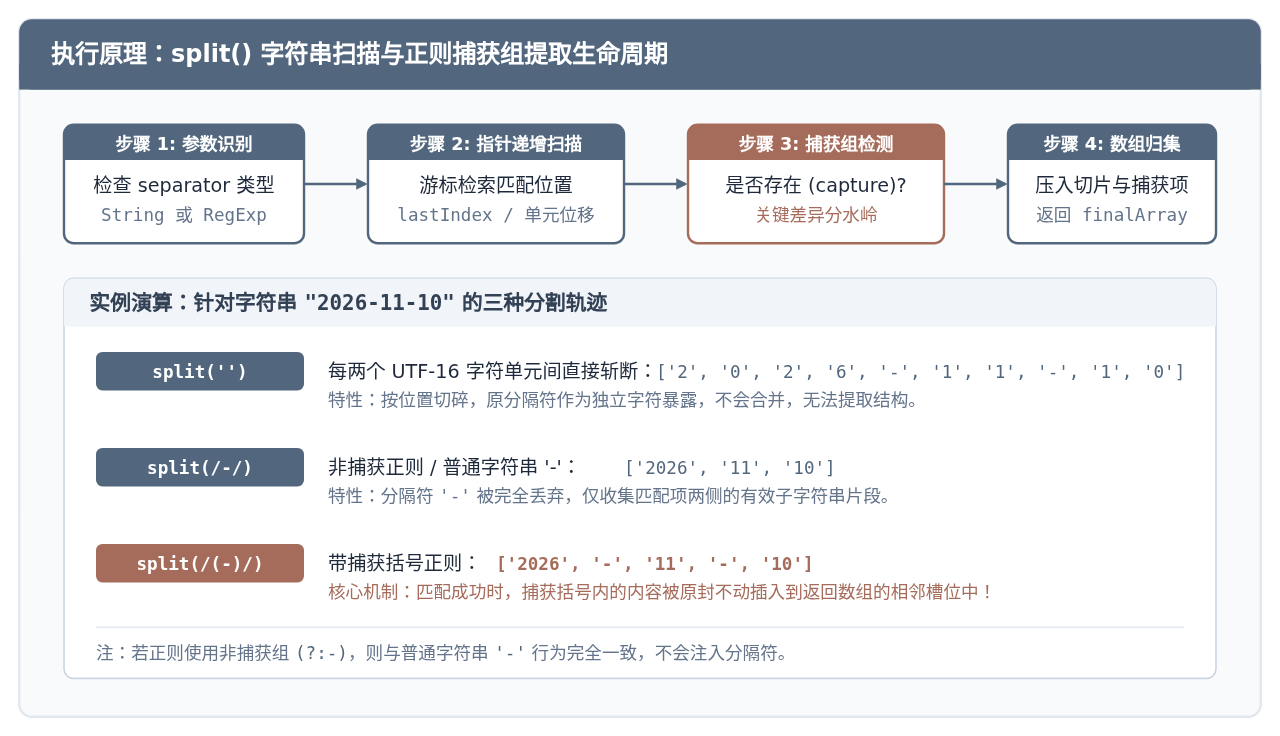
代码对比:非捕获与捕获的数组结构演变
const formula = "2026-11-10";

// 1. 普通字符串切分:分隔符被完全丢弃
formula.split('-');
// > ['2026', '11', '10']

// 2. 正则非捕获组 (?:):同样丢弃分隔符
formula.split(/(?:-)/);
// > ['2026', '11', '10']

// 3. 正则捕获组 ():分隔符保留并依序注入数组相邻槽位!
formula.split(/(-)/);
// > ['2026', '-', '11', '-', '10']undefined。如果你的初衷只是想把多个条件用括号归拢组合(例如 /(
|
)/),请务必在括号起始处添加 ?: 声明为非捕获组,否则数组中会凭空多出一倍的分隔符元素。
四、边界情况深度分析:空字符串与首尾匹配
在处理极端输入或边界情况时,split('') 与正则切分也展现出了微妙但必须注意的行为差异。
1. 对空字符串 "" 进行切分
// 空字符串使用 '' 切分
"".split('');       // > [](返回空数组)

// 空字符串使用任意非空正则切分
"".split(/,/);      // > [""](包含一个空字符串元素的数组)

// 空字符串使用空正则切分
"".split(/(?:)/);   // > [](ES2015 规范对齐后返回空数组)
当对空字符串使用具体字符(如 "".split(','))切分时,返回的是 [""] 而不是空数组。这是许多初学者在数据清洗中容易忽视的空指针或误判隐患。
2. 首尾零宽匹配与多余空串
当使用正则表达式匹配字符串开头或结尾的模式时,如果模式恰好匹配到了字符串两端,数组的首位或末位会生成空字符串 "":
const raw = ",A,B,";
raw.split(/,/);
// > ['', 'A', 'B', '']
而 str.split('') 在处理常规非空字符串时,两端不会产生多余的 "",因为空字符串分隔符的定义是在字符与字符之间的空隙下刀,字符串首字符之前和末字符之后的位置并不会被额外计入切分产生多余项。
五、性能开销:V8 引擎内部的快慢路径
在性能敏感的高吞吐场景(如日志分析或前端批量文本渲染)下,这两种调用的开销存在量级差距:
-
split('')的快路径(Fast Path): 在 Chrome 的 V8 或 Node.js 引擎中,当检测到分隔符为单字节或已知空字符串且不涉及 RegExp 时,引擎会跳过正则解释器,直接分配连续数组内存,通过 C++ 层面的内存拷贝(memcpy 或指针递增)批量构建 JSArray,耗时极短。 -
split(/.../)的通用路径: 引擎必须解析正则语法树、分配捕获状态追踪缓存区,并在每一次匹配推进时维护lastIndex与零宽前进保护机制(避免零宽死循环)。如果包含捕获组,频繁触发的数组扩容与元素重排会带来显著的 CPU 和垃圾回收(GC)压力。
六、现代选型方案与替代实践
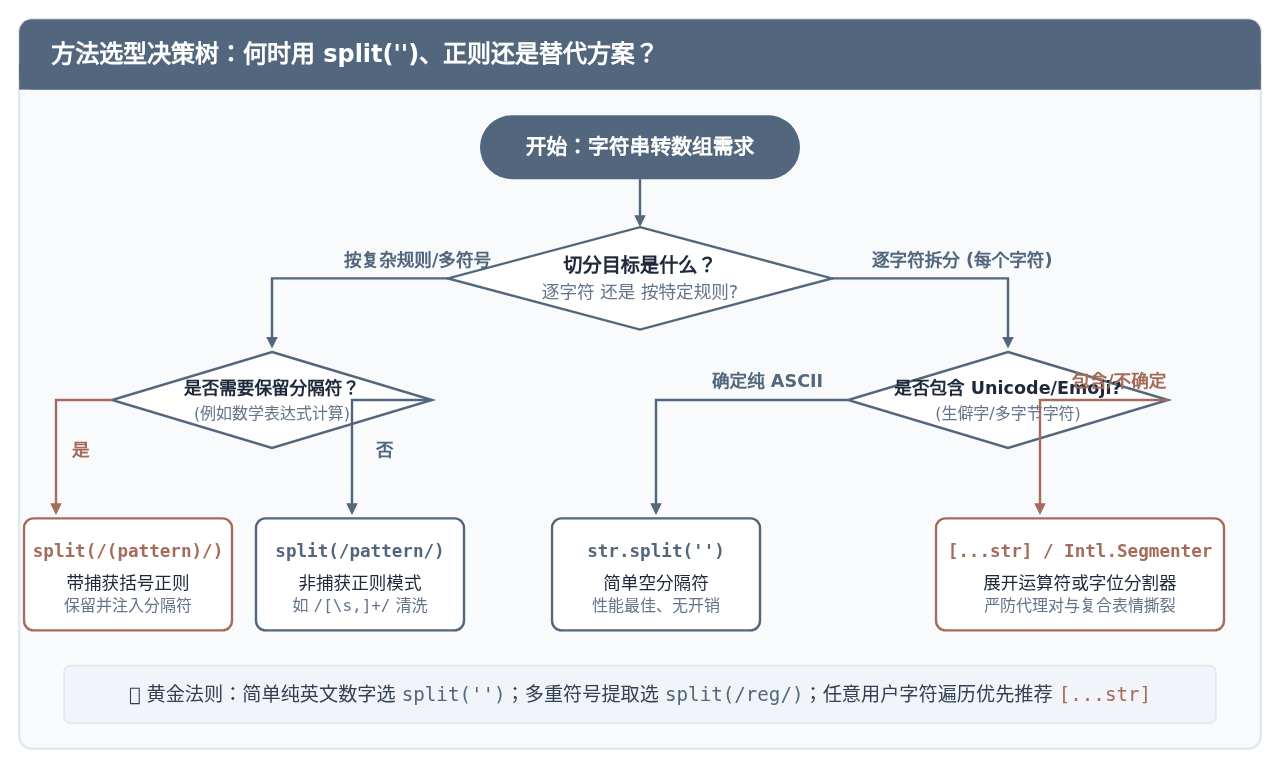
在实际生产环境中,面对将字符串转换为数组的需求,我们应当根据数据安全性和业务目的选用最合适的方式:
1. 仅限纯 ASCII 的英数字串,追求吞吐性能
如果你处理的是哈希串、UUID、内部固定协议码,完全确信不包含任何中文、生僻字或表情符号,使用 str.split('') 是最直接且性能最高的方法。
2. 通用用户文本拆分字符(防表情乱码)
如果文本来源于用户输入、聊天记录或网页内容,强烈不建议使用 str.split('')。请优先使用 ES6 展开运算符或 Array.from:
// 推荐:优雅且完全兼容单码点 Unicode
const chars = [...userString];

// 或者是:
const chars = Array.from(userString);
3. 复杂复合表情符号(如 👨👩👧 连字簇)
值得强调的是,即使是 [...str],在面对由“零宽连字”(ZWJ, Zero Width Joiner)组合而成的复杂家庭 Emoji 时,也只能拆到“码点”级别,无法感知“字位簇(Grapheme Cluster)”。如果需要按人类直觉上的“一个可视字符”完整切分,应使用现代标准的 Intl.Segmenter:
const family = '👨👩👧';
// [...family] 仍会被拆为多个码点与 ZWJ 符号
console.log([...family].length); // 5
// 正确做法:使用国际化分词器(按字位拆分)
const segmenter = new Intl.Segmenter('zh-CN', { granularity: 'grapheme' });
const graphemes = Array.from(segmenter.segment(family), s => s.segment);
console.log(graphemes); // ['👨👩👧'](长度为 1,完全符合视觉直觉)七、总结速查
为方便在日常开发中随时翻阅,下表全面汇总了 split('')、空正则、普通正则与现代迭代器各维度的核心特性:
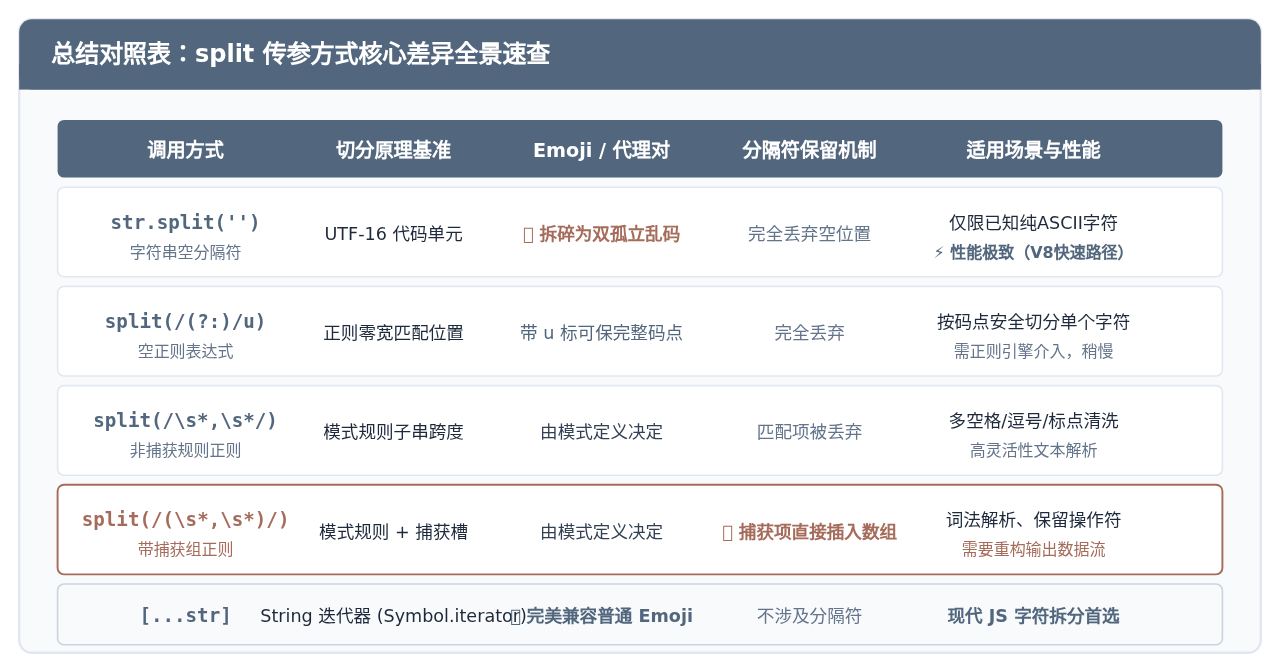
简而言之:split('') 适合无 Unicode 隐患的极端高性能场景;遇到多符号与清洗匹配用 split(/pattern/);需要保留切分标记时巧妙利用正则捕获组;而涉及到真正安全地遍历用户可见字符时,展开运算符 [...str] 与 Intl.Segmenter 才是现代前端与 Node.js 时代更稳健的答案。
JS通过修改length截断或扩展数组的行为解析
2026-11-13 16:38:41
js字符串怎么把句子转单词数组split空格
2026-11-13 16:34:45
js字符串用正则提取数字转数组
2026-11-13 16:28:24
js字符串转数组split和Array.from性能哪个快
2026-11-13 15:40:24
js字符串JSON数组转数组JSON.parse报错解决
2026-11-13 15:30:11