js字符串JSON数组转数组JSON.parse报错解决
针对JavaScript中使用JSON.parse将字符串JSON数组解析为数组时出现的SyntaxError报错,深入分析单引号、尾随逗号、未定义值、双重序列化等常见根因,并提供标准排查步骤、修复方案与工业级防御性安全解析实现。
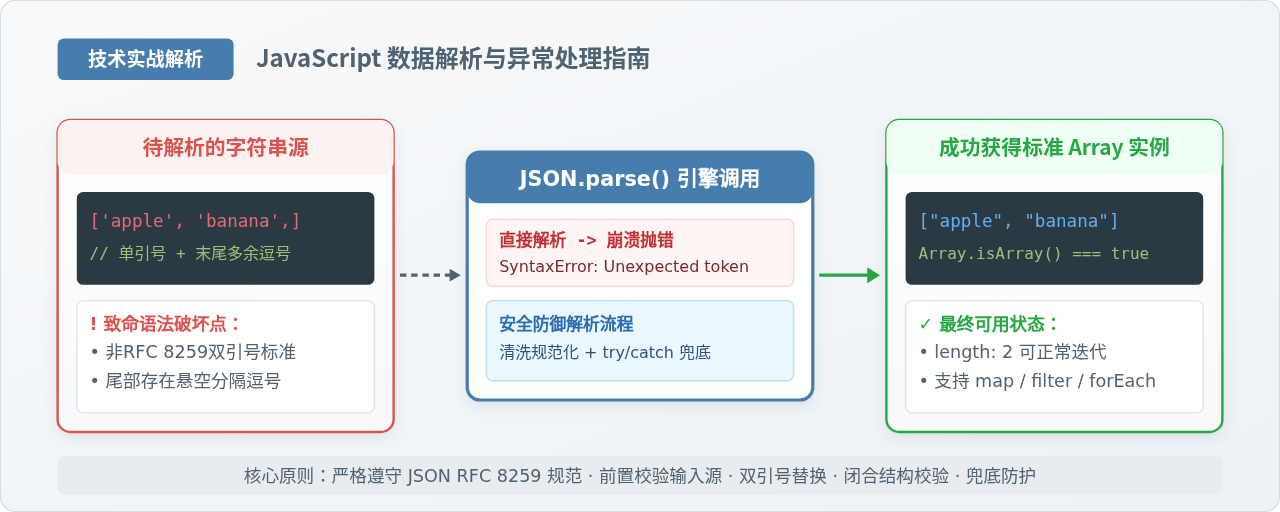
JSON.parse() 解析表示数组的字符串时,只要抛出 SyntaxError: Unexpected token... 报错,其本质原因只有一个——待解析的字符串并未严格遵守 RFC 8259 规范。最常见的诱因包括:字符串内部错误使用了单引号包裹元素、数组末尾残留了多余逗号、传入了未加引号的 undefined 或 [object Object],以及数据在网络传输中被重复序列化导致出现多余的转义反斜杠。解决这一问题的有效路径是:先提取报错信息的字符索引锁定破坏点,再实施针对性清洗修复,最后用带类型校验的防御性函数进行安全兜底。
一、常见报错形态与错误定位特征
JavaScript 引擎内置的 JSON.parse() 是一个严格语法的有限状态机解析器,与宽容的 eval() 或 JavaScript 对象字面量语法完全不同。当解析器遇到第一个不符合规范的字符时,会立即终止解析并抛出原生异常。在日常开发中,主要表现为以下三种典型报错:
-
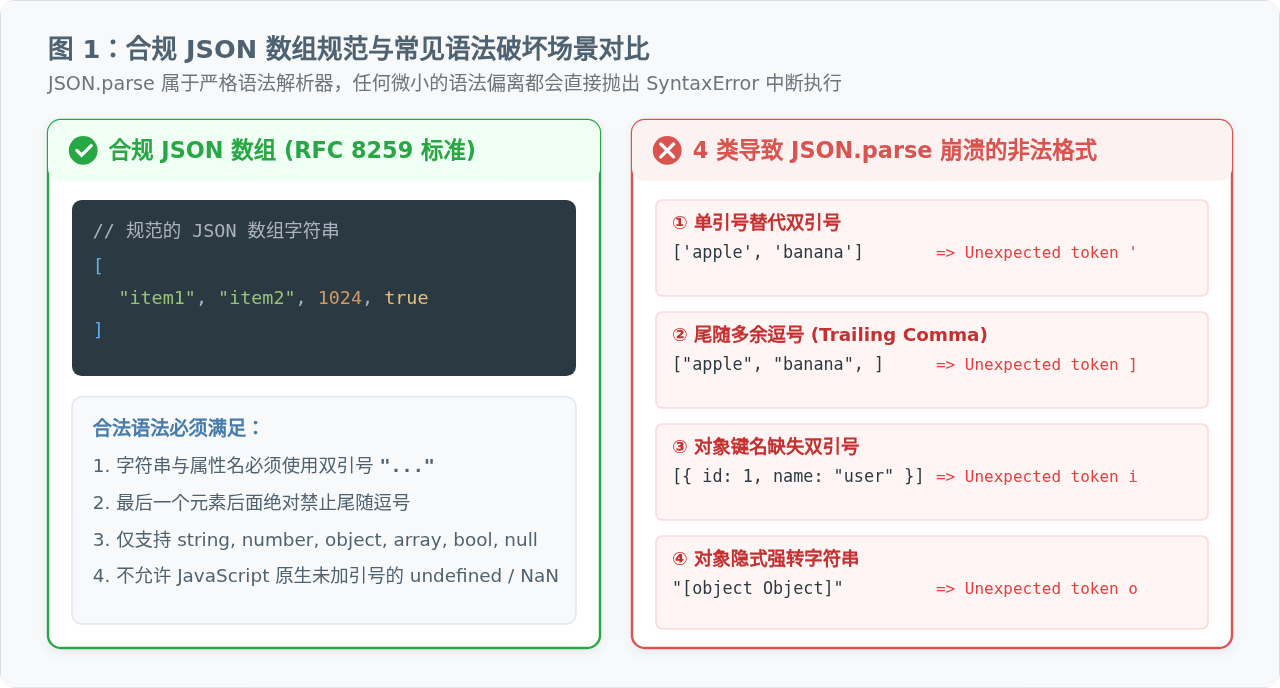
SyntaxError: Unexpected token ' in JSON at position 1:在解析以['a', 'b']这类单引号构成的字符串时出现,位置 1 对应的正是开头的单引号。 -
SyntaxError: Unexpected token ] in JSON at position ...:通常由数组最后一个元素后面的尾随逗号(Trailing Comma)引起,解析器读到逗号后期望下一个数据项,却直接读取到了闭合中括号]。 -
SyntaxError: Unexpected token o in JSON at position 1:极其隐蔽却非常高频的报错。通常是因为开发者误将一个已经是 Object 的变量通过模板字符串或隐式类型转换成了"[object Object]",其位置 1 对应的字符正是字母o。
二、导致 JSON.parse 崩溃的五大根因剖析与修复示例
1. 混淆了 JS 对象字面量与严格 JSON 规范(单引号问题)
在纯 JavaScript 代码中,编写 ['苹果', '香蕉'] 是完全合法的数组字面量写法;但当这一内容作为字符串存放在本地存储(localStorage)或由某些后端返回时,如果它保持单引号形式,JSON.parse("['苹果', '香蕉']") 就会瞬间崩溃。JSON 标准强制要求:所有字符串值及对象的键名都必须使用标准的半角双引号 "。
// ❌ 错误示范:内部包含单引号
const badStr = "['apple', 'banana', 'orange']";
// JSON.parse(badStr); // 抛出 SyntaxError: Unexpected token ' in JSON at position 1

//  正确修复方案:确保内部为严格双引号
const validStr = '["apple", "banana", "orange"]';
const arr = JSON.parse(validStr);
console.log(arr.length); // 3 (正确获得 Array 实例)
2. 末尾多余的尾随逗号 (Trailing Comma)
在现代 ECMAScript 语法中,数组或对象的最后一个元素后添加逗号是合法的,但在严格 JSON 规范中,尾随逗号是绝对违规的语法。例如 ["a", "b",] 会使解析器在逗号后处于等待元素状态,遇到右括号 ] 立即触发语法中断。
// ❌ 错误示范:数组末尾有悬空逗号
const trailingStr = '["vue", "react", "angular", ]';

//  修复方法:通过正则表达式剥离闭合括号前的多余逗号
const fixedStr = trailingStr.replace(/,\s*\]/g, ']');
const techStack = JSON.parse(fixedStr);
console.log(techStack); // ["vue", "react", "angular"]
3. 变量未初始化或被隐式转成了字符串 "[object Object]"
当从接口解构参数或读取 LocalStorage 时,若键不存在,返回值可能是 null 或 undefined。如果未做前置判断直接执行 JSON.parse(localStorage.getItem('user_tags')),当值为 null 时虽然会返回 null,但如果是未定义的字符串 "undefined",解析器将直接抛错 Unexpected token u in JSON at position 0。更严重的是,若之前代码执行了 localStorage.setItem('tags', obj),浏览器会将对象强制转为 "[object Object]",再次解析必然报错。
// ❌ 错误示范:解析了非法空值或强转对象
// JSON.parse(undefined); // 报错
// JSON.parse("[object Object]"); // 报 Unexpected token o at position 1

//  规范化防御:
function parseStorageArray(key) {
  const raw = localStorage.getItem(key);
  // 必须确保 raw 为真实有效字符串,且以 '[' 开头、以 ']' 结尾
  if (typeof raw !== 'string' || !raw.trim().startsWith('[') || !raw.trim().endsWith(']')) {
    return []; // 安全回退为默认空数组
  }
  return JSON.parse(raw);
}
4. 双重序列化(Double-Stringified)与深层转义字符串
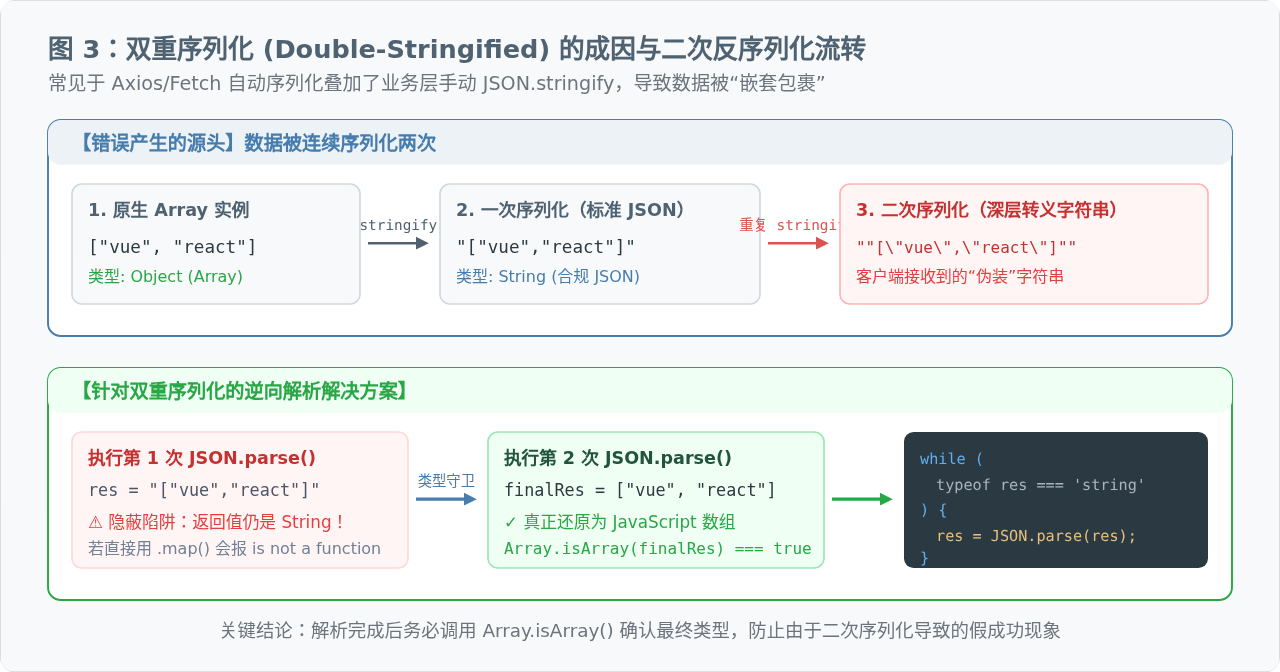
在全栈协作场景中,经常出现前端使用 Axios 发起请求(默认自动执行 JSON.stringify),而开发者在传递前又手动执行了一次 JSON.stringify()。到达接收端后,字符串变成了带有大量反斜杠转义的外层字符串(形如 ""[\"a\",\"b\"]"")。
此时如果只调用一次 JSON.parse(),程序不会报错,但解析出来的结果却依然是一个 string,而非预期的 Array。后续执行 arr.map(...) 便会直接抛出 TypeError: arr.map is not a function。而在某些转义符不平衡的场景下,第一次解析就会直接抛出语法异常。
// 示例:模拟后端或第三方库双重序列化后的数据
const doubleEncoded = JSON.stringify(JSON.stringify(["A", "B", "C"]));
console.log("原始字符串表现:", doubleEncoded);
// 输出: ""["A","B","C"]""

//  正确处理双重反序列化方案:
let result = doubleEncoded;
try {
  // 循环解包,直到结果不再是 string 类型
  while (typeof result === 'string') {
    result = JSON.parse(result);
  }
} catch (e) {
  result = []; // 异常回退
}

if (Array.isArray(result)) {
  console.log("最终成功获得数组:", result); // ["A", "B", "C"]
}
5. 包含不可见的 Unicode 字符或 UTF-8 BOM 头
在从 Windows 记事本、部分 CSV 导出工具或某些后端服务读取 JSON 数据时,文本开头可能携带十六进制编码为 0xEF 0xBB 0xBF(Unicode )的 BOM 签名。虽然在控制台打印时该字符完全不可见,但 JSON.parse() 无法识别该标记,会报出 Unexpected token at position 0。
//  去除 UTF-8 BOM 头的高效处理函数
function stripBOM(str) {
  if (typeof str === 'string' && str.charCodeAt(0) === 0xFEFF) {
    return str.slice(1);
  }
  return str;
}

const rawFromCsv = "["北京", "上海"]";
const cleanStr = stripBOM(rawFromCsv);
console.log(JSON.parse(cleanStr)); // ["北京", "上海"]
三、标准排查定位流程(4 步实操排错法)
遇到线上或测试环境的 JSON 解析报错时,不要盲目通过 replace() 胡乱替换字符。按照下方展示的标准排查步骤,可以在数秒内精准定位问题根因并完成修复。
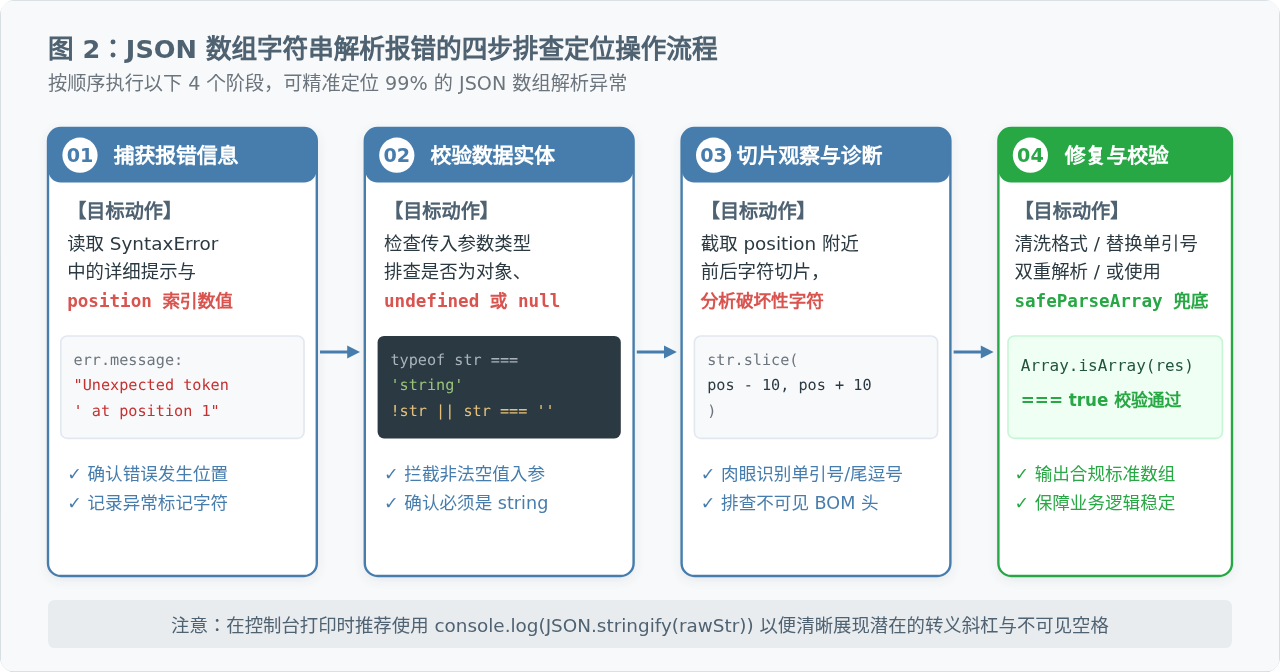
具体执行细节如下:
-
第一步:提取报错位置索引(Position Index)
仔细观察控制台的SyntaxError描述。例如错误信息包含at position 14,这代表解析器在第 14 个字符(从 0 开始计数)遇到了无法识别的语法结构。 -
第二步:核对输入变量类型与有效性
在JSON.parse()前增加断点或临时日志:
使用console.log('数据类型:', typeof rawData, '原始长度:', rawData?.length); console.log('原始完整内容:', JSON.stringify(rawData));JSON.stringify()打印原始字符串能够让潜藏的反斜杠转义、回车换行符和首尾不可见空格无所遁形。 -
第三步:对报错位置进行前后切片打印
若字符串体积庞大(例如上万字符的数组),可以通过slice()截取报错点前后的上下文:
这能迅速暴露诸如非法全角引号、中文逗号或截断残缺等肉眼不易察觉的问题。const pos = 14; // 来自错误信息中的 position console.log('可疑上下文切片:', rawData.slice(Math.max(0, pos - 15), pos + 15)); console.log('冲突字符代码:', rawData.charCodeAt(pos)); -
第四步:执行规范化修补与最终结果断言
确认问题后,在数据入口处完成修复,并最终通过Array.isArray(result)校验,确保拿到的是合法的 Array 实例。
四、生产级健壮方案:封装安全解析函数 safeParseJsonArray
在大型业务系统开发中,任何直接暴露且未加 try/catch 防护的 JSON.parse() 都是潜在的系统崩溃隐患。为了确保前端或 Node.js 服务在面对脏数据时绝不白屏、绝不中断,推荐统一使用如下具备容错清洗、多层解包与安全兜底机制的封装函数。
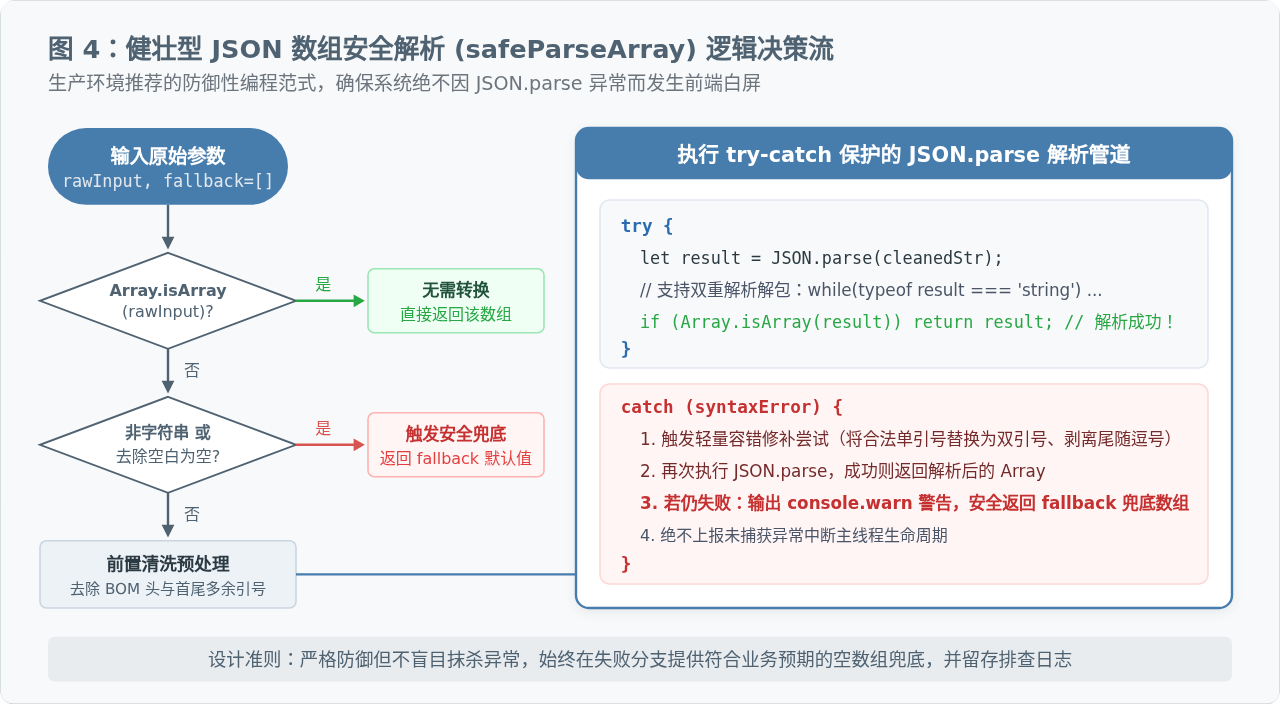
完整工业级实现源码:
/**
 * 健壮的 JSON 数组安全解析工具函数
 * @param {any} input 待解析的输入值(允许字符串、已解析数组或脏数据)
 * @param {Array} fallback 解析失败或非数组时的默认回退值,默认为空数组 []
 * @returns {Array} 保证返回合法 Array 实例
 */
function safeParseJsonArray(input, fallback = []) {
  // 1. 若入参本身就已经是标准数组,直接安全返回
  if (Array.isArray(input)) {
    return input;
  }

  // 2. 拦截非字符串、null、undefined 或全空字符
  if (typeof input !== 'string') {
    return fallback;
  }

  let trimmed = input.trim();
  if (!trimmed) {
    return fallback;
  }

  // 3. 移除可能存在的 UTF-8 BOM 标记
  if (trimmed.charCodeAt(0) === 0xFEFF) {
    trimmed = trimmed.slice(1).trim();
  }

  // 4. 第一道防线:标准规范解析与双重序列化解包
  try {
    let parsed = JSON.parse(trimmed);
    // 处理多重序列化场景(嵌套的字符串字符串)
    let maxUnpackDepth = 3; // 防止死循环
    while (typeof parsed === 'string' && maxUnpackDepth > 0) {
      parsed = JSON.parse(parsed);
      maxUnpackDepth--;
    }

    if (Array.isArray(parsed)) {
      return parsed;
    }
  } catch (initialError) {
    // 第一道解析失败,进入第二道轻量清洗容错链路
  }

  // 5. 第二道防线:常见轻量语法畸变容错修补
  try {
    let patched = trimmed;

    // A. 修复尾随逗号:例如 ["a", "b", ] -> ["a", "b"]
    patched = patched.replace(/,\s*\]/g, ']');

    // B. 若外部为单引号数组,尝试谨慎转为合规双引号
    // 仅在明确符合 ['...'] 结构时做保守置换
    if (patched.startsWith('[') && patched.endsWith(']')) {
      // 替换非转义单引号为双引号
      const quoteFixed = patched.replace(/(^|\[|\s|,|:)'(.*?)'(?=\s*(,|\]|:|\}))/g, '$1"$2"');
      const secondAttempt = JSON.parse(quoteFixed);
      if (Array.isArray(secondAttempt)) {
        return secondAttempt;
      }
    }
  } catch (secondError) {
    // 修补解析仍然失败,静默降级
  }

  // 6. 最终兜底:输出可追踪的警告日志,返回业务安全的默认数组
  console.warn('[DataWarning] 无法将输入内容解析为 JSON 数组,已启用默认兜底值。输入片段:', trimmed.slice(0, 50));
  return fallback;
}
常见测试场景验证结果:
| 输入测试用例内容 | 解析处理情况 | 最终返回结果 |
|---|---|---|
'["apple", "banana"]' |
标准 RFC 8259 规范,第一道直接命中 | ["apple", "banana"] (正常数组) |
"['apple', 'banana']" |
单引号畸变,触发轻量修补机制成功纠偏 | ["apple", "banana"] (正常数组) |
'["vue", "react", ]' |
尾随逗号,正则剔除逗号后成功解析 | ["vue", "react"] (正常数组) |
JSON.stringify('["a", "b"]') |
双重序列化数据,循环解包还原为数组 | ["a", "b"] (正常数组) |
"[object Object]" 或 null |
完全非合规语法,触发拦截兜底逻辑 | [] (安全空数组,避免白屏) |
五、开发与协作建议
"tags": ["A", "B"],而不是将数组序列化成字符串后再塞入 JSON 字段 "tags": "["A", "B"]"。这不仅白白增加了序列化与反序列化的 CPU 开销,更极易因转义字符或编码差异产生上述解析崩溃问题。
JSON.stringify(arr),绝对不要直接传递变量对象 localStorage.setItem('k', arr);读取时务必使用封装后的安全解析函数,对读取结果做 Array.isArray() 断言,从根源上杜绝潜在风险。
js字符串转数组split和Array.from性能哪个快
2026-11-13 15:40:24
js字符串转数组后怎么恢复成字符串join
2026-11-13 14:58:46
js字符串怎么按换行转数组split(/\n/)
2026-11-13 13:06:09
为什么JS的toFixed四舍五入不准确及修复方案
2026-11-13 12:58:34
js字符串正则分组转数组match
2026-11-13 11:35:19