

js字符串转数组Node.js22新特性支持
全面解析在 JavaScript 与 Node.js 22 LTS 环境中将字符串转换为数组的最新技术方案。重点讲解 Iterator Helpers 中的 toArray() 方法、RegExp v 标志集合运算切分、Array.fromAsync 异步流转换以及针对 Unicode 码点和字素簇的边界安全切分实践。
在 JavaScript 开发中,将字符串转换为数组是最基础却又最容易隐藏边界缺陷的操作。长期以来,传统的 split('') 与展开运算符存在切碎代理对(Surrogate Pairs)、粉碎复杂表情字素簇以及产生大量垃圾中间数组等问题。随着 Node.js 22 LTS 搭载 V8 12.4 引擎正式发布,语言标准原生带来了 Iterator Helpers(迭代器辅助方法中的 .toArray())、RegExp v 标志(Unicode Sets 集合运算切分) 以及 Array.fromAsync。本文深入解析这些新特性如何从底层解决 Unicode 边界安全、单次遍历惰性求值及异步数据流的切分难题,为工程实践提供高可靠的选型与实现参考。
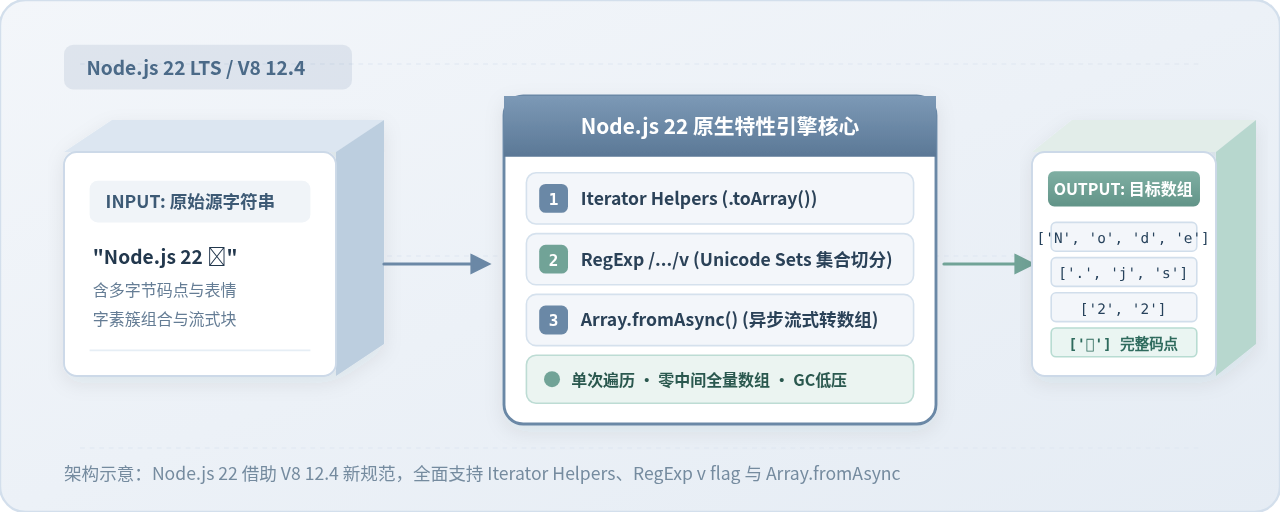
一、传统字符串转数组的底层瓶颈与 Unicode 陷阱
要理解 Node.js 22 带来的新特性价值,首先需要明确 JavaScript 底层处理字符串的三层抽象层次:UTF-16 码元(Code Unit)、Unicode 码点(Code Point) 以及 字素簇(Grapheme Cluster)。很多看似简单的字符串转数组逻辑,在不同字符集面前会表现出截然不同的行为。
1. str.split(''):机械切割 16 位码元的历史隐患
JavaScript 诞生初期采用 UCS-2 编码,随后演化为 UTF-16。在 UTF-16 中,基本多语言平面(BMP)内的常规英文字符和基础汉字占用 16 位(1 个码元),而超出 BMP 的辅助平面字符(如生僻字“𠮷”、特殊数学符号、绝大多数 Emoji)则必须使用 2 个 16 位的代理对(Surrogate Pair,包含一个高位代理和一个低位代理)表示。
str.split('') 完全按照底层存储的 16 位码元进行切分,这会导致代理对被硬生生切为两半,产生无意义且非法的孤立代理字符。
// 示例环境:任意 JavaScript 运行时
const str = "A𠮷B";

// 使用传统的 split('') 进行切分
const result = str.split('');

// [示例输出]
console.log(result);
// 输出: [ 'A', '\uD842', '\uDFB7', 'B' ]
console.log(result.length);
// 输出: 4 (本应为 3 个肉眼可见字符,生僻字'𠮷'被割裂为两个孤立码元)
2. [...str] 与 Array.from(str):码点级别的进步与字素簇盲区
ES6 引入了字符串的默认迭代器 [Symbol.iterator],它能够识别成对的代理对,从而让 [...str] 和 Array.from(str) 能够正确返回 Unicode 码点。然而,现代文本中普遍存在着由多个码点通过“零宽连字符”(ZWJ, \u200D)或修饰符连接的复合表情(如家庭表情 👨👩👧👦、不同肤色的挥手 🧏🏽♀️)以及带重音组合符的拉丁字符(如 e\u0301 渲染为 é)。
展开运算符和 Array.from 只能精确到码点层级,遇到字素簇时仍会将其拆碎:
// 示例环境:任意 ES6+ 运行时
const familyEmoji = "👨👩👧👦";
// 使用展开运算符与 Array.from
const spreadArr = [...familyEmoji];
const fromArr = Array.from(familyEmoji);
// [示例输出]
console.log(spreadArr.length);
// 输出: 7 (包含 4 个单人码点 + 3 个零宽连接符)
console.log(spreadArr);
// 输出: [ '👨', '\u200D', '👩', '\u200D', '👧', '\u200D', '👦' ]
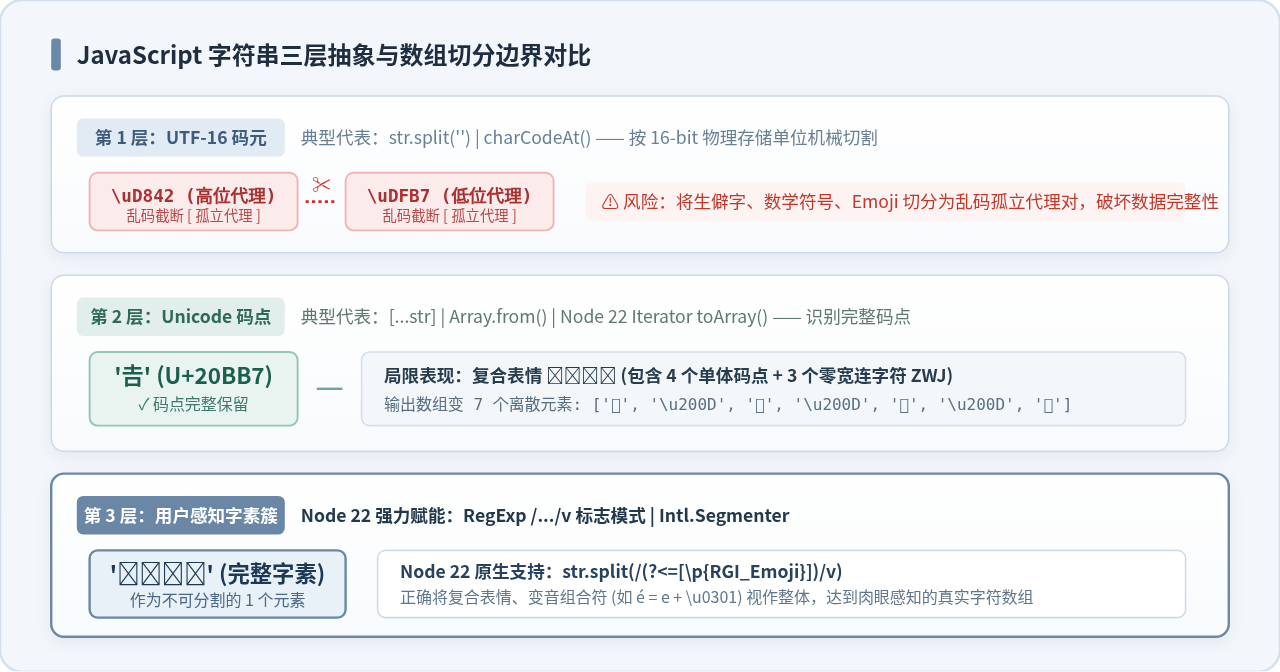
split('') 或 [...str] 会导致字符串结构性损坏或字数计算偏差。
二、Node.js 22 核心新特性:Iterator Helpers 与 .toArray()
在 Node.js 22 中,搭载的 V8 12.4 引擎全面启用了 ECMAScript Iterator Helpers 规范提案。该特性为所有继承自 Iterator.prototype 的对象注入了强大的内建方法,其中最具生产力价值的就是 Iterator.prototype.toArray() 以及一系列惰性变换方法。
1. 原生 str[Symbol.iterator]().toArray()
过去,如果要将一个迭代器转换为数组,开发者必须使用外层函数 Array.from(iter) 或通过展开语法 [...iter] 进行消费。在 Node.js 22 中,迭代器自身直接具备了终结求值并生成数组的能力:
// 执行环境:Node.js 22.0.0+
// 执行命令:node index.mjs

const greeting = "Hello 🚀 2026";

// 获得字符串迭代器并直接转为数组
const charArray = greeting[Symbol.iterator]().toArray();

// [示例输出]
console.log(charArray);
// 输出: [ 'H', 'e', 'l', 'l', 'o', ' ', '🚀', ' ', '2', '0', '2', '6' ]
console.log(charArray.length);
// 输出: 12 (火箭表情正确作为一个完整码点保留)
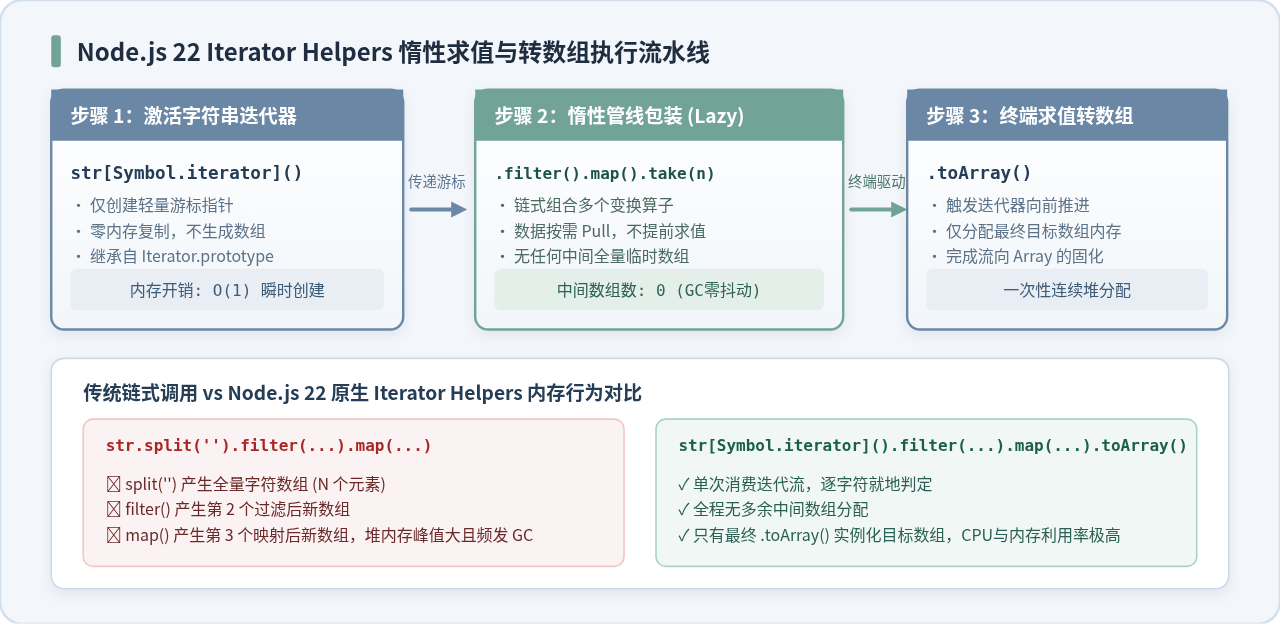
2. 惰性链式求值管线(Lazy Pipeline):告别中间全量数组
以往当我们需要“切分字符串、过滤空白、转换大写、截取前 N 项并生成数组”时,传统的写法是链式调用数组方法:str.split('').filter(...).map(...).slice(0, N)。这种做法在处理百万级长文本时性能极差,因为每一步链式调用都会在堆内存中立即实例化一个完整的全新数组,引发严重的内存膨胀与垃圾回收(GC)暂停。
Node.js 22 的 Iterator Helpers 允许在迭代器上直接链式挂载 filter()、map()、take()、drop() 等方法。这些方法是完全惰性(Lazy)的,数据只有在最终调用 .toArray() 时才会逐项向前拉取,单次遍历完成所有逻辑:
// 执行环境:Node.js 22.0.0+
// 场景:提取长文本中前 5 个非空格大写字符并转为数组

const rawContent = "Node.js 22 LTS brings awesome features to standard ECMAScript";

const result = rawContent[Symbol.iterator]()
  .filter(char => char !== ' ' && char !== '.')
  .map(char => char.toUpperCase())
  .take(5)
  .toArray();

// [示例输出]
console.log(result);
// 输出: [ 'N', 'O', 'D', 'E', 'J' ]
3. 全局匹配迭代器直接数组化:matchAll().toArray()
在提取符合正则表达式的子串时,String.prototype.matchAll() 返回一个正则表达式匹配迭代器(RegExpStringIterator)。在 Node.js 22 中,该迭代器同样继承自 Iterator.prototype,配合 map() 与 toArray() 可以写出极其清爽的代码:
// 执行环境:Node.js 22.0.0+
const logText = "2026-11-10 [INFO] Task #101 completed; Task #102 pending; Task #103 error";

// 提取所有匹配的 Task 编号并转换为扁平数组
const taskNumbers = logText
  .matchAll(/#(\d+)/g)
  .map(match => Number(match[1]))
  .toArray();

// [示例输出]
console.log(taskNumbers);
// 输出: [ 101, 102, 103 ]
三、Node.js 22 RegExp v 标志:基于集合运算与字素簇的安全切分
除了 Iterator Helpers 带来的遍历革命,Node.js 22 还全面普及了 RegExp v 标志(Unicode Sets 模式)。这是继 ES6 的 u 标志之后,JavaScript 正则表达式对 Unicode 支持最重大的升级。
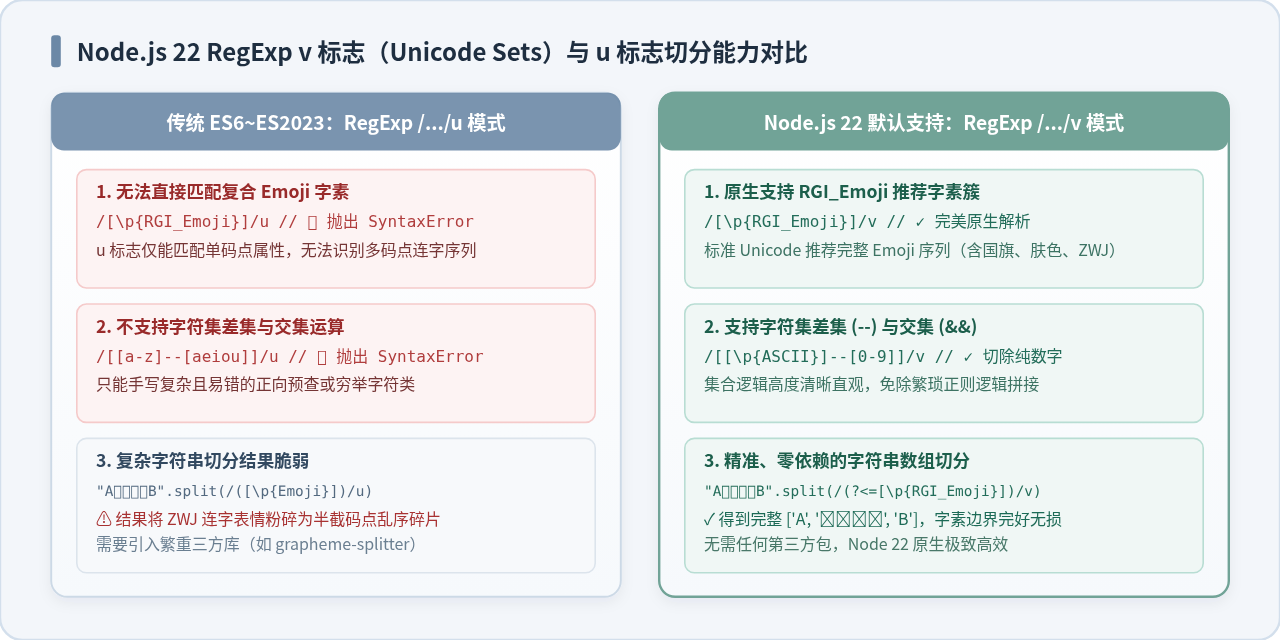
1. 为什么 u 标志不足以完成复杂的字符切分?
在旧版中,即使使用了 u 标志,正则表达式的字符类 [...] 仍然只能匹配单个 Unicode 码点。如果需要切除“某个字符集中的特定子集”(例如:匹配所有 ASCII 字符但排除数字),开发者只能手动拼接或者借助于复杂的正向先行断言。此外,u 标志无法识别推荐字素区间表情(RGI_Emoji)。
2. v 标志带来的字符集差集与交集语法
Node.js 22 的 v 标志原生支持在字符类中使用 --(差集)与 &&(交集)运算符,这使得自定义切分边界的正则表达式变得前所未有的直观:
// 执行环境:Node.js 22.0.0+
// 场景:按照“非元音字母且非数字”的边界来切分字符串

const text = "apple123orange456banana789grape";

// 使用 v 标志的差集语法:所有小写英文字母中排除 a, e, i, o, u
// 语法:[[a-z]--[aeiou]]
const splitByConsonants = text.split(/[[a-z]--[aeiou]]+/v);

// [示例输出]
console.log(splitByConsonants);
// 输出: [ 'a', 'e123o', 'a', 'e456', 'a', 'a789', 'a', 'e' ]
3. 原生匹配 \p{RGI_Emoji} 实现完整表情切分
Unicode 定义了 RGI_Emoji(Recommended for General Interchange Emoji,通用交换推荐 Emoji 集合),该集合收录了所有由多码点组合而成的合法表情(包括旗帜、肤色修饰与 ZWJ 连字表情)。在 Node.js 22 中,配合 v 标志,我们可以零第三方依赖安全地将文本按照字素簇切分成数组:
// 执行环境:Node.js 22.0.0+
const mixedMessage = "Hello👨👩👧👦World🚀2026";
// 使用后行断言配合 \p{RGI_Emoji} 在 Emoji 之后安全拆分
const tokens = mixedMessage.split(/(?<=[\p{RGI_Emoji}])/v);
// [示例输出]
console.log(tokens);
// 输出: [ 'Hello👨👩👧👦', 'World🚀', '2026' ]
// 关键点:'👨👩👧👦' 完好无损,没有被切成 7 个破碎字符!
四、异步场景下的字符串数组化:Array.fromAsync 与流式读取
在服务端 Node.js 编程中,待转换的字符串常常并不是内存中的单一静态变量,而是来自于 fs.createReadStream、HTTP 请求分块或者逐行文件扫描器(readline/promises)。
在 Node.js 22 中,作为 ES2024 标准特性的 Array.fromAsync 已成为原生内置方法。它接受一个异步可迭代对象(Async Iterable)或普通可迭代对象,并将其安全沉淀为一个完整的 Promise 数组,同时支持在遍历过程中直接传入映射函数。
// 执行环境:Node.js 22.0.0+
// 文件:stream_to_array.mjs
import { Readable } from 'node:stream';

// 模拟异步接收的大文本字符块流
async function* generateStringChunks() {
  yield "Part-1:Config\n";
  yield "Part-2:Database\n";
  yield "Part-3:Cache\n";
}

// 使用 Node.js 22 原生 Array.fromAsync 一行代码完成异步聚合与转换
const lines = await Array.fromAsync(
  generateStringChunks(),
  chunk => chunk.trim().toUpperCase()
);

// [示例输出]
console.log(lines);
// 输出: [ 'PART-1:CONFIG', 'PART-2:DATABASE', 'PART-3:CACHE' ]
data、end 事件,或者手动维护 for await (const chunk of stream) 循环并将元素 push 进临时数组。Array.fromAsync 统一了同步与异步的数组化接口,大幅简化了服务端 I/O 管道代码。
五、方案选型矩阵与最佳实践指南
为了在不同业务场景中做出最合理的性能与正确性权衡,下表汇总了 JavaScript 与 Node.js 22 中常见的 5 种字符串转数组方式:
| 方案与方法 | 支持环境 | 底层抽象层级 | 内存/GC 开销 | 适用核心场景 |
|---|---|---|---|---|
str.split(delim) |
所有 JS 引擎 | 16位 UTF-16 码元 | 极低(C++快路径) | 已知单一明确分隔符(如逗号、空格、固定字符) |
[...str] / Array.from |
ES6 / Node 6+ | Unicode 码点 | 中等(生成全量数组) | 基础多语言文本、单码点非复合字符快速展开 |
str[Symbol.iterator]().toArray() |
Node.js 22+ | Unicode 码点 | 极低(支持惰性管道) | 需要连带执行过滤、变换、截断的码点级流式处理 |
str.split(/.../v) |
Node.js 22+ | Unicode Sets / 字素 | 低至中等 | 含差集/交集的复杂字符类切分,多码点 Emoji 边界安全切分 |
Intl.Segmenter |
Node.js 16+ | 真正用户感知字素簇 | 中等 | 依赖特定自然语言文化规范的词边界、句边界高精度分词 |
Array.fromAsync(stream) |
Node.js 22+ | 异步流 / 异步分块 | 按需流式拉取 | 大文件逐行读取、网络分块、异步生成器沉淀为数组 |
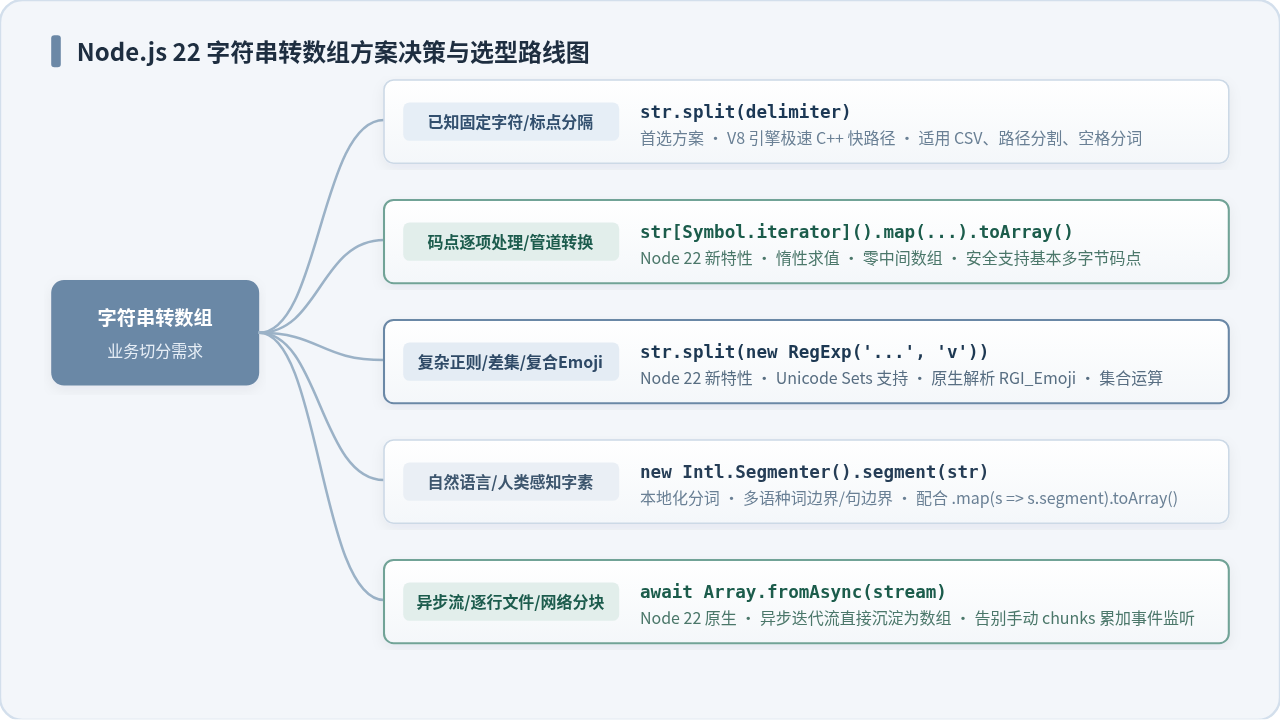
六、环境确认与向下兼容建议
1. 运行时版本确认
在终端中执行以下命令,确认当前 Node.js 版本是否具备上述完整新特性支持(要求主版本号大于或等于 22):
# 在系统终端中执行
node -v

# 示例输出:
# v22.11.0 (LTS Jod)
2. 向下兼容旧版本(Node.js 18 / 20)
如果项目需要同时兼容旧版 LTS 环境,对于 Iterator Helpers 和 Array.fromAsync,可以通过引入官方标准的 Polyfill 来实现平滑过渡:
- 针对 Iterator Helpers:可在入口文件引入
core-js/actual/iterator或es-iterator-helpers。 - 针对 Array.fromAsync:可在入口文件引入
core-js/actual/array/from-async或array-from-async。 - 针对 RegExp
v标志:由于v标志属于词法/正则解析引擎级别的改动,无法通过纯运行时 Polyfill 实现,若在低于 Node.js 20 的环境中运行含有/pattern/v的源码会直接抛出语法错误(SyntaxError)。在旧版环境中如需安全切分字素,推荐继续使用标准内置的Intl.Segmenter。
总结
Node.js 22 对 ECMAScript 标准的跟进,使字符串转数组这一基础操作迈入了更加安全、高效和现代化的阶段。总结而言:
- 在性能与内存敏感的链式过滤场景下,优先使用
str[Symbol.iterator]().filter(...).map(...).toArray(),充分利用惰性求值消除中间数组分配; - 在面对富文本、Emoji、特殊符号等复杂边界时,使用
str.split(new RegExp('...', 'v'))结合\p{RGI_Emoji}和集合运算,彻底规避代理对与字素截断问题; - 在处理I/O 流或异步生成器时,使用
Array.fromAsync()替代手动事件监听。
合理运用这些新特性,能够让你的 JavaScript 代码在保持整洁表现力的同时,获得坚固的编码安全保障与卓越的运行性能。
Node.js是前端还是后端?澄清JavaScript运行时的技术定位
2026-11-13 15:37:48
iOS上运行Node.js的限制:后台挂起、性能瓶颈与npm兼容性说明
2026-11-13 14:33:04
js字符串转数组处理二进制BufferNode.js
2026-11-13 14:00:05
js字符串转数组内存占用对比
2026-11-13 09:44:53
Node.js有什么用:核心应用场景与技术优势解析
2026-11-12 22:17:19







