React组件和普通JavaScript函数有什么区别?
深入对比React组件与普通JavaScript函数在调用机制、编译转换、状态持久化、生命周期和设计模式上的本质区别,配合架构图与代码示例解答两者的技术边界与避坑指南。
核心答案先行:从 JavaScript 语法来看,函数组件本质上依然是使用 function 或箭头函数声明的普通函数;但二者的调用宿主、生命周期、返回值含义以及运行期状态支持存在根本区别。普通函数是由开发者直接调用、执行完毕后栈帧立即销毁的时序逻辑单元;而 React 组件是由 React 运行时框架托管调度、负责声明 Virtual DOM 树结构并依托 Fiber 树长久记忆状态的 UI 单元。
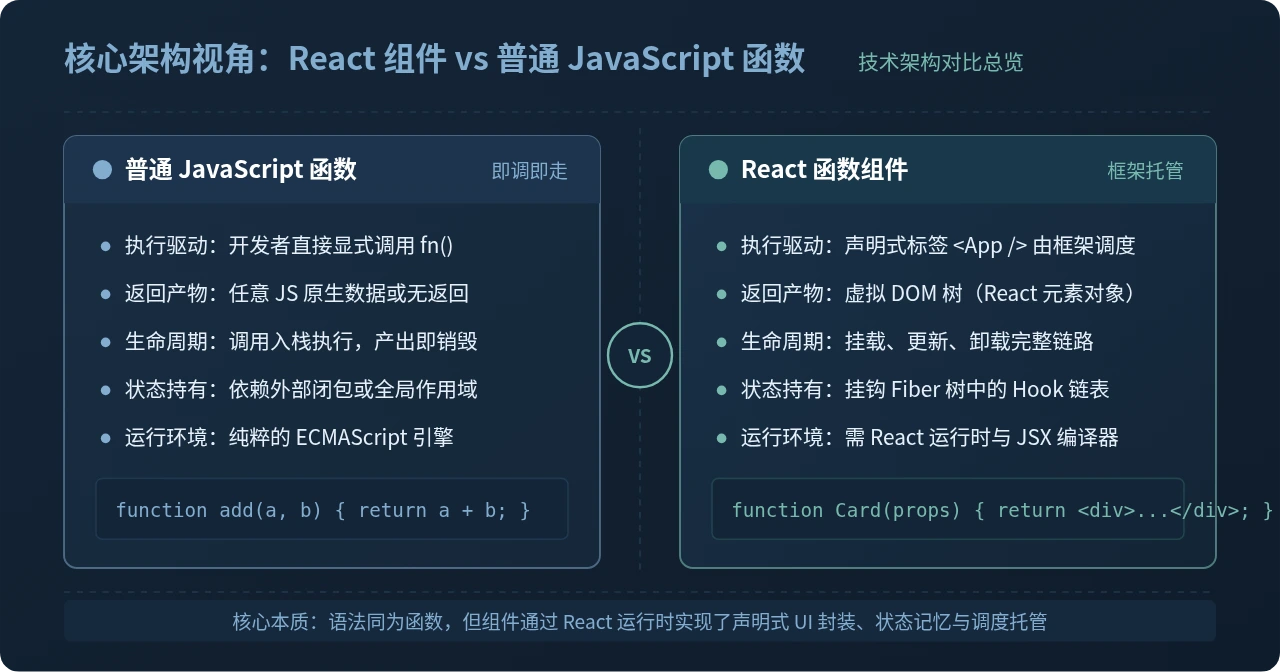
一、为什么初学者容易将两者混淆?
假设你在日常业务中写下下面两段代码:
// 示例 A:用于格式化价格的函数
function formatPrice(cents) {
  return "¥" + (cents / 100).toFixed(2);
}

// 示例 B:用于在页面展示价格徽章的组件
function PriceTag(props) {
  return <span className="price-badge">{formatPrice(props.cents)}</span>;
}
初看起来,两者的定义语法没有任何不同:都接受入参,都在内部执行某些计算,都用 return 产出结果。很多初学者往往会产生疑问:“既然 PriceTag 是个函数,那我能不能直接在事件处理函数里写 const v = PriceTag({ cents: 9900 })?”
答案是:绝对不能将其当普通函数直接调用。虽然语法外壳相似,但它们在现代前端运行时中承担着完全对立的角色。为了彻底理清边界,我们需要从调用控制权、JSX 编译、内存持久化以及副作用约束四个关键维度逐一拆解。
二、核心区别维度全景对比
在深入底层机制之前,我们通过下表先建立完整的对比心智模型:
| 对比维度 | 普通 JavaScript 函数 | React 函数组件 |
|---|---|---|
| 调用驱动者 | 业务代码显式调用(如 calculateTotal()) |
React 调度引擎隐式调度渲染(如 <Header />) |
| 返回值用途 | 任意数据类型(数字、字符串、Promise、布尔或空) | 必须返回 React Element(JSX 虚拟 DOM 描述对象)或 null |
| 状态保持方式 | 函数执行完毕局部变量即被回收,无持久化宿主 | 依托 Fiber 节点中的 memoizedState 链表跨重渲染保留状态 |
| 命名与编译规范 | 常规小驼峰命名(camelCase),不受 JSX 编译器特殊对待 | 强制大驼峰命名(PascalCase),编译器借此区分原生 DOM 标签 |
| 入参形式 | 支持任意位置参数((a, b, c, ...rest)) |
固定单对象入参(props),只读且支持 children 嵌套 |
| 副作用与纯度 | 可任意读写外部变量或产生网络、定时器等副作用 | 渲染主体必须保持纯函数,副作用强制推迟至 useEffect |
三、调用机制与控制反转:开发者驱动 vs 框架托管
普通函数与 React 组件在执行时最根本的技术分水岭在于控制反转(Inversion of Control)。
当你执行普通函数 add(1, 2) 时,控制权完全在当前执行线程中:JavaScript 引擎在当前调用栈上创建一个新的执行上下文(Stack Frame),同步执行函数体内的每一条语句,返回值被赋予调用方,随后该栈帧被立即弹出并释放。
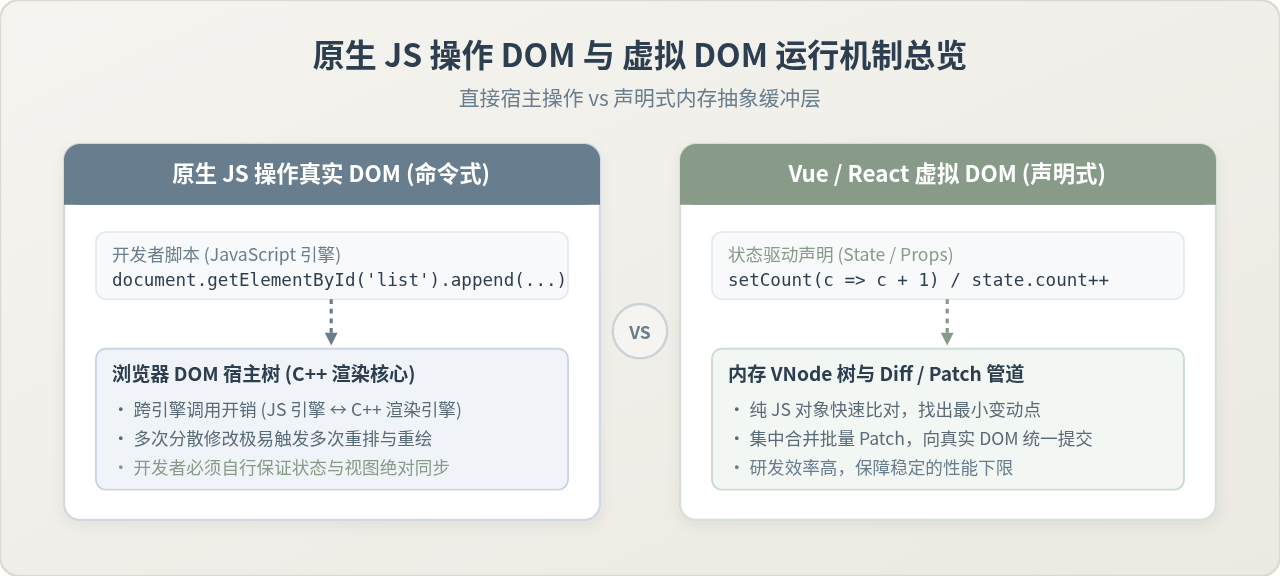
而当你书写 <UserCard id="101" /> 时,你并没有在当前时刻真正执行 UserCard 函数。你只是创建了一个轻量级的 React 元素(一个纯 JavaScript 对象,描述了“我希望在此处挂载 UserCard”)。React 随后接管了控制权,在协调(Reconciliation)阶段决定何时调度、以何种优先级运行该组件,并为该组件在 Fiber 树上建立对应的上下文节点。
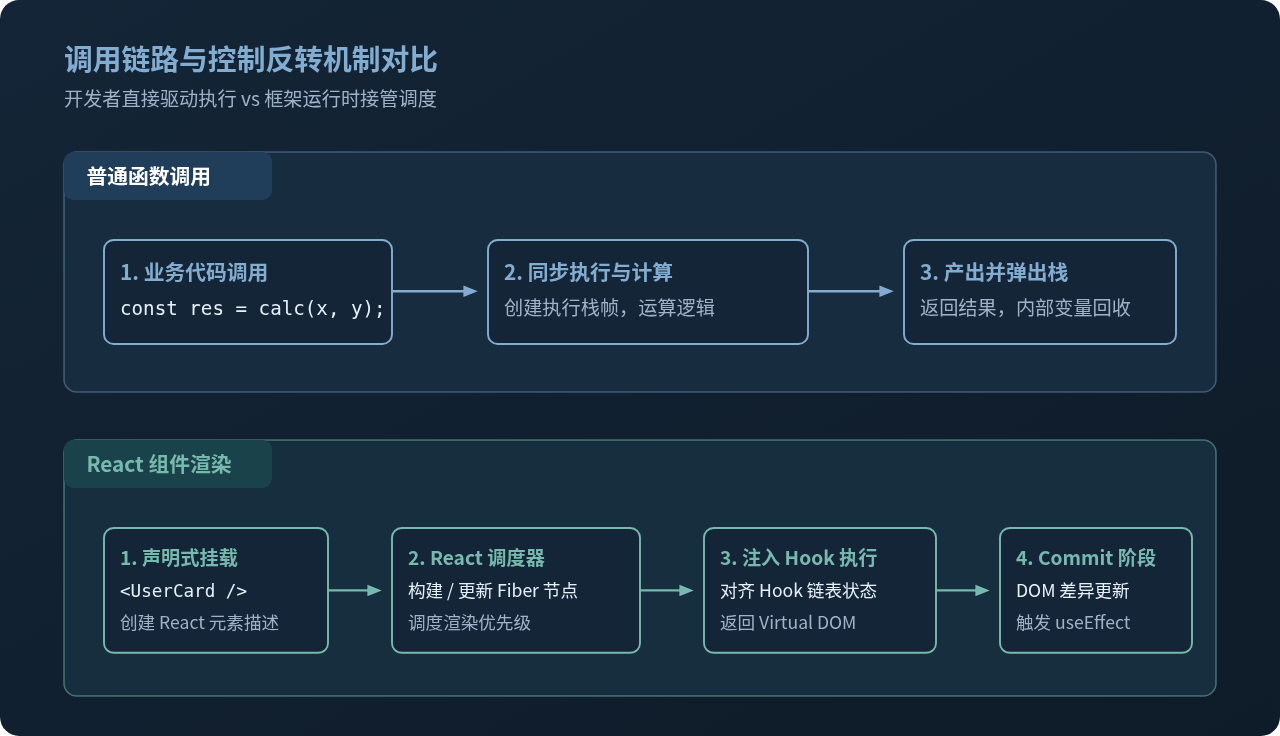
为什么控制反转至关重要?
因为由框架托管调用后,React 可以实现并发渲染(Concurrent Mode)、时间切片(Time Slicing)以及优先级中断。如果某个页面更新很重,React 可以暂停组件渲染先响应用户的输入操作;普通函数一旦开始同步运行,就无法在中间被框架无缝挂起与恢复。
四、编译转换与命名规范:为什么首字母必须大写?
在 React 代码规范中,所有人都被告知:组件名首字母必须大写(例如 UserProfile 而非 userProfile)。这并非风格偏好,而是 JSX 转译器(如 Babel、SWC 或 TypeScript)的核心语法分流依据。
JSX 并非浏览器原生支持的语法,在打包构建过程中,编译器会扫描所有形如 <tag /> 的语法标记:
- 如果标签名以小写字母开头(如
<div>、<button>),编译器会将其作为原生 DOM 字符串传递给运行时:jsx("div", { ... })。 - 如果标签名以大写字母开头(如
<Button>),编译器会将其识别为一个变量标识符引用:jsx(Button, { ... })。
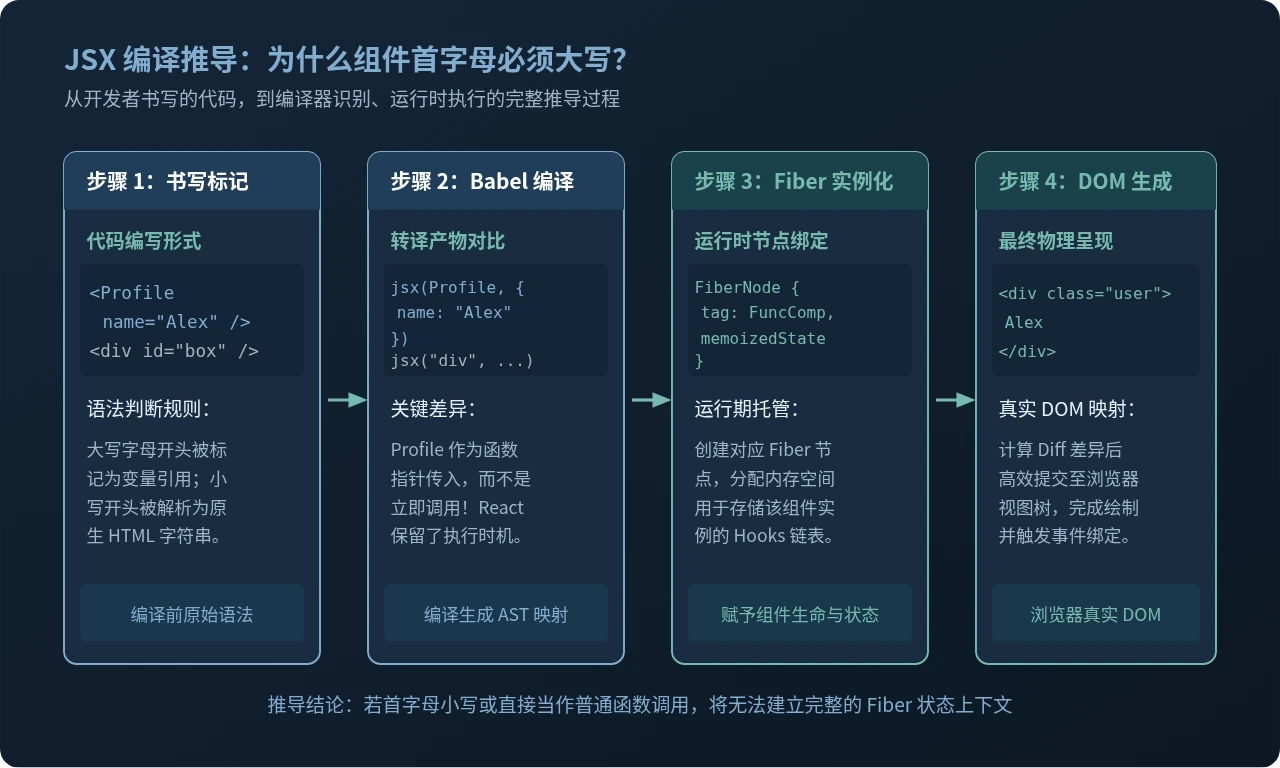
如果把一个组件写成小写字母(例如 function card() { ... } 并在 JSX 中写 <card />),编译器会生成 jsx("card", ...)。浏览器在挂载时会尝试在 DOM 树中查找或生成一个原生的 <card> 自定义元素,而绝不会执行你编写的 card() 函数,进而导致渲染静默失效或出现未知标签警告。
五、内存机制与状态持久化:栈帧销毁 vs Fiber 链表驻留
另一个核心差异体现在变量生命周期与内存管理。我们来看下面两个具体对比:
1. 普通函数:无状态记忆
function createCounter() {
  let count = 0;
  count += 1;
  return count;
}

createCounter(); // 产出 1
createCounter(); // 依然产出 1,因为每次执行都开辟了新的局部作用域
在普通函数中,局部变量 let count = 0 仅在当前调用栈帧生命周期内存活。一旦执行完毕返回,局部变量被垃圾回收,函数无法在多次连续调用之间自行保留状态(除非显式借助外部全局变量或闭包工厂)。
2. React 组件:通过 Hooks 与 Fiber 节点建立持久连接
import { useState } from "react";

function Counter() {
  const [count, setCount] = useState(0);
  return (
    <button onClick={() => setCount(count + 1)}>
      当前点击次数:{count}
    </button>
  );
}
当 Counter 组件触发重渲染时,Counter() 函数会被 React 再次执行一遍。为什么这里的 count 不会被重置为 0?
原因在于:React 并不依靠函数本身保存状态,而是将状态存储在当前组件对应的 FiberNode 实例的 memoizedState 单向链表上。当 useState(0) 执行时,React 的调度器根据当前正在处理的 Fiber 节点和 Hook 指针,按调用顺序从链表中读出上一次缓存的状态值。
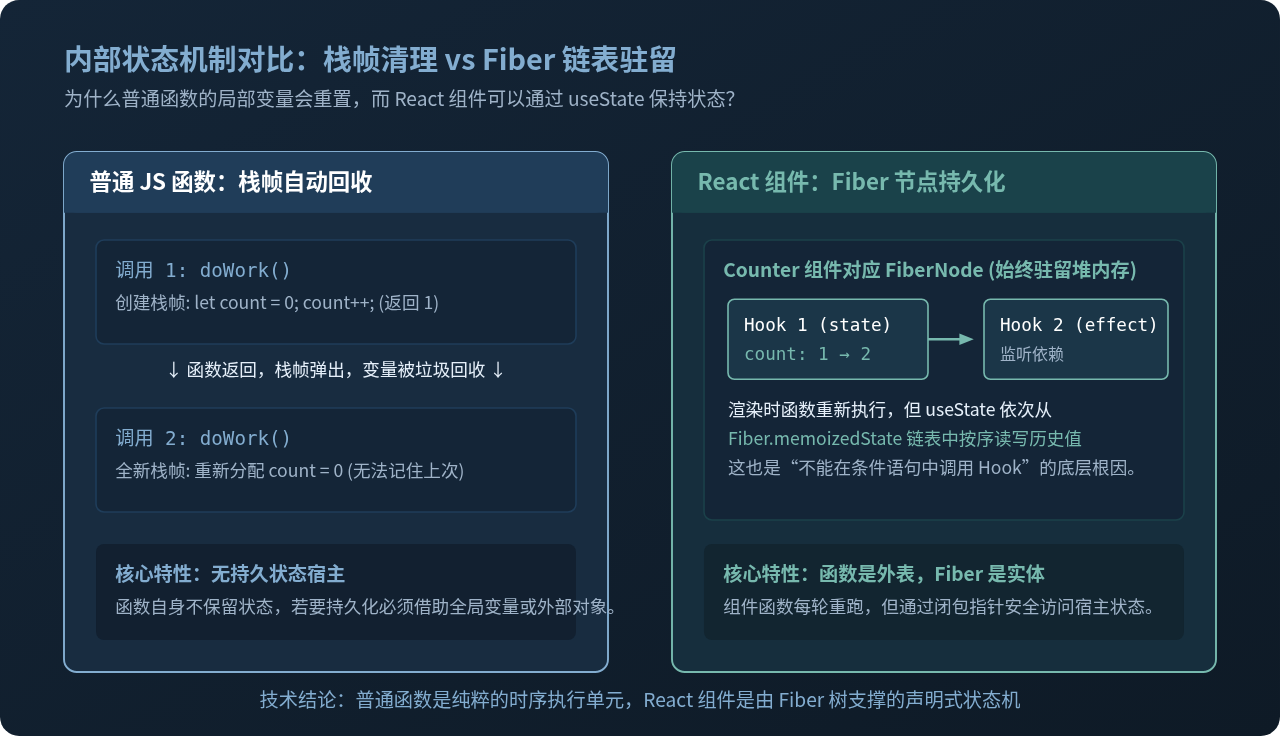
底层注意事项:Hook 的调用顺序规则
由于 React 是按数组/链表的物理索引来追踪每个 useState 或 useEffect 的,因此 Hook 绝不能写在 if 条件分支、for 循环或普通嵌套函数中。如果调用顺序错乱,Fiber 链表上的状态槽位就会错位崩溃。而普通函数内部的普通变量声明则完全没有这类调用顺序约束。
六、常见误区:为什么不能直接写 `MyComponent()`?
在实际开发中,有些开发者为了“省事”或在某些列表渲染中,会写出类似这样的代码:
// 错误的反模式写法:把组件当普通函数调用
function ParentPage() {
  return (
    <div className="container">
      {/* 错误!直接以普通函数方式调用 */}
      {UserCard({ name: "Alex", role: "Admin" })}
    </div>
  );
}
这种写法虽然在极为简单的纯展示场景下看起来能显示出 HTML,但在工程实践中隐藏着极其严重的三大隐患:
- Hook 上下文丢失与错乱:如果
UserCard内部使用了useState或useEffect,以UserCard()形式调用时,React 不会为它创建独立的 Fiber 节点。其内部的 Hook 会被直接挂载到外层ParentPage的 Fiber 节点上!这会导致父组件的状态链表污染,极易触发不可预测的 Hook 报错。 - 无法享受局部重新渲染(Re-render):当通过 JSX
<UserCard />声明时,该组件拥有独立的虚拟节点。当内部状态变化时,React 只需针对该组件进行精准 Diff;而如果是函数直接调用,它仅仅是父组件渲染产物的一段内联树,任何变动都将强制父组件整体重新计算。 - React DevTools 与生态工具失效:React 开发者工具(React DevTools)是基于 Fiber 树的组件节点来展示层级和审查 Props 的。直接调用函数不会生成组件树节点,在 DevTools 中完全隐形,极大地增加了排查调试的难度。
七、选型与应用边界:如何选用普通函数与组件?
为了在日常架构中准确划分职责,可以遵循以下选型判断路径:
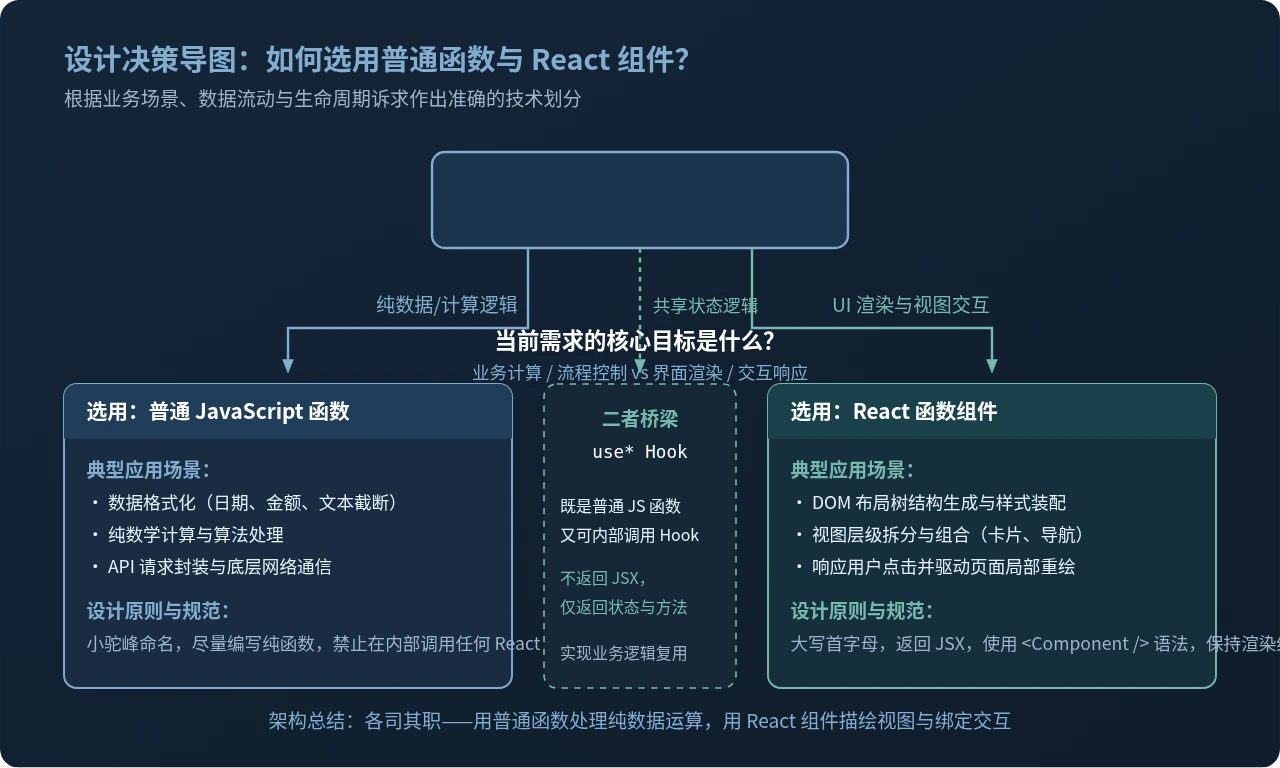
实用决策清单:
- 编写普通 JavaScript 函数:
- 逻辑为纯数据计算、文本处理或格式化(例如汇率折算、日期转换、正则验证)。
- 底层 API 通信、数据映射、算法实现。
- 要求:保持函数纯净、无 DOM 依赖、无需感知 React 生命周期,易于使用 Jest 等工具做轻量单元测试。
- 编写 React 自定义 Hook(二者的结合体):
- 逻辑需要管理内部状态或副作用(例如封装轮询、防抖搜索状态、窗口尺寸监听),但不直接输出 DOM 结构。
- 以
use开头命名,能够调用 React 的内置 Hook,供多个不同组件复用状态逻辑。
- 编写 React 组件:
- 逻辑核心是输出界面的结构(HTML/DOM)、装配视觉样式以及承载用户视图交互。
- 必须以大写首字母命名,返回合法的 JSX 元素,并在 JSX 模板中以
<Component />的形式声明挂载。
八、全文小结
总结来说,“React 组件是不是普通 JavaScript 函数”这个问题的本质是:语法层面是一致的,但运行时宿主和契约体系完全不同。
普通 JavaScript 函数是语言原生标准的一部分,随时随地调用,调用即执行,执行即销毁;而 React 组件是 React 框架赋予的声明式角色,它通过首字母大写的契约被 JSX 转译器识别,通过 <Component /> 声明将执行权移交给 React 调度引擎,依托 Fiber 树长久记忆状态,并最终参与浏览器的视图更新。认清这一边界,不仅能帮助我们规避 Hook 错乱和性能陷阱,更能在项目工程中写出职责分明、易于维护的代码架构。
JS解析JSON字符串报错SyntaxError怎么处理
2026-11-12 09:56:59
JavaScript处理文本框浮点数运算精度丢失的解决方案
2026-11-12 09:21:16
JS数组末尾添加元素:push()方法详解与返回值陷阱
2026-11-11 15:39:57
JS怎么在字符串中加字符:+运算符与concat方法
2026-11-11 14:28:21
JavaScript比较参数怎么给新人讲明白
2026-11-08 18:19:07