JS数组indexOf和findIndex用法对比:查找元素索引的最佳实践
深入对比JavaScript中Array.prototype.indexOf与Array.prototype.findIndex的底层机制、查找场景、边界情况与性能差异,帮助开发者准确选择最适合的数组索引查找方法。
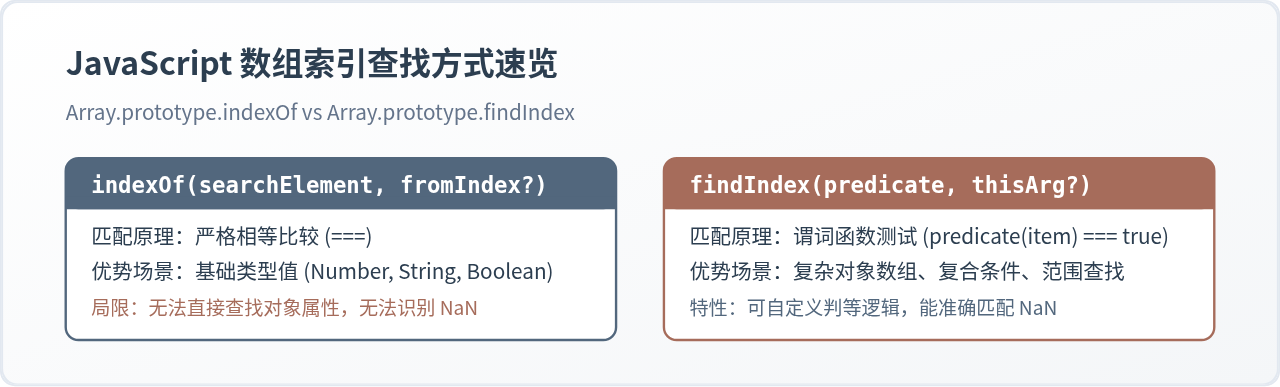
在日常 JavaScript 开发中,从数组中获取某个元素的下标是一项高频基础操作。多数开发者都知道 Array.prototype.indexOf 与 Array.prototype.findIndex 都可以返回满足条件的第一个元素索引,但若不清楚两者的底层匹配机制与适用边界,极易在处理复杂对象、特殊数值或性能敏感场景时踩坑。
核心结论非常明确:当查找目标是基础数据类型(如数字、字符串、布尔值)且属于直接全等比对时,优先使用 indexOf,语法精炼且执行效率更高;当查找目标为对象数组、需要按对象属性匹配、或包含复合判断条件(例如查找 NaN、范围判断)时,必须使用 findIndex。
一、定义与底层比较机制差异
理解两个方法差异的根源,在于观察它们如何决定两个元素“是否相等”。
1. indexOf:值匹配与严格相等 (===)
indexOf 接收具体的待查找值以及可选的起始检索位置:
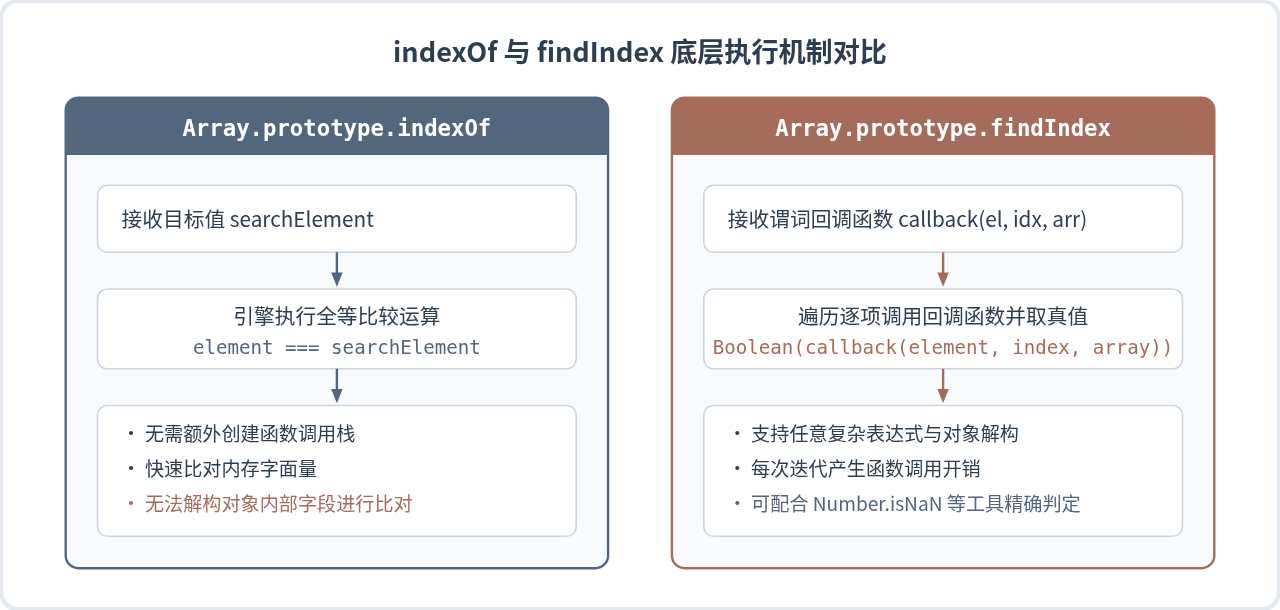
arr.indexOf(searchElement[, fromIndex])它的比对完全基于 JavaScript 的严格相等运算符 (===)。引擎从 fromIndex 开始依次取出数组元素,执行 item === searchElement。一旦表达式为 true,立即停止遍历并返回当前下标;如果遍历完整数组仍未匹配,则返回 -1。
2. findIndex:逻辑断言与谓词回调
findIndex 接收一个谓词函数(Predicate Callback):
arr.findIndex(callback(element[, index[, array]])[, thisArg])它在遍历每个元素时,将当前元素、下标和原数组传入回调函数。只有当回调函数的返回值在转换为布尔值后为 true 时,才认为命中目标并返回下标。若始终没有元素满足回调条件,则返回 -1。
二、场景实测:基础数据类型与引用数据类型
1. 基础数据类型检索
在数字、字符串、布尔值等基本类型数组中,两者的工作方式差异主要体现在代码简洁度与直观性上:
const cities = ['Beijing', 'Shanghai', 'Guangzhou', 'Shenzhen'];

// 使用 indexOf
const indexA = cities.indexOf('Guangzhou');

// 使用 findIndex
const indexB = cities.findIndex(city => city === 'Guangzhou');indexA: 2
indexB: 2
此时两种方式均能正确返回 2。但 indexOf 语义直接,无需编写额外的箭头函数闭包,可读性与性能都优于 findIndex。
2. 对象数组检索与引用地址陷阱
当数组元素为对象时,初学者经常会写出如下代码并困惑于为何总是返回 -1:
const users = [
  { id: 101, name: 'Alice' },
  { id: 102, name: 'Bob' },
  { id: 103, name: 'Charlie' }
];

// 尝试使用 indexOf
const targetIndex = users.indexOf({ id: 102, name: 'Bob' });
console.log(targetIndex);indexOf 之所以返回 -1,是因为字面量 { id: 102, name: 'Bob' } 在堆内存中开辟了一个全新的对象地址。indexOf 内部执行的是严格相等比对,两个拥有不同内存指针的对象进行 === 比较时结果永远是 false。
除非你传入的是该对象在内存中的原始引用,否则 indexOf 无法直接用于对象匹配。而 findIndex 允许我们深入对象属性进行匹配,这正是它的强项所在:
// 正确做法:使用 findIndex 根据唯一属性匹配
const correctIndex = users.findIndex(user => user.id === 102);
console.log(correctIndex);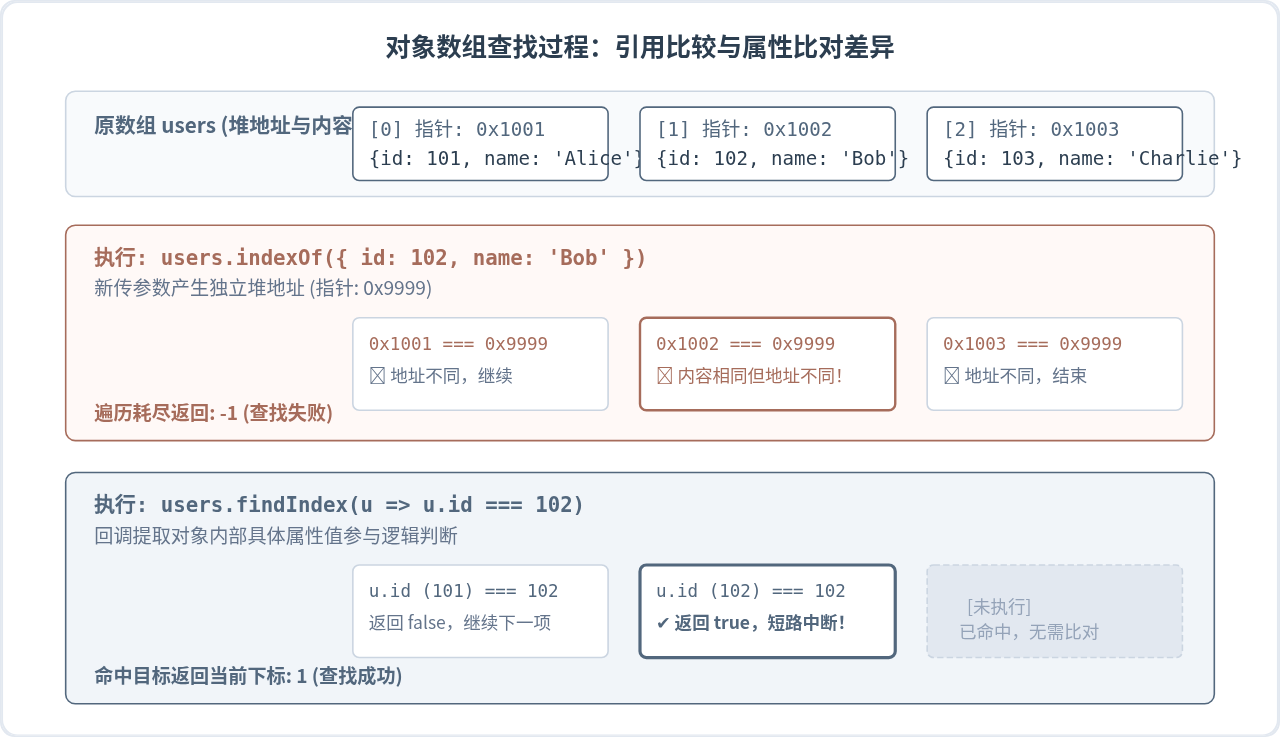
三、边界情况与特殊场景处理
在面对一些 JavaScript 语言层面的边缘情况时,两者的差异尤为显著。
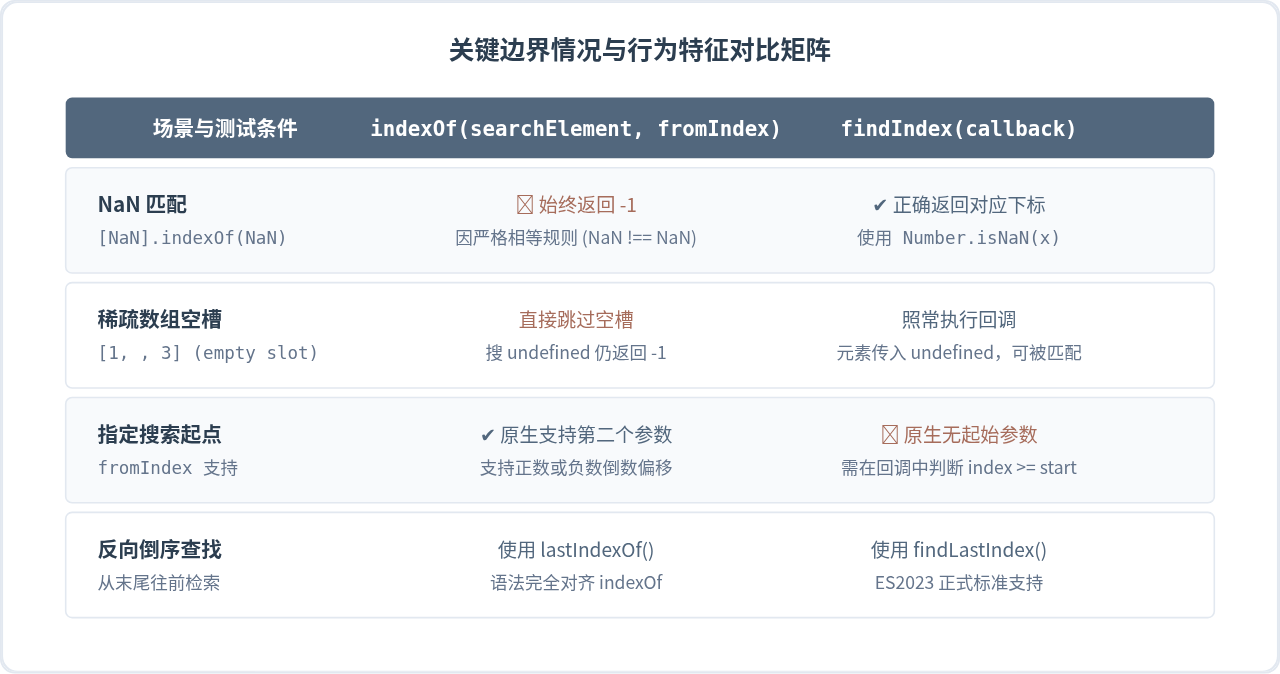
1. 查找特殊值 NaN
在 JavaScript 中,NaN === NaN 的结果为 false。这意味着使用基于严格相等的 indexOf 永远无法在数组中定位 NaN:
const list = [10, NaN, 30];

console.log(list.indexOf(NaN)); // 输出: -1
console.log(list.findIndex(item => Number.isNaN(item))); // 输出: 1indexOf: -1
findIndex: 1
如果业务中存在可能包含 NaN 的浮点数或计算残留数组,且需要获取其下标,必须使用 findIndex 并结合 Number.isNaN()。
2. 稀疏数组(Sparse Array)与空槽处理
稀疏数组是指数组中存在未分配内存的“空槽(empty slots)”。例如通过 Array(3) 或 [1, , 3] 构造的数组。两方法对空槽的遍历行为存在本质区别:
- indexOf:在底层遍历时会跳过空槽,不会对空槽执行任何判断。即使你搜索
undefined,它也不会匹配空槽。 - findIndex:不会跳过空槽。它会将空槽视作传入
undefined并照常执行回调函数。
const sparse = [1, , 3]; // 索引 1 为空槽

console.log(sparse.indexOf(undefined)); // 输出: -1 (跳过空槽)
console.log(sparse.findIndex(x => x === undefined)); // 输出: 1 (正常访问并判定)indexOf: -1
findIndex: 1
3. 起始搜索位置(fromIndex 参数)
indexOf 原生支持第二个参数 fromIndex,可用于控制查找的起点位置或实现分页/循环查找所有重复元素的下标:
const tags = ['js', 'css', 'html', 'js', 'node'];
const first = tags.indexOf('js'); // 0
const second = tags.indexOf('js', first + 1); // 3
但 findIndex 不接受原生 fromIndex 参数。如果希望从某个指定偏移量开始查找,常见的实现方式有两种:
- 在回调函数内结合索引判断(推荐,无内存额外分配):
const startIndex = 2; const idx = tags.findIndex((tag, i) => i >= startIndex && tag === 'js'); // 输出: 3 - 配合 slice 进行截取(不推荐用于大数组,会产生额外切片数组,且返回的下标需要手动加上偏移量)。
4. 反向查找需求
如果需要从数组末尾向前查找第一个匹配项的下标:
- 对于简单值,直接使用配套的
Array.prototype.lastIndexOf()。 - 对于复杂条件,ECMAScript 2023(ES14)正式引入了
Array.prototype.findLastIndex(),语法与findIndex完全一致,但从数组末尾开始向前遍历。
四、性能考量与底层引擎优化
在面对上百万级数据量或处于高频渲染帧循环中时,选择合适的方法对运行性能有直接影响。
现代 JavaScript 引擎(如 Google Chrome 与 Node.js 使用的 V8 引擎)针对 Array.prototype.indexOf 进行了深度的 C++ 层面优化:
- 对于紧凑型(Packed Elements)的数字数组或字符串数组,
indexOf的底层循环往往会被内联为底层的向量化操作(甚至利用 SIMD 指令),避免了多余的分支跳转。 - 而
findIndex在每一次遍历迭代时,都需要进行一次 JavaScript 函数调用(调用栈入栈与出栈、传参、接收布尔返回值)。即使 JIT 编译器尝试进行函数内联,在未命中前的大规模迭代中,函数调用与上下文切换的开销依然明显高于简单的内存比较。
实测考量:在长度为 1,000,000 的纯数字数组中查找位于末尾的元素,indexOf 的耗时通常显著低于 findIndex。因此,在大规模基础类型数组检索时,不要盲目为了“函数式编程风格”而滥用 findIndex。
五、查找元素索引的最佳实践与决策树
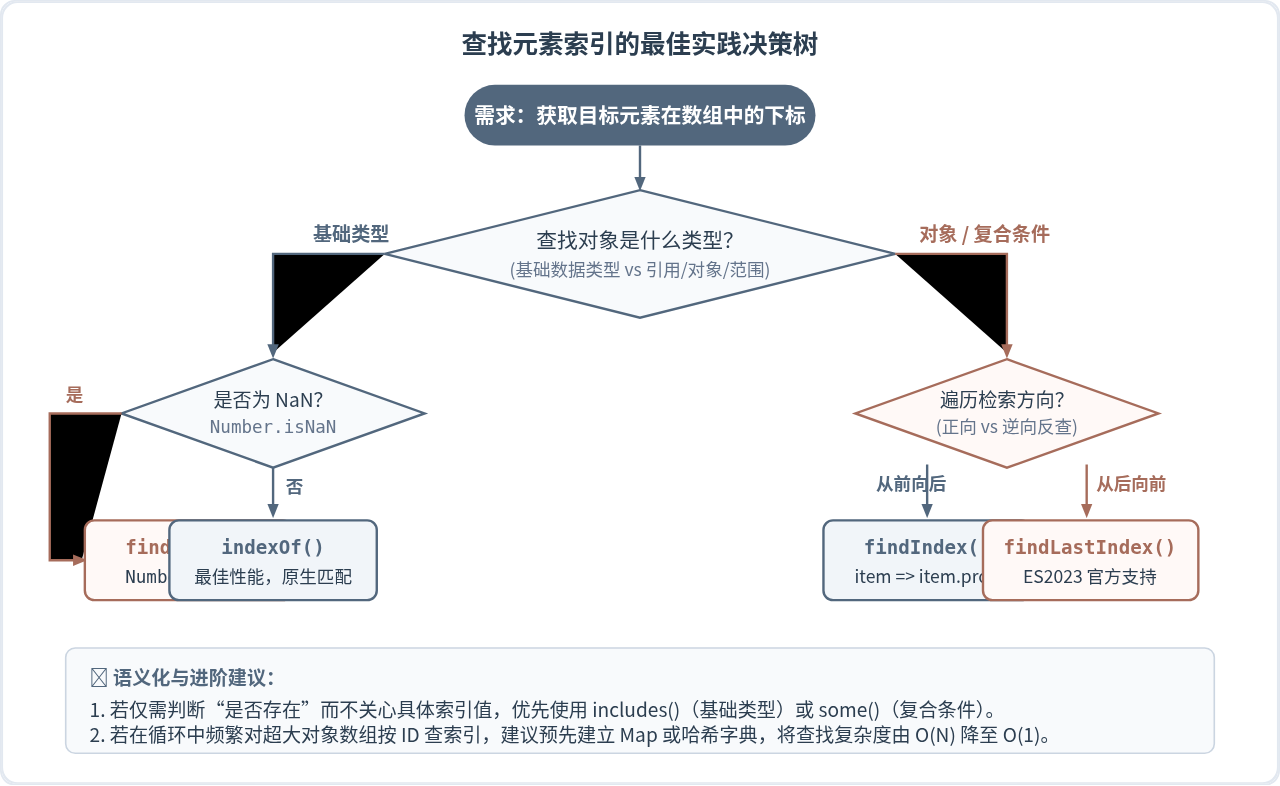
为了让编码逻辑更加严谨高效,建议在编写索引查找代码时遵循以下决策路径:
6 条实用检查清单
- 明确查找目标结构:基础数据用
indexOf,对象和复杂条件用findIndex。 - 警惕对象字面量直接比对:永远不要写
arr.indexOf({ id: 1 }),因为字面量对象每次分配独立引用地址。 - 防范特殊数值 NaN:若数据源包含未过滤的计算结果,
indexOf(NaN)会静默返回-1,定位 NaN 须使用findIndex(Number.isNaN)。 - 合理利用配套方法:需要倒序查找时,基础类型使用
lastIndexOf(),复杂条件使用现代标准的findLastIndex()。 - 辨析使用意图:若业务只关注“元素在不在”,直接使用
includes()或some(),避免书写if (arr.indexOf(x) !== -1)这种历史残留写法。 - 高频检索重构:当业务中对同一数组进行多次大跨度根据主键查找索引时,建立
new Map(arr.map((item, i) => [item.id, i]))可以把时间复杂度降为常数级。
JavaScript比较参数怎么拼接模板文本
2026-11-08 23:49:11
JavaScript比较参数处理后中文乱码怎么解决
2026-11-08 17:04:17
JavaScript基础选择题怎么处理用户输入的异常值
2026-11-08 10:48:56
JavaScript比较参数旧代码怎么重构
2026-11-07 13:15:34
为JavaScript配置文件添加TypeScript类型提示的最佳实践
2026-11-06 22:56:07