js判断整数正则表达式处理后中文乱码怎么解决
针对JavaScript在进行整数正则表达式校验或处理后出现中文乱码的问题,分析文件编码冲突、正则过度过滤、URL编解码异常以及数据传输不一致等原因,并提供详细的排查步骤与修复方案。
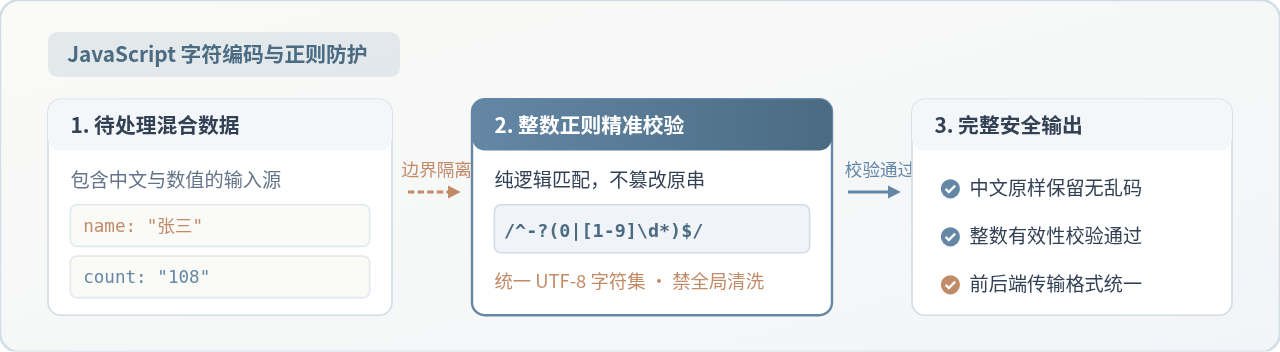
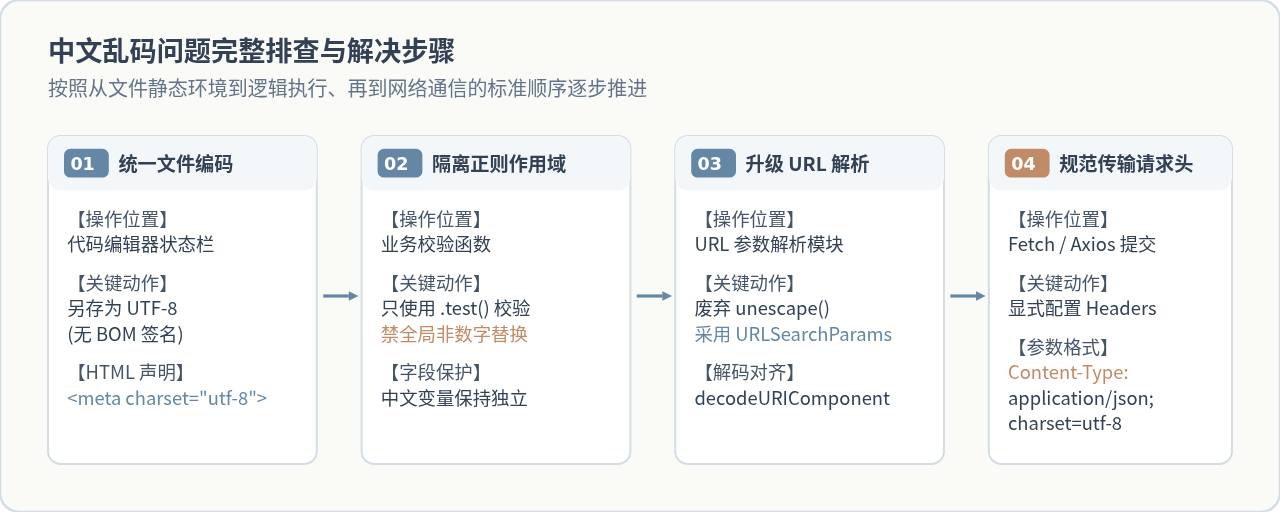
/^-?\d+$/)只是执行模式匹配,底层绝不会修改字符的字节流编码。开发中之所以出现“正则判断整数后中文变成乱码”的表象,根源并不在正则表达式本身,而在于伴随校验操作的前后链路:或是 JS 脚本文件本身的编码(GBK/ANSI)与 HTML 声明(UTF-8)产生冲突;或是误用了全局非数字正则替换破坏了中文字符;或是在解析包含中文与整数的 URL 参数时调用了淘汰的解码函数;亦或是校验完成后发起异步请求时丢失了 charset=utf-8 请求头。本文按从原因排查到实操修复的递进顺序,详细解析每一类场景的具体解决措施。
一、原因剖析:为什么“判断整数”会引发中文乱码
排查该问题前,必须先厘清一个技术事实:JavaScript 内置的 RegExp.prototype.test() 是一个纯粹的只读判定方法,接收一个参数并返回布尔值(true 或 false)。它既不修改入参对象,也不涉及任何字符编码重组。因此,所谓“正则处理后产生中文乱码”,都是由校验前后的附属逻辑引起的。
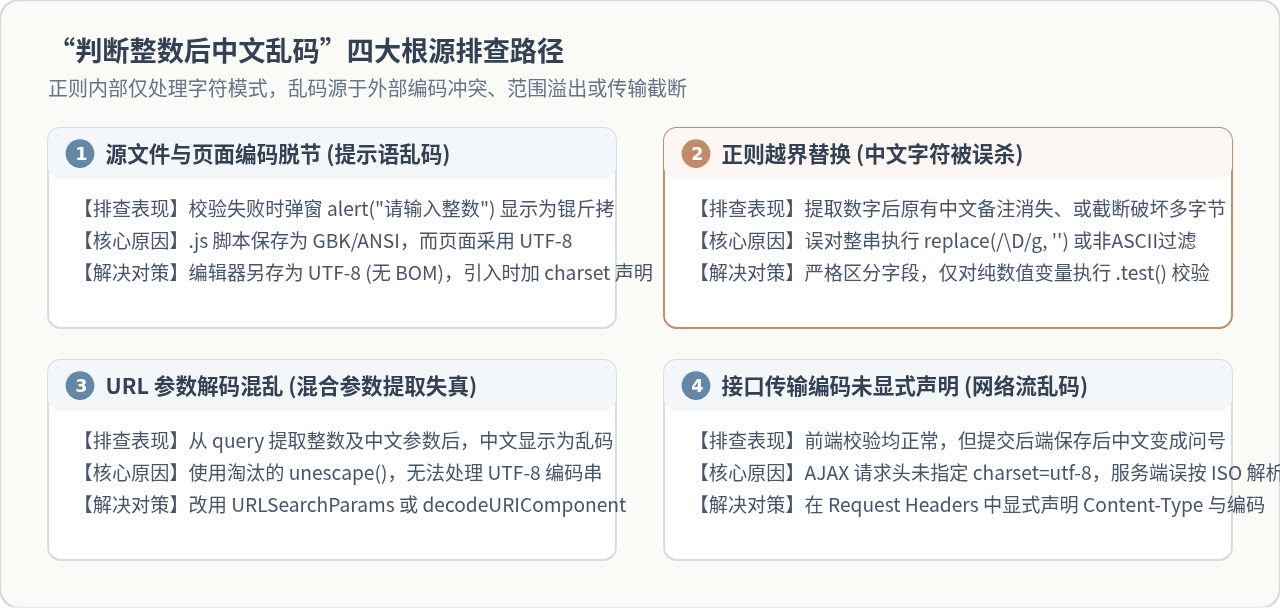
在实际项目代码中,“判断整数”通常嵌入在一个连续的处理流中,常见的乱码诱因可以归结为以下四种典型链路问题:
- 提示语字符集冲突:开发者在正则判断返回
false时执行alert("请输入有效的整数")或操作 DOM 渲染警告文本,此时页面出现锟斤拷或类似方块乱码。这通常是编写该逻辑的.js文件本身存储编码与页面声明不一致所致。 - 误用正则全局替换导致数据污染:部分开发者习惯在验证前“清洗”数据,误将
replace(/\D/g, '')或非 ASCII 过滤正则作用于包含中文和数值的整个复合字段(如“共 12 件商品”或包含中文的表单对象),导致中文字符被强行剥离或双字节序列破损。 - URL 参数提取与解码失真:在处理形如
?user=张三&id=1024的地址栏参数时,使用正则提取数值参数的同时用旧式unescape()解析中文参数,导致 UTF-8 编码字节无法还原。 - 校验后传输请求头缺失:前端完成整数验证后将数据组装为 JSON 并提交给服务端,由于未在 HTTP 请求中显式指定
charset=utf-8,后端框架默认回退至ISO-8859-1解析,进而保存或回显出乱码。
二、四类典型场景的排查与具体解决方案
根据前文分析的四个关节点,我们可以对照实际业务代码进行针对性排查和修复。
场景 1:校验失败提示语中文乱码(文件与页面字符集脱节)
故障现象:当用户输入非整数触发校验失败时,系统弹出的提示信息或表单下方显示的红字提示变成乱码,例如出现 锟斤拷 或问号字符。
根本原因:HTML 文件中设置了 <meta charset="UTF-8">,但存放整数校验逻辑的外部 .js 脚本文件在本地被编辑器保存为 GBK、ANSI 或带有 Windows BOM 头的格式。浏览器在按 UTF-8 解码外部脚本里的中文字符串字面量时,字节对齐产生错位。
解决步骤:
- 重新转换脚本编码:在主流编辑器(如 VS Code)右下角查看编码状态。若显示为
GBK或Windows-1252,点击该位置,选择“通过编码保存(Save with Encoding)”,明确指定为 UTF-8(切勿选择 UTF-8 with BOM)。 - 在 HTML 引入处显式标注编码:在引用该脚本的
<script>标签上显式补充charset="utf-8"属性,防止某些低版本或特殊配置的网关自行推断编码。
<!-- 规范的 HTML 头部与脚本引用声明 -->
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>整数校验演示</title>
</head>
<body>
  <!-- 显式指定 charset 为 utf-8 -->
  <script src="validate.js" charset="utf-8"></script>
</body>
</html>
场景 2:数据预处理时过度替换,误伤中文字符
故障现象:表单中有“商品名称”和“采购数量”两个字段,或者输入框内容类似于“第 3 期账单”。在进行了所谓的“提取整数并校验”之后,中文字段彻底消失,或者在后续字符串拼接时出现了问号与截断乱码。
根本原因:代码为了获取纯整数,错误地执行了全局正则替换,例如 str.replace(/\D/g, '');或者为了“去除不可见非法字符”复制了旧论坛中的正则 replace(/[^ -ÿ]/g, '')。在 JavaScript 中,中文字符的 Unicode 码点远超 255,此正则会瞬间将字符串里的所有汉字全部强制剥除。如果后续再将残缺的字节流做解码,就会造成多字节截断乱码。
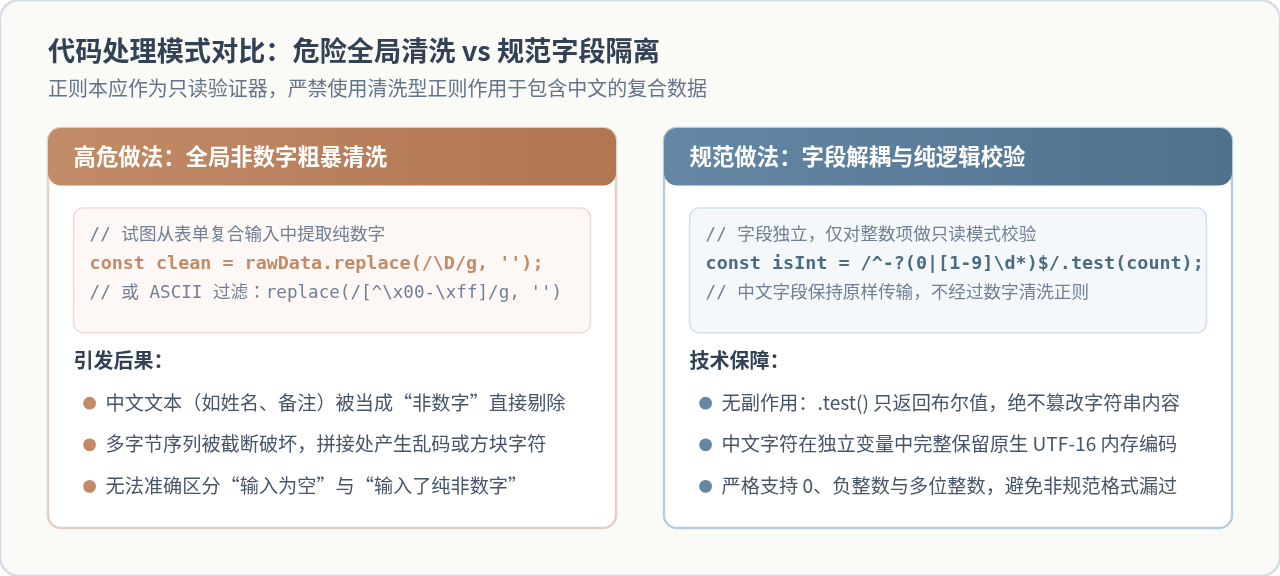
正确做法:实现“字段隔离”与“纯逻辑判定”。严禁对可能包含中文字符的复合文本实施全局非数字过滤。校验只读判定,数据提取精准拆分:
// 错误示范:对复合输入进行粗暴过滤(会导致中文全灭)
function unsafeFilter(text) {
  // 危险!非ASCII过滤会杀掉所有汉字,/\D/g 会删掉非数字的所有汉字
  return text.replace(/\D/g, '');
}

// 正确示范:严格保持字段独立,只对需要验证为整数的目标做判定
function validateForm(data) {
  // 1. 中文字段独立保留,不做破坏性正则清洗
  const userName = String(data.name || '').trim();
  const countInput = String(data.count || '').trim();

  // 2. 使用标准的整数正则进行纯逻辑匹配(不改变任何字符内容)
  const integerRegex = /^-?(0|[1-9]\d*)$/;
  if (!integerRegex.test(countInput)) {
    return {
      valid: false,
      message: "采购数量必须为合法的整数"
    };
  }

  // 3. 校验通过后,中文与整数各自保持原生格式
  return {
    valid: true,
    payload: {
      name: userName,
      count: parseInt(countInput, 10)
    }
  };
}
场景 3:URL 参数解析时中文与整数的解码错误
故障现象:页面从当前地址栏(window.location.search)提取参数,其中既包含数字 ID,又包含中文搜索词或用户名。在编写正则表达式匹配查询字符串后,整数提取正常,但中文参数却变成了乱码或形如 %E5%BC%A0%E4%B8%89 的百分号编码。
根本原因:许多开发者直接套用老旧代码库中的 unescape() 函数解码正则捕获组。unescape 只能处理 %uXXXX 这种已弃用的 16 位 Unicode 编码,而现代浏览器在地址栏中默认将中文字符以 UTF-8 编码成多个百分号字节(每个汉字占用 3 个 %XX 字节)。unescape 无法将其还原,甚至将其当作单字节字符拆分,导致后续渲染为乱码。
解决步骤:全面废弃 unescape(),统一使用标准浏览器 API URLSearchParams,或者在自定义正则提取中配合 decodeURIComponent()。
// 现代推荐做法:使用标准 URLSearchParams 提取参数
function getQueryParams() {
  const params = new URLSearchParams(window.location.search);

  // 自动使用 UTF-8 安全解码中文,绝不产生乱码
  const categoryName = params.get('category') || '';
  const pageIndexRaw = params.get('page') || '';

  // 正则检验整数合法性
  const isInt = /^[1-9]\d*$/.test(pageIndexRaw);

  return {
    category: categoryName,
    page: isInt ? parseInt(pageIndexRaw, 10) : 1
  };
}

// 如果必须兼容旧浏览器使用正则匹配,请配合 decodeURIComponent
function getParamByRegex(name) {
  const reg = new RegExp('(^|&)' + name + '=([^&]*)(&|$)', 'i');
  const match = window.location.search.substr(1).match(reg);
  if (match !== null) {
    try {
      // 严格使用 decodeURIComponent,切勿使用 unescape
      return decodeURIComponent(match[2]);
    } catch (e) {
      return match[2];
    }
  }
  return null;
}
场景 4:校验通过后异步请求(AJAX/Fetch)报头配置缺失
故障现象:前端页面上中文显示完全正常,使用整数正则验证也成功通过,但点击提交后,后端数据库存入的中文字段全变成了问号。
根本原因:前端通过 fetch() 发起 POST 提交时,若仅将对象 JSON.stringify() 序列化,但未在 headers 中指明字符集,部分 Web 服务器默认会以 ISO-8859-1 字符集解析传入的字节流,导致原本合法的 UTF-8 汉字被按单字节错乱拼装。
解决对策:规范请求配置,明确声明 Content-Type: application/json; charset=utf-8。
async function submitValidatedData(payload) {
  const response = await fetch('/api/submit', {
    method: 'POST',
    headers: {
      // 显式指定 UTF-8 编码,杜绝后端解码偏差
      'Content-Type': 'application/json; charset=utf-8',
      'Accept': 'application/json; charset=utf-8'
    },
    body: JSON.stringify(payload)
  });
  return await response.json();
}
三、严谨的整数正则表达式与安全校验模式
许多乱码问题的始作俑者,正是因为使用了模糊或错误的正则表达式,迫使开发者在外部做“缝缝补补”的二次过滤。直接使用严谨的整数正则,不仅可以杜绝外部冗余逻辑,还能彻底避免对非目标字符产生误操作。
1. 常用整数场景的精准正则表达式
| 业务校验类型 | 推荐正则表达式 | 规则说明与边界控制 |
|---|---|---|
| 正整数(不含 0) | /^[1-9]\d*$/ |
首位必须为 1-9,杜绝出现 0 或 0012 类似的前导零无效数字。 |
| 非负整数(含 0) | /^(0|[1-9]\d*)$/ |
严格匹配单字符 0 或以非零数字开头的多位自然数。 |
| 负整数 | /^-[1-9]\d*$/ |
前缀必须有负号,且数值部分不为 0。 |
| 任意整数(含正负号) | /^-?(0|[1-9]\d*)$/ |
通用整数检验,允许负号,不允许 -0 或非法前导零。 |
| 带长度限制的整数 | /^-?(0|[1-9]\d{0,8})$/ |
限制整数最大有效长度(如不超过 9 位),防止超出安全整数范围溢出。 |
2. 安全的通用校验函数封装
在企业级项目中,推荐将校验逻辑封装为无副作用的纯函数,明确入参与出参,隔绝任何跨字段过滤行为:
/**
 * 安全的整数校验器(纯逻辑判定,绝不改变输入源与编码)
 * @param {string|number} value 待校验输入
 * @param {boolean} allowNegative 是否允许负整数
 * @returns {{isValid: boolean, value: number|null}}
 */
function checkInteger(value, allowNegative = false) {
  if (value === null || value === undefined || value === '') {
    return { isValid: false, value: null };
  }

  const str = String(value).trim();
  const regex = allowNegative
    ? /^-?(0|[1-9]\d*)$/
    : /^(0|[1-9]\d*)$/;

  if (!regex.test(str)) {
    return { isValid: false, value: null };
  }

  // 安全转为原生数值
  const num = Number(str);
  if (!Number.isSafeInteger(num)) {
    return { isValid: false, value: null };
  }

  return { isValid: true, value: num };
}
许多开发者喜欢使用 parseInt("123abc"),该方法会成功返回 123,从而遗漏后面的非数字字符;如果输入为 "123条",使用 parseInt 结合字符串拼接容易掩盖错误逻辑。始终使用正则表达式的 ^ 与 $ 进行全量锚定匹配。
四、全链路排查矩阵与验证确认
为了确保项目中的中文乱码彻底肃清,可以按照下述矩阵进行逐层核验:
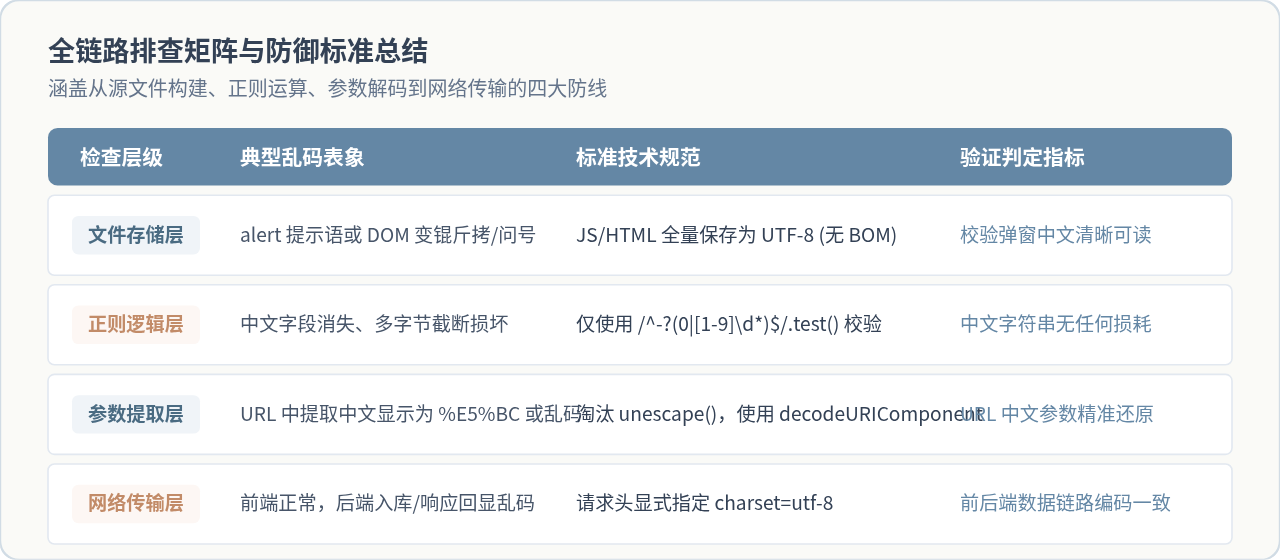
最终验证三步法
- 本地静态检查:打开浏览器开发者工具的 Console 面板,直接测试打印包含中文的校验弹窗或文本。若本地输出正常,说明文件字符集配置无误。
- 字段隔离测试:向测试用例传入包含复杂汉字(如“张三”、“测试订单”、“繁體字”)及合法/非法整数的测试对象,验证在判断整数失败或成功时,中文字段的值和长度(
str.length)是否发生丝毫变化。 - 网络抓包审计:在 Network 选项卡中审查提交的 POST 请求与服务端的 Response。检查 Request Headers 中的
Content-Type是否带有utf-8,确认 Payload 载荷中的中文字符与整数参数均按标准 JSON 原样呈现。
dw怎么用javascript有哪些值得照着做的真实案例
2026-11-08 21:29:11
js函数里面的data参数怎么给新人讲明白
2026-11-07 21:41:09
怎么在JS数组指定位置插入元素
2026-11-06 23:50:23
什么是JS函数组合(Function Composition)及其实现
2026-11-06 21:57:41
使用立即执行函数解决JS循环中闭包捕获变量错误
2026-11-06 20:13:30
相关标签: