办公写作选DeepSeek还是ChatGPT?常见场景下的模型推荐
本文针对办公写作场景,提供DeepSeek与ChatGPT的选型建议。通过拆解任务类型、控制变量对照测试及遵循数据治理原则,帮助用户根据准确性、可用性及合规性做出理性选择,而非盲目依赖模型名气。
在办公写作场景中,不妨将DeepSeek和ChatGPT均视为候选助手,避免仅凭品牌名称做决定。若任务是邮件改写,核心在于语气是否得体;若是整理会议材料,重点则在于信息还原的忠实度。相较于笼统地比较“谁更强”,更有效的做法是将同一份脱敏样稿分别提交给两者,并依据准确性、可修改性、易用性及数据合规性进行打分评估。
先按任务目标区分起草与润色。
先把办公任务拆开看
“写作”涵盖多种工作形态,包括基于要点起草通知、压缩长篇材料、调整行文语气、整理会议纪要,或按固定模板补全文档。不同任务的试错成本差异显著:内部头脑风暴允许措辞后续修正,而面向客户的报价、时间节点、承诺事项及政策内容,则必须逐项严格核实。
鉴于模型算法及产品功能持续迭代,网页端、客户端、API接口或不同账号权限所提供的能力可能存在差异。因此,不宜将单次体验固化为“DeepSeek一定擅长中文”或“ChatGPT更胜润色”等绝对结论。更稳妥的策略是明确输入内容、输出格式及限制条件,进而观察当前可用版本能否精准执行要求。
例如,可向两者下达相同指令:“基于以下三条已确认事实,撰写一封不超过200字的延期通知;禁止添加原因或新日期;保持语气诚恳,并保留联系人字段。”随后检查是否存在事实遗漏、擅自补充原因、字数超标或字段缺失等情况。此类对照测试能直观揭示模型是否契合你的具体工作需求。
哪些场景可以先试DeepSeek
若你已具备合规使用DeepSeek的条件,可将其纳入日常初稿生成的候选流程:例如将个人列出的要点转化为正式通知、压缩段落篇幅,或为既有内容生成多个标题选项。需注意的是,这里的“优先尝试”仅指测试顺序,并不代表其在所有版本或任务类型上均优于其他产品。
建议先让模型处理低风险且易于复核的任务,并记录返工细节:如是否篡改数字、遗漏限定条件、过度确信不确定内容,或需反复解释格式要求。若输出结果符合团队规范,且接入方式、响应稳定性及组织数据规定均可接受,便可将此类任务交由其起草。反之,若频繁需要重写,节省的生成时间可能被复核与返工成本抵消。
哪些场景可以先试ChatGPT
同理,若当前的ChatGPT接入渠道符合所在地区、账号权限及组织合规要求,可使用同一份样稿测试其改写、摘要及结构整理能力。重点观察其能否保留原意、遵守长度与格式限制,以及在接收反馈后能否准确调整。切勿仅凭单个精彩示例便判定其长期表现。
处理复杂材料时,可先要求模型列出“原文明确陈述的事实”与“需进一步确认的空缺”,再行起草。此举虽无法彻底消除错误,但能使复核目标更加清晰。涉及合同、财务、人事、医疗或对外承诺等内容时,必须由责任人核对原始依据,严禁将模型生成内容直接作为审批依据或事实来源。
用一份小样做出自己的选择
选取三至五份已脱敏的真实工作样例,覆盖你常处理的任务类型。分别输入相同指令,并从四个维度记录结果:事实是否发生变更、格式是否得到遵守、达到可用标准所需的修改轮次、操作入口是否符合团队规范。若条件允许,建议间隔数日重复测试,以避免单次偶然输出影响最终判断。
用统一需求比较两边的初稿。
数据处理优先级应高于写作效率。严禁将客户姓名、联系方式、未公开方案或内部凭证直接复制至未经批准的服务中。使用前须确认组织允许的工具范围及数据边界;若无法确认,应使用虚构字段或已脱敏文本进行测试。鉴于隐私选项、数据保留策略及产品入口可能变动,使用前务必查阅当前服务条款及组织的正式说明。
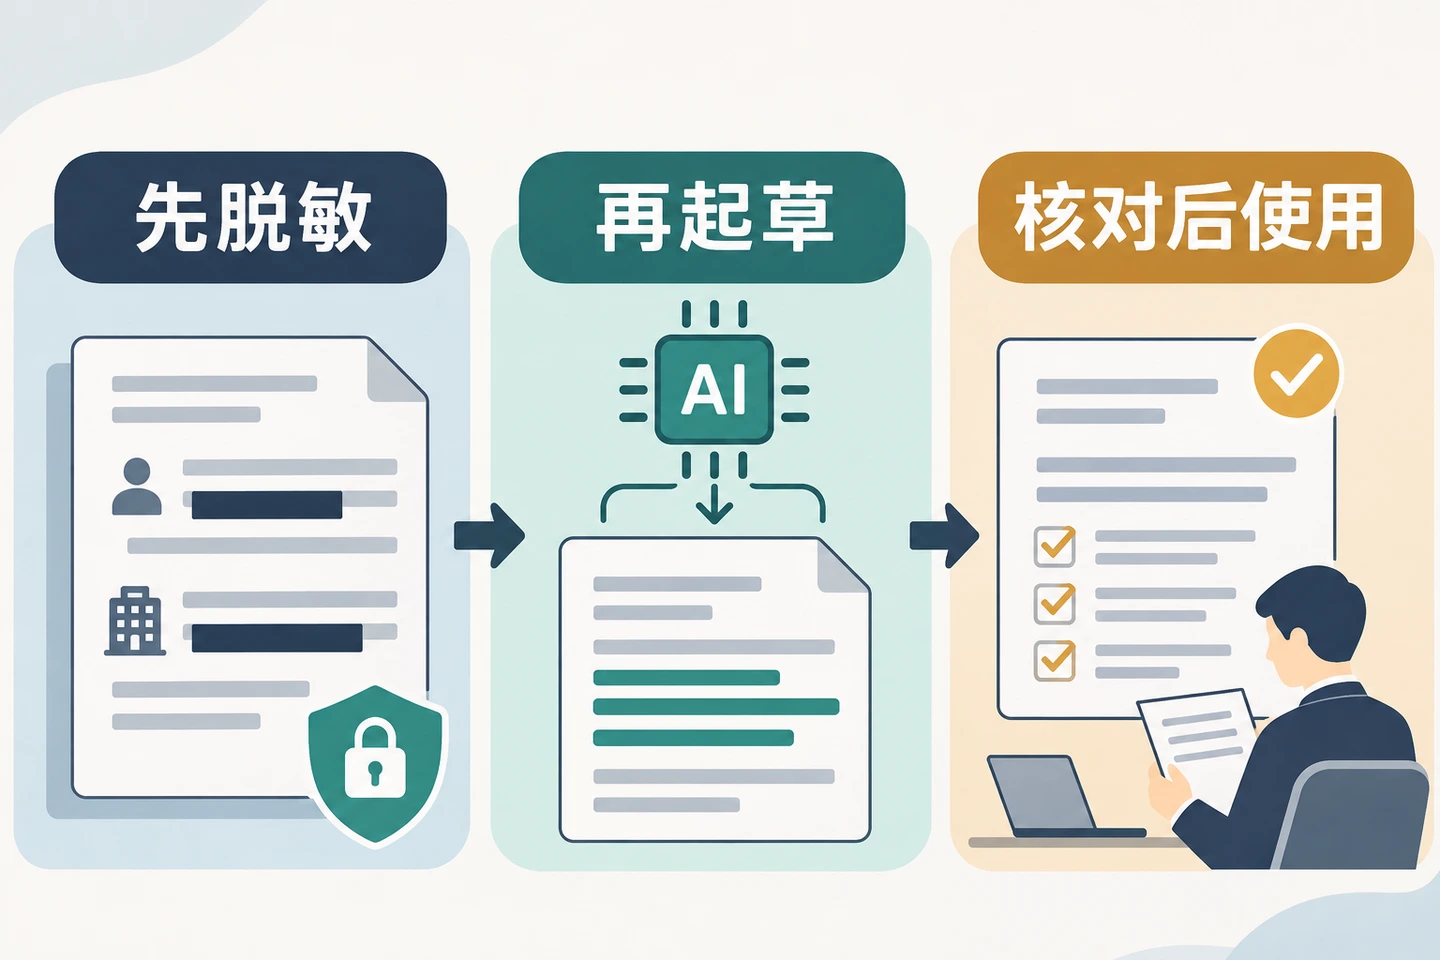
使用AI前先脱敏,输出后再核对。
结论可以很简洁:将两款产品视为动态变化的工具,通过同一任务、同一标准进行横向比较;低风险内容可交由助手起草,但事实准确性与敏感信息仍需由人工严格把关。
Stable Diffusion写实人像与二次元风格提示词案例解析
2026-11-07 23:10:27
VS Code安装通义灵码插件及阿里云账号登录配置
2026-11-07 19:28:53
通义灵码插件连接超时或无法登录怎么解决
2026-11-07 11:17:52
CrewAI vs LangChain vs AutoGen:智能体框架选型对比
2026-11-07 10:46:52
用ChatGPT优化Midjourney提示词:间接实现高质量AI绘图
2026-11-07 09:54:24