

JS中split、正则与URLSearchParams解析URL参数的对比
深入对比JavaScript中通过split拆分、正则表达式匹配与原生URLSearchParams解析URL查询参数的技术原理、实现代码、边界缺陷及选型依据。
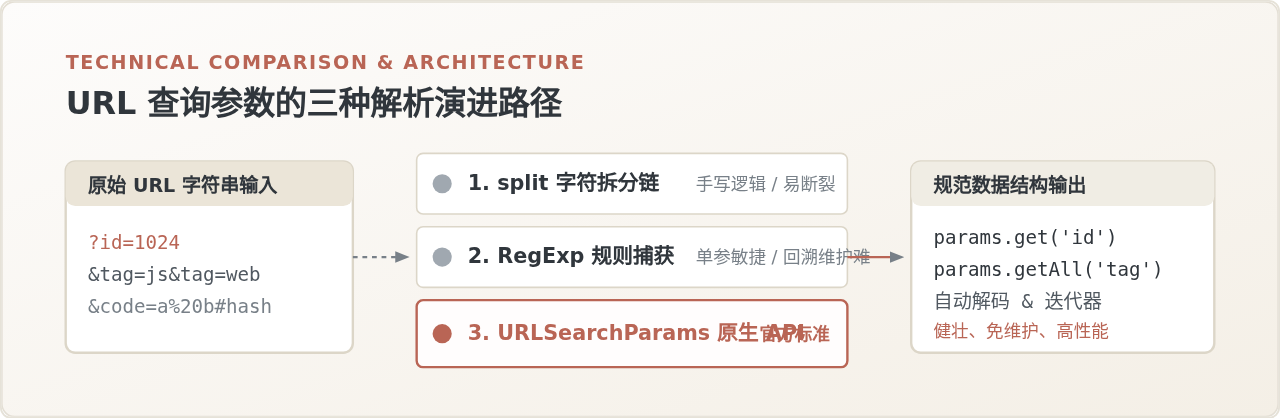
URLSearchParams(或直接使用 new URL(url).searchParams)。它是由 WHATWG 规范标准化的原生接口,天然支持同名多值合并、自动容错首字符问号、开箱即用地按规范转换 + 与百分号编码。相比之下,传统的 split 字符串拆分与正则表达式,不仅需要大量额外代码来处理等号截断、哈希干扰、字符解码等边界缺陷,且代码冗长极易踩坑,仅在无 Polyfill 的极老旧历史系统或超微型单参数匹配脚本中具有权衡存在。
一、URL 查询参数解析的核心诉求与边界挑战
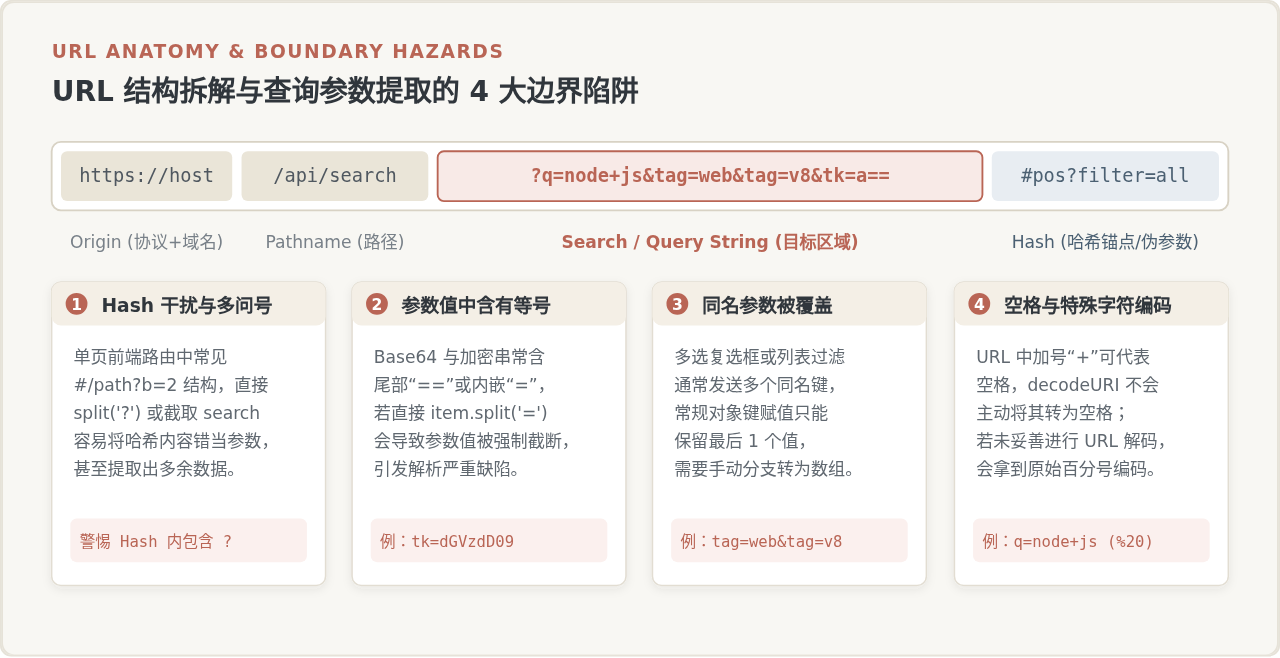
URL(统一资源定位符)的参数承载着前端状态同步、分页筛选、鉴权令牌传递等关键信息。在实际开发中,查询字符串(Query String)远不止 ?a=1&b=2 这样理想的结构,它在真实业务场景下面临诸多边界挑战:
- 前缀与哈希干扰:完整的 URL 包含协议、路径、Query(以
?开头)以及 Hash(以#开头)。若直接在前端截取,当遇到单页应用(SPA)采用 Hash 路由(如https://domain.com/#/list?type=1)甚至双问号时,容易错位提取。 - 参数值内含等号:例如
?token=dGVzdD09&source=web,其中 Base64 编码的 Token 尾部含有两个=字符。若使用简单拆分,参数值会被过早切断。 - 同名参数的多值收集:例如筛选场景中的多选标签
?tag=javascript&tag=typescript&tag=node,需要以数组形态聚合,普通键值对象赋值极易出现“后值覆盖前值”。 - 标准规范的字符编码差异:在 URL 标准(RFC 3986 与 application/x-www-form-urlencoded)中,空格不仅可被编码为
%20,还常常被表单序列化为+。标准解码必须将+还原为空格。 - 无值键与空值键的区别:例如
?preview&filter=中,preview属于无值键(Flag 标志),而filter属于空字符串值。
二、基于 split 的链式拆分法
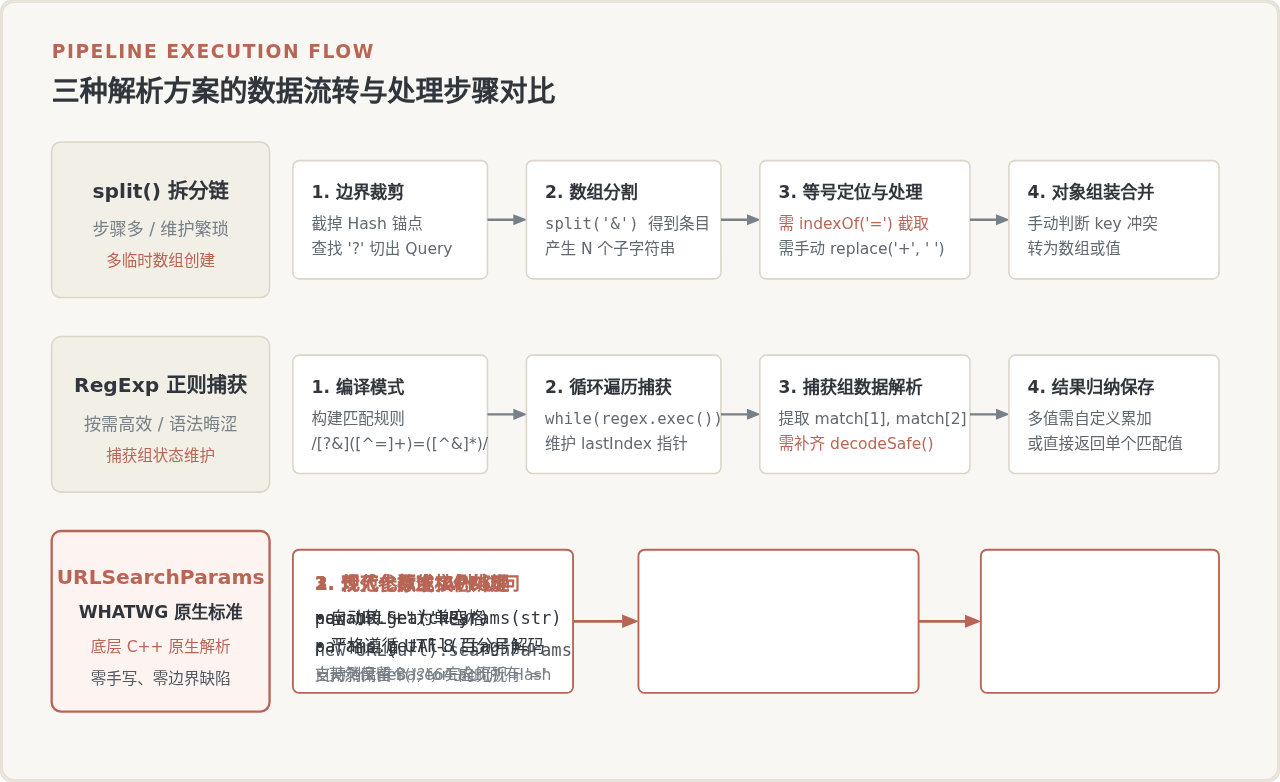
split 是早期前端开发最直观的实现思路:先剔除 ? 前的路径与 # 后的哈希,再通过 & 分割成条目数组,最后针对每条用 = 分割键与值。
1. 健壮版 split 解析函数实现
为了避免上述提到的等号截断与同名参数覆盖,成熟的 split 实现必须包含索引定位与数组累加逻辑:
function parseUrlBySplit(url) {
  const params = {};
  if (!url || typeof url !== 'string') return params;

  // 1. 过滤 Hash 部分,精准提取从 '?' 到 '#' 之间的查询串
  const hashIndex = url.indexOf('#');
  const cleanUrl = hashIndex !== -1 ? url.slice(0, hashIndex) : url;
  const questionIndex = cleanUrl.indexOf('?');
  if (questionIndex === -1) return params;

  const queryString = cleanUrl.slice(questionIndex + 1);
  if (!queryString) return params;

  // 2. 按照 '&' 分割为单个参数对
  const pairs = queryString.split('&');

  for (let i = 0; i < pairs.length; i++) {
    const pair = pairs[i];
    if (!pair) continue;

    // 3. 注意:切忌使用 pair.split('='),防止 Base64 等号被切分
    const eqIndex = pair.indexOf('=');
    let rawKey = '';
    let rawVal = '';

    if (eqIndex === -1) {
      // 无值参数,如 '?view'
      rawKey = pair;
      rawVal = '';
    } else {
      rawKey = pair.slice(0, eqIndex);
      rawVal = pair.slice(eqIndex + 1);
    }

    // 4. 处理 URL 编码:先将 '+' 替换为空格,再 decodeURIComponent
    const key = decodeSafe(rawKey);
    const val = decodeSafe(rawVal);

    // 5. 同名参数转为数组收集
    if (Object.prototype.hasOwnProperty.call(params, key)) {
      if (Array.isArray(params[key])) {
        params[key].push(val);
      } else {
        params[key] = [params[key], val];
      }
    } else {
      params[key] = val;
    }
  }

  return params;
}

function decodeSafe(str) {
  try {
    return decodeURIComponent(str.replace(/\+/g, ' '));
  } catch (e) {
    return str;
  }
}const [k, v] = pair.split('=')?
很多初学者习惯用 ES6 解构写 const [k, v] = item.split('='),这在遇到 token=eyJhbGciOi== 时,解构出来的 v 只保留了等号前第一个片段,导致有效 Token 损毁;必须使用 indexOf('=') 截取第一个等号后面的全部子串。
三、基于正则表达式的规则匹配法
正则表达式(RegExp)在前端通常用于两种诉求:一是仅提取单个指定参数(轻量避免全局拆分),二是全量匹配参数键值对。
1. 仅提取单个指定参数的轻量正则
function getUrlParam(name, url = window.location.href) {
  // 针对参数名中的正则特殊字符进行转义
  const safeName = name.replace(/[\[\]\{}()*+?.,\^$|#\s]/g, '\$&');
  // 匹配 (?|&)name=([^&#]*)
  const regex = new RegExp('[?&]' + safeName + '(=([^&#]*)|&|#|$)');
  const results = regex.exec(url);

  if (!results) return null;
  if (!results[2]) return ''; // 无值参数匹配返回空字符串

  return decodeURIComponent(results[2].replace(/\+/g, ' '));
}
2. 全量解析全部参数的正则实现
function parseUrlByRegex(url) {
  const params = {};
  if (!url) return params;

  // 剥离 hash 避免越界匹配
  const cleanUrl = url.split('#')[0];
  // 匹配模式:([?&])key(=value)?
  const reg = /[?&]([^=#&]+)(?:=([^&#]*))?/g;
  let match;

  while ((match = reg.exec(cleanUrl)) !== null) {
    const rawKey = match[1];
    const rawVal = match[2] !== undefined ? match[2] : '';
    const key = decodeSafe(rawKey);
    const val = decodeSafe(rawVal);

    if (Object.prototype.hasOwnProperty.call(params, key)) {
      if (Array.isArray(params[key])) {
        params[key].push(val);
      } else {
        params[key] = [params[key], val];
      }
    } else {
      params[key] = val;
    }
  }

  return params;
}
四、基于 URLSearchParams 的现代标准方案
URLSearchParams 接口是 WHATWG URL 规范定义的原生类,现代所有主流浏览器(Chrome、Firefox、Safari、Edge)以及 Node.js (v10.0.0+) 均提供完整的内置支持,完全不需要加载任何第三方库。
1. 常见的使用形态
// 场景 A:在浏览器中直接解析当前页面 URL
const searchParams = new URLSearchParams(window.location.search);

// 场景 B:解析任意给定的完整 URL(配合 URL 类使用,体验最顺畅)
const urlObj = new URL('https://example.com/api?id=100&tag=js&tag=css&token=abc==');
const params = urlObj.searchParams;

// 场景 C:直接传入带有或不带 '?' 的查询字符串
const sp = new URLSearchParams('?name=jack&city=shanghai+china');
2. 核心 API 与能力展示
URLSearchParams 针对日常开发提供了语义极其明确的操作方法:
params.get('key'):获取指定键的第一个值。若该键不存在,返回null;若该键为无值参数(如?flag),返回空字符串""。params.getAll('key'):完美解决同名参数问题。返回包含该键所有值的数组,例如params.getAll('tag')直接返回['js', 'css']。params.has('key'):判断是否存在某个参数,返回布尔值。针对?flag,params.has('flag')返回true。Object.fromEntries(params):一键将实例转换为普通的 JavaScript 纯对象(注意:此快捷转换对于同名多值仅保留最后一个值)。
// 全量转化为对象的标准现代写法:
function parseQueryToObject(queryString) {
  const sp = new URLSearchParams(queryString);
  const result = {};

  for (const [key, value] of sp.entries()) {
    if (Object.prototype.hasOwnProperty.call(result, key)) {
      if (Array.isArray(result[key])) {
        result[key].push(value);
      } else {
        result[key] = [result[key], value];
      }
    } else {
      result[key] = value;
    }
  }

  return result;
}
五、三种方案的极限边界用例深度对比
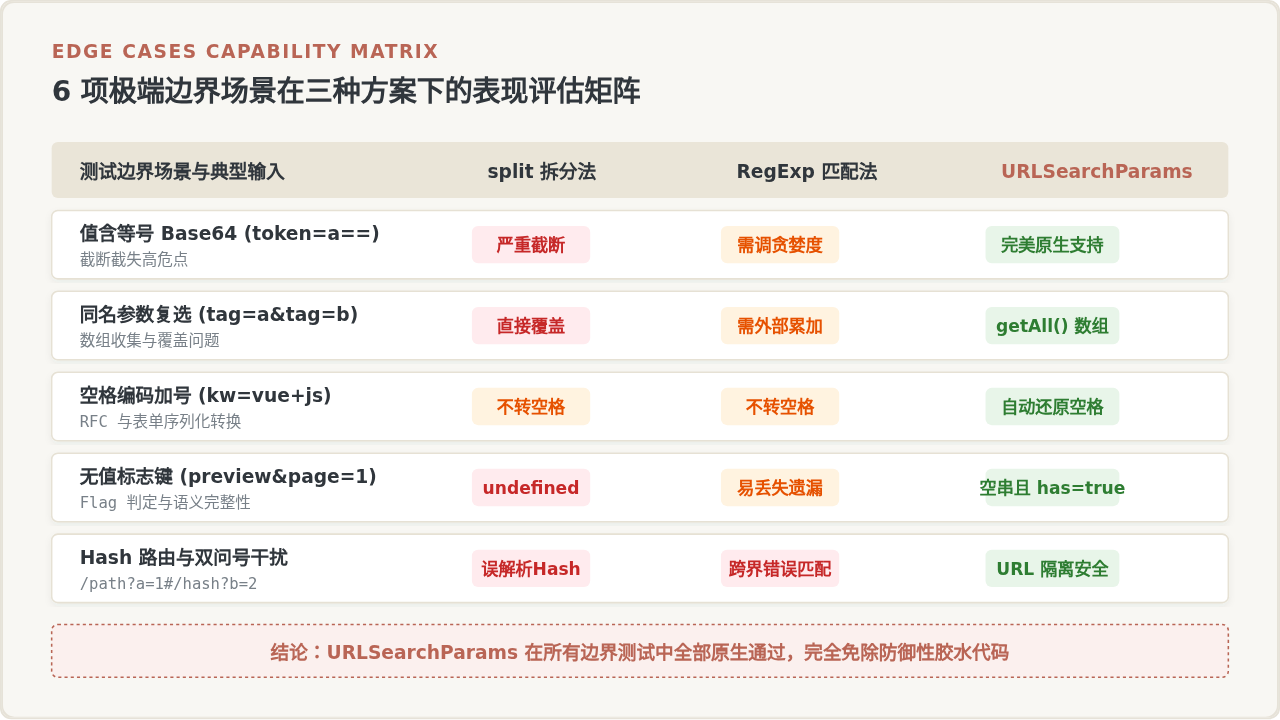
为了直观说明三者在真实开发中的鲁棒性差异,我们使用 6 组具有代表性的极端 URL 用例进行测试对照:
| 测试输入场景 | split 简易拆分法 | RegExp 基础匹配 | URLSearchParams (现代标准) |
|---|---|---|---|
同名多参数?tag=js&tag=web |
易覆盖 需额外手动写数组判断 |
易覆盖 需维护全局迭代累加 |
原生支持getAll('tag') 完美返回数组 |
参数值含等号?tk=eyJhbGciOi== |
值被截断 若用 split('=') 丢失后续内容 |
有条件支持 正则必须精确使用贪婪/非贪婪 |
完美支持 首个等号后全量作为值 |
表单空格加号?kw=hello+world |
保留加号decodeURI 不转加号,需手动替换 |
保留加号 同左,必须额外正则替换 |
自动转换 原生规范解析为 hello world |
纯无值标志键?preview&active=1 |
产生 undefined 拆分后 value 为 undefined |
易匹配丢失 若未定义可选分支会跳过该键 |
规范标准get('preview') 为 "",has 为 true |
带 Hash 的 SPA 链接/page?a=1#/path?b=2 |
易错裁 需手动在 # 前截断,易混淆 |
易串位 全局正则容易跨越 # 匹配 |
配合 URL 自动隔离searchParams 仅作用于真正的 Search |
不带问号的纯 querya=1&b=2 |
依赖前置判断 若依赖 indexOf('?') 则直接落空 |
需适配首字符 正则首字符非 ? 需额外分支 |
宽容输入 无论有无首字符 ? 均同等解析 |
六、技术选型依据与最佳实践指南
综合代码可读性、维护成本、运行性能与规范符合度,针对不同场景的技术选型建议如下:
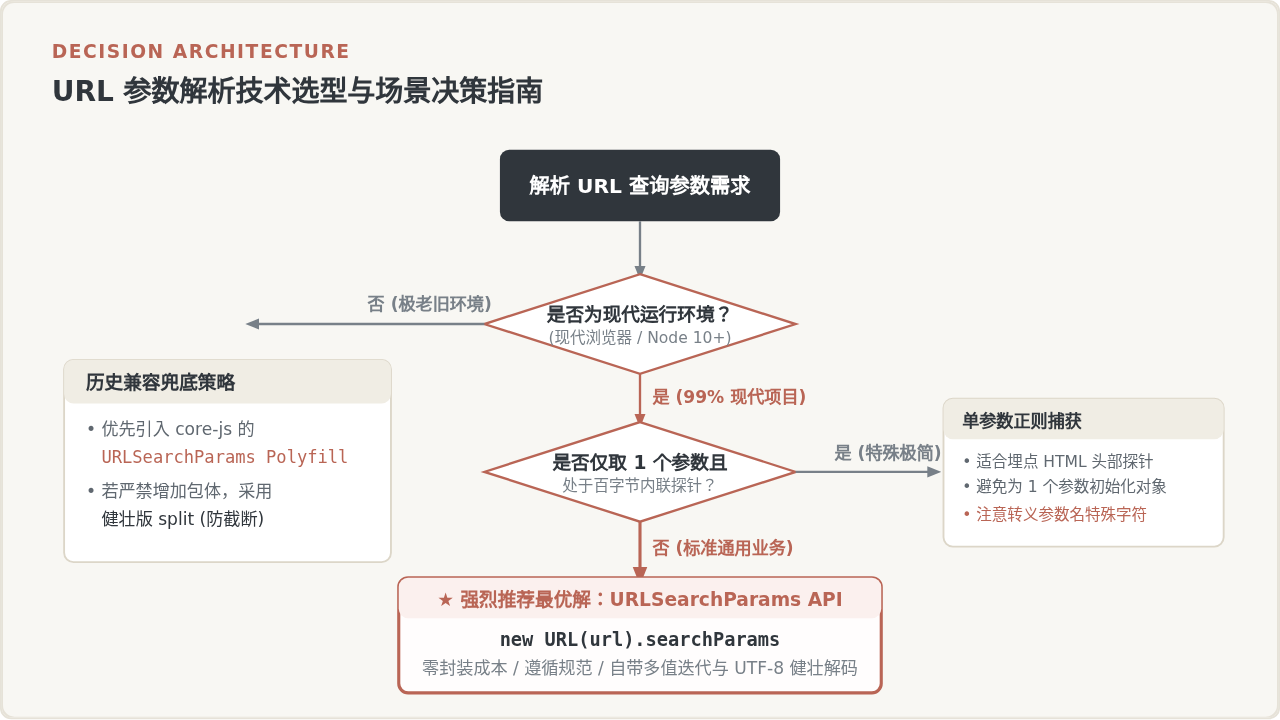
总结与行动建议
- 弃用手写 split 字符串切割:手写
split看似门槛低,但要写出一个能够兼顾等号截断、加号转空格、无值键与同名数组的健壮函数,需要数十行满是边界判断的胶水代码,得不偿失。 - 谨慎对待全量正则:全量提取的全局正则模式可读性差,当遇到非标准编码或复杂字符集时排查成本极高;正则表达式仅适合保留在纯静态、无依赖的单参数探针脚本中。
- 坚定采用
URLSearchParams:它是当前全端标准的正解。配合new URL(url, window.location.origin),不仅能够一步到位解决 Hash 与路径分离的问题,更能以最少的代码量提供最高级别的工程稳定性。
JavaScript闭包与类(Class)的区别及适用场景对比
2026-11-05 15:48:57
JavaScript入门要学ES6吗?let与箭头函数等新特性解析
2026-11-05 14:49:16
JavaScript 8种数据类型详解:基本类型与引用类型的区别
2026-11-05 14:25:15
怎么在JavaScript中使用async/await优化Ajax异步流程
2026-11-05 13:56:15
JavaScript replace回调函数实现动态正则替换逻辑
2026-11-05 13:52:13







