JS闭包实现柯里化函数的原理与代码示例
深入剖析JavaScript中利用闭包实现柯里化函数的运行原理与堆内存词法环境暂存机制,提供支持任意参数组合与上下文保全的通用curry代码示例,并详细解答元数截断、this丢失等边界问题。
一、柯里化与闭包的核心协同机制
要彻底掌握柯里化,首先需要明确它与普通函数调用的本质差异。在传统的多元函数调用中,所有实参必须在单次调用时全部提供,例如 fn(a, b, c)。如果某些参数在当前阶段尚未生成,开发者往往需要声明中间变量或编写繁琐的包裹函数。
柯里化则打破了这种一次性限制,将原本的多参函数转换为链式调用形态:curried(a)(b)(c)。值得注意的是,工业级实现通常支持灵活的传参组合,例如允许写成 curried(a, b)(c) 或 curried(a)(b, c)。
1. 为什么柯里化必须依赖闭包?
在 JavaScript 引擎中,普通函数的执行依赖调用栈(Call Stack)。当一个普通函数被调用时,引擎会为其分配一个执行上下文(Execution Context)压入栈顶;函数执行完毕后,该栈帧会立即弹出,栈内分配的局部变量随之被标记清理。
柯里化函数面临的核心挑战在于:第一次调用传入的参数,如何在第二次、第三次乃至更晚的独立调用中依然被访问到?
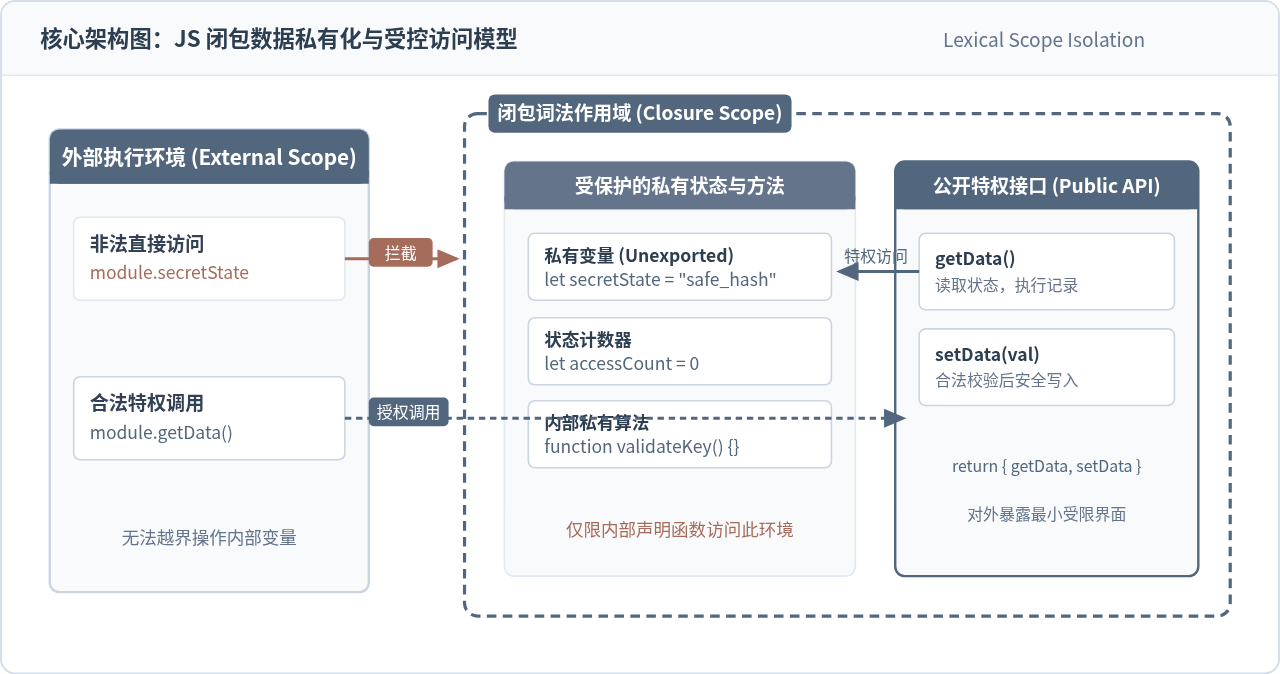
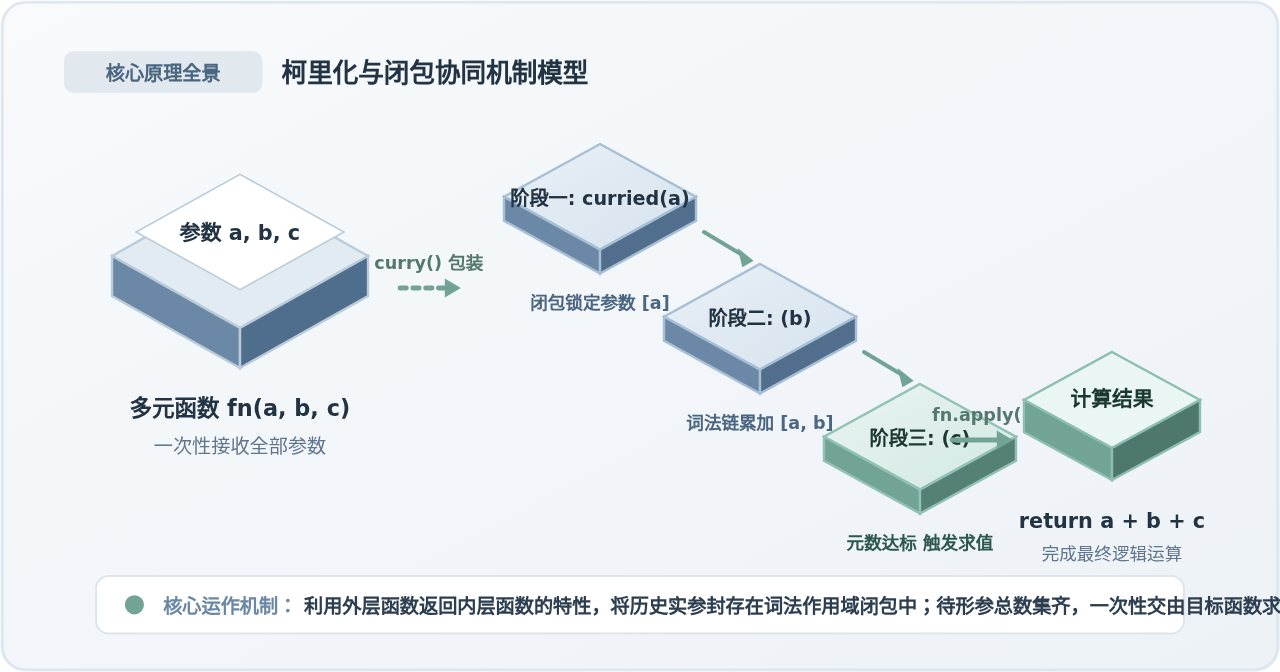
这正是闭包发挥作用的关键所在。根据 ECMAScript 规范,当一个内部函数引用了外部函数的变量,并且该内部函数被返回并在外部保留存活引用时,外部函数的词法环境(Lexical Environment)不会随执行栈的弹出而销毁,而是被保存在堆内存(Heap Memory)中。返回的新函数内部的内部属性 [[Scopes]] 会持有指向该词法作用域的引用链。
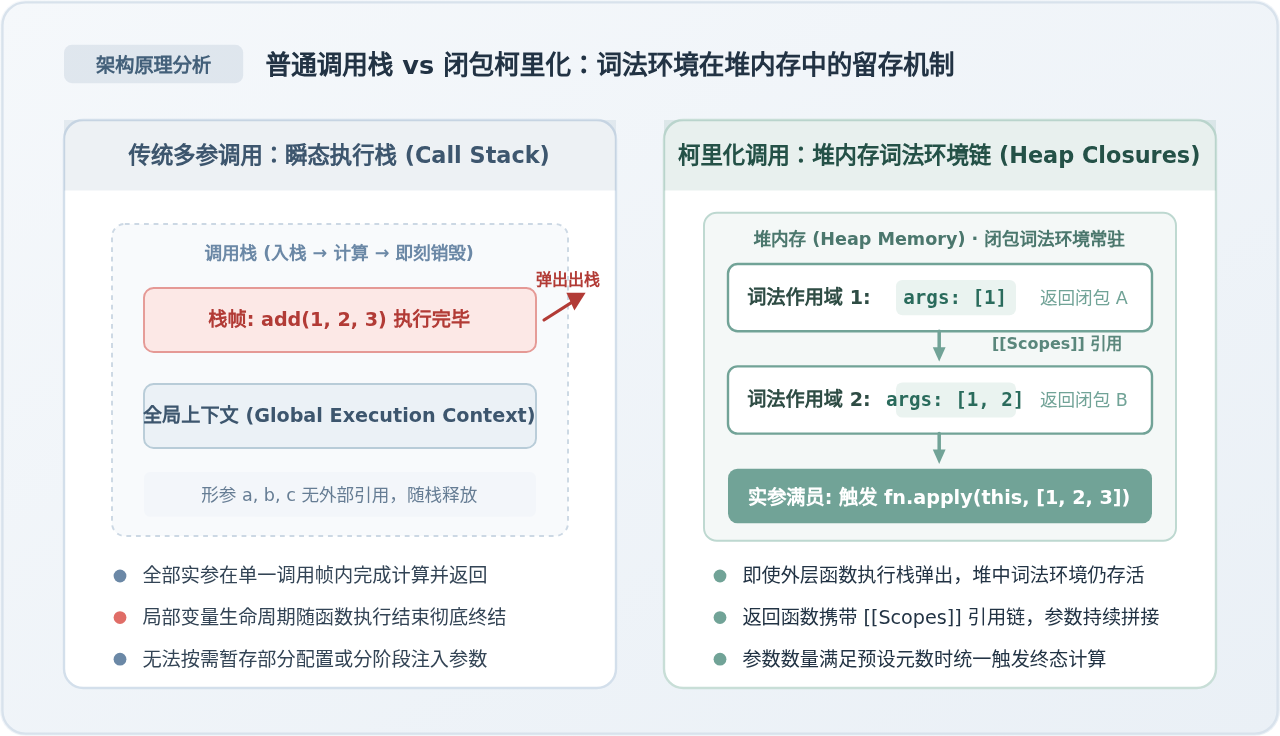
如图 1 所示,柯里化正是利用闭包充当了“参数暂存容器”。外层每次接收到新参数后,都会将新实参合并追加到当前闭包持有的参数数组中,并生成一个新的闭包函数返回给调用方。整个链路在堆内存中串联起一条作用域链,使历史参数在多次调用生命周期中始终驻留。
二、从基础到通用:柯里化函数的代码推导
1. 固定三参数的手工闭包实现
为了直观理解参数在闭包中的流转过程,我们先从一个最简单的三数相加函数入手,手动编写嵌套闭包:
// 原始三数相加函数
function add(a, b, c) {
  return a + b + c;
}

// 手工编写的三层嵌套闭包柯里化
function curriedAddManual(a) {
  return function(b) {
    return function(c) {
      // 内层函数通过闭包同时访问外层作用域中的 a、b 与当前作用域中的 c
      return a + b + c;
    };
  };
}

// 调用测试
const step1 = curriedAddManual(1);      // 返回函数,闭包暂存 a = 1
const step2 = step1(2);                // 返回函数,闭包暂存 b = 2 (作用域链中包含 a=1)
const result = step2(3);               // 计算 1 + 2 + 3,返回 6
console.log(result);                   // 输出: 6
这种硬编码嵌套的代码结构存在致命缺陷:它只能处理形参固定为 3 个的特定函数,既无法接受其他参数数量的函数,也不支持 curriedAddManual(1, 2)(3) 这样的混合传参形态。因此,我们需要设计通用的柯里化包装器。
2. 通用柯里化包装器的核心逻辑设计
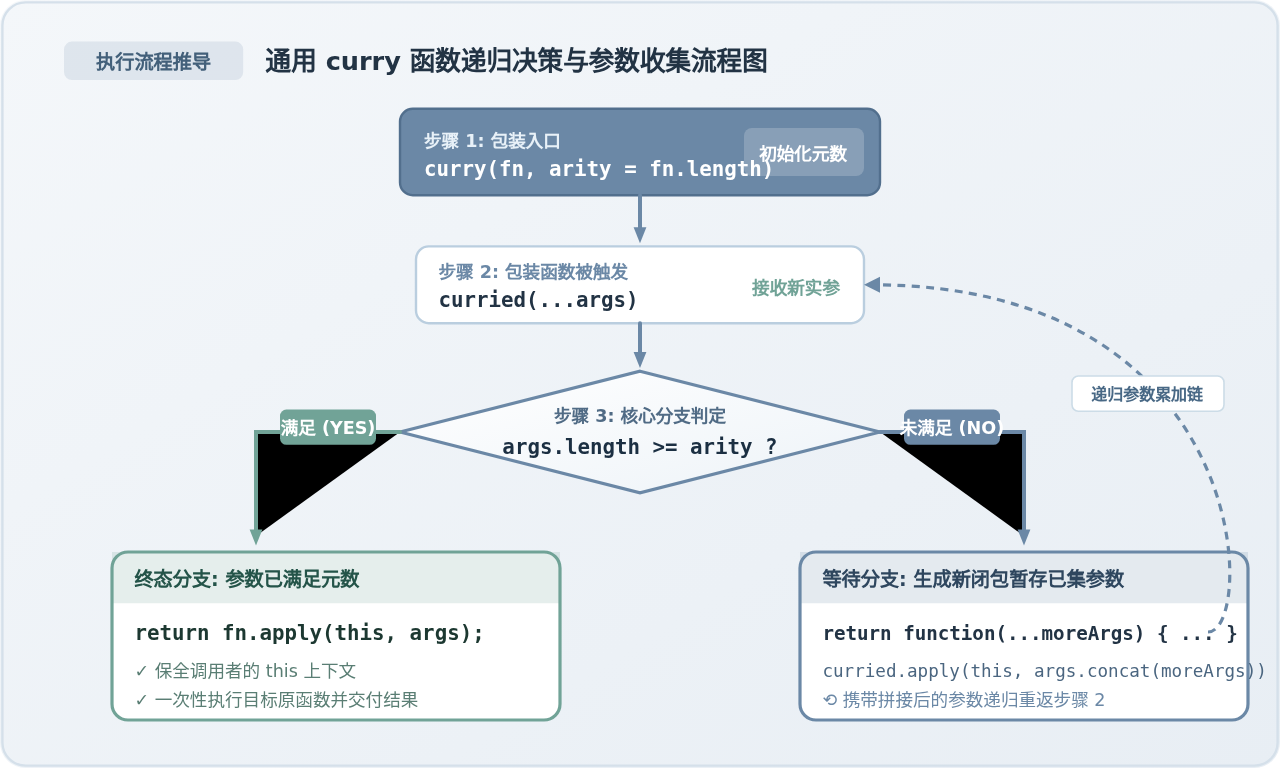
一个工业级的通用柯里化函数,需要完成以下四项核心设计:
- 元数探测(Arity Detection):通过读取函数的
fn.length属性,获取目标函数预期的形参数量。 - 动态参数合并:使用数组收集每次调用传入的所有实参(借助 Rest 参数或
concat)。 - 条件分支裁决:若累加的实参总数达到或超过预期元数,立即调用原函数并返回求值结果;否则返回新的闭包函数继续等待后续参数。
- 执行上下文保全:在整个调用链路中使用
apply或call透传调用者的this,防止方法调用时的上下文漂移。
3. 通用 curry 函数的标准代码实现
结合上述流程推导,标准的通用柯里化函数实现代码如下:
/**
 * 通用柯里化包装函数
 * @param {Function} fn 需要柯里化的目标函数
 * @param {number} [arity=fn.length] 目标函数的形参元数(可选,用于处理默认参数等边界场景)
 * @returns {Function} 柯里化后的包装函数
 */
function curry(fn, arity = fn.length) {
  // 返回一个具名包装函数,便于内部递归引用
  return function curried(...args) {
    // 分支一:累积的实参数量已满足或超过预期形参数量
    if (args.length >= arity) {
      // 保全当前 this 上下文,直接执行原函数并返回结果
      return fn.apply(this, args);
    }

    // 分支二:参数尚未凑齐,返回新的闭包函数继续收集
    return function(...moreArgs) {
      // 将已有实参 args 与本次新传入的 moreArgs 拼接合并
      // 递归调用 curried,同时将当前的 this 上下文无缝穿透传递
      return curried.apply(this, args.concat(moreArgs));
    };
  };
}
4. 执行步进剖析:以 curried(1)(2, 3) 为例
我们以执行 const curriedSum = curry((a, b, c) => a + b + c); curriedSum(1)(2, 3); 为例,完整拆解内部运行步骤:
- 初始化:调用
curry(fn),读取fn.length === 3,返回第 1 层包装函数curried。 - 第一次调用
curriedSum(1):- 进入
curried,接收到实参列表args = [1]。 - 判断条件:
args.length (1) >= arity (3)为false。 - 走入等待分支,返回匿名闭包函数
function(...moreArgs)。此时,变量args = [1]被锁定在该闭包的作用域中。
- 进入
- 第二次调用
(2, 3):- 触发上一步返回的匿名闭包函数,接收到实参列表
moreArgs = [2, 3]。 - 执行参数拼接:
args.concat(moreArgs)生成全新的参数数组[1, 2, 3]。 - 执行
curried.apply(this, [1, 2, 3]),递归再次进入curried函数。
- 触发上一步返回的匿名闭包函数,接收到实参列表
- 再次判定与终态求值:
- 在递归调用中,新的
args.length (3) >= arity (3)为true。 - 执行
fn.apply(this, [1, 2, 3]),原函数执行计算1 + 2 + 3 = 6,并将结果直接向上返回。
- 在递归调用中,新的
三、必须掌握的边界条件与避坑细节
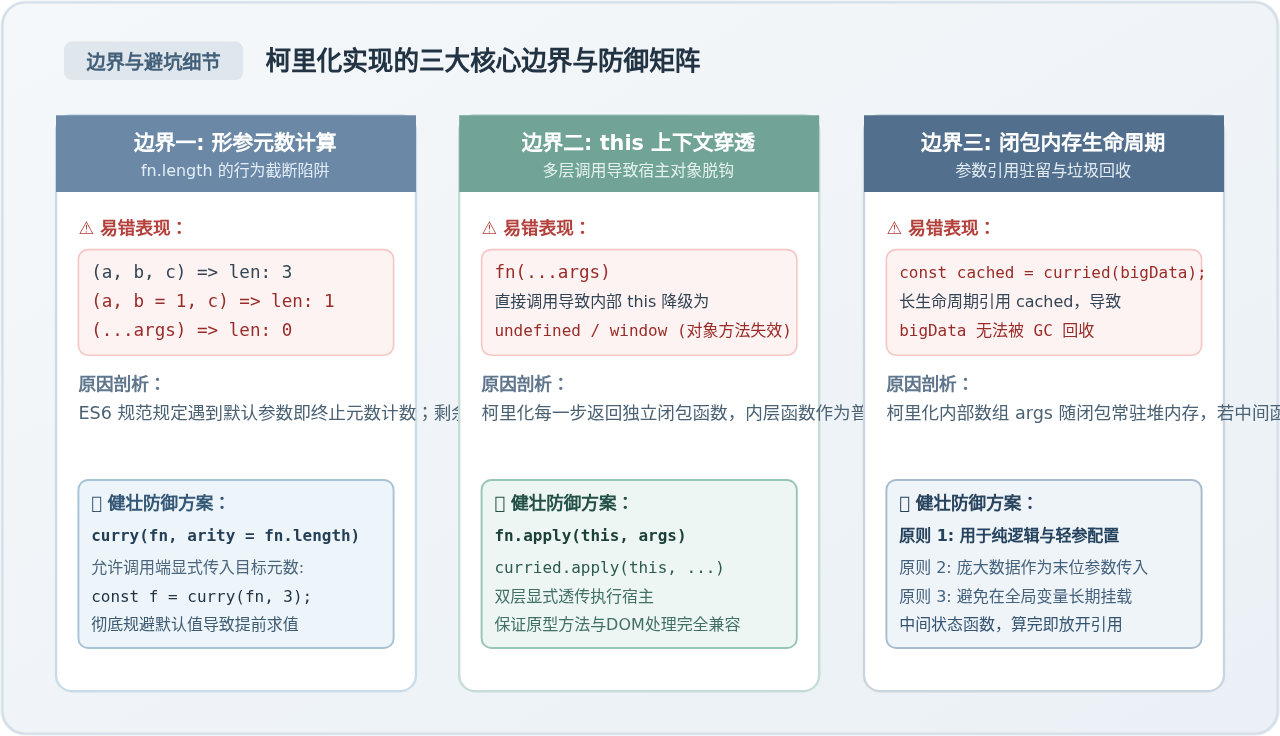
许多初学者在自制柯里化工具时,往往只在简单 Demo 中运行良好,但在复杂生产代码中却频频报错。这是因为忽略了 JavaScript 语言层面的三大特殊边界。
1. 形参长度(fn.length)的计算陷阱与规避
在 ECMAScript 规范中,函数的 length 属性并不是简单地统计参数名总数,而是遵循以下规则:
- 普通参数正常统计:
((a, b, c) => {}).length为 3。 - 遇到默认参数即刻截断:一旦某个形参定义了默认值,该形参及后续所有形参均不再计入 length。例如
((a, b = 10, c) => {}).length的值为 1,而不是 3。 - 剩余参数完全不计入:使用 Rest 参数定义的函数,例如
((...args) => {}).length,其值恒为 0。
curry(fn),当传入第 1 个参数时,由于 1 >= fn.length (1) 判定成立,柯里化函数会提前触发原函数求值,导致后续参数无法正常传入。
防御方案:在通用实现的参数声明中提供可选的 arity 参数:function curry(fn, arity = fn.length)。调用方在柯里化含默认值或剩余参数的函数时,可以显式声明期望的实参总数,例如:
const complexFn = (a, b = 10, c = 20) => a + b + c;
// 显式指定预期元数为 3,防止因 length === 1 导致提前求值
const curriedComplex = curry(complexFn, 3);
console.log(curriedComplex(1)(2)(3)); // 正常输出: 6
2. 执行上下文(this 绑定)的穿透保持
在面向对象编程或基于事件驱动的代码中,目标函数内部往往依赖 this 访问宿主对象的属性。例如:
const calculator = {
  factor: 10,
  multiply(a, b) {
    return (a + b) * this.factor;
  }
};
如果柯里化内部写成 return fn(...args) 或在闭包中直接以普通函数方式触发下一层,那么调用时的对象上下文就会丢失,this 将退化为严格模式下的 undefined 或浏览器环境的 window。
防御方案:在两处关键调用位置坚决使用 .apply(this, ...):
- 在执行原函数时:
return fn.apply(this, args); - 在闭包递归调用下一轮包装器时:
return curried.apply(this, args.concat(moreArgs));
这样无论用户采用链式调用还是绑定到对象属性后调用,宿主对象的引用都能穿透层层闭包,完好无损地抵达原函数。
3. 闭包内存开销与生命周期控制
闭包之所以强大,是因为它强制让局部作用域在堆内存中长久驻留。然而,这也意味着只要返回的柯里化闭包函数仍然被全局变量或长生命周期对象引用,其词法作用域中持有的所有实参就无法被垃圾回收器释放。
- 参数体积排序:将体量小、可复用的配置项(如配置对象、标识符、规则)放在前位参数;将体积庞大、易变的数据源(如超大数组、DOM 节点、文件 Buffer)放在最后一位传入。
- 避免无意持久化中间态:如果某个中间态函数捕获了大型临时数据,应在任务完成后及时将其置为
null,切断闭包引用链,以便 V8 引擎能及时进行垃圾回收。
四、实际工程应用场景与实战示例
1. 场景一:参数预置与高阶数据校验器
在实际的前端或 Node.js 开发中,柯里化最经典的使用价值是“参数预置(Partial Configuration)”。通过先传入校验规则,生成一个专门用途的小型校验函数,以便无缝配合数组的原生高阶函数(如 map、filter)使用。
// 基础正则匹配函数:接收正则规则、目标字段名以及待校验数据对象
const checkField = curry((regex, fieldName, record) => {
  return Boolean(record && regex.test(record[fieldName] || ''));
});

// 通过预置前置参数,生成专用的单参校验器
const isValidEmail = checkField(/^[^\s@]+@[^\s@]+\.[^\s@]+$/, 'email');
const isValidPhone = checkField(/^1[3-9]\d{9}$/, 'phone');

// 模拟用户列表数据
const userList = [
  { id: 101, name: '张三', email: 'zhang@test.com', phone: '13800000001' },
  { id: 102, name: '李四', email: 'invalid-email', phone: '13900000002' },
  { id: 103, name: '王五', email: 'wang@test.com', phone: 'invalid-phone' }
];

// 直接将预置闭包作为谓词函数传递给 filter,逻辑表达极为清晰
const legitimateEmailUsers = userList.filter(isValidEmail);
const legitimatePhoneUsers = userList.filter(isValidPhone);

console.log('邮箱合规用户 ID:', legitimateEmailUsers.map(u => u.id)); // [101, 103]
console.log('手机合规用户 ID:', legitimatePhoneUsers.map(u => u.id)); // [101, 102]
在上述代码中,如果使用传统的非柯里化函数,每次过滤都需要在 filter 内显式书写箭头函数 userList.filter(u => checkField(regex, 'email', u))。柯里化把通用函数抽象成了专用的业务谓词,显著提升了代码的简洁度与可读性。
2. 场景二:分层业务日志与请求前缀封装
另一个非常实用的场景是多级别、多模块日志打印器的封装。日志输出通常需要包含模块名称、环境标识、日志级别和具体日志文本。
// 基础通用日志格式化函数
const logMessage = curry((moduleName, logLevel, message) => {
  const time = new Date().toTimeString().split(' ')[0];
  return `[${time}] [${moduleName}] [${logLevel}] - ${message}`;
});

// 固定业务模块,得到模块专用日志函数
const authLogger = logMessage('AUTH_MODULE');

// 进一步固定日志等级,得到特定级别的专用打印接口
const authInfo = authLogger('INFO');
const authError = authLogger('ERROR');

// 业务代码中直接调用,无需重复传递模块名与级别
console.log(authInfo('用户成功获取登录验证码'));
console.log(authError('Redis 缓存连接超时重试失败'));
五、全景知识总结与核心速查
综上所述,JavaScript 闭包与柯里化不仅是面试中的经典考点,更是函数式编程范式在前端工程中的典型应用。理解其运行机制的核心在于掌握作用域链与堆内存生命周期的交互。
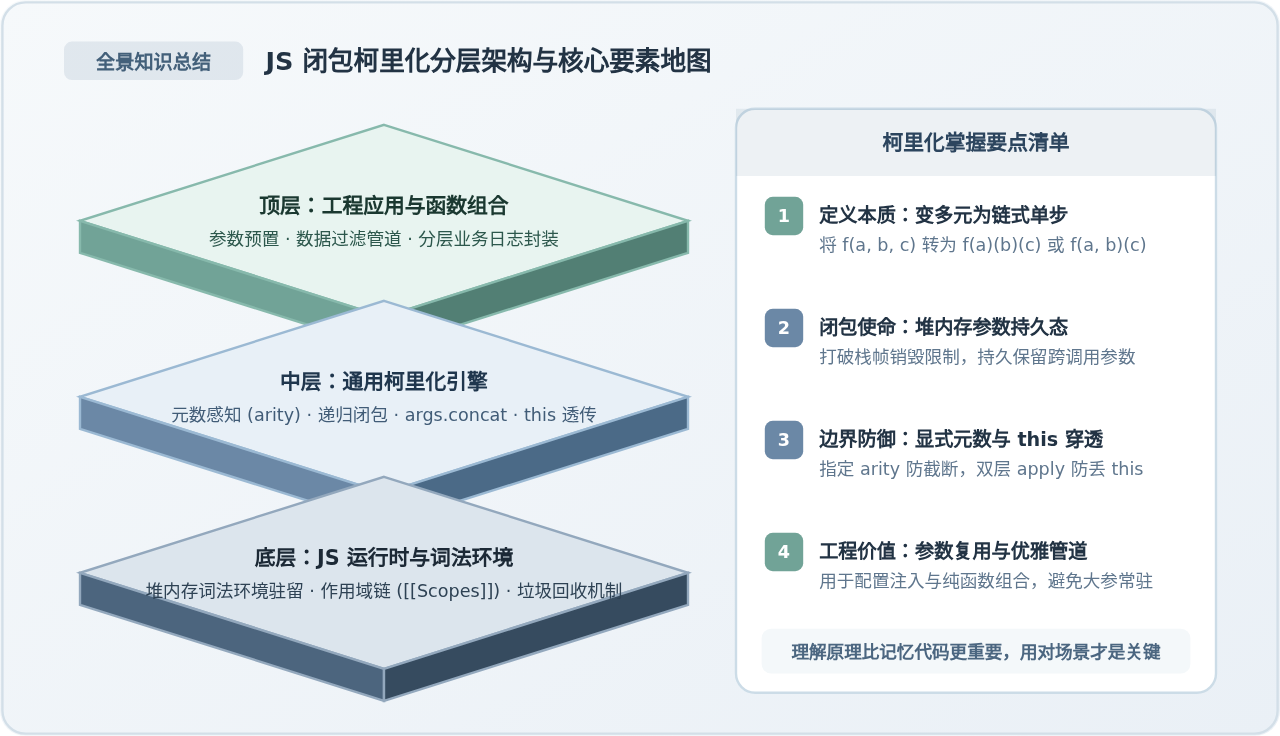
在实际编码实践中,请牢记以下四点核心准则:
- 看透闭包本质:闭包在此处的核心职能是“暂存器”,它利用返回函数的词法引用,打破调用栈局部变量即刻释放的常规生命周期。
- 防御默认参数截断:原生
fn.length遇到默认参数或 Rest 参数时会出现计数失真,通用工具务必提供可选的arity覆盖参数。 - 保全上下文透传:在所有返回的包装函数与终态执行中,始终使用
fn.apply(this, args)严谨传递this,保证与面向对象及 DOM 事件的完美兼容。 - 重在实用,切忌滥用:柯里化最适合用于“配置固定、数据流变”的纯函数管道和谓词过滤场景;对于调用关系简单直接、无复用需求的普通业务逻辑,无需强行柯里化,保持简洁即可。
ES6模块化中js文件怎么用import和export交互
2026-11-05 17:00:48
JS读取本地文件时报错或无响应的常见原因
2026-11-05 16:32:31
let、const与var的区别:JavaScript变量声明最佳实践
2026-11-05 14:16:38
JS中直接定义静态二维数组的字面量写法
2026-11-05 14:16:08
JS 怎么查找字符串中所有匹配项的位置
2026-11-05 14:15:53