

前端API数据处理中JavaScript解构赋值的最佳实践
深入剖析前端在消费和清洗后端API数据时,使用JavaScript解构赋值的核心模式、字段重命名技巧、防御性多层兜底策略,以及应对null与undefined差异的实用工程指南。
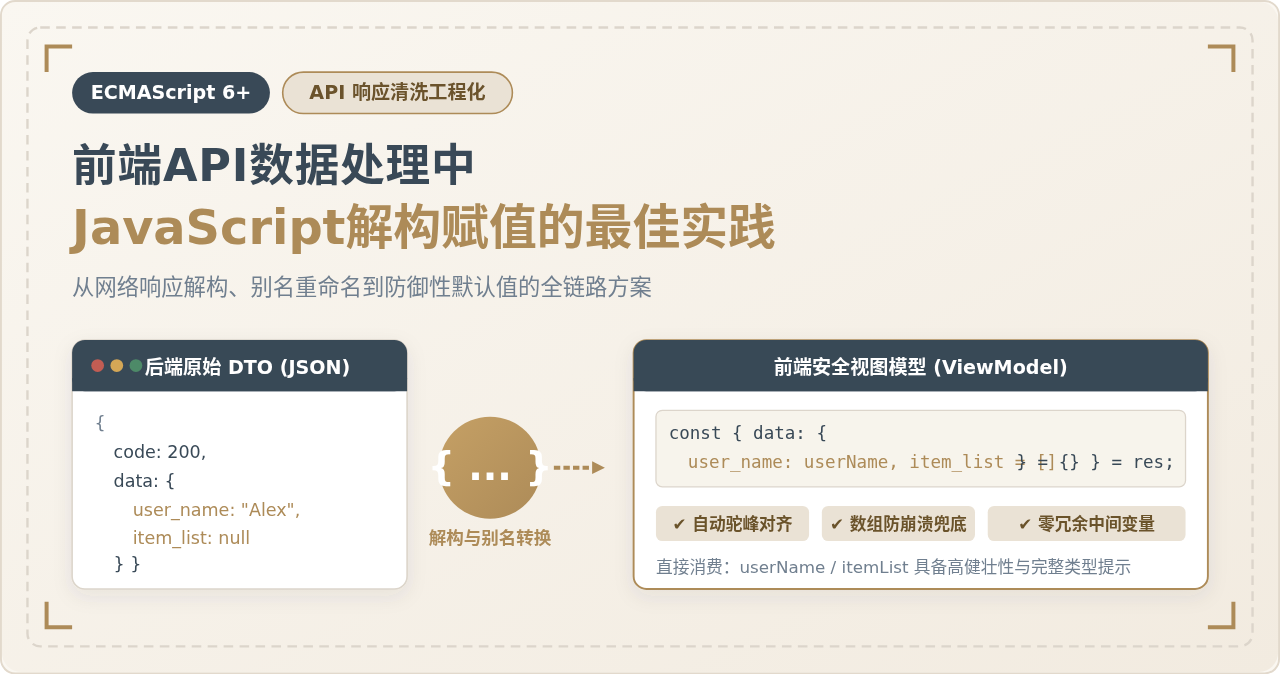
一、痛点与本质:从命令式逐层点操作到声明式模式匹配
在传统的前端开发实践中,从接口返回结果中提取数据通常依赖连续的点操作符(response.data.data.list)。这种命令式取值方式存在三大隐患:一是样板代码冗长,充斥着大量的临时中间变量;二是容错成本高昂,只要中间某一级对象为 null 或 undefined,直接执行深层属性读取就会抛出致命的 TypeError: Cannot read properties of undefined,导致页面白屏;三是逻辑碎片化,字段校验、默认值兜底和重命名混杂在业务代码中,可读性极差。
JavaScript 的解构赋值本质上是一种模式匹配(Pattern Matching)机制。它允许开发者直接声明目标对象的内部骨架,由 JavaScript 引擎自动在数据源中寻址并完成局部变量的创建与绑定。这意味着数据的“提取形态”与“原始结构”形成了一一映射,显著提升了数据流转的自解释性。
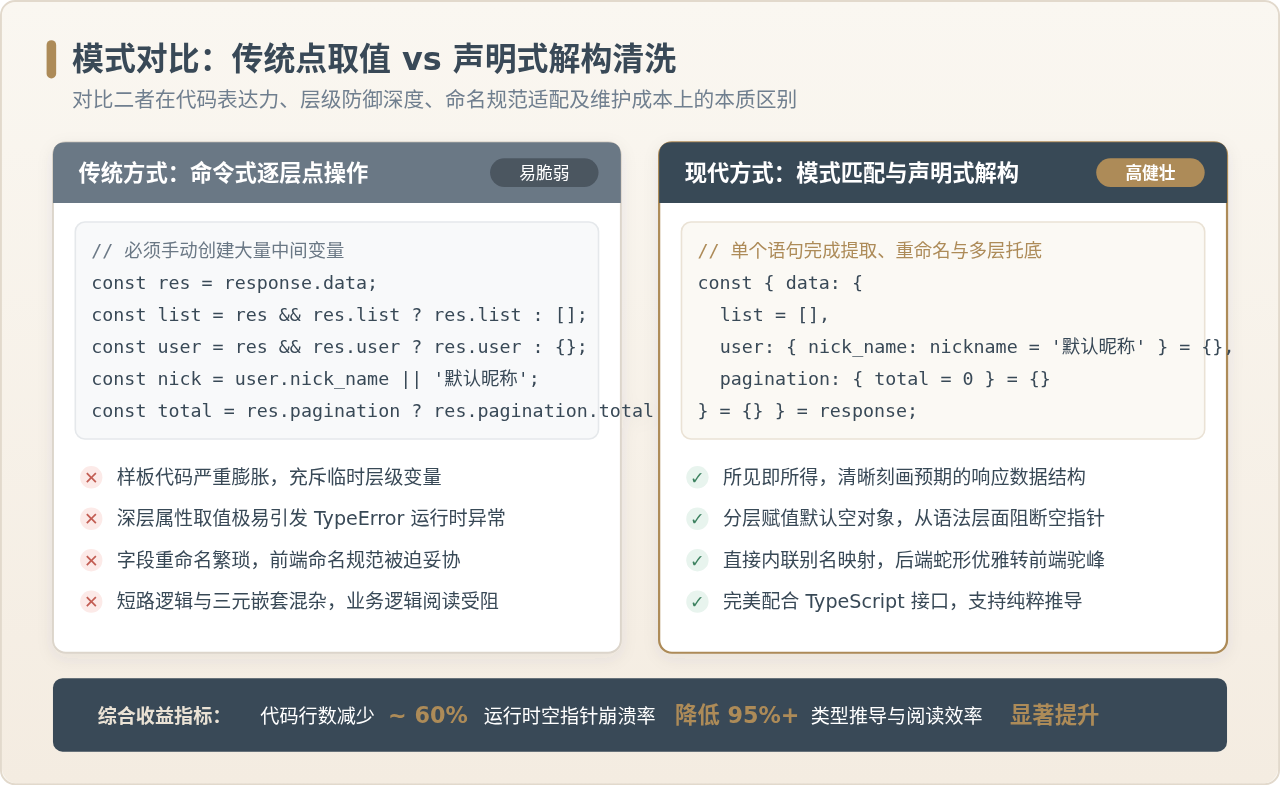
下面的代码直观展现了两种模式在处理分页列表接口时的差异:
// ❌ 传统命令式取值:脆弱且充斥防御样板代码
function renderUserListTraditional(response) {
  const resData = response && response.data ? response.data : {};
  const recordList = resData.records ? resData.records : [];
  const pagination = resData.pagination ? resData.pagination : {};
  const total = pagination.total_count !== undefined ? pagination.total_count : 0;
  const currentPage = pagination.page_no || 1;

  // 业务消费...
}

// ✔ 声明式解构赋值:单语句完成解构、层级托底与重命名
function renderUserListModern(response) {
  const {
    data: {
      records: userList = [],
      pagination: { total_count: total = 0, page_no: page = 1 } = {}
    } = {}
  } = response || {};

  // 此时 userList、total、page 均已就绪且确保不为 undefined
}
二、字段重命名(Alias):抹平前后端命名鸿沟与冲突
在全栈协作中,后端系统(如 Python、Go、MySQL)普遍使用下划线蛇形命名法(snake_case,例如 user_id、created_at、article_type),而前端代码库则严格遵守小驼峰命名法(camelCase)。如果直接将下划线字段引入组件或状态管理库,会导致代码风格撕裂,甚至引发 ESLint 语法检查告警。
解构赋值提供了优雅的冒号重命名语法:{ source_key: targetVariable }。需要特别理解其内部机制:冒号左侧是要在数据源中寻找的属性名,而冒号右侧才是在当前局部作用域中正式声明的变量名。
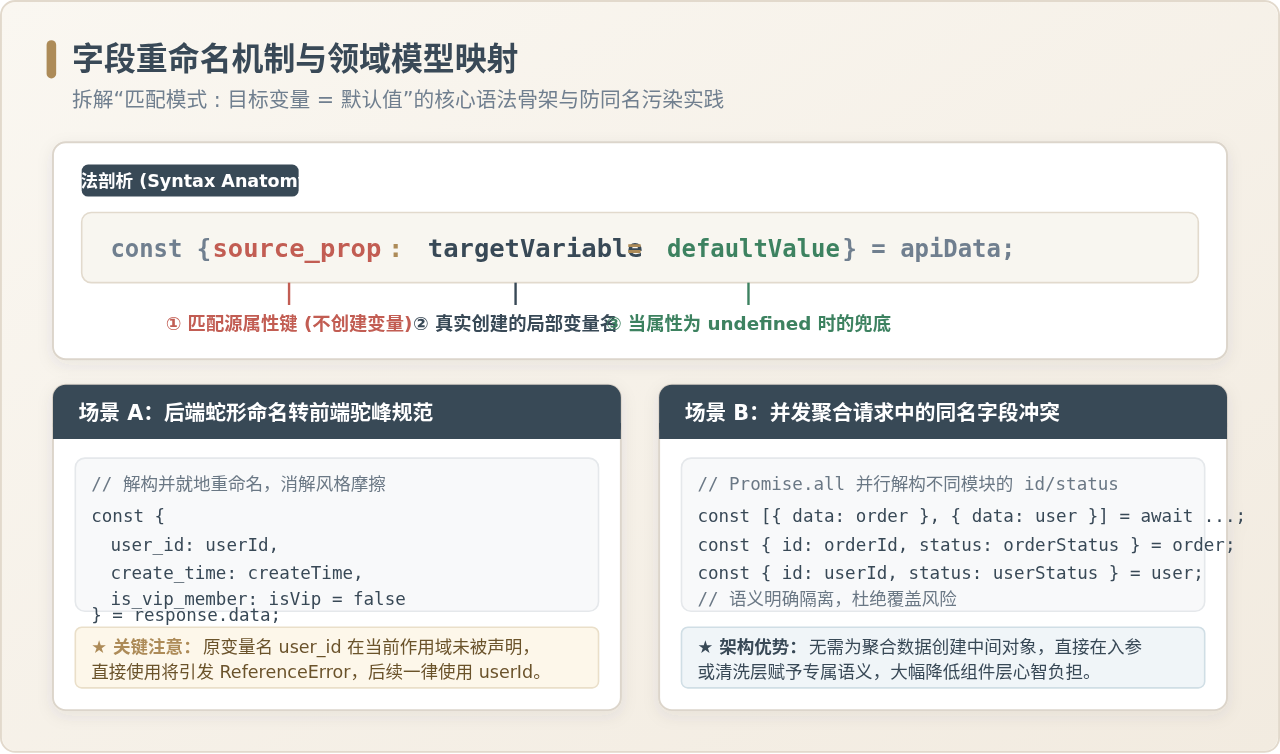
一旦对属性使用了重命名,原有的源属性名将不会被注册为变量!例如执行 const { user_id: userId } = res.data; 之后,当前上下文中只有变量 userId,如果尝试访问 user_id,JavaScript 引擎会立即抛出 ReferenceError: user_id is not defined。
重命名在处理多个并发接口的聚合(Aggregation)时尤为关键。例如使用 Promise.all 同时请求订单详情和商品详情时,二者往往都包含名为 id 和 status 的根字段。通过解构重命名,可以直接在提取阶段划分清晰的命名空间:
// 场景:合并不同 API 响应,消解通用字段重名冲突
async function fetchOrderDetail(orderNumber) {
  const [orderRes, productRes] = await Promise.all([
    apiClient.get(`/api/orders/${orderNumber}`),
    apiClient.get(`/api/orders/${orderNumber}/product`)
  ]);

  // 解构并即时赋予具备领域语义的命名
  const { id: orderId, status: orderStatus, create_time: createTime } = orderRes.data || {};
  const { id: productId, status: productStockStatus, price } = productRes.data || {};

  return {
    orderId,
    orderStatus,
    createTime,
    productId,
    productStockStatus,
    price
  };
}
三、防御性解构与默认值陷阱:识别 null 与 undefined 的本质区别
为解构属性设置默认值是实现健壮前端代码的关键手段。然而,许多开发者在此踩坑:解构默认值仅在对应属性严格等于 undefined 时才会触发!
由于数据库的空值通常序列化为 JSON 的 null,很多后端接口在数据为空或无内容时会返回形如 "tags": null 或 "avatar": null。此时即使在解构中写了 const { tags = [] } = data;,变量 tags 依然会被赋值为 null,而非预期的空数组 []!当下游代码调用 tags.map(...) 或 tags.length 时,页面将立即崩溃。
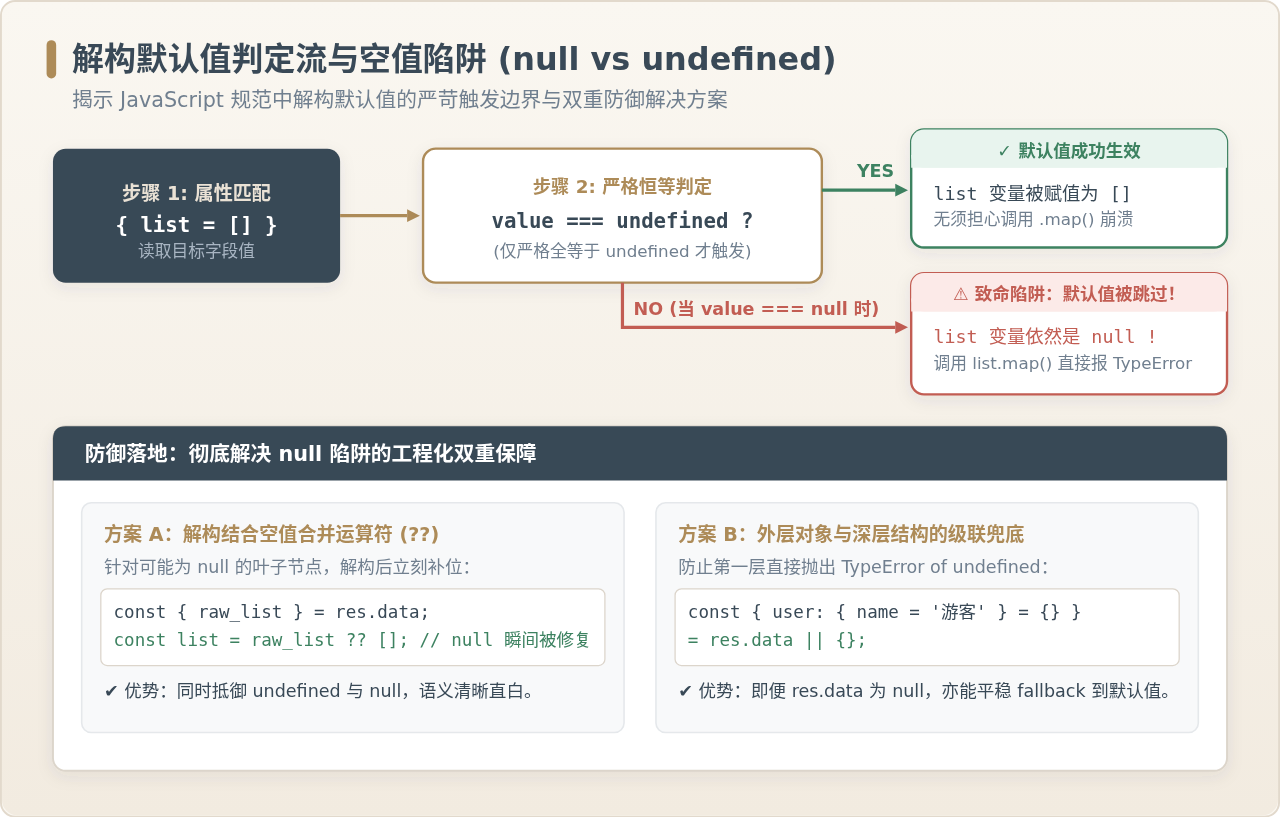
ECMAScript 规范明确规定:默认值判定使用的是严格全等比较(value === undefined)。这意味着无论是 null、0、false 还是空字符串 "",都被视为“有效值”,不会激活默认值赋权。
应对策略:空值合并运算符(??)与防空兜底
针对后端可能返回 null 的风险字段,推荐采用解构重命名后结合空值合并运算符(??)进行二次防御:
// 方案:解构与 ?? 配合,彻底清除 null 隐患
function sanitizeUserProfile(rawUser) {
  // 1. 外层对象防空:rawUser 可能为 undefined 或 null
  const {
    nickname = '匿名访客',
    avatar_url: rawAvatar,
    tag_list: rawTags
  } = rawUser || {};

  // 2. 使用 ?? 过滤 null 与 undefined
  const avatar = rawAvatar ?? '/images/default-avatar.png';
  const tags = rawTags ?? [];

  return { nickname, avatar, tags };
}
四、深度实战:嵌套解构、Rest 操作符与网络管道集成
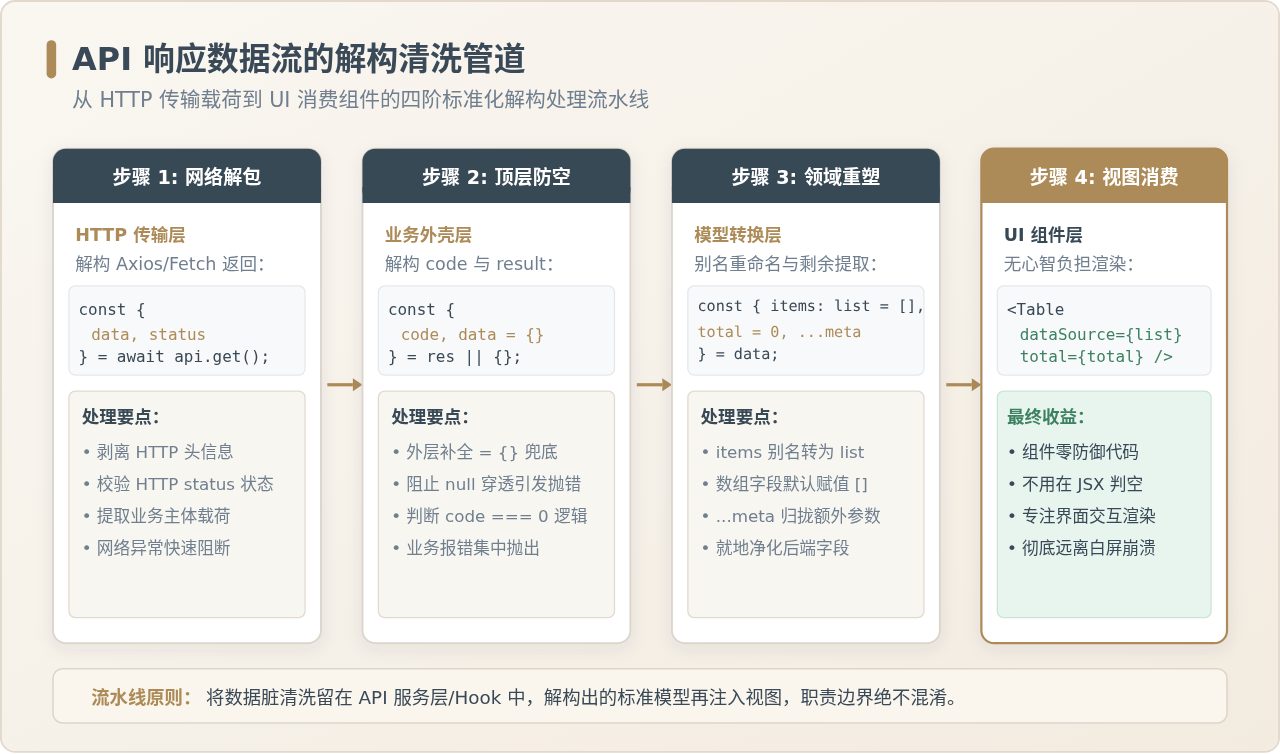
在真实生产工程中,解构赋值往往与 Axios 响应拦截器、自定义 React Hooks 或 Pinia/Vuex Store 紧密协同。
1. 函数形参中的就地解构
将解构推向前移至函数签名(Function Signature),可以让函数入参契约极为明确。在处理网络响应的回调中尤为直观:
// 在 Axios 拦截器或 Promise.then 中直接解构 HTTP 载荷
axios.get('/api/v1/articles')
  .then(({ data: { code, data: articlePayload = {} } = {} }) => {
    if (code !== 200) {
      throw new Error(`接口返回异常业务码: ${code}`);
    }
    // 继续流转至清洗函数
    return transformArticleData(articlePayload);
  });
2. 嵌套深度控制:何时该停止深层解构?
虽然语法上支持无限深度的解构(例如 const { a: { b: { c: { d } } } } = res),但嵌套超过两层后,单行解构的可读性会发生断崖式下跌,一旦中间某层漏掉了 = {} 兜底,极易引发难以定位的报错。
最佳工程经验:单次解构深度控制在 2 层以内。对于深度超过 3 层的业务数据,应当分步解构,或者在领域模型转换函数中逐步抽取。
3. 巧用 Rest 展开语法(...rest)分离关注点
当接口返回了混杂的元数据(如校验 token、服务端时间戳、追踪 ID)和实体载荷时,可使用 Rest 语法进行干净利落的分离:
// 分离协议级字段与核心数据载荷
function normalizeResponse(apiResponse) {
  const {
    _trace_id: traceId,
    timestamp,
    status_code: status,
    ...purePayload // 剩余属性全部归拢入纯粹载荷对象中
  } = apiResponse.data || {};

  // 上报埋点日志使用 traceId
  logger.record({ traceId, timestamp });

  // 纯净业务数据下发至组件
  return purePayload;
}
五、生产级规范与防御清单:五大黄金法则
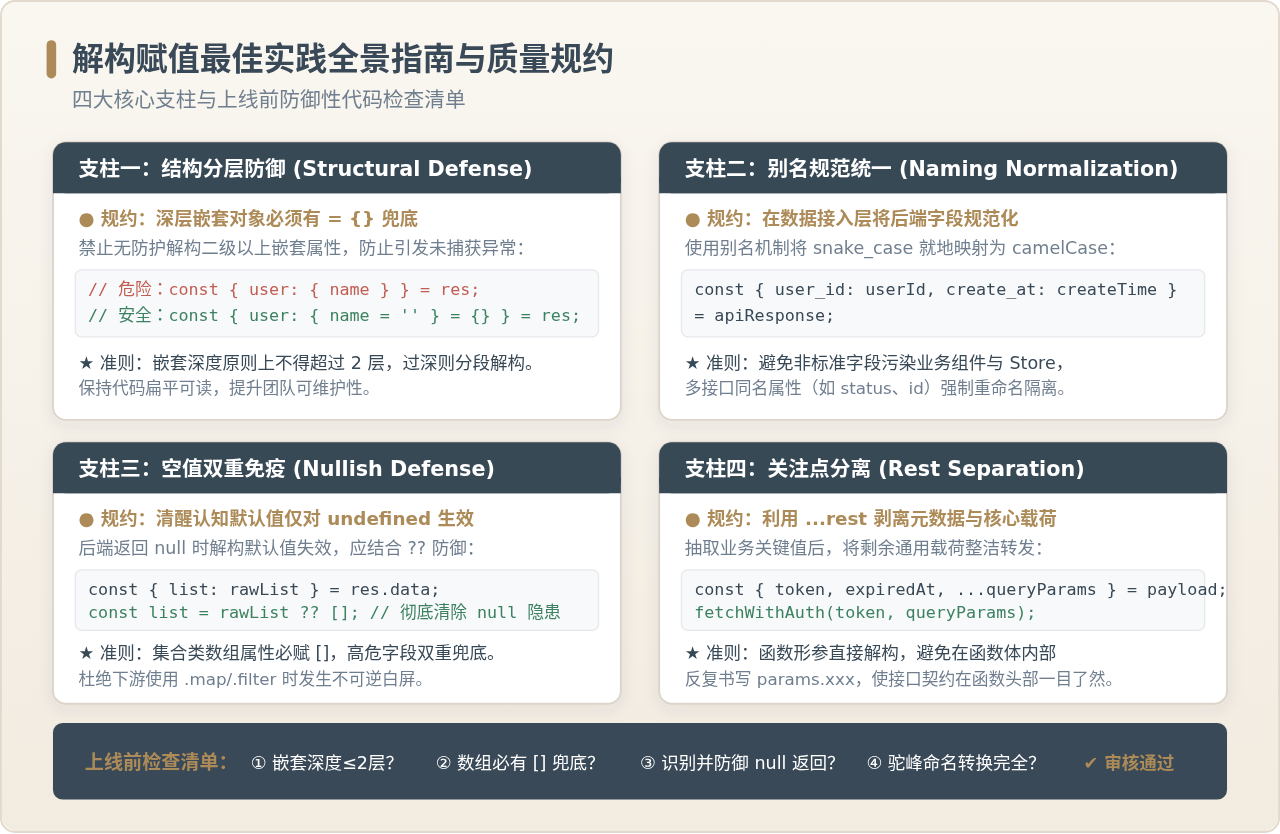
为了在团队协作中保持高水准的代码质量与系统稳定性,总结以下五条关于前端 API 解构的工程落地规范:
-
规则 1:顶层与嵌套对象必带默认空对象(
= {})
只要解构子属性,其父级结构右侧必须有= {}防御,彻底切断Cannot destructure property of undefined报错链。 -
规则 2:列表与集合字段必带默认空数组(
= [])
凡是要在前端执行.map()、.filter()、.forEach()或传递给表格组件的数组字段,解构时必须显式指定list = []。 -
规则 3:严格防范
null穿透,重点字段配合??兜底
对数据库直出字段(如扩展属性、头像、标签列表)保持警惕,解构后若值可能为null,立即使用rawField ?? defaultValue进行标准化。 -
规则 4:就地重命名,消解后端下划线风格
使用prop_name: propName形式将下划线风格转化为小驼峰,避免在后续业务层漫延不一致的命名风格。 -
规则 5:分层清晰,解构收敛在数据接入层(Service/Hook)
避免在每个 UI 组件渲染函数内重复解构原始数据。将解构、清洗与重构逻辑集中封装在 API 请求函数或专用的 ViewModel 转换器中,为 UI 组件提供纯净、无心智负担的强类型数据。
Node.js 初步连接 MySQL 数据库教程
2026-10-29 22:49:50
jQuery结合JSP实现省市区三级联动下拉菜单详解
2026-10-29 18:24:00
JavaScript实现SQL语句转StringBuffer拼接工具
2026-10-29 08:08:06
Node.js 连接 MySQL 数据库完整示例
2026-10-28 18:05:40
RxJS在TypeScript中的简单使用详解
2026-10-23 17:28:56







