

文远知行发布WITT物理AI大模型,专治智驾幻觉
文远知行发布物理AI大模型WITT,引入最小物理事实单元概念,具备事实提取、推理、验证与编排能力。其事实错误率仅为通用大模型的三分之一,单卡单日处理1万分钟视频,节省高达98%的Token成本,旨在提升自动驾驶数据闭环效率。
自动驾驶领域迎来一项备受关注的新进展。近日,文远知行WeRide正式发布自研的物理AI认知基础大模型,命名为“WITT”,全称为World Intelligence Toward Truth。
该命名蕴含深意,致敬20世纪哲学家路德维希·维特根斯坦。其核心观点“世界是事实的总和”几乎为物理AI提供了精准注脚——AI要真正认知真实世界,必须从环境、行为、规则、风险及时序关系中提炼出可信的事实,而非停留于模糊表象。
当前,物理AI的落地正在加速,自动驾驶无疑是其中最先可能实现大规模商业化验证的赛道。伴随而来的痛点也较为集中:数据量虽在暴涨,但真正具有训练价值、可用于评测和迭代的数据难以高效识别;高价值的长尾样本依然稀缺;L4实际运营数据与L2量产数据中,掺杂了大量人为接管、无效片段等噪声;更棘手的是,通用大模型在处理复杂交通场景时,常出现幻觉与误判。
那么,WITT如何应对这些挑战?根据文远知行提供的资料,其核心思路在于引入“最小物理事实单元”概念。简言之,将连续变化的真实场景拆解为一个个可识别、可验证的事实单元。
以一段夜间雨天城市道路行车视频为例,在WITT视角下,该视频会被拆解为“自车右转、城市道路、交叉口、路口信号变化”等多个独立事实单元。每个单元均具备高置信度、可校准、可追溯的特性,为后续训练与验证提供更扎实的基础。
基于这一逻辑,WITT形成了四大核心能力:
事实提取
从标准驾驶事实、多主体交互事实和物理模糊条件三个维度,识别最小物理事实单元。
事实推理
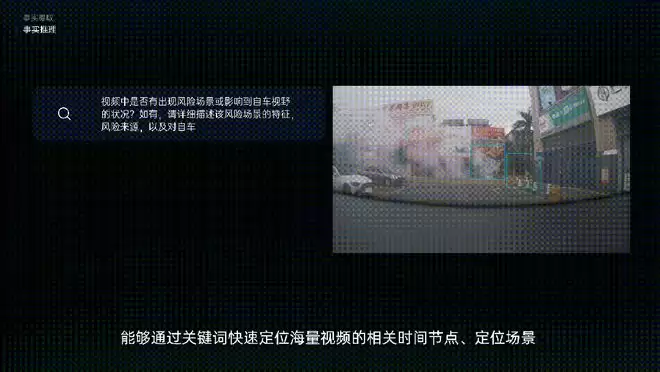
支持通过关键词或自然语言问题,在海量视频数据中快速检索,精准定位“施工区域内行人突然横穿”等长尾场景。
事实验证
从弱势道路使用者、自车行为、他车行为、场景理解、事实完备性和交通设施六个维度对模型输出进行评估,并引入事实置信度进行反向验证。在自动驾驶垂类场景中,WITT平均每片段的事实错误率约为通用大模型的三分之一。
事实编排
按照学习价值对事实视频进行智能分流——长尾场景回流至世界模型WeRide GENESIS用于仿真训练,高频日常场景则用于强化学习。
在工程效率方面,WITT优势明显。相比动辄百亿级参数的通用大模型,WITT模型规模更轻量,在同类任务中可节省高达98%的Token成本。单卡单日可处理1万分钟车辆运行视频,最高实现200倍数据处理效率提升。在标签模式下,单次请求即可输出100多个动态标签。
从行业视角来看,WITT的发布本质上是文远知行在“数据—算法—商业化”闭环效率上的一次关键押注。它试图回答一个核心问题:当车队规模从百辆级跃迁至千辆级甚至万辆级时,如何以更低的算力成本处理指数级增长的数据?
当然,技术升级能否真正转化为可持续商业模式,还需关注两个关键变量。其一,WITT带来的数据处理效率提升,能否实质性压缩文远知行的研发与运营开支;其二,L4车队的规模化扩张速度,能否跟上市场对“2026年规模化落地元年”的预期。
中信建投等机构在研报中已提示,2026年Robotaxi行业将迎来扩张潮。高盛甚至将2026年中国Robotaxi车队规模预测上调至1.4万辆。在这一时间窗口内,谁能率先跑通“千辆级车队自我造血”的经济模型,谁就将握有下一轮竞争的主动权。