

Scaling Law“暴力美学”失效了吗?
当前,OpenAIOrion等模型性能提升有限,导致ScalingLaw面临挑战。IlyaSutskever称扩展训练已趋平稳,急需寻找新方向;而SamAltman等人则认为尚无任何放缓证据。新研究提出精度缩放定律,发现7-8位训练更优,可能影响未来扩展路径。这一分歧凸显了AI发展的不确定性。
先来梳理几个关键信号。
近期,围绕Scaling Law的讨论突然密集起来。导火索是The Information的一篇报道:OpenAI下一代旗舰模型Orion(或GPT-5),相较于现有模型,性能提升只能用"有限"来形容——在某些测试里,代码能力甚至不如现有模型,远没有当年从GPT-3到GPT-4那种跃升感。而且,Orion在数据中心的运行成本更高。消息一出,OpenAI据说连夜调整了策略。
如果说OpenAI一家遇到这事儿可能是个例,那Google的遭遇就更值得警惕了。其下一代Gemini模型,原本被寄予厚望,是一次重大升级。但有内部员工透露,在大幅增加资源投入后,模型性能并未达到领导层预期,团队同样在紧急调整方向。与此同时,Anthropic也被曝暂停了Opus 3.5的推进工作,官网甚至撤下了"即将推出"的字样。
这三家巨头接连碰壁,一个绕不开的问题浮出水面:Scaling Law,是不是要走到头了?
Scaling Law,也就是尺度定律,一直被视作大模型领域的第一性原理。这个概念最早由OpenAI在2020年的论文《Scaling Laws for Neural Language Models》中提出。核心观点很直接:影响大模型性能的三大要素——计算量、数据集大小、模型参数量——只要不受另外两个因素制约,模型性能与每个单独因素都存在幂律关系。
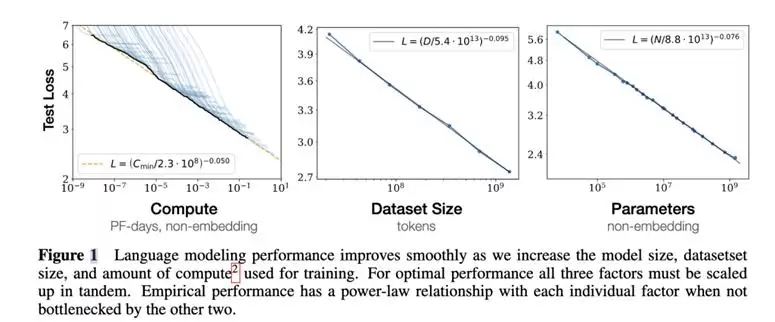
简单说,就是"更大更好""大力出奇迹":堆更多的算力、加更多的参数、喂更多的数据,模型能力就能大幅提升。如今,当规模和成本都在飙升,实际性能却增长乏力时,这个神话是否真的要被终结了?
正方:Scaling Law神话终结
Ilya Sutskever:扩展训练的结果,已经趋于平稳。
作为Scaling Law的早期倡导者之一,前OpenAI首席科学家Ilya Sutskever的表态颇有分量。他直言,扩展训练的结果已经趋于平稳,意味着传统的无监督Pre-training已经触及天花板。他甚至说,2010年代是Scaling的时代,现在人们需要重新寻找"下一个奇迹",重点是扩大"正确"的规模。
什么叫"正确"?Ilya没有明说,只透露他的新公司SSI正在研究一种全新的替代方法,来扩展预训练。但结合OpenAI和Google的最新动向,或许能看出一些端倪。OpenAI的研究人员正在开发推理模型(reasoning models)这类新技术,用来弥补传统训练方法的不足。Google也在效仿,近几周DeepMind在Gemini团队内部组建了一个由首席研究科学家Jack Rae和前Character.AI联创Noam Shazeer领导的小组,专门攻克类似能力。此外,DeepMind团队还在手动优化模型性能,通过调整超参数等变量,来测试哪些配置能带来最好的效果。
Arvind Narayanan & Sayash Kapoor:合成数据作用不大
今年6月,普林斯顿大学计算机科学教授Arvind Narayanan与其博士生Sayash Kapoor发表了一篇文章《AI scaling myths》,直接指出Scaling的"崇拜论"建立在几大误解之上。
第一,到底什么是"更好的"模型?是被认为具有"涌现能力"的模型。问题在于,Scaling Law量化的是困惑度的下降,也就是模型预测下一个单词的能力。但对最终用户来说,困惑度几乎没什么意义。真正有意义的,是模型规模增长时出现的"涌现能力",也就是模型获得新能力的趋势。但这种"涌现能力"并不受任何类似定律的支配。它为什么不能无限持续?这背后是关于LLM能力的核心争议:它们到底能否进行外推,还是只会学习训练数据中已有的任务?现有证据不完整,研究者各执一词。而Arvind Narayanan团队倾向于怀疑态度。在一些专门测试LLM解决新任务能力的基准测试中,其表现往往不理想。如果LLM无法超越训练数据中的内容,那么每一个传统的机器学习模型最终都会进入平台期。
第二,更多的数据从哪儿来?有人提出,新的数据源,比如把YouTube转录成文本,可以增加一两个数量级的可用数据。确实,YouTube有约1500亿分钟的视频内容。但考虑到其中大部分缺乏可用音频(比如音乐、静止画面、游戏画面),经过去重、质量过滤后,实际能用的训练数据远少于Llama 3所使用的15万亿tokens。退一步说,"数据耗尽"这个讨论本身就不太准确。训练数据永远有,只是成本越来越高——版权、监管等等。如今,研究的重点已经从构建更大数据集,转向提高训练数据的质量。精心筛选和清理之后,更小的数据集同样能训练出强大的模型。
第三,合成数据不是万能魔药。还有一种观点是,利用现有模型生成训练数据。这个观点同样存在误区:开发者并没有、也无法利用合成数据显著增加训练数据的总量。有论文详细列出了合成数据的用途,主要集中在弥补特定领域的不足,比如数学、编程、低资源语言。英伟达最近推出的Nemotron 340B模型,也是专注用合成数据来做对齐。虽然它还有其他用途,但取代现有预训练数据源并不在其中。换句话说,盲目生成大量合成数据,无法达到高质量人类数据的效果。
当然,合成数据在某些封闭场景中取得了巨大成功,比如2016年的AlphaGo,以及后来的AlphaGo Zero和AlphaZero。这些系统通过自我对弈学习,后两者甚至能自己生成高质量棋局。这本质上是"系统2→系统1蒸馏"的经典案例:用缓慢昂贵的"系统2"生成训练数据,用来训练快速廉价的"系统1"。但这种方法在围棋这种完全封闭的环境里效果极佳,推广到游戏之外,仍然是个有价值的研究方向。在某些领域,比如代码生成,或许能行。但指望在更开放的任务,比如语言翻译上,也实现类似的无限自我改进,恐怕不现实。可以预见,通过自我对弈实现大幅提升,将是特例,而非普遍规律。
反方:Scaling Law没有墙
OpenAI CEO Sam Altman:there is no wall
前方有The Information扰乱军心,后方Sam Altman直接在X平台上表态:there is no wall。他还在Reddit的Ask Me Anything上表示,OpenAI将在今年晚些时候发布"非常好的版本"。不过,考虑到"草莓"项目的炒作、Ilya Sutskever的威望,以及OpenAI近期在技术上的表现,Altman这番话多少有点"挽尊"的意味。事实如何,还得看产品说话。
微软AI主管Mustafa Suleyman:不会有任何放缓
Suleyman在近期的采访中表示,模型的规模既在变大,也在变小,这种趋势会持续下去。去年开始流行一种新方法叫蒸馏,利用大型、高成本模型来训练小型模型,监督效果相当不错,证据已经很充分。因此,规模仍然是竞争中的关键因素,未来发展空间还很大,数据量也会持续增长。至少在接下来两三年内,Scaling Law在提供超预期表现方面,不会有任何放缓的迹象。
微软CEO Satya Nadella:这是定律,并且一直有效
今年10月21日,在微软AI之旅伦敦站活动上,Satya Nadella明确表示:Scaling Law是经验观察所得,但我们把它称作定律,并且它一直有效。
微软CTO Kevin Scott:让别人想去吧
今年7月,Kevin Scott在接受红杉资本合伙人采访时说:尽管其他人可能这么想,但我们在规模化上并没有遇到边际收益递减的情况。
前谷歌CEO Eric Schmidt:没有证据显示
11月14日,Eric Schmidt在播客中表示:没有任何证据表明Scaling Law已经开始停止。他预测,未来五年人工智能系统的能力将是现在的100倍,能够在物理和数学领域进行推理。
Abacus.AI CEO Bindu Reddy:是技术太成熟了
Bindu Reddy的观点则有些特别:所谓的AI减速实际上无关紧要。主要原因在于AI技术发展的潜力几乎已经在各类基准测试中得以体现。当达到100/100的满分时,就很难再找到新的突破方向。因此,AI市场的"放缓"更多反映了技术成熟度,而非创新能力的不足。(至于你信不信,就是另一个问题了。)
Scaling Law 2.0:token越多,精度也要越高
无论各位大佬如何"挽尊",大模型"减速"的事实很难被掩盖——那种持续带来惊艳感的体验,似乎确实变少了。
不过,或许还有别的办法。
近期,来自哈佛、斯坦福、麻省理工等机构的合作团队发表了一篇题为《Scaling Laws of Precision》的论文,引发了广泛讨论。研究提出:精度在模型扩展规律中的重要性,比之前认为的要大得多,可以显著影响语言模型的性能。以往描述模型性能随参数量和训练数据量变化的扩展规律,基本忽略了精度这个因素。而随着模型规模不断扩大,低精度的量化方案可能不再有效。
首先,研究人员通过实验,制定了一个新的精度缩放定律。另一个重要发现是关于预训练期间的计算最优精度。研究显示,当同时优化参数数量、数据和精度时,这个精度通常与计算预算无关。其次,普遍采用的16位模型训练法并非最优,因为很多位其实是多余的。而使用4位进行训练,则需要不成比例地增加模型大小来维持损失缩放。计算表明,对于较大的模型来说,7-8位才是计算最优的。
当然,当模型大小从一开始就固定时,情况会发生变化:更大、更好的模型,应该以更高的精度进行训练——比如使用16位的Llama 3.1 8B模型。实际的计算节省还取决于硬件对更低精度的支持。此外,这项研究的模型参数最多才1.7B,还没有在最大的实际规模上进行测试。不过,这些一般趋势,对于更大规模的模型仍然是适用的。
CMU教授Tim Dettmers评价说,这是长久以来最重要的一篇论文。他认为,人工智能的大部分进步都来自计算能力的提升,而这种提升近年来主要依赖于低精度路线(32→16→8位)的加速。现在看来,这一趋势即将结束。再加摩尔定律的物理限制,大模型的大规模扩展,可以说快到尽头了。他预计,随着低精度带来的效率提升达到极限,行业将从纯规模扩张,转向专用模型和人本应用。
AGI之路漫漫,但大家也不必灰心。
退一万步讲,正如OpenAI研究人员Steven Heidel所说:就算现在LLM停滞了,基于当今模型的产品,至少还有十年的开发空间等着你。
这么一想,是不是又干劲十足了?